
昨天 Day 23,我替 Learning Card 加上「重新產生」功能。
現在如果對 Gemini 產生的內容不滿意,不需要重新輸入學習條件,只要使用上一次成功產生時保存的條件,就能再次呼叫 Gemini:
Previous Generate Options
        ↓
Regenerate
        ↓
Gemini API
        ↓
Structured Output
        ↓
LearningCard[]
        ↓
React State
做到這裡,從程式的角度來看,Learning Card Generator 已經越來越完整。
但今天我突然想到一個更重要的問題:
Gemini 成功產生 Learning Card,就代表這些內容可以直接拿來當教材嗎?
前幾天我一直在確認 JSON、Schema、TypeScript、React State,今天決定先不寫新功能,回頭真正看看 AI 到底產生了什麼。
目前 Gemini 的 Structured Output 已經可以穩定回傳:
{
  "cards": [
    {
      "emoji": "🚗",
      "title": "小汽車",
      "content": "...",
      "question": "...",
      "answer": "..."
    }
  ]
}
這代表程式可以確認:
emoji 有沒有?
title 有沒有?
content 有沒有?
question 有沒有?
answer 有沒有?

欄位是不是 string?
但 Schema 不知道:
內容正確嗎?
適合這個年齡嗎?
有沒有過度簡化?
問題設計合理嗎?
真的適合拿來教嗎?
所以今天決定用目前完全相同的 Prompt Template,產生三組不同類型的 Learning Cards,再進行人工 Review。
開始測試前,我先整理幾個檢查方向,並在實際看完卡片後補成六項:
| Review Criteria | 檢查內容 |
|---|---|
| Accuracy | 知識內容是否正確 |
| Age Appropriateness | 是否符合指定年齡 |
| Focus | 是否聚焦一個主要概念 |
| Q&A Consistency | Question 是否能從 Content 找到 Answer |
| Clarity | 表達是否簡單、清楚 |
| Internal Consistency | Emoji、Title、Content、Question、Answer 是否圍繞同一概念 |
接著直接開始測。
第一組條件:
學習對象:3~4 歲幼兒
學習主題:交通工具
卡片數量:5
Gemini 產生:
🚗 小汽車
🚌 大公車
🚂 長火車
✈️ 飛機飛上天
⛵ 小船划水去
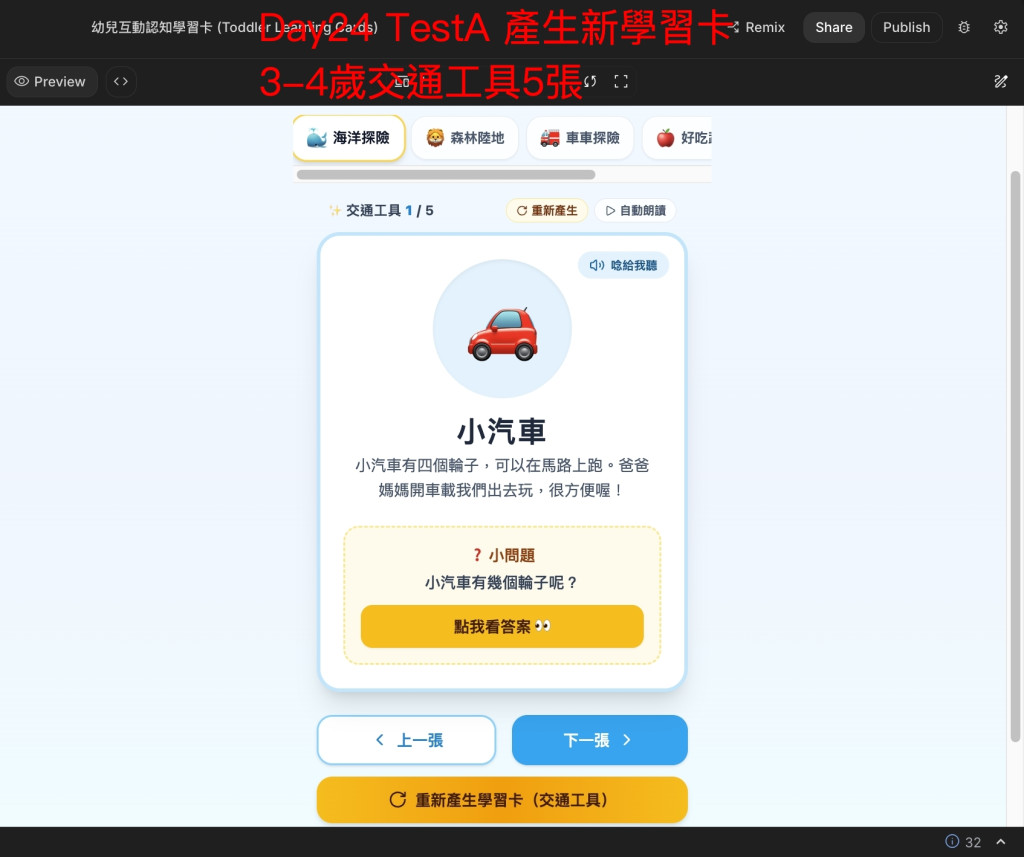
整體看下來,其實表現比我預期得好。
例如飛機:
飛機有大大的翅膀,可以在天上飛。它飛得很高很高,比小鳥還要高,帶我們去很遠很遠的國家。
Question:
飛機在哪裡飛呢?
Answer:
在天上飛。
不論年齡、語氣或 Q&A 都很直覺。
但仔細看還是發現一個問題:一張卡常常放進太多概念。
例如火車同時介紹:
鐵軌
+
匡噹匡噹的聲音
+
車廂
+
載客
最後 Question 卻只問:
火車在哪裡跑呢?
Prompt 明明要求:
每張卡片只介紹一個主要概念
Gemini 大方向有遵守,但對「一個主要概念」的理解沒有我想像中嚴格。
另外「小船划水去」也有一點有趣。
Emoji:⛵
Title:小船划水去
Content:在水上漂
Question:在哪裡漂?
每個欄位單獨看都沒有太大問題,但組合起來後,教學焦點就沒有那麼一致。
因此 Test A 的結論不是「Gemini 產生錯誤教材」,而是:
內容大致可以使用,但仍需要人工確認每張卡的教學焦點。
第二組開始增加一點知識性:
學習對象:7~8 歲兒童
學習主題:太陽系
卡片數量:5
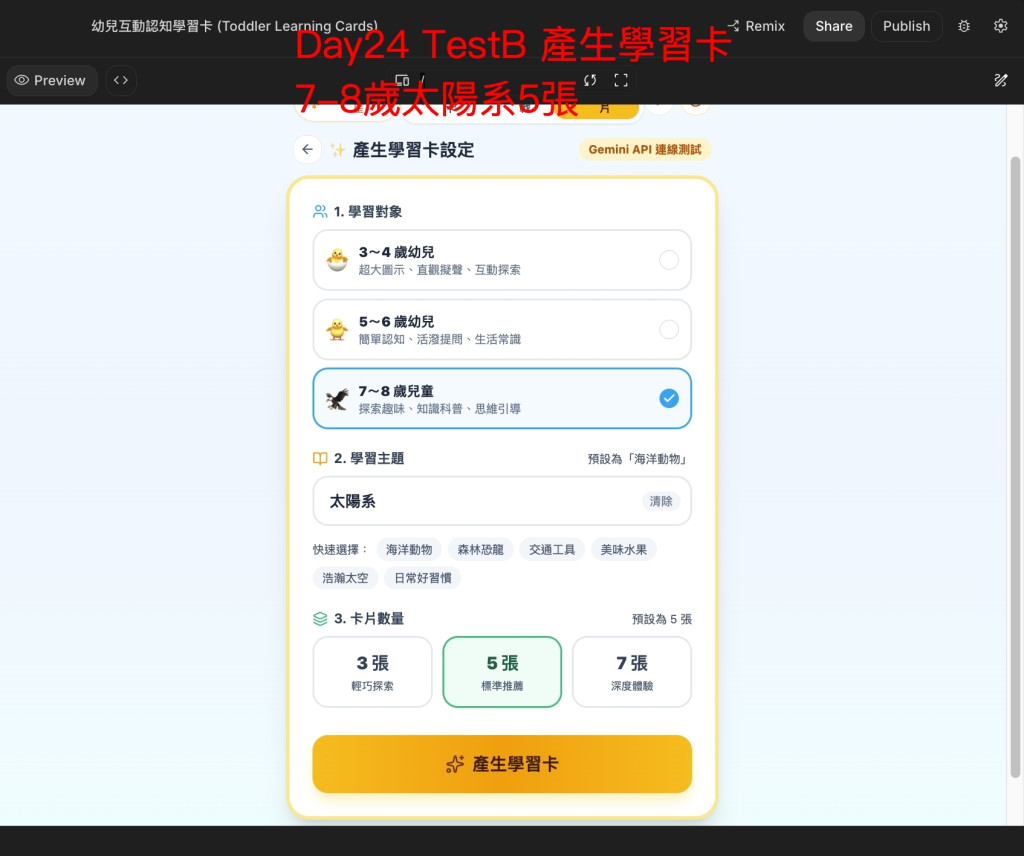
Gemini 產生:
🪐 什麼是太陽系?
☀️ 太陽是誰?
🌍 我們住的地球
🌕 地球的好朋友:月亮
✨ 太陽系的其他行星
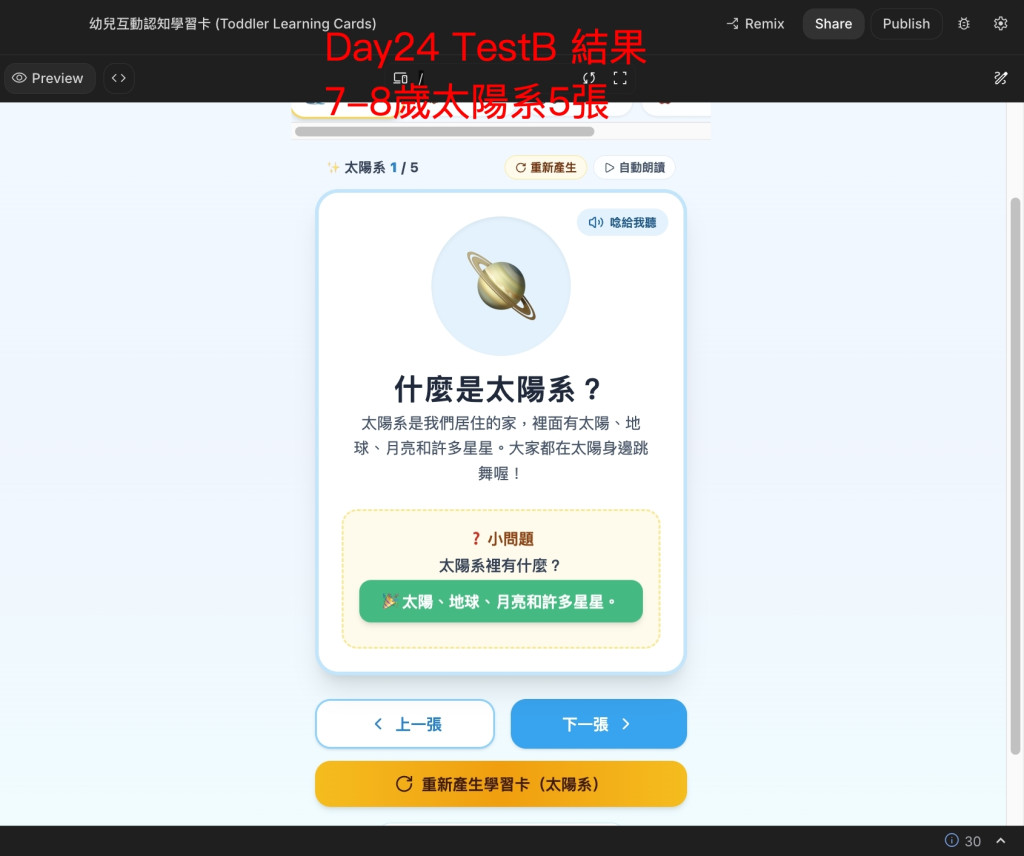
這次很快就看到比 Test A 更值得注意的內容。
第一張寫:
太陽系是我們居住的家,裡面有太陽、地球、月亮和許多星星。大家都在太陽身邊跳舞喔!
問題就在:
「太陽系裡有……許多星星」
太陽是太陽系唯一的恆星;太陽系還包括八大行星、矮行星、許多衛星、小行星、彗星等天體。
所以這裡把「許多星星」列為太陽系的組成,就不適合直接拿來當教材。
更值得注意的是,它後面的 Q&A:
Q:太陽系裡有什麼?
A:太陽、地球、月亮和許多星星。
從程式設計的角度來看,這組 Q&A 非常成功:
Content
↓
Question
↓
Answer
答案真的可以從 Content 找到。
問題是——Content 本身就不精確。
因此變成:
不精確的 Content
        ↓
一致的 Question
        ↓
一致的 Answer
        ↓
不精確的概念被再次強化
這讓我發現:
Q&A 一致,不代表 Q&A 正確。
另外一張寫:
太陽是太陽系裡最大、最亮的星星。
雖然限定在「太陽系裡」不至於造成大問題,但更精確又簡單的方式其實可以直接寫:
太陽是太陽系唯一的恆星。
這樣概念反而更清楚。
月亮則寫:
月亮每天晚上都會掛在天上。
這種描述很童趣,但容易讓兒童形成「月亮只有晚上才會出現」的印象。
所以 Test B 開始出現另一種問題:
AI 為了讓內容簡單、親切,有時也會犧牲科學表達的精確度。
第三組我換成人體器官:
學習對象:7~8 歲兒童
學習主題:人體器官
卡片數量:5
Gemini 產生:
🧠 大腦真聰明
❤️ 噗通的心臟
🫁 呼吸的肺
🍎 咕嚕嚕的胃
💧 小小的腎臟
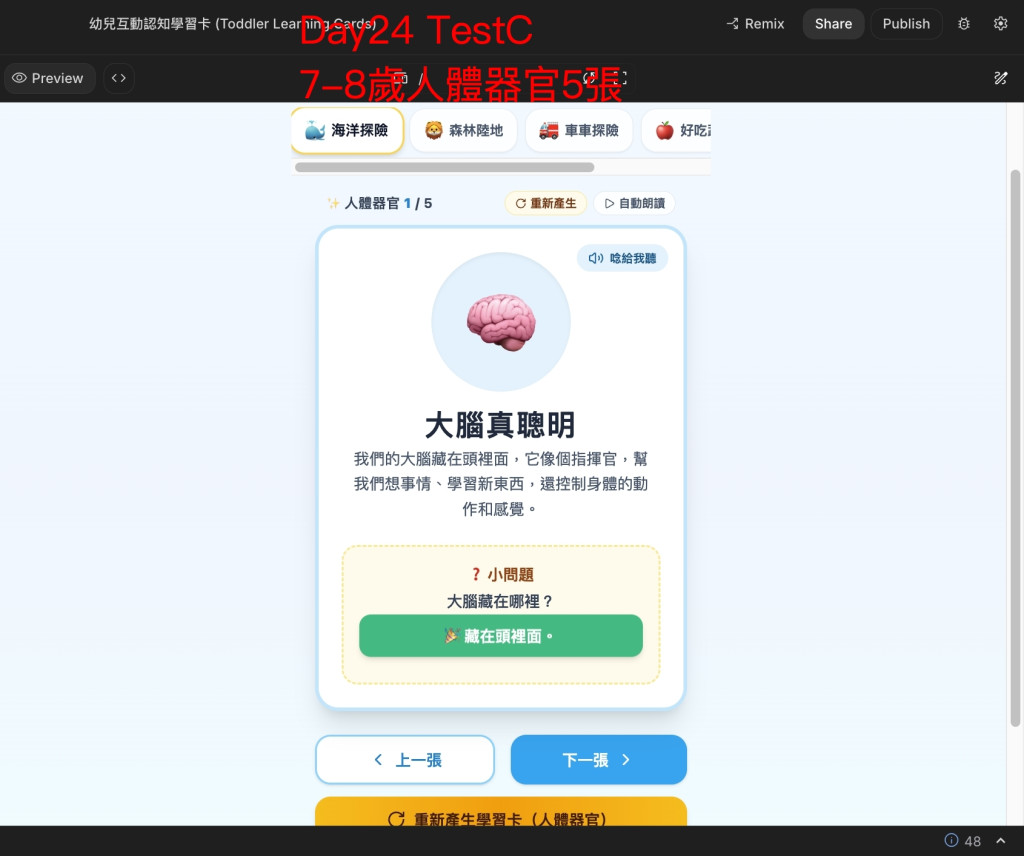
這次沒有像「太陽系有許多星星」那麼明顯的問題,但出現了另一種現象:
過度簡化。
例如肺:
吸進乾淨的空氣,再把不要的空氣吐出去。
對 7~8 歲兒童來說確實很好懂,但:
乾淨的空氣
不要的空氣
並不是很精確的呼吸概念。
胃的描述則是:
胃像個袋子,把食物磨碎變小,讓身體可以吸收養分。
這很容易讓孩子把:
食物
↓
胃
↓
吸收養分
直接連在一起。
實際上胃負責消化的一部分,而大部分營養吸收主要發生在小腸。
腎臟也使用:
過濾掉不要的髒東西……讓身體保持乾淨。
作為兒童比喻很容易理解,但「髒東西」、「保持乾淨」又可能把真正的生理概念簡化得太多。
所以 Test C 讓我看到:
內容越簡單,不一定代表教材越好。
對兒童教材來說,「容易理解」和「知識精確」之間其實需要取得平衡。
這次總共檢查了 15 張 Learning Cards。
三組的結果其實不太一樣:
| Test | 主題 | 主要發現 |
|---|---|---|
| A | 交通工具 | 整體合理,但一張卡容易放太多概念 |
| B | 太陽系 | 出現需要修正的知識內容 |
| C | 人體器官 | 為了兒童化而產生過度簡化 |
可以再整理成三個問題:
① Focus
一張卡塞了太多概念

② Factual Accuracy
內容可能不精確

③ Oversimplification
為了容易理解而簡化過頭
但這次 Gemini 也有一點表現得相當穩定:
Q&A Consistency。
15 張卡大多都能做到:
Content
↓
Question
↓
Answer
也就是 Question 的答案真的能從 Content 裡找到。
只是 Test B 也提醒我:
一致性不等於正確性。
做到這裡,我終於更清楚 Structured Output 的邊界。
Schema 可以幫我檢查:
answer 存不存在?       ✅
answer 是不是 string?  ✅
但它不知道:
answer 正確嗎?         ❓
content 適合兒童嗎?    ❓
知識有沒有過度簡化?   ❓
這張卡真的適合教學嗎? ❓
所以:
Structured Output 解決的是資料格式問題,不是教材品質問題。
前面花了很多天把 Gemini Response 從文字整理成 JSON,再接進 TypeScript、React State 和 UI。
今天才真正發現:
Schema Validation
≠
Content Validation
程式可以接受的資料,不代表就是可以直接使用的教材。
一開始做 Learning Card Generator 時,我就把 AI 產生的內容定位成:
Draft,而不是 Ground Truth。
今天實際檢查 15 張卡後,這件事變得更具體。
Gemini 很適合快速幫我完成:
學習條件
↓
教材初稿
↓
Learning Cards
但後面還需要:
AI Generated Draft
        ↓
Human Review
        ↓
修改 / 確認
        ↓
Final Learning Card
而 Human Review 也不只是「找 AI 有沒有講錯」。
還要確認:
對 AI for Education 來說,這可能比單純「成功呼叫 Gemini API」更重要。
今天找到問題之後,又出現下一個很實際的問題。
假設五張 Learning Cards 裡:
4 張可以用
1 張需要修改
現在的 App 只有兩種選擇:
接受整組
或:
重新產生整組
但如果我只是想把:
「太陽系裡有許多星星」
改掉呢?
好像沒必要把另外四張一起丟掉。
所以明天要開始把 Human Review 真正放進 App:
Day 25|AI 寫完,人來決定:加入 Learning Card 編輯功能


 iThome鐵人賽
 看影片追技術