

Day 20 把逐日值、視窗統計與 baseline 一起放進 summary-v1,是為了讓當時的比較組保留原始資料可見的資訊。Day 24 又在 summary-v2 補上 baseline 視窗日期,讓引用可以核對時間範圍。這些欄位各有用處,但目前最長的 summary 只涵蓋 7 天,專案裡可取得的最長歷史是 60 到 64 天(合成情境 n_days 多為 60,mostly_missing 為 30;LifeSnaps 每個 round 64 天)。歷史拉長後,「資料全部貼上」還夠不夠、模型能不能知道這次問題該看哪段、哪個數值可以與個人過去比較,專案沒有測過;這是今天要測的假設,不是前提。輸入的選擇與排列,因此成了工程問題。
今天想做一個 context builder:針對同一個使用者問題,從 LifeSnaps 與合成情境整理近期事件、短期趨勢、長期 baseline、資料品質和問題本身,產生有明確資訊優先級與 token 預算的 prompt context。重點是檢查省下內容時,有沒有連判定依據、缺值或引用路徑一起刪掉;模型能不能據此說清「相對於過去的自己」,仍要看後續輸出。
前兩天已把模型輸入與 claim 引用的邊界定在 summary:Day 23 的 manifest.json、payload.json 與 trace 用於追查,不直接送模型;Day 24 的 citation checker 也以模型實際看見的 summary.json 為比對基準。今天若重排或縮減 context,就要保留這條邊界,不能事後用未送出的資料替模型補證據。
「最近有沒有變化」和「今天相對於我的平常如何」需要的資料不同:前者要近期值與短期趨勢,後者還要個人 baseline、它的時間範圍與偏離判定。context builder 依問題類型決定取哪些層:解讀日與近期事件、短期統計、長期 baseline,以及各層依賴的品質與來源說明;不必每次都把每一層填滿。
問題類型是 builder 的輸入參數,不另外呼叫 LLM 分類。今天列四類:current、trend、vs_baseline(避開與 baseline 欄位同名)、specific_date,每個測例事先指定類型,配一句新寫的問題句。所以這裡測的是「給定類型後怎麼取捨」,不是「能不能辨認類型」;同時問兩件事的複合問題受每天 20 次的配額限制,本輪不做。
baseline 不能只留中心值。狀態、有效觀測數、視窗日期、decidable 與判定原因要一起留,否則模型分不出可判定的個人偏離和資料不足時的表面差距;短期平均也要和有效天數一起出現。這些欄位要成組保留或成組捨棄。
summary-v1、summary-v2 的逐日列只有 7 天(COVERAGE_DAYS),更早的資訊只有 baseline 估計視窗內的部分被壓成統計量。所以今天用 coverage_days=60 產生一份完整 summary-v2 當對照組,builder 從同一份選取、不重算;兩邊的 trailing、baseline、deviation 相同,差別只在選了什麼。解讀日取各情境最後一個解讀日 2026-03-05(Day 24 的解讀日往前不到 60 天),讓事件落在視窗中段。LifeSnaps 沒有 ground truth,只量 token。
builder 的優先序:不可拆的基本資料(解讀日、指標定義與單位、品質與可判定狀態、讓 claim 指回來源的欄位)一律保留;其後依序是指定日或近期事件、短期統計與有效天數、baseline 與判定、其他逐日值,最後一項最先刪;問 vs_baseline 時 baseline 提到短期統計之前。刪減以組為單位,不能留平均而刪有效天數。baseline、deviation 只算解讀日,所以 specific_date 的預期答案是回報那天的值或缺值,不下判定。
預算以實際送出請求的 token 計算,指令、問題、資料都算在內;參考 Day 24 完整請求的 5,888–6,033 token,定為 8,000。只能本地估算時,它只是估計上限,計數做法見 Method。預算只管輸入,輸出、thinking 與延遲要看回應。
省略也要寫進送出的 context。缺值日在 summary 裡是明確的一列,builder 若只刪列,「沒有那一列」就分不出是被省略還是沒資料。刪列後 daily[j] 的索引會移位,兩個條件之間的 claim 要用(指標,日期)對齊,不用 path。
Day 20、21 的問題都放在資料之前,也沒有銜接句。Gemini 的 prompt 文件建議大量 context 先放、問題放最後,再用銜接句或 tag 區分資料與任務,但沒有給效果數據。所以問題位置、銜接句與 tag 是三個要分開比的候選,不能先當成改善。
驗收也不能只看輸入變短:要核對問題需要的數值與限制是否還在;引用要對照刪減後實際送出的那份,不是完整 summary;也要看模型有沒有把 insufficient 說成正常,或替沒提供的長期資料補出結論。沿用 Day 22、24 的檢查工具,前提是欄位名與「資料摘要:」標籤不變。
今天實際跑的是第 2 節的兩條件比較;第 3 節的排列方式沒有比,兩個條件都沿用 Day 24 的順序。
輸入由 Day 14 的合成情境產生,指標同 Day 24:minutesAsleep、rmssd、resting_hr,都取 p01。解讀日是兩個情境最後一個解讀日 2026-03-05,以 coverage_days=60 建出完整 summary-v2,各有 60 筆逐日列(2026-01-05~03-05)。
| 案例 | 問題類型 | 問題句 | 情境的事件期間(含恢復期,不送模型) |
|---|---|---|---|
sleep_debt_0305_specific_date |
specific_date | 請說明 2026-02-04 這一天的資料。 | 02-04~02-07,恢復到 02-09 |
drift_vs_event_0305_vs_baseline |
vs_baseline | 和我自己平常的水準比起來,我今天的資料如何? | 02-14~02-16,恢復到 02-18 |
sleep_debt_0305_trend |
trend | 我最近一週的資料有沒有變化? | 02-04~02-07,恢復到 02-09 |
第一、三個案例用同一份 summary,只差問題類型。specific_date 指定的 02-04 是事件首日,但送出的摘要裡沒有事件標籤;trend 問的最近一週(02-27~03-05)沒有事件,事件在一個月前。drift_vs_event 的 baseline 視窗 02-12~03-04 涵蓋了事件:resting_hr 在 02-14~02-16 是 70.2、71.3、69.0 bpm,baseline 中心 64.9,解讀日 58.3,score −2.33,未達門檻 3.0,沒有標旗。
各案例的預期寫在 days/day25/context_demo.py 的 EXPECTED,依情境 yaml 的事件日期另寫:specific_date 只回報 02-04 的三個值(327.3 分鐘、25.1 ms、63.2 bpm),不把 03-05 的判定當成 02-04 的;vs_baseline 以 02-12~03-04 的 baseline 對照 03-05,三項都可判定且未標旗,不把 2 月中的事件說成今天的事;trend 聚焦 02-27~03-05,不把 2 月初的事件說成近期仍在發生。
Concept §1 列了四類,實際只跑三類。current 原本配 mostly_missing 02-02,但 Day 24 已用同一人同一天測過資料不足的情況,這個情境也只有 30 天,所以拿掉,current 沒有呼叫結果。
LifeSnaps 只量 token、不呼叫模型:rmssd 非空 ≥ 60 天、排除疑似重複後剩 11 組 (id, round),各取最後一個解讀日,四類問題各建一次。
full:完整 60 天 summary-v2 原樣送出。builder:context-v1 從同一份選取,值原樣複製,不重算;預算 8,000 token。其餘設定與 Day 24 相同:prompt v1、輸出格式 v2、問題句、「資料摘要:」與 JSON;gemini-3.8-flash、temperature 1.0、max_output_tokens 8192、response_json_schema,沒有修正迴圈。問題句取代 Day 20 到 24 共用的要求句,位置不變(資料之前、沒有銜接句)。3 案例 × 2 條件 × 3 次 = 18 次,2026-10-08 同一天跑完,全部第一次嘗試就有回應。
builder 的取捨規則。 不可拆的基本資料是:頂層的 versions、coverage、day、cross_metric、data_issues;每個指標的 metric、source_column、unit、definition、date_attribution、interpretation_day、整段期間的 missing_dates_in_coverage;以及 baseline.status、deviation.decidable、deviation.reason。specific_date 的指定日那一列也算基本資料。其餘分組,依問題類型排序:
| 問題類型 | 第一組(最後才刪) | 第二組 | 第三組(先刪) |
|---|---|---|---|
| current、trend | 解讀日往前 7 天的逐日列 | trailing |
baseline、deviation 的其餘欄位 |
| vs_baseline | 解讀日往前 7 天的逐日列 | baseline、deviation 的其餘欄位 |
trailing |
| specific_date | 指定日前後各 3 天的逐日列 | trailing |
baseline、deviation 的其餘欄位 |
不屬於任何一組的其他逐日列最先刪,由最舊的日期一天一天刪;刪完才由後往前整組刪。builder 依序試這些刪減狀態,取第一個估計不超過預算的。被省略的部分寫進送出的 context,下面是 trend 案例 builder 條件的 context_selection:
"context_selection": {
  "question_type": "trend",
  "target_date": null,
  "daily_dates_shown": [{"start": "2026-02-17", "end": "2026-03-05"}],
  "omitted": [{"part": "daily", "dates": [{"start": "2026-01-05", "end": "2026-02-16"}]}],
  "note": "omitted 列出的日期與欄位沒有放進這份摘要,不代表那幾天沒有資料或那些欄位沒有值。…"
}
missing_dates_in_coverage 列的是整段 60 天的缺值日,包括被省略範圍裡的(這份是 01-13、02-01,no_row),所以「沒有那一列」分得出是被省略還是沒資料。coverage 則改寫成完整來源的實際起訖(這次三案都是 01-05 起),不是省略後顯示的第一天。
預算掃描。 8,000 是看過下表後定的(本地估算,days/day25/results.md §1):
| 案例 | 6,000 | 7,000 | 8,000 | 9,000 |
|---|---|---|---|---|
| specific_date | 5,318/7 天/刪 baseline | 6,944/10 天 | 7,994/17 天 | 8,894/23 天 |
| vs_baseline | 5,870/7 天/刪 trailing | 6,958/12 天 | 7,859/18 天 | 8,909/25 天 |
| trend | 5,280/7 天/刪 baseline | 6,875/10 天 | 7,926/17 天 | 8,976/24 天 |
格式是「估計 token/逐日列天數/刪掉的組」。6,000 時會整組刪掉 baseline 或 trailing,兩個條件就會同時差在天數與判定欄位;8,000 時三案都保留全部組,只刪較舊的逐日列。所以這次比較的主要是「60 天對 17–18 天的逐日列」,再加上 builder 多送的 context_selection,不是組的取捨。整組刪減只有單元測試和這張表確認過,沒有送給模型。
計數。 research 查到,Gemini Developer API 的 count_tokens 只能對 contents 計數,config 裡的 schema 帶不進去;對 Day 24 一份請求計得 6,033,與那次的 prompt_token_count 相同(days/day25/count_tokens_check.txt)。但它的配額、算不算進每日請求數都沒有公開,所以這次改用本地估算:字元數 ÷ 2.444,取專案先前 13 筆請求裡最小的字元/token 比,預期會高估 token。8,000 因此只是估計上限,跑完再用 prompt_token_count 核對。
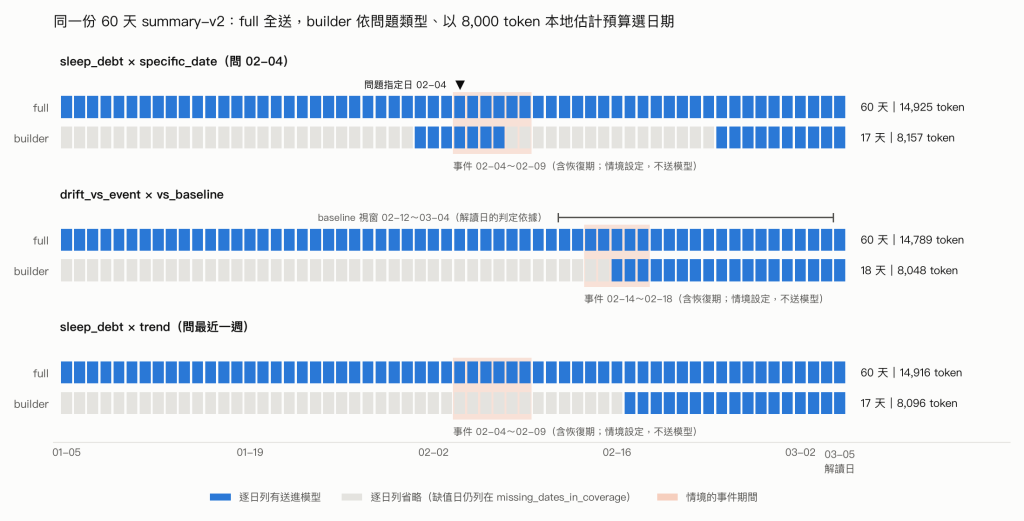
三個案例在 full 與 builder 條件下送進模型的逐日列
同一份 60 天 summary-v2,full 全部送出,builder 依問題類型、以 8,000 token 的本地估計預算選取,保留 17–18 天的逐日列。藍色是送進模型的逐日列,灰色是省略,橘色是情境的事件期間(不送模型)。trend 的 builder 條件不含 2 月初的事件;vs_baseline 的事件只剩 02-16 一天在逐日列裡,但整段仍落在 baseline 視窗內。
實際送出的 token(prompt_token_count,days/day25/results.md §1):full 14,789–14,925,builder 8,048–8,157,約省 45%。本地估算少估了 163–189 token,實際的字元/token 是 2.31–2.40,低於 2.444,所以三份 builder 都略超過 8,000(+0.6%–2.0%)。
驗收。 回應先過 Day 22 的四層驗證(parse、schema、evidence、cross_field),再由 Day 24 的 citation checker 比對引用。比對的對象是各條件實際送出的那份 summary,所以 builder 省略的欄位上的引用不會通過。兩個條件之間用(指標,日期)對齊 claim,不用 path。送出前兩份都過了洩漏檢查。
主要實作在 src/wearable_ai/ai/context.py:selections 列出由少刪到多刪的全部狀態,apply_selection 依狀態挑欄位並寫 context_selection,build_context 依序估算,取第一個在預算內的。
import wearable_ai.ai.context as cx

res = cx.build_context(
    summary,                                   # 完整 60 天 summary-v2
    cx.QuestionSpec("specific_date", "2026-02-04"),
    budget_tokens=8_000,                       # 整份 contents,prompt_token_count 的口徑
    render=lambda c: render(question, c),      # prompt v1 + 輸出格式 + 問題 + 資料摘要
)                                              # 沒給 count 時只用本地估算(2.444 字元/token)
res.selection                                  # 刪了幾天較舊的逐日列、哪些組
res.context["context_selection"]               # 送進模型的省略紀錄
build_context 也可以接 count(例如 llm.GeminiTokenCounter),對成品實際計數、超過就再刪一步,這次沒有用。它最多計數 3 次,仍超過時只回傳 fits=False 的版本,不會擋下,送不送出要由呼叫端檢查 res.fits 決定。重現:
uv run python days/day25/context_demo.py --section 1   # 建輸入、預算掃描,不呼叫 API
uv run python days/day25/context_demo.py --section 2   # 18 次呼叫
uv run python days/day25/context_demo.py --section 3   # 四層驗證與 citation checker
uv run python days/day25/context_demo.py --section 4   # LifeSnaps token 量測,不呼叫 API
uv run python days/day25/plot_timeline.py
| 條件 | 通過四層 | MAX_TOKENS |
thinking token 中位數 |
|---|---|---|---|
| full | 6/9 | 3 | 4,869(9 份) |
| builder | 8/9 | 1 | 2,172(7 份;2 份原值是 null) |
四份失敗都停在 parse,都是 MAX_TOKENS 截斷:輸出加 thinking 達 8,177–8,178,碰到 max_output_tokens 8192。四份裡三份是 trend(full 2、builder 1),一份是 specific_date 的 full。Day 24 同設定 18 份只有 1 份截斷。
同一份輸入的 thinking 長度也差很多(trend 的 full 三次是 579、7,329、7,404),每格 3 次不足以說長輸入會導致截斷。直接的影響是 trend 的 full 只剩 1 份可用,這一題的比較變成 1 份對 2 份。
以下對照 EXPECTED,涵蓋 14 份通過驗證的回應,分開看兩件事:有沒有把日期或判定套錯,以及有沒有回答問題。判讀由 agent 在看過 EXPECTED 與 checker 結果後完成,沒有逐句標註,也沒有獨立的人工檢查。
specific_date(full 2 份、builder 3 份)。 5 份都回報 02-04 三個指標的值(327.29 分鐘、25.14 ms、63.17 bpm),也都說明 baseline 與 deviation 是對 03-05 算的、沒有 02-04 的判定,「無法判定不等於沒有異常」。沒有一份把 03-05 的判定套到 02-04,也沒有提到事件或原因;next_step 都建議以 02-04 為解讀日重算。builder r1 另外拿 02-04 和前一天 02-03 相減(minutesAsleep 少 36.5 分鐘、rmssd 低 13.8 ms、resting_hr 高),沒有下判定;但嚴格照 EXPECTED 的「只回報 02-04」,這已超出範圍,而這次沒有事先訂「相鄰日比較算不算越界」的判準。
vs_baseline(各 3 份)。 6 份都回報 03-05 三項的值、baseline 中心與未標旗;resting_hr 都寫成 58.28 bpm 對中心 64.87,在閾值內或 flag 為 false。6 份都沒有提到 02-14~02-16、沒有說 resting_hr 偏低,也都沒有 next_step。引用 baseline、deviation 或 cross_metric 的 claim,兩個條件都是 21/30。
trend(full 1 份、builder 2 份)。 3 份都沒有提到 2 月初的事件,沒有把舊事件說成近期仍在發生。但 3 份也都沒有回答「最近一週有沒有變化」:只回報 03-05 的值、7 日平均、baseline 狀態與未標旗,既沒有下趨勢結論,也沒有說明摘要沒有趨勢判定所以無法下結論。builder r2 雖然列出 02-27~03-05 七天的逐日值,也沒有說這七天有沒有變化。兩個條件在這一題同樣沒回答核心問題,所以這一題不能用來說刪減後回答品質沒有變。
用(指標,日期)對齊兩個條件引用的逐日列(§8),三個案例「只有 full 引用」的組合都是 0:full 多送的 42–43 天逐日列,14 份回應一次都沒有引用。不過 full 本來就很少引用逐日列,只有 specific_date 的 full 引用了 02-04;沒被引用也不代表那些列對生成沒有影響。
| 條件 | claim | pass | fail | needs_human |
|---|---|---|---|---|
| full | 58 | 22 | 11 | 25 |
| builder | 76 | 32 | 10 | 34 |
21 筆 fail 依原因分組(days/day25/results.md §5):
EXPECTED 一致;觸發 date_unsupported,是因為 02-04 只出現在問題句、逐日列與 builder 的 context_selection.target_date,這些 claim 都沒有引用它們。7-day trailing mean。中文的 7 帶單位「天」,走 count_word(送人工判讀);觸發 number_unsupported 的是英文 7-day 的 7,抽出時沒有單位。這三句只引了 trailing[1].mean,沒有引 window_days,所以視窗長度本來就沒有引用支持。trailing[1].mean 寫進句子,其中的「1」被當成數字,因為遮蔽 path 的規則(grounding._PATH_RE)只認 $ 開頭的寫法。這一類是 checker 規則的問題。baseline.status、baseline.center 或 cross_metric。所以 fail 數不能直接拿來比兩個條件哪個回答比較好,也不能都算成 checker 誤判:只有 trailing[1] 那 3 筆是規則本身的問題;其餘 8 筆是引用不完整,漏引了視窗、日期或其他指標的欄位。specific_date 的 10 筆說明句內容正確,能不能從問題句補取日期,是還沒訂的引用政策。
這一節的分母是 builder 條件通過前三層、能取出 claim 的 8 份回應,共 76 筆 claim。其中 6 筆提到被省略的逐日日期,每一筆的日期都能在送出的 JSON 裡找到出處(days/day25/results.md §7):
baseline.current_window.start。context_selection.omitted。missing_dates_in_coverage。這 6 筆裡沒有一筆把省略範圍說成沒有資料;trend r1 的 next_step 還建議「可調閱 2026-01-05 至 2026-02-16 期間完整的逐日觀測資料」。這個檢查只比對日期字串是否出現在送出的 JSON,不看整句意思、不含 next_step,也不含截斷的 builder trend r3(原文只有 02-27、03-05)。
| 原本以為 | 實際發現 |
|---|---|
| 我原本以為,取先前請求中最小的字元/token 比值 2.444,估出的 token 數應該偏高,足以守住 8,000 的輸入預算。 | 本地估算取專案最小的比值 2.444,builder 三份仍超過 8,000 預算 0.6–2.0%;這批輸入的實際比值是 2.31–2.40,換了內容,最小值也不保證高估。 |
| 我原本以為,8,000 token 會讓 builder 不只刪較舊的逐日列,也得按問題類型捨棄低優先級的統計組,因而能檢查整組取捨。 | 預算 8,000 時三案都保留全部組,只差逐日列天數;這次測到的是歷史長度(60 天對 17–18 天),不是 builder 的組別取捨。 |
| 我原本以為,full 多給的歷史逐日值會提供更多可引用的線索,尤其能幫模型回答最近一週有沒有變化。 | 兩個條件都沒有把日期或判定套錯,但 trend 的 3 份都沒有回答「最近一週有沒有變化」;full 多送的 42–43 天逐日列沒有被引用,而 full 本來就很少引用逐日列。 |
| 我原本以為,兩個條件沿用同一個輸出上限,都能產生足夠的完整 JSON,至少能保留每格三份回應來比較。 | MAX_TOKENS 截斷 full 3/9、builder 1/9;trend 的 full 只剩 1 份可用,比較變成 1 對 2。 |
| 我原本以為,checker 的 fail 大多會指向回答內容與摘要不符,能直接用失敗筆數比較兩個條件。 | checker 的 21 筆 fail 中,10 筆是內容與預期一致的說明句(02-04 不是解讀日),只有 3 筆(trailing[1] 被當成數字)是 checker 規則本身的問題,其餘 8 筆是引用不完整(視窗、日期或其他指標)。 |
| 我原本以為,builder 明列被省略的日期後,模型會在回答裡主動引用這份紀錄,說清哪些歷史逐日值沒送進去。 | builder 8 份回應裡,提到省略日期的 6 筆 claim,日期都對得回送出的 JSON;直接引用省略紀錄的只有 trend r1 一份,其他 4 筆的日期來自 baseline 視窗。 |
這次只有 3 個案例、2 個合成情境與同一人 p01,每個條件各跑 3 次;四種問題類型中的 current 沒有呼叫模型。8,000 token 下,builder 保留全部 trailing、baseline 與 deviation 組,主要刪的是舊逐日列,因此不能由這批回應判斷整組捨棄後是否仍能回答。兩個條件的差別還包括 builder 多送的 context_selection,觀察到的回應差異不能單獨歸因於逐日列變短。三個問題分別需要最近一週、解讀日對 02-12~03-04 baseline 的判定,或一個會被基本資料規則保留的指定日;沒有測到回答必須依賴被省略逐日列的問題。資料排列、銜接句與 tag 也沒有作條件比較。
合成情境的事件與恢復期是設定,不能當成真實生理反應;LifeSnaps 的 11 組只做本地 token 估計,沒有實測 token 或模型回應,不能把合成案例的回答結果推到公開資料或真實使用者。本輪用字元比值選 context,三份 builder 輸入實際都超過 8,000 token;送出前的 count_tokens 只曾對另一份請求核對一次,不能替本輪保證硬上限。18 次呼叫有 4 次因 MAX_TOKENS 無法解析,trend 的 full 只剩 1 份可比較;其餘 3 份可用 trend 回應也都沒有直接回答一週變化。回答是否符合 EXPECTED 是看過預期與 checker 的 agent 判讀,未做獨立逐句標註,所以這些觀察不足以估計一般情境的回答正確率或健康判定能力。
這次的 builder 省下約 45% 的輸入,回答裡沒有出現只有 full 才引用的逐日列。但能說的範圍很窄:本輪問題要用的指定日、近期值與解讀日 baseline,在 builder 條件裡都還看得到;baseline 只摘要自己的估計視窗,不能代替被省略的更早日期,而 trend 那一題兩個條件都沒有真的回答。要看 builder 的取捨規則會不會出錯,下一步得測預算緊到要刪組的情況(例如 6,000),以及要用到被省略逐日列的問題,例如比較兩個相距很遠的日期。
可以直接沿用的是兩件事。第一,省略要寫進 context 本身,而且要和缺值分開:這次 builder 回應裡提到省略日期的 6 筆 claim,日期都對得回送出的 baseline.current_window、context_selection 或 missing_dates_in_coverage,checker 也以送出的那份為準,所以每份 context 可以重建、可以回歸,不必猜模型當時看到什麼。第二,預算要以實際計數為準。字元/token 比隨內容改變,從別天的請求取最小值,在這批輸入仍然少估;build_context 已經留了 count 參數,可以用 count_tokens 對成品再量一次;但它最多量 3 次,仍超過預算時只回傳 fits=False,送不送出要由呼叫端檢查後決定。
Day 26 的回歸可以收進結果三的反例(trailing[1] 與 7-day 的數字抽取、漏引欄位、從問題句補取日期的引用政策),以及 MAX_TOKENS 截斷要怎麼記錄與重跑。修正時都要保留版本,才能分清分數變化來自模型、context,還是評分規則。


 iThome鐵人賽
 看影片追技術