

一次文件材料化實驗裡,執行者交回了輸出與自評。報告寫著修改範圍正確、當階段語意沒有差異;打開實際檔案,卻看到兩個標題黏在同一行:
### CURRENT_GATE — FULL#### C01 — Authority and state
這不代表所有規則都不見了。彙整評估確認主要保護仍在,但章節結構沒有忠實保留。自評與產物回答的問題不同,不能拿其中一個取代另一個。
這次材料化,是把已查明的文章約束整理成下一步可使用的工作說明(Brief)。實驗只允許產生這份說明及報告,沒有授權修改正式文章。本文不重跑那個實驗,只檢查已保存的輸入、輸出與評估紀錄。
應該穩定的是規劃、執行與評估各自的責任;模型名字只記錄當次由誰承擔。
這組紀錄讓三種角色的交付物變得具體:
| 角色 | 應交付什麼 | 不能自行取代什麼 |
|---|---|---|
| 規劃者(Planner) | 輸入範圍、可改區段、必留規則與驗收標準 | 不把「規劃合理」當成輸出已符合 |
| 執行者(Executor) | 限定範圍內的產物、變更說明與未取得的資訊 | 不用自己的完成標籤代替驗收 |
| 評估者(Evaluator) | 原始約束與實際產物的對照、差異及限制 | 不把另一份自評當成獨立證據 |
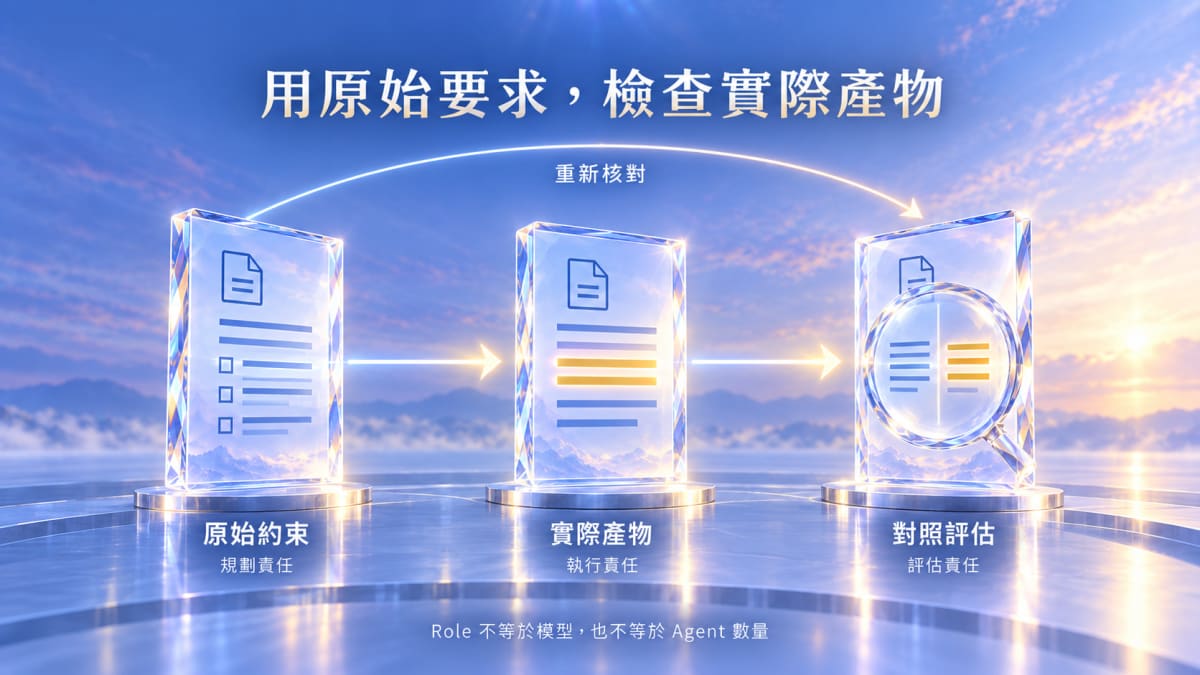
這次的工作契約把當階段必要規則保留全文,其他階段只保留識別碼、階段與延後狀態。若執行者為了「更完整」把後續規則全部補回,即使每句話都正確,也偏離了本次要驗證的範圍。
評估者因此需要同時檢查內容與結構:保護條款是否還在、應延後的內容有沒有提早展開、標題是否仍讓下一位讀者分辨規則群組。這些檢查不能只問「摘要好不好看」。
上述輸出的自評將自己歸為修改適中;彙整評估則把它列為結構不符合要求。兩者差別不只是意見不同:實際檔案中的標題黏接,可以重新打開確認。
還有另一個限制。部分執行報告沒有拿到實驗原定問題的完整文字,回答的是自行對應的問題集。評估者可以從產物補做靜態檢查,卻不能把補做結果說成「執行者當時已完成相同測試」。
這裡的獨立性首先是證據來源獨立:用原始要求與產物檢查完成聲明,而非只重新閱讀執行者的結論。多叫一個模型,如果仍只餵它那份結論,也可能只是多得到一次同意。
三種責任可以由同一個 Agent 在不同階段承擔。小範圍文件修改,先固定驗收條件,再修改,最後重新載入條件檢查,未必要增加同時工作的 Agent。
需要分開評估時,交接內容至少包括:
原始要求與驗收條件
允許/禁止修改的範圍
原始輸入與實際產物
執行者的說明
尚未取得的證據
要特別保留前兩項。若交接只剩「我改好了,請 review」,評估者就必須猜哪些差異是要求、哪些差異是越界。
分開的執行環境可能幫助評估者避免沿用同一套假設,但這組材料沒有 runtime audit,不能證明每輪完全沒有相互影響,也沒有量到獨立評估增加或節省多少時間。
實驗報告記錄了不同的請求模型設定,但部分實際執行時的模型識別碼與推理強度沒有被執行環境揭露。它們只能作為請求與回報的設定紀錄,不能補成完整的模型能力排名。
選擇由誰承擔角色時,可以先問:
「高階模型負責想、便宜模型負責做」可以是一個待測的安排;沒有成功率、重試與時間資料,就不能直接說它更划算。
OpenAI 在 2026-10-02 的 GPT‑6 系列指南裡,模型選擇本身就是依 workload 做取捨,而不是先替每個模型指定永久職位:
| 官方定位 | 較適合的工作 |
|---|---|
| GPT‑6 Astra | 最高難度、最需要智慧能力的推理 |
| GPT‑6.1 Sol | 複雜程式設計、研究與 computer use |
| GPT‑6 Luna | 大規模、範圍清楚、重複性高的工作 |
同一個模型還能再調 reasoning effort:低強度適合例行抽取或小修改,中等用在規劃與比較,高強度放在困難除錯與深入審查;只有改善值得額外時間與成本時,才繼續提高。
這和「Planner 固定用最強模型、Executor 固定用便宜模型」不同。比較穩的做法是先固定 Role 的交付責任,再按任務難度、工具需求、成本與延遲選 model × reasoning:
Role responsibility
        ↓
Task difficulty / tools / latency / cost
        ↓
Model + reasoning effort
因此,同一個 Executor 角色可以因任務從簡單格式化切到複雜除錯而換模型或提高推理強度;Planner 也不因名稱叫 Planner,就必須永遠使用最昂貴配置。
這份官方定位仍不是本系列的模型排行榜。它沒有證明哪個模型在本文材料化實驗一定更好,也不能替缺少的成功率、重試、時間與成本對照補數字。
這次實驗留下的可用成果,是一個可重查的責任分界:執行者產生了什麼,評估者看到了哪個差異,哪些結論因缺證據而不能成立。
下一次換模型,原始要求、允許範圍與驗收標準仍可保留。若只把角色命名清楚,卻沒有這些交付物,工作流仍會隨每輪自評漂移。
下一篇再問規模問題:把工作拆給更多 Agent 之後,節省的執行時間,是否足以抵銷交接與整合成本?


 iThome鐵人賽
 看影片追技術