
前幾天我們透過 Confusion Matrix 和 Error Analysis,發現模型雖然有約 74% 的 Test Accuracy,但對不同皮膚病灶類別的辨識能力差異很大。
例如,模型經常將 mel 和 bkl 預測成 nv。
於是我開始想:
如果增加 CNN 的層數,讓模型學習更多影像特徵,分類結果會不會更好?
所以今天要介紹 CNN 的模型架構,以及 Layer、Filter、Kernel 和 Parameters 之間的關係,最後實際比較不同深度的 CNN。
前面我們已經使用過 Conv2D 和 MaxPooling2D。
其中,Conv2D 主要負責從圖片中學習特徵,而 MaxPooling2D 則會縮小 Feature Map 的空間尺寸,保留局部區域的重要資訊。
在 CNN 中,不同深度的 Convolution Layer 有機會學習不同層次的影像特徵。
例如較淺的 Layer 學到了邊緣、顏色變化、簡單紋理,較深的 Layer則組合前面學到的特徵,形成更複雜的影像表示。
因此增加 Layer,可能讓模型學習更複雜的特徵,但不代表一定能提升分類效果。
在 Conv2D 中,我們常常看到:
tf.keras.layers.Conv2D(filters=32,kernel_size=(3, 3),activation="relu",padding="same")
這裡有兩個重要參數:
| 參數 | 作用 |
|---|---|
| Filter | 決定這一層要學習多少組不同的特徵 |
| Kernel Size | 決定每次運算觀察的局部區域大小 |
例如 filters=32 會產生 32 張 Feature Map,而kernel_size=(3, 3)代表每次觀察 3×3 的局部區域,Filter 數量增加,模型就有機會學習更多不同的特徵,但需要的計算量和 Parameters 通常也會增加。
Parameters(參數)是模型在訓練過程中需要學習的數值,例如 Weight 和 Bias。
以 Conv2D 為例,參數數量與 Kernel Size、輸入 Channel 數量及 Filter 數量有關。
假設輸入是 RGB 圖片:
Kernel Size = 3×3
Input Channel = 3
Filter = 32
則參數數量為:
(3×3×3 + 1) × 32 = 896
其中 +1 代表每個 Filter 的 Bias,當模型增加 Layer 或 Filter 時,Parameters 通常也會跟著增加,不過 Parameters 越多,並不代表模型一定越好。
Model Complexity(模型複雜度)可以從模型深度、寬度、參數數量及計算需求等不同角度理解。
一般來說,增加 CNN 的 Layer 或 Filter,可能提高模型學習複雜特徵的能力。
但同時也可能帶來:
因此我們要思考的是:
增加模型複雜度後,是否真的能改善它對新資料的分類表現?
這次延續前面的 HAM10000 Dataset,建立兩個不同深度的 CNN。
模型一:原本的 CNN
Input
↓
Conv2D(32) → MaxPooling
↓
Conv2D(64) → MaxPooling
↓
Flatten
↓
Dense(128)
↓
Dropout(0.5)
↓
Output(7)
模型二:增加一層 CNN
Input
↓
Conv2D(32) → MaxPooling
↓
Conv2D(64) → MaxPooling
↓
Conv2D(128) → MaxPooling
↓
Flatten
↓
Dense(128)
↓
Dropout(0.5)
↓
Output(7)
這次兩個模型都保留 Dropout(0.5),並使用相同的資料切分與訓練設定。
主要差異是第二個模型多了一組 Conv2D 和 MaxPooling2D。
因此可以觀察:增加 CNN 深度後,是否能讓模型學到更有用的影像特徵?
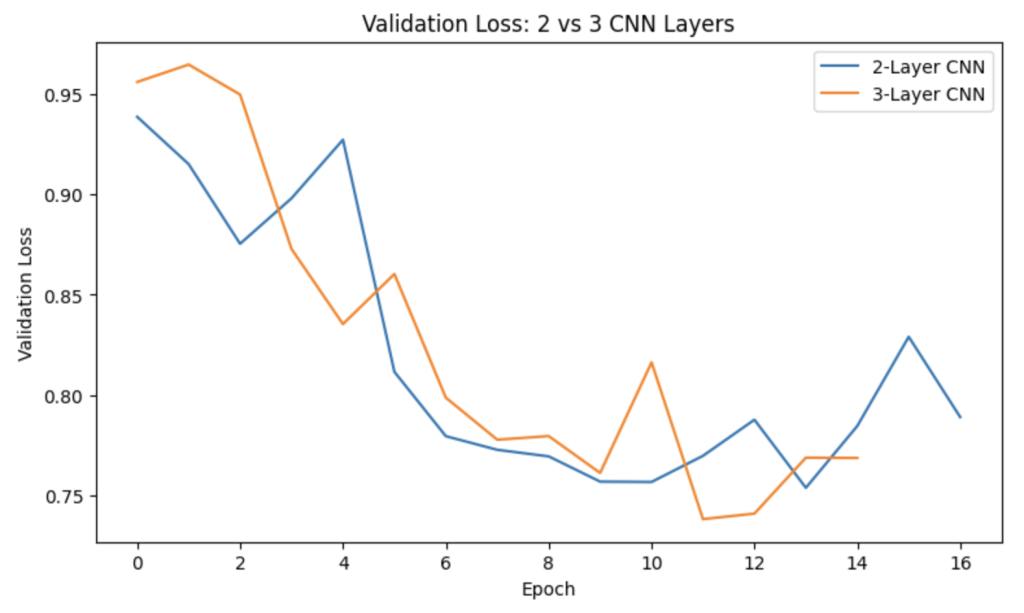
將 2-Layer CNN 和 3-Layer CNN 的 Validation Loss 畫在一起後,可以看到兩個模型的訓練過程有所不同。
2-Layer CNN 的 Validation Loss 前期下降較快,但中間出現一些波動,後期也有回升的情況。
3-Layer CNN 前期下降較慢,不過隨著訓練進行,Validation Loss 逐漸降低,並在後期達到約 0.74,比 2-Layer CNN 的最低值約 0.76 略低。
這表示在這次實驗中,增加一層 Convolution Layer 後,模型有機會學習到更適合目前資料的影像特徵,但仍不能只根據這張曲線就認定更深的模型一定比較好。
最後使用相同的 Test Data,比較兩個模型的分類結果:
| 模型 | Test Loss | Test Accuracy |
|---|---|---|
| 2-Layer CNN | 0.6988 | 74.43% |
| 3-Layer CNN | 0.6997 | 74.97% |
從結果可以看到,3-Layer CNN 的 Test Accuracy 從 74.43% 提升到 74.97%,約增加 0.54 個百分點。
不過 Test Loss 並沒有跟著降低,反而從 0.6988 小幅增加到 0.6997。
這代表增加 CNN 的深度後,雖然這次分類正確率稍微提高,但並不是所有評估指標都有改善。
因此,這次實驗可以得到一個結論:
增加 CNN 的 Layer 可能改善模型表現,但並不保證所有指標都會變好。
今天我們認識了 CNN 的 Layer、Filter、Kernel、Parameters,以及 Model Complexity 的概念。
增加 Layer 可能讓模型學習更複雜的影像特徵,但也會改變模型的參數數量與計算需求。
因此CNN 並不是疊得越深就一定越強,還是需要透過實驗確認。
下一篇,我們將介紹 Transfer Learning,看看能不能利用已經在大量圖片上學習過的模型,改善目前的皮膚病灶分類結果。


 iThome鐵人賽
 看影片追技術