
昨天我們利用 Confusion Matrix,觀察 CNN 對 HAM10000 七種皮膚病灶的分類結果,從結果中發現,模型雖然有約 74% 的 Test Accuracy,但不同類別的辨識能力差異很大。
nv:996 張中有 957 張預測正確mel:187 張中只有 24 張預測正確mel:有 133 張被誤判成 nv
但你會不會好奇:
那些被模型判斷錯誤的圖片,到底長什麼樣子?它們有什麼共同特徵?
所以今天要介紹 Error Analysis(錯誤案例分析),把模型預測錯誤的圖片找出來,實際觀察模型可能遇到了什麼問題。
Error Analysis 就是分析模型預測錯誤的案例,試著找出可能影響模型判斷的原因。
前面我們使用 Accuracy、Loss 和 Confusion Matrix 評估模型,但這些數字並不能直接告訴我們圖片本身有什麼特徵。
因此這次不只看數字,而是把預測錯誤的圖片實際顯示出來。
我們可以觀察:
不過要注意,這些都只是可能的影響因素,不能只靠觀察幾張圖片,就認定它們是模型預測錯誤的真正原因。
這次延續 Day25 的程式,直接比較 Test Data 的真實標籤與預測標籤。
import numpy as np

# 找出預測錯誤的圖片索引
wrong_indices = np.where(y_test != y_pred)[0]

print("Test Data 總數:", len(y_test))
print("預測錯誤數量:", len(wrong_indices))
只要 y_test 和 y_pred 不相同,就代表這張圖片被模型預測錯誤。
接下來將部分錯誤圖片顯示出來,並標示:
這樣就能直接比較模型把哪一種病灶誤認成其他類別,由於錯誤圖片可能很多,文章中先展示部分代表性案例,其他圖片則可以繼續透過程式檢視。
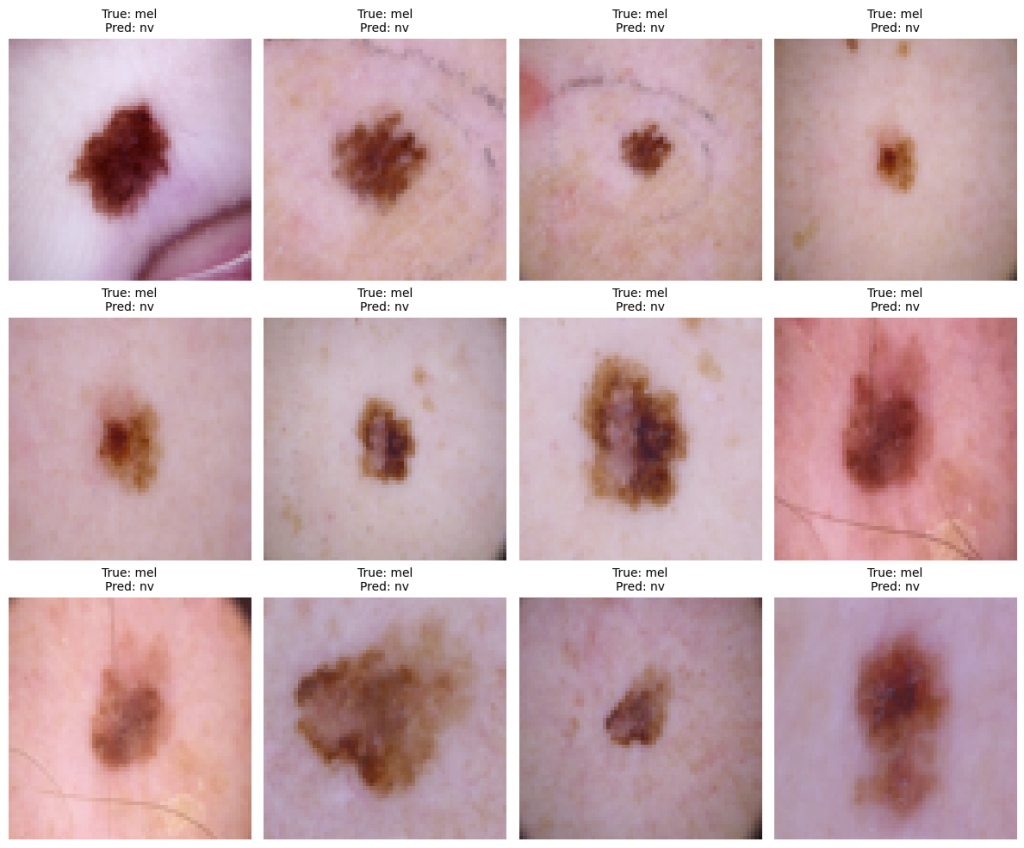
從 Day25 的 Confusion Matrix 發現,187 張 mel 中有 133 張被模型預測成 nv,因此這次特別將部分錯誤案例找出來觀察。
從圖片可以看到,有些病灶呈現深褐色,也有些病灶範圍較小,周圍包含大面積正常皮膚。部分圖片的病灶邊界並不規則,但模型仍然將它們判斷成 nv。
這讓我開始思考,模型是否過度依賴某些顏色或形狀特徵,而沒有充分學習不同類別之間的差異。
不過目前只能從圖片觀察到這些現象,還不能確定它們就是造成誤判的原因。
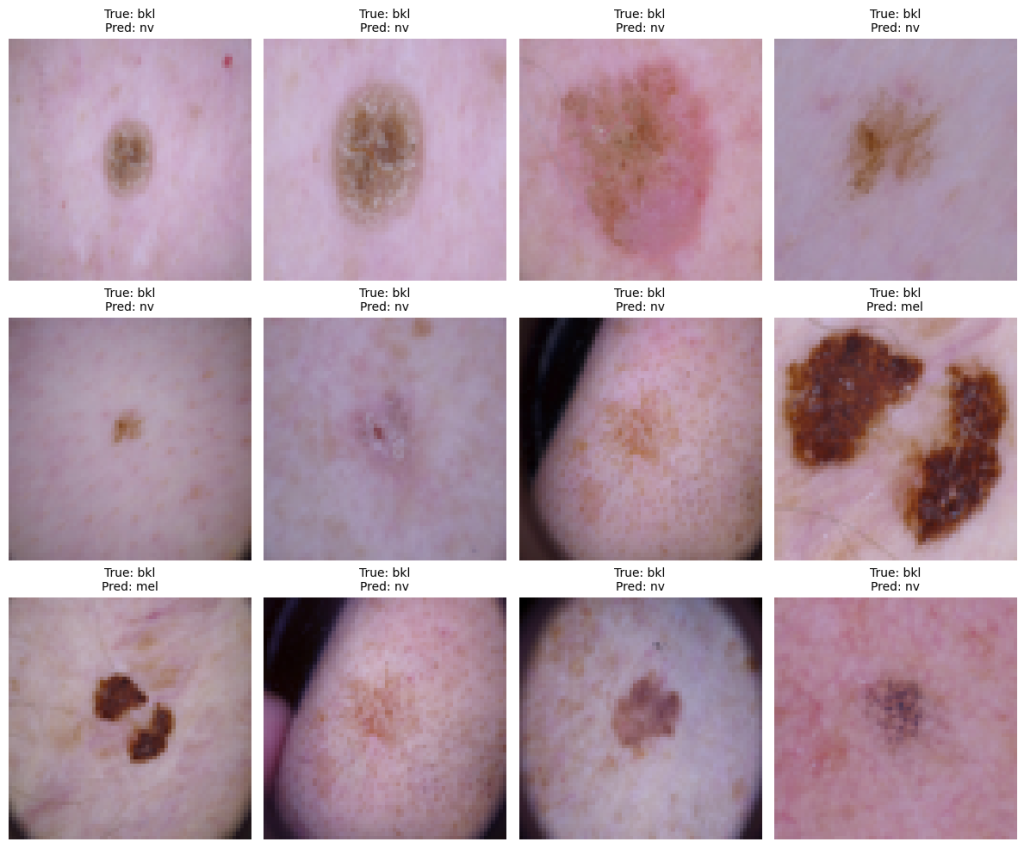
除了 mel,Day25 的結果也顯示,152 張 bkl 中有 70 張被預測成 nv。
從這次找出的圖片可以看到,有些病灶顏色較淡,與周圍皮膚的差異不明顯;也有部分病灶呈現較深的褐色,甚至被模型預測成 mel。
這些案例顯示,即使屬於同一個類別,病灶的顏色、大小與外觀仍可能有很大的差異。
因此,模型需要學習的可能不只是單一的顏色或形狀,而是不同影像特徵之間的組合。
經過這次觀察,我發現模型的錯誤並不是平均分布在各種類別,而是有不少 mel 和 bkl 被預測成 nv。
這也呼應了前面 Class Imbalance 的問題:模型可能比較容易學到資料量較多類別的特徵,但對其他類別的辨識能力仍然不足。
不過,Class Imbalance 是否就是造成這些錯誤的主要原因,還需要透過後續實驗確認。
這次的 Error Analysis 讓我了解到,除了觀察 Accuracy 和 Loss,也需要實際檢查預測錯誤的圖片,才能進一步思考模型有哪些值得改善的地方。


 iThome鐵人賽
 看影片追技術