

一份工作說明變短了,能不能就說 Agent 成本下降?
一份長期維護的 Repository 留有一組規則材料化實驗:把當階段需要的規則保留全文,後續階段只留下識別碼、階段與延後狀態。2026-10-03 重新讀回來源與其中一份候選,統一行尾後計算,文字長度確實下降。
| 本輪可重算的項目 | 結果 |
|---|---|
| 來源工作說明 | 46,117 |
| 候選工作說明 | 31,319 |
這裡的單位是 UTF-16 碼元,與 JavaScript 字串的 .length 相同;計算對象是這次讀回、行尾統一為 LF 的文字,不是原始檔案位元組或模型 Token。原報告使用的部分字數不同,這裡不混用原報告的縮減百分比。
但下一個問題沒有答案:模型是否少花時間?接手者是否更快找到下一步?原始紀錄沒有提供 Token、延遲與工具呼叫用量,也沒有人的理解時間。
Context 成本要看重新進入正確狀態的代價;文字變短,只證明其中一個輸入變小。
模型可使用的上下文(Model Context)與人的理解(Human Comprehension)是兩種不同資源。
上述候選把後續階段規則的全文延後展開,能讓當階段的工作說明較集中。但人還需要知道:這輪停在哪個階段、哪些事尚未驗證、下一步是否有權執行。若只把細節移到別處,卻沒有留下清楚入口,接手者仍可能花時間搜尋。
這組實驗的候選保留了「主要證據尚待重查,正式文章不可修改」的限制。靜態評估可以檢查這條決策是否仍可從文件讀出,卻沒有證明下一位接手者實際花多久、是否答對、需要回查幾次。
2026-10-08,我把完整來源與精簡 Brief 分別交給兩個獨立 Agent session,各自回答同一組預先固定的五題;兩個 session 都答對 5/5。這只支持這兩次 Agent session 在指定題目上的文件重建結果,不是真人理解實測,也不能推論時間或 Token 節省。評分鍵與逐題回答保存在 notes。
2026-10-02,explainx.ai 的二手整理將 Andrej Karpathy 一則公開貼文的觀點概括為:模型承擔更多工作後,人會更常理解與監督模型輸出。這是值得檢驗的表示層假設,不是本篇的實驗結果。
該整理列出四種輸出形式:受控、簡化的技術寫作、圖解、互動式 HTML,以及客製化解說影片。第一種借用了 ASD-STE100 Simplified Technical English 的概念。STE 原本為航空維修文件而發展,首版 AECMA Simplified English Guide 在 1986 年發布,透過寫作規則與受控詞彙降低歧義。
放回 Agent 工作流,我會把它理解成一個表示層的選擇,而不是新的固定模板:
| 要理解的東西 | 較可能適合的輸出 |
|---|---|
| 一段明確結論或操作限制 | 簡潔、低歧義文字 |
| 流程、依賴、狀態轉移 | 圖解 |
| 需要點選、篩選、比較的結果 | 互動式 HTML |
| 需要建立完整心智模型的複雜概念 | 解說影片 |
這裡仍然不能直接宣稱「換成圖或網頁就比較快」。至少要量測同一批讀者完成同一理解任務的正確率、時間與回查次數。但它補上一個原本五類成本表沒有直接寫出的變數:Human Comprehension 不只受內容多少影響,也受 representation 影響。
換句話說,Context compression 處理的是「模型和任務要帶多少內容」;representation design 處理的是「人最後要用什麼形式接住結果」。兩者都可能降低負擔,也都需要 Evidence 才能證明。
OpenAI 的 GPT‑6 指南把兩種正式環境做法直接放進成本管理:對重複工作使用 prompt caching;對較長對話使用 compaction,讓上下文縮小但保留繼續執行需要的狀態。
這能補強 Model Context 這一側,但仍不能替本文回答 Human Comprehension。模型少讀了多少 Token,和人重新進入任務時是否少開文件、少問問題、少誤判狀態,是不同量測。
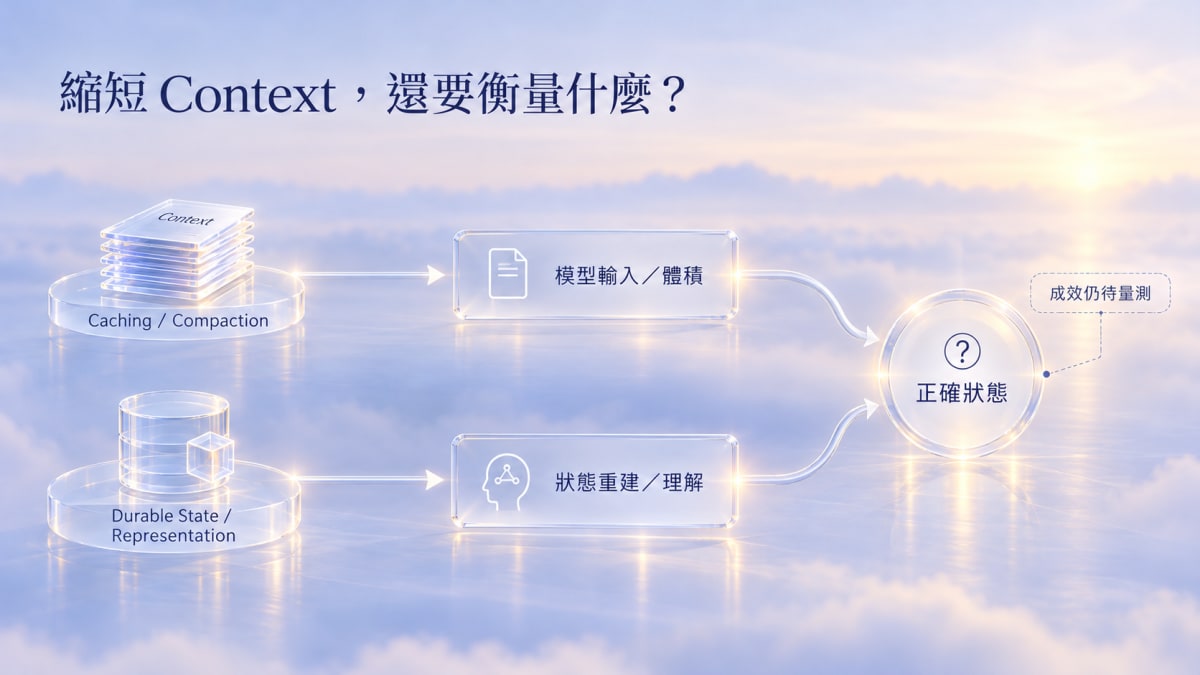
問題可以拆成:
Caching / Compaction
→ 模型輸入複用與上下文體積

Durable State / Representation
→ 人與 Agent 是否更容易重建正確狀態
官方也建議刪掉任務不需要的上下文,同時保留必要佐證。它支持「不是塞越多越安全」這個方向;但本篇現有 46,117 → 31,319 仍只是文字材料大小變化,不升級成 token、latency 或 human-time 成果。
| 成本 | 應觀察什麼 |
|---|---|
| 模型用量 | 實際輸入與輸出 Token,不能用字數直接代換 |
| 等待時間 | 搜尋、讀檔、工具執行與驗證的經過時間 |
| 重試 | 因缺少上下文或誤解狀態而重做哪些步驟 |
| 除錯 | 錯誤假設進入產物後,追查與修正花了什麼代價 |
| 人的理解投入 | 能否判斷現況、限制與下一步,需要多少回查與澄清 |
這五項不適合直接相乘成一個分數。時間、次數、Token 與答題正確性是不同量綱,先分開記錄才知道變更改善了哪一項,又把成本轉移到哪裡。
例如規則文件少了很多字,接手者卻要另外開三份來源才能判斷可不可以寫檔,便不能只憑輸入較短宣稱端到端更省。
現況、決策與交接紀錄的價值,可以落到一次重新進入任務的檢查。
讓接手者只取得指定的工作包與允許查閱的來源,先回答:
哪一個狀態已被驗證?
哪個結果仍缺證據?
下一個安全動作是什麼?
哪些動作不在授權內?
如果資料矛盾,應回查哪一個來源?
比較完整來源與精簡工作包時,需固定相同任務、起始狀態與問題;記錄回答是否正確、耗時、搜尋/讀取次數、澄清與重試。若兩輪由同一人或同一段上下文接手,要揭露先讀過答案的影響。
這才有機會區分「文件較短」與「狀態較容易重建」。截至這次整理,這組對照仍未完成。
有明確答案的檢查可以交給確定性工具;但工具是否減少重複工作,仍要看整輪的讀取、重試與等待紀錄,不能由工具存在直接推算。
另一個常見方向是把所有歷史都留在上下文。它也需要付出代價:舊方案、過期狀態與目前有效規則若沒有分開,接手者得先判斷哪些內容還能使用。
材料化實驗選擇保留當階段必需內容,並讓延後規則仍可定位。這是一種候選設計;若來源更新或任務換階段,工作說明就須重新編譯,不能把精簡快照當成永久正本。
這次可以確認的,是指定候選在一致計數方式下比來源短,以及文件仍寫著重要的停止邊界。
仍缺少的是:實際模型用量、重新讀取次數、重試、等待時間,以及人重新理解系統的對照。原報告中的靜態規則覆蓋,也不能代替這些結果。
因此,本篇不使用單次額度消耗推算整體成本,不宣稱壓縮已改善效率,也不把尚未完成的記憶實驗寫成成果。補證前,候選可以保留,效果仍待量測。
下一篇會處理狀態跨時間延續的另一個問題:中斷後如何知道哪一步可繼續,哪一步必須先重新查證?


 iThome鐵人賽
 看影片追技術