
今天要介紹的是動態規劃 (Dynamic Programming)~
Day 13 介紹遞迴的時間複雜度時有提到一個問題,有些遞迴寫法會重複計算相同的子問題,導致處理時間變長。今天就用 Fibonacci 數列來看看這件事。
如果要寫出 Fibonacci 數列,照著定義寫成遞迴只要短短幾行程式,算 fib(7) 時函式總共被呼叫 41 次,但 n 如果增加到 25,呼叫次數就變成 242,785 次。同樣一支函式,為什麼 n 大一點,呼叫次數會多出這麼多呢?
Fibonacci 數列 (Fibonacci Sequence) 從 0、1 開始,之後的每個數字都是前兩個數字相加:
0, 1, 1, 2, 3, 5, 8, 13, 21, ...
如果把第 n 個數字(從 0 開始數)寫成 fib(n),這個規則可以寫成:
fib(0) = 0
fib(1) = 1
fib(n) = fib(n - 1) + fib(n - 2),n ≥ 2
例如 fib(7) 就是 fib(6) + fib(5),也就是 8 + 5 = 13。
上面的定義直接寫成程式碼會長這樣:
function fib(n) {
  if (n <= 1) return n;
  return fib(n - 1) + fib(n - 2);
}
第一行是 base case,n 為 0 或 1 時直接回傳 n,剛好對應 fib(0) = 0 與 fib(1) = 1;第二行是 recursive case,把 fib(n) 拆成 fib(n - 1) 與 fib(n - 2) 兩個子問題。和 Day 13 的 factorial 相比,差別在於 fib 的 recursive case 裡呼叫了自己兩次。
這段程式算出來的答案正確、沒什麼問題,fib(7) 會回傳 13。
前言有提到執行 fib(7) 時函式總共被呼叫 41 次,這呼叫次數是我們在函式第一行加上一個計數器、每呼叫一次就加 1 數出來的:
let calls = 0;

function fib(n) {
  calls++;
  if (n <= 1) return n;
  return fib(n - 1) + fib(n - 2);
}

fib(7);
console.log(calls); // 41
把 fib(7) 換成 fib(25),同一個計數器數出來就是 242,785 次。那這些呼叫都在算什麼呢?
fib(7) 會呼叫 fib(6) 與 fib(5),fib(6) 又會呼叫 fib(5) 與 fib(4),每一次呼叫都再分出兩個呼叫,直到碰到 fib(1) 或 fib(0) 這兩個 base case 為止。把每一次呼叫當成一個 node、它呼叫出來的兩個當成 child,整個展開過程就是一棵 Tree:
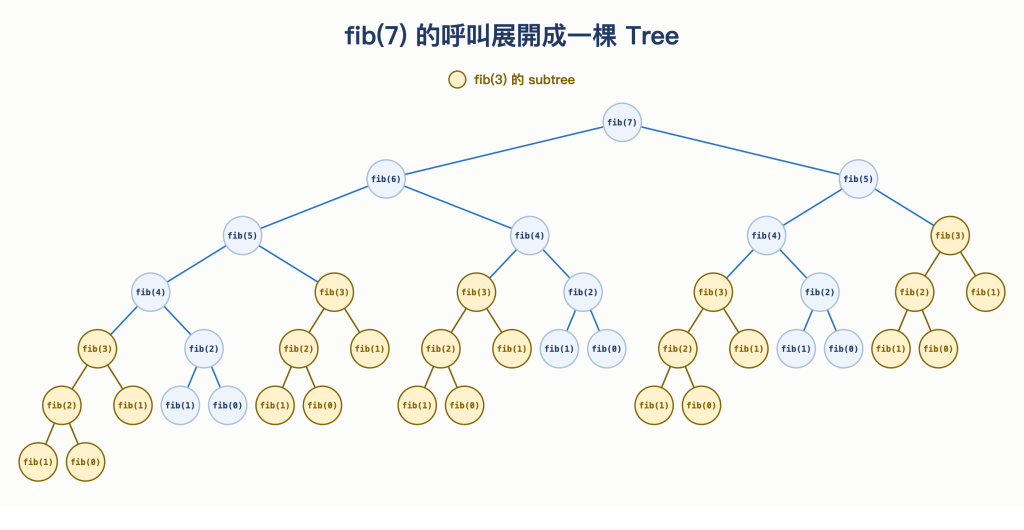
圖 1 fib(7) 的呼叫展開成一棵 Tree
從圖中可看出,最上面幾層就已經有重複了。fib(7) 右邊那個 fib(5),和 fib(6) 底下那個 fib(5),是同一個子問題,卻是兩次各自獨立的呼叫,各自又會展開成一整棵一模一樣的 subtree。越往下重複就越多,例如 fib(3) 在整棵 Tree 裡出現了 5 次,每一次都從頭展開成同樣的 5 個呼叫。
把 41 次呼叫依照參數分類,就能看出重複的程度如下:
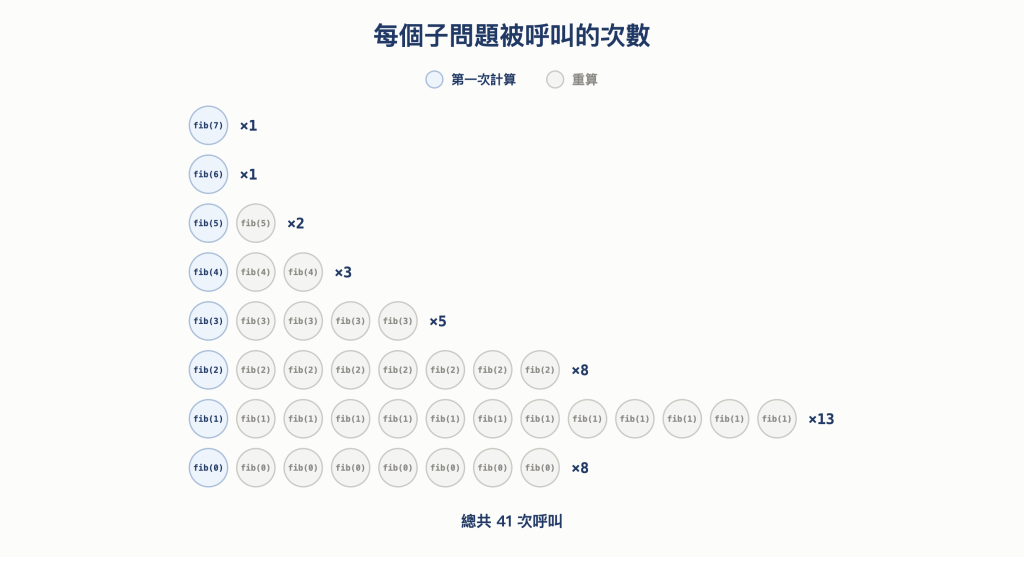
圖 2 每個子問題被呼叫的次數
越小的子問題被算得越多次,但其實真正不同的子問題只有 fib(0) 到 fib(7) 這 8 個,也就是說,41 次呼叫裡有 33 次都在重算已經算過的東西。
不同的遞迴分支需要同一個子問題的答案,但每一次都要重新算一遍,這個多此一舉(?的行為就是這支函式慢下來的原因。這狀況稱為 Overlapping Subproblems:
重疊子問題 (Overlapping Subproblems):不同的遞迴分支需要相同的子問題,導致同一個計算被執行好幾次。
聽起來遞迴缺點多多(?,但並不是每個遞迴都有這情況。Day 13 的 factorial(4) 往下只會經過 factorial(3)、factorial(2)、factorial(1) 各一次,每個子問題都只出現一次;而 Fibonacci 則是每一層分成兩支,而兩支需要的子問題大量重疊,呼叫次數才會因此膨脹得這麼快。
先看時間。每次呼叫最多再分出兩個呼叫,而從 fib(n) 一路往 fib(n - 1) 走到 fib(1) 最多只有 n 層,所以整棵 Tree 的呼叫次數不會超過 1 + 2 + 4 + ⋯ + 2^(n-1),也就是少於 2^n 次,而每次呼叫本身最多只做一次比較與一次加法,因此時間複雜度是 O(2^N)。這裡用的是 Day 02 說的漸近上界,所以 fib(7) 實際的 41 次比 2^7 = 128 少並不衝突。
O(2^N) 的特徵是 n 每增加 1 就多長出一層要展開的呼叫,呼叫次數會以倍數成長,這也是前言那情境裡,n 從 7 增加到 25 只多了 18,呼叫次數卻從 41 次變成 242,785 次的原因。
再來看空間。整棵 Tree 雖然有 41 個 node,call stack 卻不會同時有著整棵 Tree。之前講遞迴時提過,一個呼叫回傳之後那一層就會被移除,所以同時存在的只有從最上面到目前這個呼叫的那條路徑。以 fib(7) 來說,要等 fib(6) 底下全部算完、回傳之後,才輪到右邊的 fib(5) 被呼叫,這時左半邊用過的 frame 就已經收掉了。最長的一條路徑是 fib(7) 一路到 fib(1) 的 7 層,所以額外空間是 O(N)。
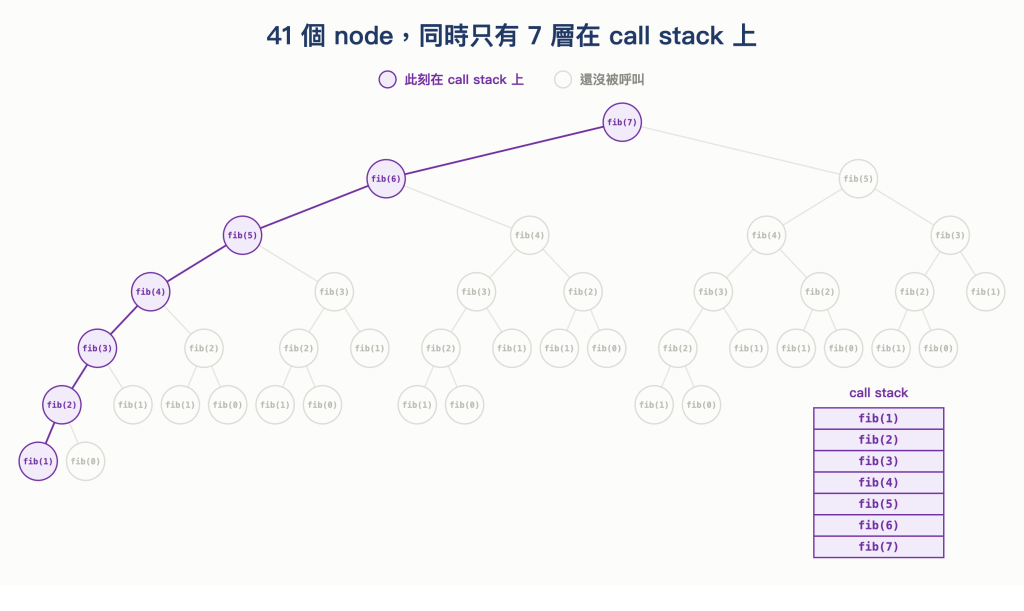
圖 3 41 個 node,同時只有 7 層在 call stack 上
補充一點,上面的分析把每個數字當成固定大小、每次加法當成固定成本。JavaScript 的 Number 能精確表示的整數上限是 Number.MAX_SAFE_INTEGER,Fibonacci 算到 fib(78) 都還在範圍內,但如果是 fib(79) 就超過了,算出來的會是 14472334024676220,而正確答案是 14472334024676221。所以今天的程式都以 n 是 0 到 78 之間的整數為前提,Number 並不能精確表示任意大的 Fibonacci 數。
既然問題在於同個子問題被重複計算,那只要想辦法讓每個子問題只算一次就好。動態規劃就是這樣的優化技巧,它不改變問題的答案,而是節省重複的計算:
動態規劃 (Dynamic Programming):針對可以用遞迴描述、而且有重疊子問題的問題,確保同一個子問題不會被重複計算。
做法主要有兩種:
首先先來看看 Memoization~
要避免重複計算,最直覺的想法就是把算好的結果存進變數,之後要重用就從變數取。但不同呼叫算出的結果,要能留給後面的呼叫共用,因為重複發生在不同的分支之間:fib(6) 底下那個 fib(5) 算完、整層回傳之後,fib(7) 才會呼叫右邊那個 fib(5),函式呼叫的每一層區域變數只有那一層自己看得到,函式一回傳就跟著收掉,所以前一次算出來的 fib(5) 留不到後面這次呼叫。
我們需要的是一個所有呼叫都能共用、且能存下很多筆結果的地方。這裡我們可用 Hash Table 來存,以 n 當 key、fib(n) 的結果當 value,在 JavaScript 實作上可以用 Map,而這份用來存結果的表一般稱為 memo。
加上 memo 之後,每次要計算 fib(n) 的流程變成這樣:
n 是不是已經在 memo 裡fib(n - 1) 與 fib(n - 2) 算出結果fib(n) = fib(n - 1) + fib(n - 2) 這個關係沒有改變,改變的是往下展開之前會先查看 memo,已經算過的子問題就不再展開。
將 memo 的邏輯加入 fib 後,程式碼如下:
function fibMemo(n, memo = new Map()) {
  if (n <= 1) return n;
  if (memo.has(n)) return memo.get(n);

  const result = fibMemo(n - 1, memo) + fibMemo(n - 2, memo);
  memo.set(n, result);
  return result;
}
呼叫時只要寫 fibMemo(7),第二個參數會用預設值建立一個空的 Map。這裡用的是 Day 13 介紹過的傳入額外參數,往下傳的是同一份 memo。
程式的順序和上面的流程一樣,base case 先處理,接著查 memo,查不到才往下遞迴,算完再用 memo.set 存起來。判斷有沒有算過時用的是 memo.has(n),問的是「這個 key 存不存在」,而不是拿 memo.get(n) 回傳的值判斷真假。這個版本的 memo 只會存 n 大於等於 2 的結果,值都大於 0,兩種寫法剛好一樣;但如果之後把 fib(0) = 0 也存進 memo,if (memo.get(0)) 就會把合法的 0 當成還沒算過。
memo.set 改的是大家共用的那一份 Map,不是替某一層的變數重新指定新的值,所以每一層拿到的都是同一個物件,某個分支存進去的結果,另一個分支馬上就能查到。反過來說,如果遞迴時漏傳了 memo,每一次呼叫都會用預設值另外建一個空的 Map,存進去的結果沒有別的呼叫看得到,就又回到重算的狀態了。
執行看看 fibMemo(7),流程如下:
fibMemo(7) 查不到 memo,往下呼叫 fibMemo(6),一路往左呼叫到 fibMemo(2),這段路上 memo 還是空的,什麼也查不到fibMemo(2) 呼叫 fibMemo(1) 與 fibMemo(0),兩個都是 base case,得到 1 + 0 = 1,把 fib(2) = 1 存進 memofibMemo(3),右邊的 fibMemo(1) 也是 base case,得到 1 + 1 = 2,存進 memofibMemo(4),右邊需要的 fib(2) 這次查得到,直接拿到 1,得到 2 + 1 = 3,存進 memofibMemo(5) 右邊查到 fib(3) 是 2,fibMemo(6) 查到 fib(4) 是 3,fibMemo(7) 查到 fib(5) 是 5,最後得到 8 + 5 = 13
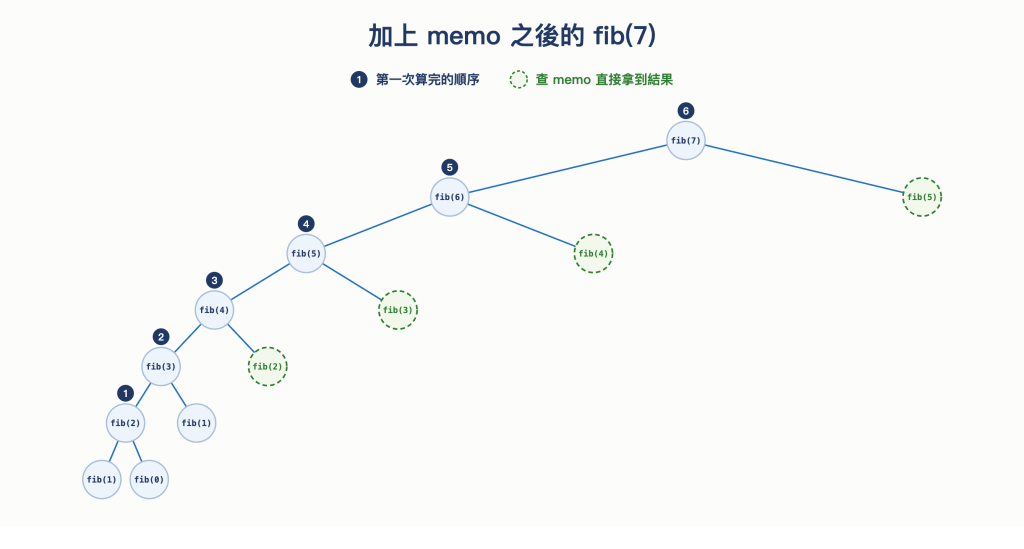
圖 4 加上 memo 之後的 fib(7)
和圖 1 比起來,右邊那些原本要整棵展開的 subtree,現在都在查到 memo 的那刻就停住了。
fibMemo(7) 總共呼叫了 13 次,其中 fib(2) 到 fib(7) 真正計算的有 6 次,查 memo 查到的有 4 次,base case 有 3 次。這個數字也可以直接推出來,查到 memo 與碰到 base case 都會直接回傳、不再發出新的呼叫,所以除了最外面那一次,其他呼叫都是由「真正計算」的那幾次發出的。而 fib(2) 到 fib(n) 共 n - 1 個子問題各計算一次、每次發出兩個呼叫,所以 n 大於等於 1 時,總共是 1 + 2 × (n - 1) = 2n - 1 次。
比較兩個版本的呼叫次數,差別如下:
n |
fib |
fibMemo |
|---|---|---|
| 5 | 15 | 9 |
| 7 | 41 | 13 |
| 10 | 177 | 19 |
| 25 | 242,785 | 49 |
呼叫次數是 2n - 1,而每次呼叫做的事是查一次 memo,最多再加上一次加法與一次存入。Map 的查詢與存入平均是 O(1),所以每次呼叫都是固定成本,整體時間複雜度是 O(N)。
額外空間要分成兩份來算。第一份是 memo,fib(2) 到 fib(n) 各存一筆,算 fibMemo(7) 最後會存下 6 筆,是 O(N);第二份是 call stack,fibMemo(7) 一路往左呼叫到 fibMemo(1) 時最深,同時掛著 7 層,也是 O(N)。
這兩份空間存在的時間並不一樣。call stack 上的 frame 一回傳就被收掉,memo 裡的結果卻要一直留到整個計算結束,後面的呼叫才查得到。
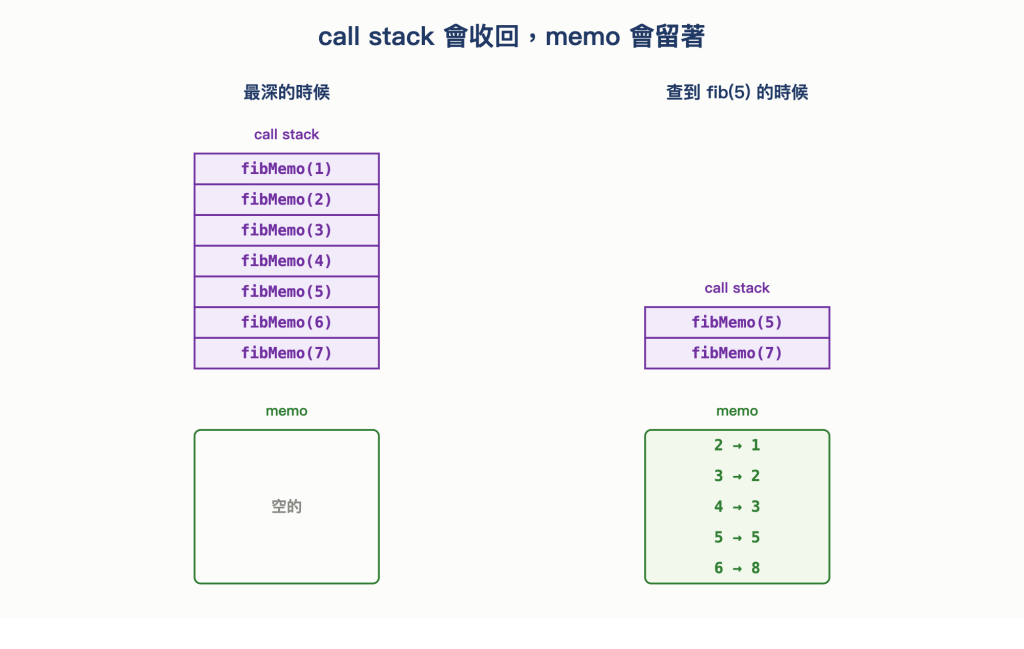
圖 5 call stack 會收回,memo 會留著
兩份相加仍是 O(N)。和直接遞迴的版本比起來,call stack 那一份本來就有,多出來的是 memo 這一份。換句話說,Memoization 是拿 memo 的 O(N) 空間,換掉重算造成的 O(2^N) 時間。
fibMemo(7) 的流程是從 fib(7) 開始往下拆,但真正第一個算出結果的是 fib(2),接著才是 fib(3)、fib(4),一路往上到 fib(7)。這種 Memoization 的方式是從目標往下拆解,因此這做法也被稱為 top-down。
不過就像之前提過的,遞迴程式可改用迴圈寫,我們也可以用迴圈由小到大來計算。
把 fib(0) 到 fib(7) 排成一排,每一格的值都由左邊兩格相加而來:
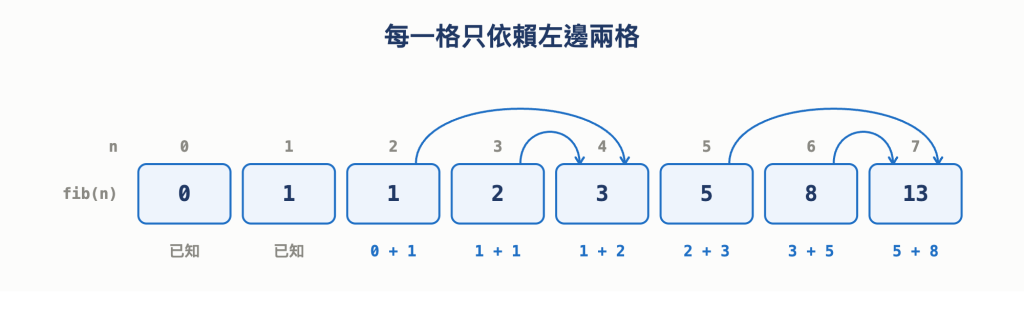
圖 6 每一格只依賴左邊兩格
fib(0) 與 fib(1) 是已知的起點,從 fib(2) 開始由左往右填,輪到任何一格時,它需要的兩格一定都已經填好了,也不用先檢查是否有算過。
照著這張表寫成程式如下:
function fibTable(n) {
  const table = [0, 1];

  for (let i = 2; i <= n; i++) {
    table[i] = table[i - 1] + table[i - 2];
  }

  return table[n];
}
table 一開始就先放好 fib(0) 與 fib(1) 的計算結果,迴圈從 i = 2 開始,每一輪用 table[i - 1] + table[i - 2] 填好第 i 格,最後回傳 table[n]。n 是 0 或 1 時迴圈不會執行,直接回傳表裡本來就有的值。
迴圈跑 n - 1 輪、每輪一次加法,時間複雜度是 O(N)。這個版本沒有遞迴,所以沒有 call stack 的成本,也不必查 memo,但 table 會存下 fib(0) 到 fib(n) 共 n + 1 筆,額外空間仍是 O(N)。
再看一次迴圈裡的 table[i] = table[i - 1] + table[i - 2],算第 i 格時只需要左邊兩格,而再更早的那些格子,後面其實不會再用到。既然如此,就不必留整張表,只要兩個變數記住最近的兩個值即可:
function fibTwoValues(n) {
  if (n <= 1) return n;

  let prev = 0;
  let curr = 1;

  for (let i = 2; i <= n; i++) {
    [prev, curr] = [curr, prev + curr];
  }

  return curr;
}
prev 與 curr 一開始分別是 fib(0) 與 fib(1) 的結果,每一輪做的事就是把這兩個變數往前移一格,新的 prev 是原本的 curr,新的 curr 是原本兩個相加。
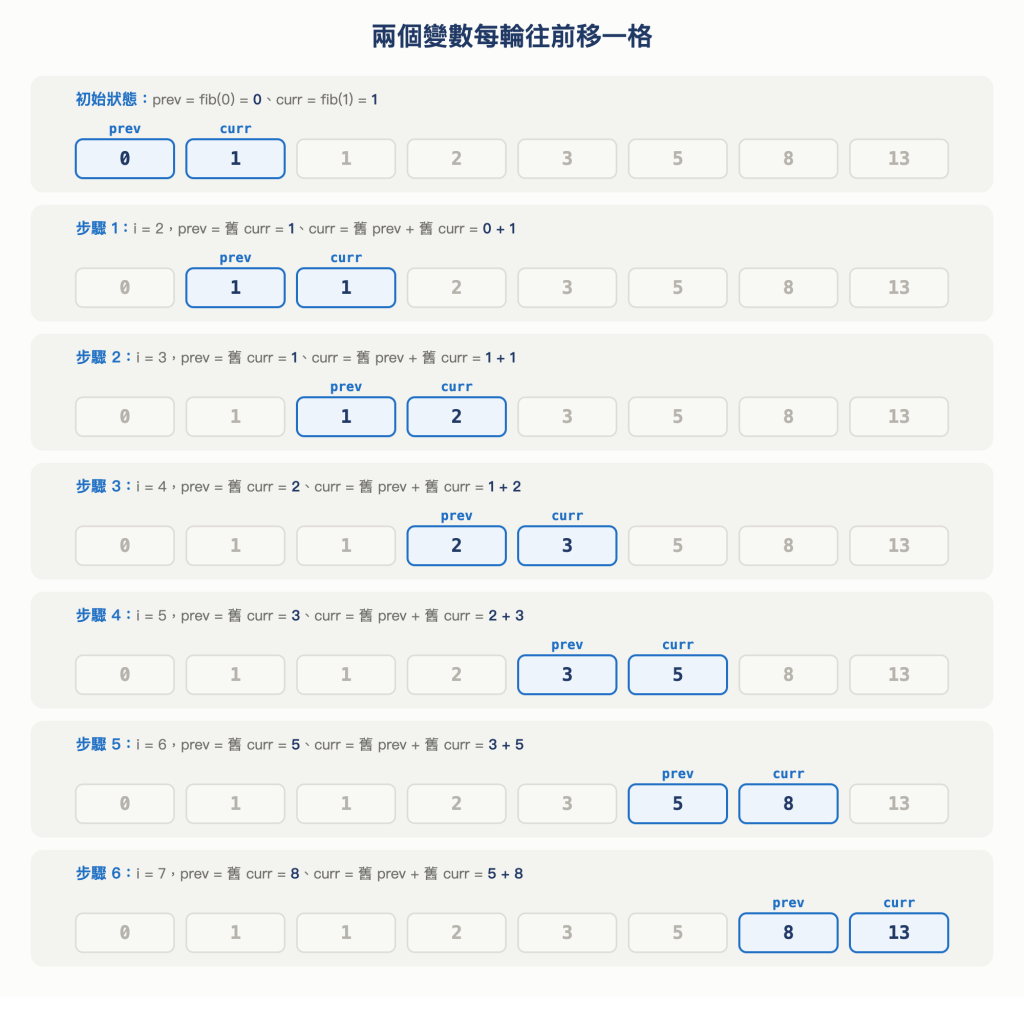
圖 7 兩個變數每輪往前移一格
迴圈一樣跑 n - 1 輪,時間複雜度仍是 O(N);額外空間則只有 prev、curr 與 i 這幾個固定數量的變數,不會隨著 n 增加,是 O(1)。
fibTable 與 fibTwoValues 都是迴圈,額外空間一個是 O(N)、一個是 O(1),可見省下空間的原因不在於改用了迴圈,而是變數儲存的東西。Fibonacci 能只留兩個變數,是因為 Fibonacci 的每一項只依賴前兩項,換成每一步要看更多項的問題,情況就不同了。
以爬樓梯為例,假設一段樓梯有 n 階,每一步可以往上走 1 階、2 階或 3 階,想知道從地面走到頂端共有幾種走法,而且步伐順序不同就算不同的走法。樓梯很短的時候,可以直接把走法列出來:
| 階數 | 走法數 | 所有走法 |
|---|---|---|
| 1 | 1 | 1 |
| 2 | 2 | 1+1、2 |
| 3 | 4 | 1+1+1、1+2、2+1、3 |
| 4 | 7 | 1+1+1+1、1+2+1、2+1+1、3+1、1+1+2、2+2、1+3 |
階數一多就列不完了,這時可以從最後一步來想。要站上第 4 階,最後一步只可能是從第 3 階走 1 階、從第 2 階走 2 階,或是從第 1 階走 3 階上來,這三種情況不會重疊,也涵蓋了所有走法,所以走到第 4 階的走法數,就是走到第 3、2、1 階的走法數相加,4 + 2 + 1 = 7,和上面列出來的一樣。寫成一般的式子就是 paths(n) = paths(n - 1) + paths(n - 2) + paths(n - 3),這裡的每一步要看前三項,Bottom-up 就得留三個變數,而不是兩個。
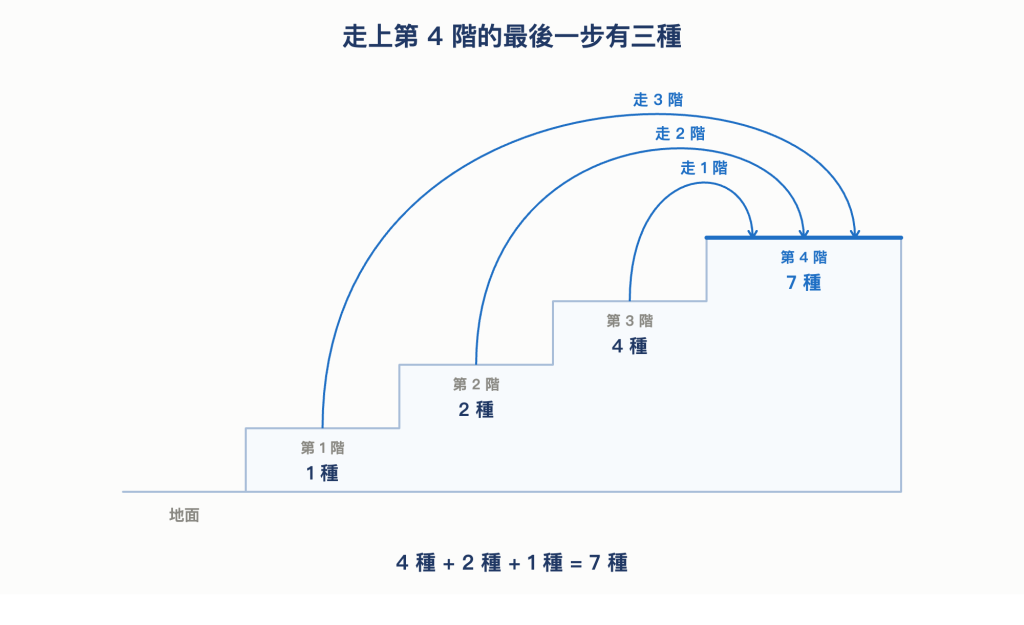
圖 8 走上第 4 階的最後一步有三種
比較上述幾種寫法,差別如下:
| 寫法 | 時間複雜度 | 額外空間 | 用到遞迴 |
|---|---|---|---|
直接遞迴 fib |
O(2^N) |
O(N),call stack |
是 |
Memoization fibMemo |
O(N) |
O(N),memo 與 call stack |
是 |
Bottom-up fibTable |
O(N) |
O(N),整張 table |
否 |
Bottom-up fibTwoValues |
O(N) |
O(1) |
否 |
以 Fibonacci 來說,Memoization 與 Bottom-up 都能讓每個子問題只算一次,時間複雜度也相同,選哪一種取決於哪個更好理解。Memoization 保留了原本的遞迴關係,只是多了查 memo 與存 memo 兩個動作,問題本身用遞迴描述最自然時,這樣的改動最小,代價是 memo 與 call stack 兩份額外空間。
Bottom-up 不必遞迴,也不必每次先查 memo,但仍然要保存算過的結果,fibTable 留的是整張表,fibTwoValues 則因為 Fibonacci 只依賴前兩項而只留兩個變數。另外,也要先想清楚子問題之間的依賴順序,才知道從哪裡開始算、往哪個方向算,對不熟悉這種寫法的人來說不一定比較好讀。
所以迴圈版本和遞迴版本一樣直觀時,可以優先考慮 Bottom-up;遞迴的寫法明顯比較自然時,保留遞迴再加上 Memoization 也是合理的選擇。
Bottom-up 從 fib(2) 一路算到 fib(7),每一步都用前面已經算好的結果。真實系統裡也有這種照順序計算的例子,PostgreSQL 在規劃 SQL 查詢時就是其中一個案例,這裡也小小延伸補充下。
在資料庫裡,join 是把一張表的資料列和另一張表的資料列配對起來,配對的依據寫在 ON 後面的條件。以一個簡單的電商資料庫為例,使用者、訂單、訂單明細、商品分成四張表,表和表之間靠 id 欄位互相對應:
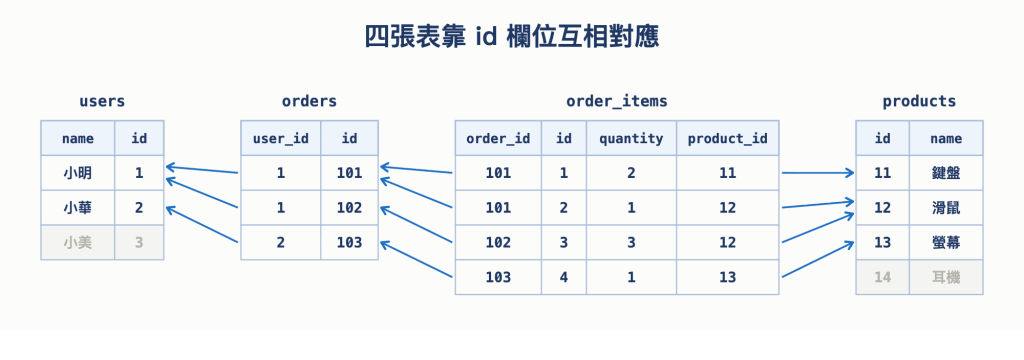
圖 9 四張表靠 id 欄位互相對應
下面這個查詢會把四張表依序接起來,每一個 JOIN ... ON 都是再接上一張表,並說明這張表要用哪個欄位和前面的資料配對:
SELECT users.name, orders.id, order_items.quantity, products.name
FROM users
JOIN orders ON orders.user_id = users.id
JOIN order_items ON order_items.order_id = orders.id
JOIN products ON products.id = order_items.product_id;
跑出來的結果是每一筆訂單明細一列,每一列都接上了下單的人與商品名稱:
| users.name | orders.id | order_items.quantity | products.name |
|---|---|---|---|
| 小明 | 101 | 2 | 鍵盤 |
| 小明 | 101 | 1 | 滑鼠 |
| 小明 | 102 | 3 | 滑鼠 |
| 小華 | 103 | 1 | 螢幕 |
結果裡沒有小美,也沒有耳機,因為小美沒有下過訂單、耳機也沒有被買過,配對不到的資料列就不會出現。只留下配對成功的資料列,這種 join 叫做 inner join,也是直接寫 JOIN 時的預設邏輯。如果改寫成 LEFT JOIN,左邊那張表的每一列至少都會出現一次,配對不到的欄位補上 NULL,這種把配對不到的資料列也留下來的 join 則叫做 outer join。
同樣是 inner join,先接哪兩張表並不會改變結果,例如先把 order_items 與 products 接起來、再接 orders 與 users,得到的仍然是上面那 4 列。但資料庫每次 join 只處理兩個輸入,四張表得分成好幾步才能接完,而中間產生的資料量會因為順序不同而差很多。PostgreSQL 的文件是這樣描述的:
these different join possibilities give semantically equivalent results but might have hugely different execution costs.
以圖 9 那份資料為例,users 與 products 之間沒有任何配對條件,先把這兩張表接起來,3 位使用者與 4 件商品就會兩兩配成 12 列還沒被任何條件篩掉的資料,後面才有機會用其他條件把它們縮小;先接有配對條件的兩張表,中間的資料量就不會這樣膨脹。
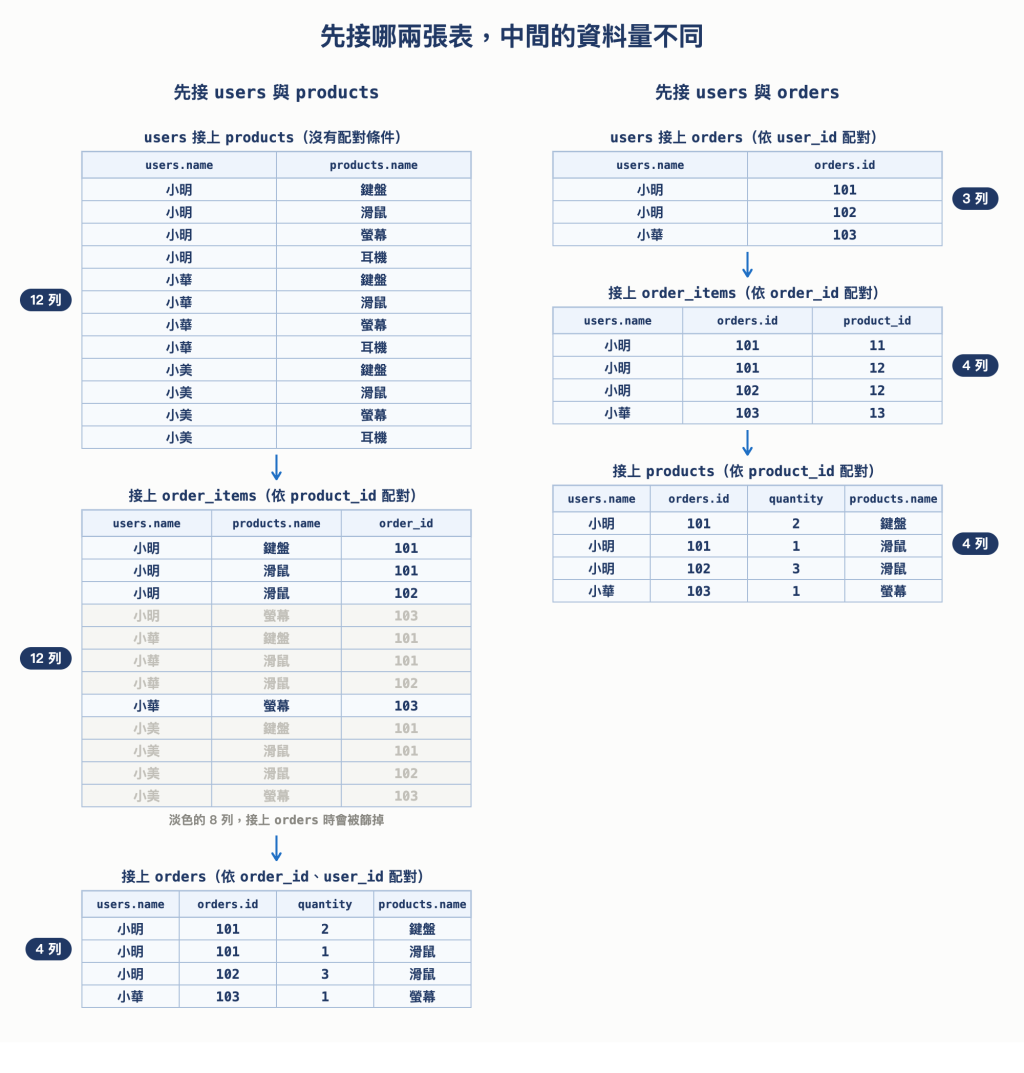
圖 10 先接哪兩張表,中間的資料量不同
所以 PostgreSQL 在執行查詢之前,會先由查詢規劃器 (planner) 依照統計資料(例如每張表有多少資料列)估算各種順序的成本,再挑出估算成本最低的那一種。上面那段 SQL 雖然依序寫了 users、orders、order_items、products,但寫的順序不等於實際接的順序,只要表的數量不超過 join_collapse_limit 這個設定(預設是 8),planner 仍然可以自己決定先接哪兩張表。outer join 則不一樣,配對不到的資料列也要留下來,換了順序結果可能就不同,所以能調整的順序比較少。
planner 要找的是「把這四張表 join 起來,成本最低的做法」。這裡算的是各種執行方案的估算成本,還沒有真的把資料列 join 起來,留下來供後面使用的也是方案與成本紀錄。
PostgreSQL 的 optimizer 說明文件把這做法稱為 dynamic programming:
The join tree is constructed using a "dynamic programming" algorithm: in the first pass ⋯ we consider ways to create join rels representing exactly two list items. The second pass considers ways to make join rels that represent exactly three list items; the next pass, four items, etc.
也就是和 Bottom-up 一樣,先把兩張表的組合算完,再用它們組出三張、四張表的組合。這四張表之間只有相鄰的兩張有條件可以配對,排起來是 users、orders、order_items、products 一條鏈:
{users, orders}、{orders, order_items}、{order_items, products},各自找出成本最低的 join 做法。圖 10 左欄是用來展示順序可能造成的成本差異;在這個例子裡,planner 會優先利用現有的配對條件,因此不會建立先接 users 與 products 的起始組合{users, orders, order_items} 與 {orders, order_items, products},用第二層的結果再接上一張表,一樣各自找出成本最低的做法同一組表不管用什麼順序組出來,planner 都當作同一個子問題。以 {users, orders, order_items} 為例,可以是 {users, orders} 再接 order_items,也可以是 users 接上 {orders, order_items},比較這兩種組法時,planner 會利用前面已建立的讀取與 join 方案,估算再接上剩下那張表的整體成本,再比較哪種組法成本較低。替這組表留下估算成本最低的方案後,後面要用到這組表時就直接取用,像 Bottom-up 的表格裡每個 i 都對應一格。
不過 fib(i) 是一個數字,join 的做法卻還帶著別的性質,例如結果是不是已經照某個欄位排好序。排好序的結果可以讓後面的 join 省下排序的工作,所以就算這種做法本身的成本不是最低,也可能被留下來,每一組表因此可能保留不只一種做法。下面為了說明逐層組合的順序,還是先以「成本最低的那一種」來講。
這些組合之間也有重疊的子問題。以 {users, orders} 為例,第三層組 {users, orders, order_items} 時會用到它;到了第四層,除了「三張表再接一張表」,{users, orders} 接上 {order_items, products} 這種兩邊都是 join 結果的組法也會被考慮,它又被用了一次。每一組表的最低成本只算一次、之後直接取用,所以不論被用到幾次,同一組表都不必重新估算。
那 planner 怎麼確定,要用到某一組表時,它的最低成本已經算好了呢?同一份說明文件也提到,這種逐層計算的做法會先把某一組表的所有做法都建完,才開始建包含這組表的更大組合。所以輪到第三層時,第二層每一組的最低成本都已經確定,這和 Bottom-up 算 fib(i) 時 fib(i - 1) 與 fib(i - 2) 一定已經算好是相同概念。
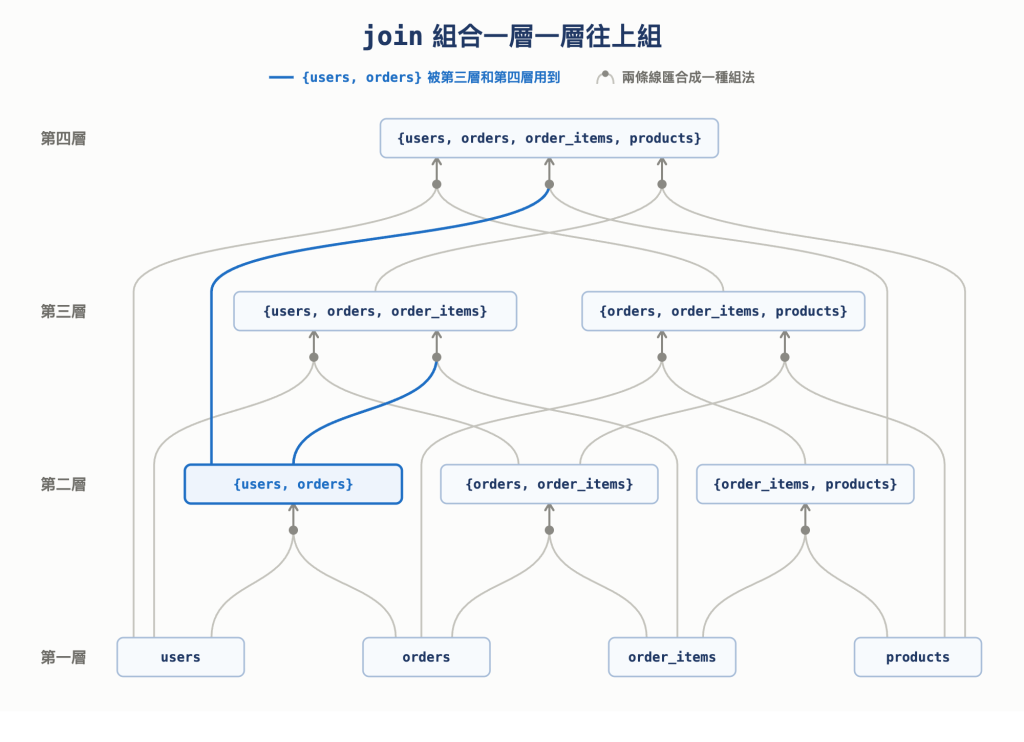
圖 11 join 組合一層一層往上組
Fibonacci 每一步只看前兩項,所以可以只留兩個變數。join 規劃就不行了,每次 join 雖然只接兩個輸入,但兩邊的表數只要加起來是 4 就可以,所以第四層有三種組法:
| 左邊 | 右邊 | 兩邊各來自哪一層 |
|---|---|---|
{users, orders, order_items} |
products |
第三層 + 第一層 |
users |
{orders, order_items, products} |
第一層 + 第三層 |
{users, orders} |
{order_items, products} |
第二層 + 第二層 |
第四層同時用到第三層、第二層與第一層的結果,前面每一層都得保留,沒辦法只留最近一層。
另一個差別是子問題的數量。fib(n) 只有 n + 1 個子問題,join 順序的可能性卻會隨著表的數量快速增加,全部算完要花很長的規劃時間。所以 FROM 裡的項目達到 geqo_threshold 設定的數量(預設是 12)時,PostgreSQL 會改用另一套叫做 GEQO (Genetic Query Optimizer) 的搜尋方式,不再逐層算完所有組合。換句話說,GEQO 是拿「不保證找到成本最低的做法」換較短的規劃時間。
這裡只描述了 join 順序的主要流程,實際的 planner 還要處理 outer join 造成的順序限制等,以上內容依據 PostgreSQL 18 的文件,其他版本的細節可能不同。
小小總結一下今天對 Dynamic Programming 的認識~
fib(7) 的 41 次呼叫裡,真正不同的子問題只有 8 個,其餘 33 次都在重算。fib(7) 的呼叫次數從 41 次降到 13 次,時間複雜度從 O(2^N) 變成 O(N);換來的成本是要把算過的結果存下來。實際使用時,還可以記住幾件事~
O(N),而且 memo 要留到整個計算結束fibTwoValues 能做到 O(1),是因為 Fibonacci 只依賴前兩項,不是改成迴圈就一定省空間圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。
src/backend/optimizer/README


 iThome鐵人賽
 看影片追技術