
昨天從台北出發,沿著桃園、新竹一路走到台中,透過 DFS 確認了這幾個城市之間確實有路。不過如果問題改成「從台北到台中,最少要經過幾條路」,只看昨天 DFS 找到的那條路徑,還無法確定是不是最少 edge 數。台北也有一條路直接通往新竹,沿那邊過去只需要經過 2 條路,比先繞到桃園再前進少了 1 條。
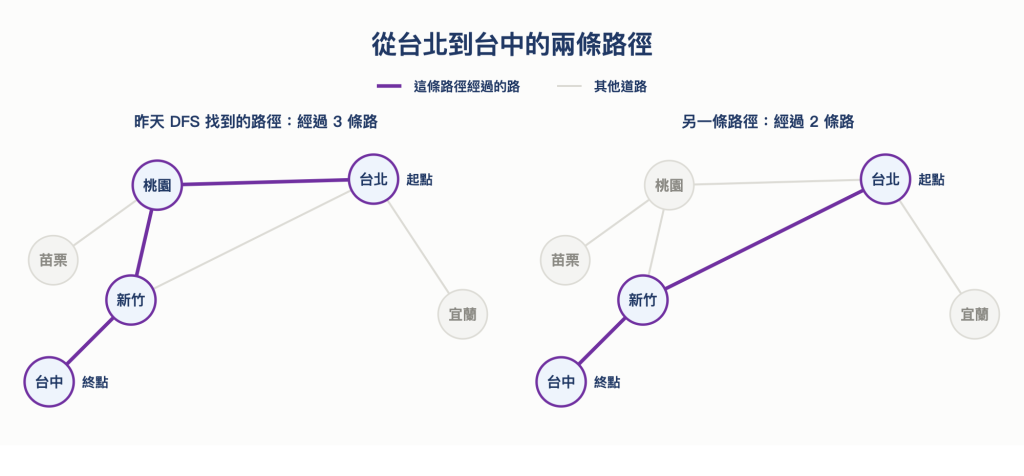
圖 1 同樣從台北到台中,兩條路徑經過的 edge 數不同
DFS 會先把挑中的分支走下去,所以走得到很遠的地方,卻不保證先遇到的是離起點最近的城市。那如果先把台北直接相連的城市都看過,再從這些城市往外走一條路呢?這樣的順序能不能直接回答「最少要走幾條路」?
今天就來看看廣度優先走訪 (Breadth-First Search,簡稱 BFS)~
BFS 的走法是先處理和起點直接相連的城市,再從這些城市繼續往外找,而這裡的遠近只算經過幾條路,不算公里數或票價。地圖上的每一條路就是 Day 24 說的 edge,本篇要算的「最少 edge 數」數的就是它們;而這張地圖的 edge 都沒有帶值,也就是 Day 24 說的 Unweighted Graph。
昨天的遞迴 DFS 看到還沒走過的鄰居,就會先沿著那個鄰居往下走,BFS 則需要先把同一層的城市都處理完。這種一層一層橫著走的順序,Day 19 在 Tree 的篇章有提過,就是層序走訪 (level-order)。
回到地圖上,那些已經找到、卻還不能立刻往下走的城市,要放在哪裡等呢?Day 12 的 Queue 可以記住這些待處理的城市,先加入的先取出,後來找到的就排在後面。用同一張地圖走一次,看看這個順序怎麼維持~
沿用昨天 6 個城市、6 條路的 Graph,先不加入最後示範的花蓮與台東。Graph 使用 Day 24 的實作,neighbors() 會回傳指定城市的鄰居陣列:
const roads = new Graph();
roads.addEdge('台北', '桃園');
roads.addEdge('桃園', '新竹');
roads.addEdge('新竹', '台中');
roads.addEdge('台北', '宜蘭');
roads.addEdge('台北', '新竹');
roads.addEdge('桃園', '苗栗');
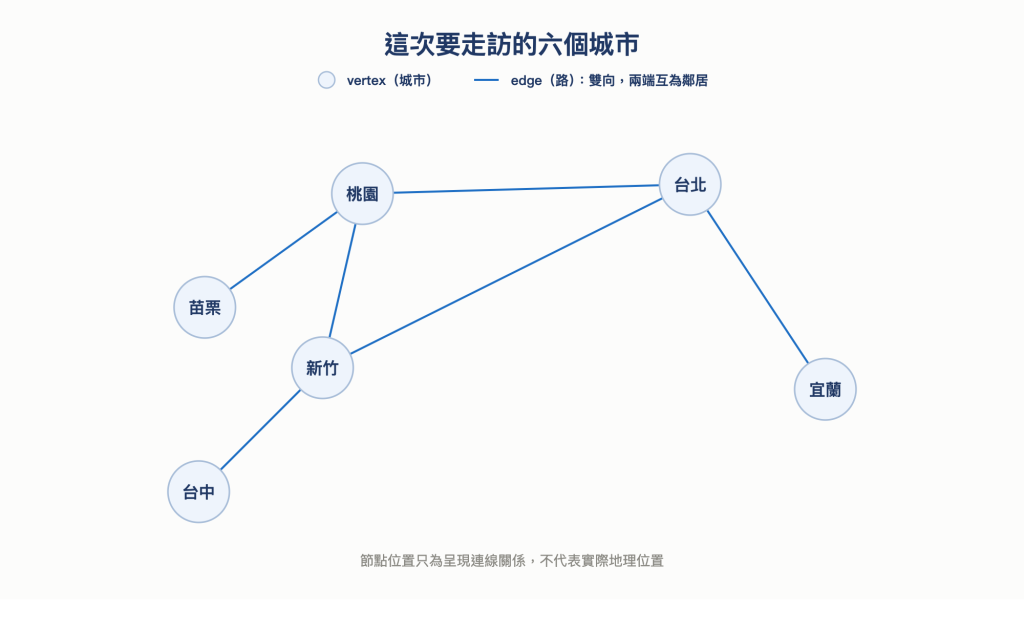
圖 2 六個城市與六條路的連接關係(沿用 Day 25)
從台北的鄰居名單可以找到桃園、宜蘭、新竹。若發現桃園就立刻跟著桃園往下走,又會回到昨天 DFS 的做法;要先處理完台北周圍的城市,就要先把這三個城市依序放進 Queue。之後從桃園找到苗栗時,宜蘭和新竹都還在等待,因此苗栗會排在它們後面。
這裡先區分兩個動作:「發現一個城市」是第一次遇到它,記錄下來並加入 Queue;「處理一個城市」則是從 Queue 取出它、查看它的鄰居。城市被發現後,可能還要在 Queue 裡等幾輪,才會被取出處理。
昨天已經介紹過為什麼需要記住走過誰。BFS 也需要記錄哪些城市已經發現,而且要在加入 Queue 時就記錄,表示已經安排好之後會處理它。從台北開始,Queue 與這份紀錄會依照以下步驟改變:
[台北]。[桃園, 宜蘭, 新竹]。[宜蘭, 新竹, 苗栗]。[新竹, 苗栗]。[苗栗, 台中]。[台中];台中也處理完後,Queue 清空,走訪結束。第三步的新竹剛好說明了為什麼要在加入 Queue 時標記,若等到取出時才記錄,新竹雖然已經在 Queue 裡,處理桃園時卻仍會被當成尚未發現,再加入 Queue 一次。加入 Queue 時就記錄,才能讓每個城市最多只進隊伍一次。
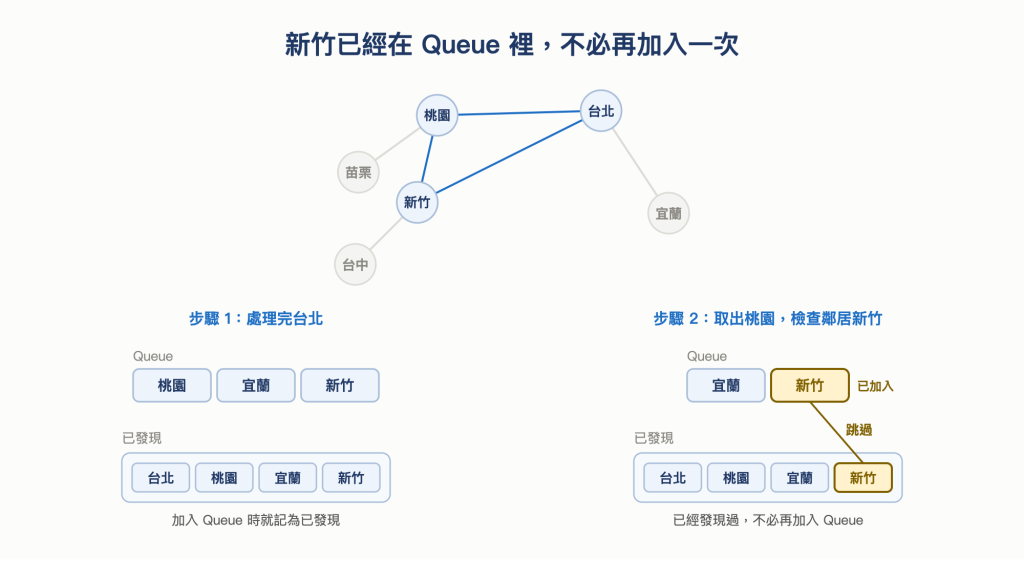
圖 3 新竹還沒取出,但已經標記並加入 Queue
走訪完之後,處理順序是 台北、桃園、宜蘭、新竹、苗栗、台中。台北周圍的桃園、宜蘭、新竹先處理完,才輪到經由它們找到的苗栗與台中。
用一句話來說 BFS:
BFS 使用 Queue,先處理較早發現的 vertex,再將新發現的鄰居排到隊伍最後面,讓走訪按照與起點的距離逐層展開。
先看這張地圖本身:台北自己不需要走任何路;桃園、宜蘭、新竹都有一條路直接連到台北;苗栗與台中沒有直達路,但各能經由桃園、新竹用 2 條路抵達。因此在這個例子裡,最少 edge 數分別是 0、1、2,而剛才的處理順序也正好符合這個分層。
這樣的走訪我覺得有點像水面上的漣漪,從起點一圈一圈往外擴散。台北是中心,桃園、宜蘭、新竹是第一圈,苗栗與台中則是第二圈。不過這裡的「一圈」是按最少經過幾條路來分,不是地圖上的實際距離;城市畫得遠或近,都不影響它屬於哪一層。
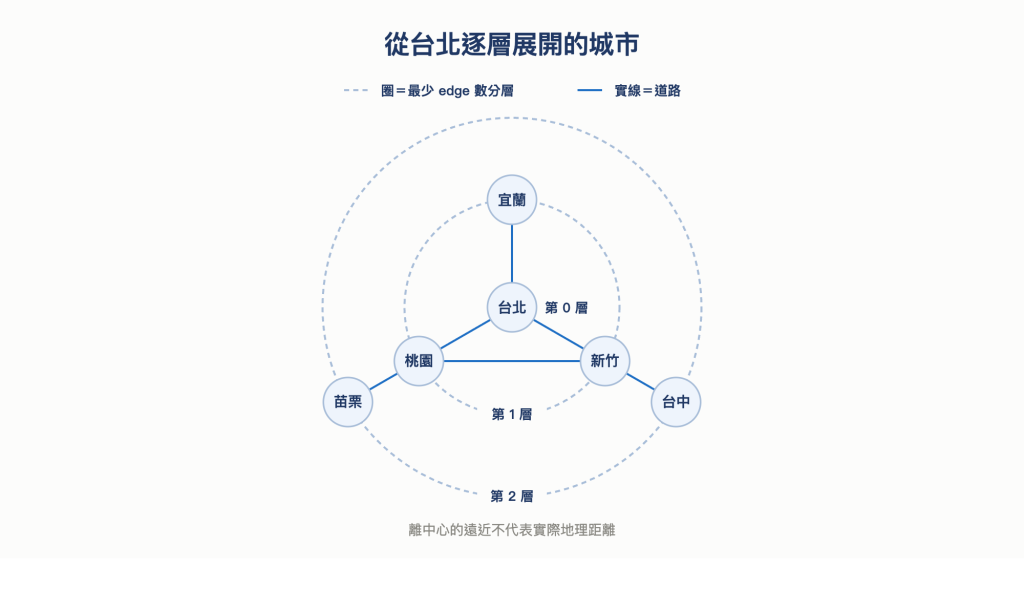
圖 4 城市按最少 edge 數分層,同層之間也可能有路
Queue 的順序取決於加入的先後,處理台北時,桃園、宜蘭、新竹就已經全部加入 Queue;之後處理桃園才找到苗栗,因此苗栗只能接在宜蘭與新竹後面。苗栗要等待,是因為它比較晚加入 Queue。
同樣的,處理新竹時才找到的台中,也只能排在先前已經加入的苗栗後面。每次從 Queue 最前面取出城市,新找到的城市再加到最後面,就能確保原本已經在 Queue 裡的城市先被處理。
Queue 裡也可以同時放著不同層的城市,例如處理完桃園時,Queue 是 [宜蘭, 新竹, 苗栗]。對照圖 4,宜蘭、新竹屬於第 1 層,苗栗屬於第 2 層;它們可以同時在 Queue 裡,只是苗栗必須排在後面。
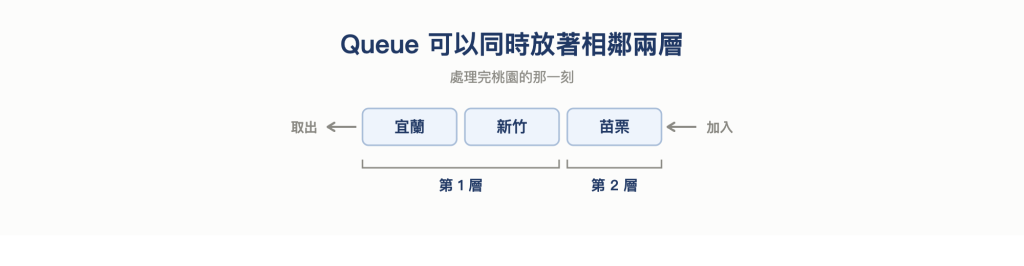
圖 5 同一個 Queue 裡,較近的一層仍然排在前面
所以程式不需要知道一層有幾個城市,分層是取出與加入這條規則自己維持出來的。每個城市的鄰居數可以不同,甚至完全沒新鄰居,Queue 的規則仍相同。
圖 4 的桃園和新竹同屬第 1 層,中間又有一條路,並不會破壞分層。當桃園沿那條路看到新竹時,新竹已經由台北直接找到,不需要因為多了一種抵達方式,就把它改排到更遠的一層。分層描述的是「最少要走幾條路」,同一個城市仍可以有其他更長的路徑通往它。
先把剛才那段流程寫成程式。這一版只處理「從起點能走到哪些城市,依照什麼順序處理」,使用 visited Set 記住已經發現的城市,再用 order Array 保存取出的順序。visited 包含已經加入 Queue 但還沒取出的城市,order 則只在取出時新增。
Queue 沿用 Day 12 的 HeadIndexQueue,用它來實作 BFS 如下:
class HeadIndexQueue {
  constructor() {
    this.items = {};
    this.head = 0;
    this.tail = 0;
  }

  enqueue(value) {
    this.items[this.tail] = value;
    this.tail++;

    return this;
  }

  dequeue() {
    if (this.isEmpty()) return undefined;

    const value = this.items[this.head];

    delete this.items[this.head];
    this.head++;

    return value;
  }

  peek() {
    return this.items[this.head];
  }

  isEmpty() {
    return this.head === this.tail;
  }
}

function bfs(graph, start) {
  const order = [];
  if (!graph.adjacency.has(start)) return order; // neighbors() 對不存在的城市也回空陣列

  const visited = new Set();
  const queue = new HeadIndexQueue();
  visited.add(start);
  queue.enqueue(start);

  while (!queue.isEmpty()) {
    // 當 queue 還有東西時,持續取出並處理
    const city = queue.dequeue();
    order.push(city);

    for (const next of graph.neighbors(city)) {
      if (visited.has(next)) continue; // visited 有儲存過,就跳過,避免重複存

      visited.add(next); // 先記錄,再加入 Queue
      queue.enqueue(next);
    }
  }

  return order;
}

console.log(bfs(roads, '台北'));
// [ '台北', '桃園', '宜蘭', '新竹', '苗栗', '台中' ]
若起點不存在,會回傳空 Array;若它存在但沒有鄰居,則仍然會加入 Queue 並被取出,結果只包含它自己。這和 Day 25 一樣,一次呼叫從一個起點開始,只走它能抵達的部分。
while 決定現在輪到哪個城市,裡面的 for 則把這個城市的鄰居全部看完,遇到已在 visited 的鄰居時,continue 跳過這鄰居。這裡沒有遞迴呼叫 bfs,因此看到桃園時不會立刻深入桃園,而會繼續查看台北的鄰居宜蘭、新竹。
初始化時,Queue 是 [台北],visited 已有台北,order 還是空的。下表的 Queue 都是「這一輪把鄰居看完之後」的狀態,左邊是下一個要取出的位置;visited 只列新增項目,之前加入的城市仍然保留:
| 本輪取出 | 本輪加入 visited | 處理完後的 Queue | 累積 order |
|---|---|---|---|
| 台北 | 桃園、宜蘭、新竹 | 桃園、宜蘭、新竹 | 台北 |
| 桃園 | 苗栗 | 宜蘭、新竹、苗栗 | 台北、桃園 |
| 宜蘭 | 無 | 新竹、苗栗 | 台北、桃園、宜蘭 |
| 新竹 | 台中 | 苗栗、台中 | 台北、桃園、宜蘭、新竹 |
| 苗栗 | 無 | 台中 | 台北、桃園、宜蘭、新竹、苗栗 |
| 台中 | 無 | 空 | 台北、桃園、宜蘭、新竹、苗栗、台中 |
處理桃園的那一輪,台北已經取出,新竹卻還在 Queue 裡等,兩個城市的處理進度不同,但都已經在 visited,兩個都跳過,只加入新的苗栗。這裡明確看出 visited 的記的是「已經發現並安排過」的城市。
如果改成從 Queue 取出時才把城市加入 visited,處理桃園時,新竹雖然已經在 Queue 裡,卻還不在 visited,因此會被再次加入 Queue。之後即使取出時再檢查、跳過重複項目,仍然多存了一份、多取出了一次;若連取出時的檢查也沒有,還會重複處理鄰居。加入 Queue 前先標記,能直接避免這些重複安排。
最後 Queue 清空,order 留下 6 個城市,visited 也仍然保有這 6 個城市。Queue 是尚待處理的工作,取出就移除;另外兩份紀錄則各自保存發現狀態與走訪結果,不會跟著 Queue 一起清空。
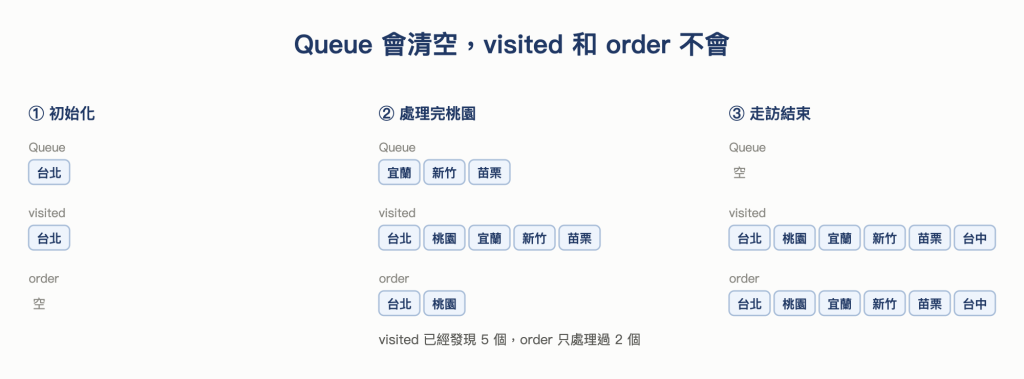
圖 6 取出就從 Queue 移除,visited 與 order 則一路累積
剛才的 bfs 回傳了 6 個城市的處理順序,但前言還有個問題:從台北到台中,最少要經過幾條路?台中雖然排在清單的第 6 個,卻不代表要走 6 條路;從台北經新竹到台中,只需要 2 條。走訪清單只記下先後順序,若要直接查到最少 edge 數,還需要把每個城市的距離一起記下來。
我們可用 distance Map,以城市為 key,記錄首次找到它時的路徑 edge 數。每個數值都對應一條實際找到的路;至於這條路是不是最短,還需要確認。
起點不需經過任何路,因此先記錄 台北 → 0;處理台北時,第一次發現的桃園、宜蘭、新竹都沿著一條路抵達,距離是 0 + 1 = 1;之後處理桃園,若發現還沒見過的苗栗,苗栗的距離就是桃園的距離再加 1,也就是 2。
這張 Map 也能用來判斷城市是否已經被發現:城市不在 distance 裡就是還沒安排過,在裡面就是已發現。檢查 Map 裡有沒有這個城市,就能取代原本 visited.has() 的判斷,不需另存 Set。
另外,判斷城市是否已發現時,要用 distance.has(city),若用 if (distance.get(city)),起點的距離 0 會被當成 false,誤判為還沒有紀錄。回頭遇到台北時,應該用 has() 確認它已有紀錄,直接跳過。
現在把 Queue 與 distance 放在一起看。開始時 Queue 只有台北,distance 也只有台北的 0;每次取出城市時,它的距離都已經在 Map 裡,因此新鄰居的距離就是「目前城市的距離加 1」。
[桃園, 宜蘭, 新竹]。distance 記錄苗栗的距離,再將苗栗加入 Queue。苗栗的距離是 distance.get('桃園') + 1,也就是 2;Queue 變成 [宜蘭, 新竹, 苗栗],苗栗排在最後面,必須等宜蘭和新竹。[新竹, 苗栗],接著輪到新竹。台中 → 2。Queue 是 [苗栗, 台中],苗栗比台中早加入,所以接著會先處理苗栗。[台中]。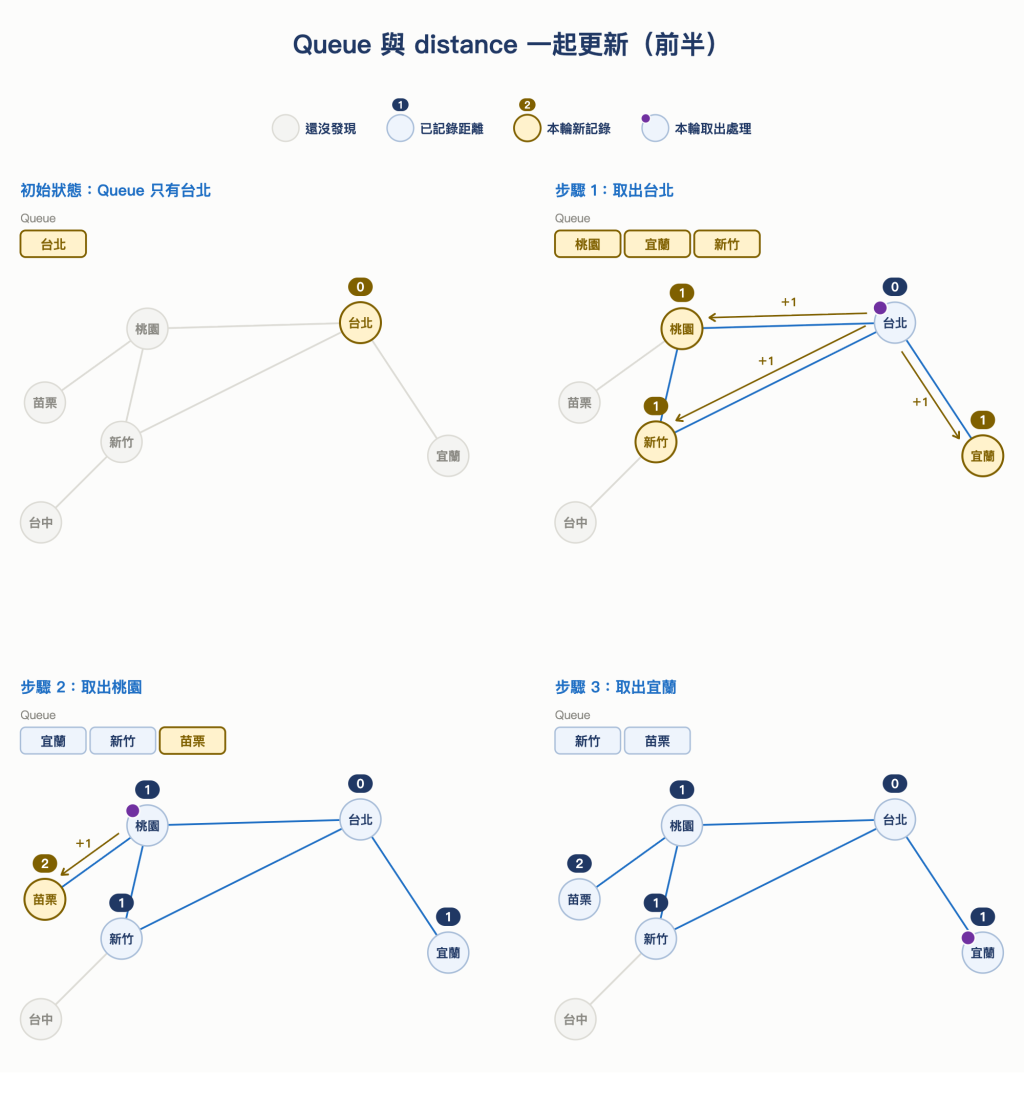
圖 7 初始狀態到步驟 3:新城市先記下距離,再排到 Queue 最後面
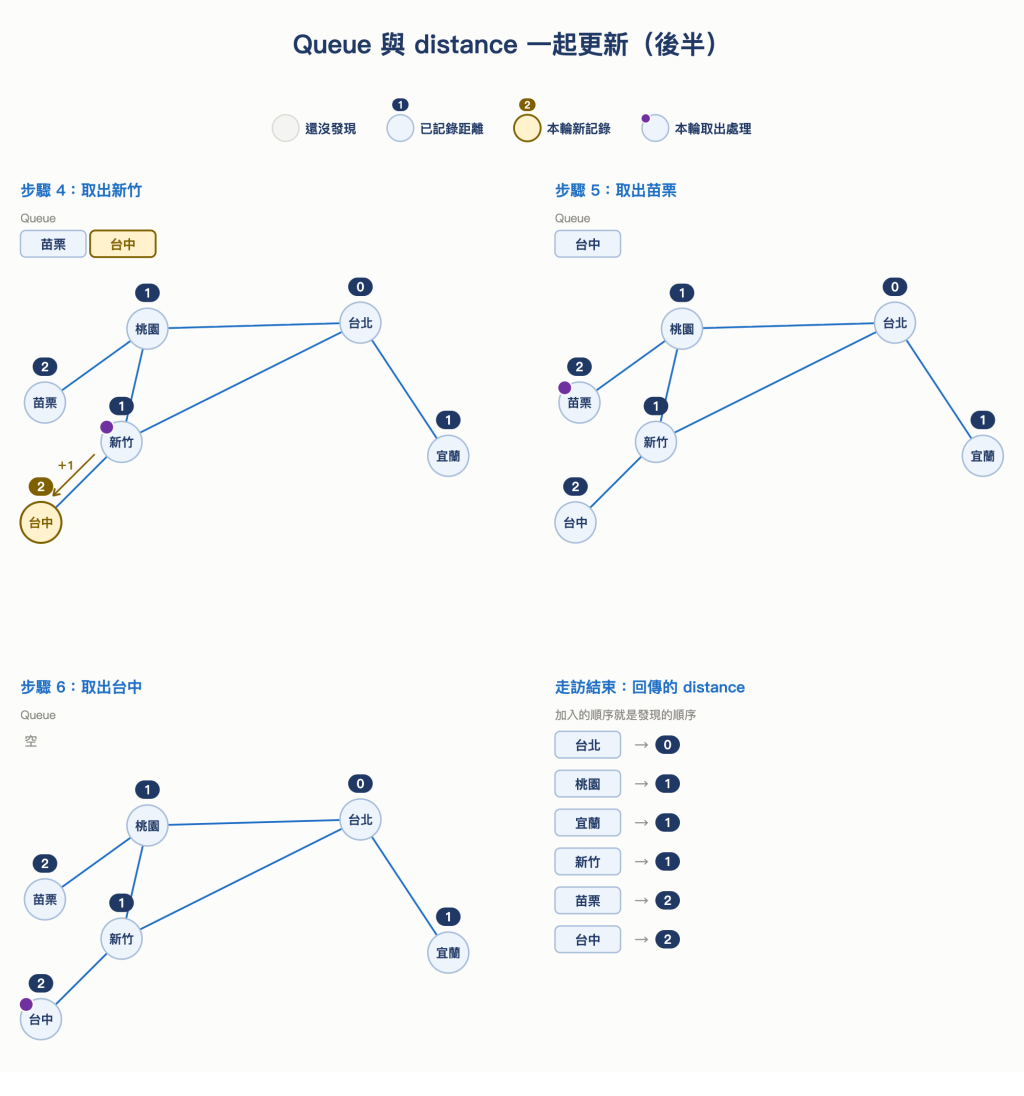
圖 8 步驟 4 到步驟 6:只剩台中是新發現,Queue 清空後回傳六筆距離紀錄
第二輪處理桃園時,又會在鄰居名單看到新竹。若沿著台北、桃園再走到新竹,總共是 2 條路,但新竹已經有距離 1,所以這次不會重新記錄。BFS 到這裡也沒有執行「比較 1 和 2,留下比較小的」那種判斷,它只檢查新竹是否已經被發現。
沿用 bfs 的 Queue 與兩層迴圈,把 visited 換成 distance,在首次發現城市時記錄距離。這版要回傳的是距離 Map,不再另外建立 order。程式如下:
function bfsDistances(graph, start) {
  const distance = new Map();
  if (!graph.adjacency.has(start)) return distance;

  const queue = new HeadIndexQueue();
  distance.set(start, 0);
  queue.enqueue(start);

  while (!queue.isEmpty()) {
    const city = queue.dequeue();

    for (const next of graph.neighbors(city)) {
      if (distance.has(next)) continue; // 有紀錄就跳過

      distance.set(next, distance.get(city) + 1); // 目前城市的距離加 1
      queue.enqueue(next);
    }
  }

  return distance;
}
函式接收一張 Graph 與起點,回傳「城市 → 最少 edge 數」的 Map(為什麼首次記下的 edge 數就已經是最少 edge 數,等等會說明)。開頭先用 graph.adjacency.has(start) 確認起點存在,少了它,不存在的城市會被當成距離 0 的有效起點。這裡約定起點不存在時回傳空 Map。
用同一張圖實際執行:
const distances = bfsDistances(roads, '台北');
console.log([...distances]);
// [
//   [ '台北', 0 ],
//   [ '桃園', 1 ],
//   [ '宜蘭', 1 ],
//   [ '新竹', 1 ],
//   [ '苗栗', 2 ],
//   [ '台中', 2 ]
// ]

console.log(distances.get('台中')); // 2
console.log(distances.get('台北')); // 0
Map 會保留 key 首次加入的順序,所以把它展開時,也能看見城市首次被發現的順序。這份 BFS 裡,每個城市只會加入 Queue 一次,取出又遵守先進先出,因此首次發現與之後取出的城市順序相同,不需另外保存一份走訪清單。
若起點與要查詢的城市都存在於 Graph,但後者沒有出現在結果中,代表從這個起點走不到它。可以把昨天那條花蓮與台東的路加回來,確認它不會影響從台北出發的結果:
roads.addEdge('花蓮', '台東');

const fromTaipei = bfsDistances(roads, '台北');
console.log(fromTaipei.has('花蓮')); // false
console.log(fromTaipei.get('花蓮')); // undefined
console.log(fromTaipei.get('台中')); // 2
加入 Queue 的城市,只會是起點或走訪時新發現的鄰居。台北所在的那一塊與花蓮–台東之間沒有 edge,從台北沿鄰居名單走下去,找不到花蓮,也不會將它加入 Queue。Queue 清空表示「從台北能抵達的城市已經處理完」,不表示整張 Graph 的所有城市都已被走過。若從花蓮重新出發,則會得到花蓮的 0 與台東的 1,這是另一個起點的新走訪。
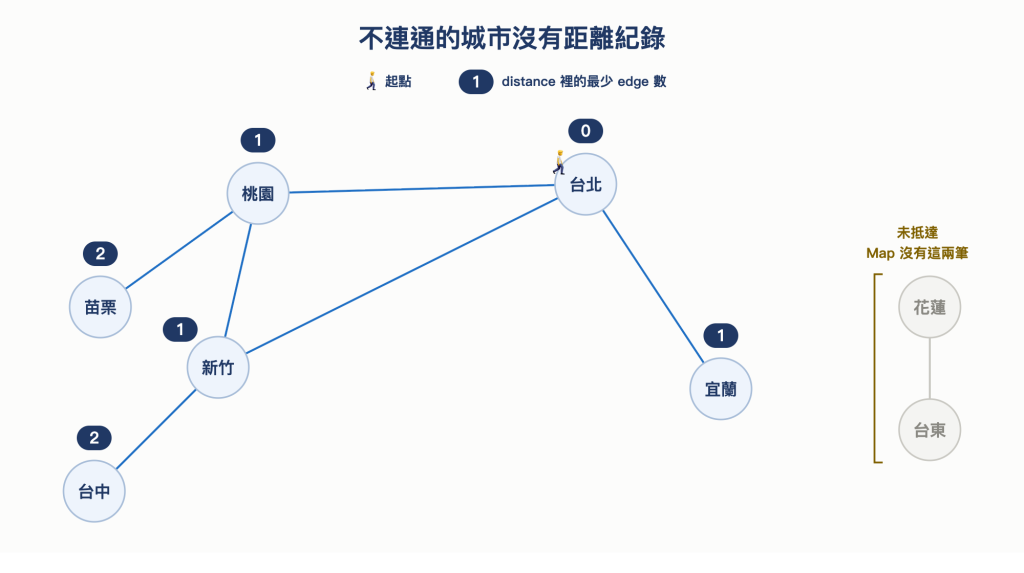
圖 9 從台北走不到東部兩城,結果中便沒有它們
如果有一個城市完全沒鄰居,從它自己出發仍會回傳一筆距離 0。它先加入 Queue,接著被取出,因為沒有鄰居可加入,Queue 就變空;「起點存在但沒有路可走」和「起點根本不存在」因而有不同的結果。
另外,distance 記錄的是那次走訪看到的地圖,不會隨後來新增或移除的 edge 自動更新;地圖改變後要重新執行,才能得到新的最少 edge 數。
把兩個函式放在一起看,走訪規則不變,起點先加入 Queue,每輪從 Queue 取出一個城市,未發現的鄰居才會加入。改變的是發現城市時保存的資訊和最後的回傳值:
| 動作 | bfs |
bfsDistances |
|---|---|---|
| 記錄起點 | visited.add(start) |
distance.set(start, 0) |
| 判斷鄰居是否已發現 | visited.has(next) |
distance.has(next) |
| 記錄新鄰居 | visited.add(next) |
distance.set(next, distance.get(city) + 1) |
| 保存處理順序 | 取出時 order.push(city) |
不另外保存 Array |
| 回傳結果 | 城市順序 order |
城市與最少 edge 數 distance |
只需依序處理可達城市時,第一版就足夠,例如把 order.push(city) 換成要對城市執行的操作;需要知道離起點幾條路時,再使用第二版。distance 能取代 visited,是因為每個城市都在首次發現時存入 Map,之後也不刪除。
不過...,上面這樣省略比較會不會漏掉更短的路?如果先記下的是繞遠的路,之後即使沿另一條更短的路遇到同一個城市,也會因為已有紀錄而跳過。因此我們需要確認:第一次記下的距離,為什麼就已經是最少 edge 數?
台中是在處理新竹時被發現,因此記錄值是 1 + 1 = 2。從台北到新竹有直達路,所以新竹的最少 edge 數確實是 1;再往台中走一條路,就得到長度 2 的路徑。如果台中還有更短的路,就只能是台北直接連到台中。然而台北是最先處理的城市,假如真有這條直達路,台中早就會在第一輪被找到,不會等到處理新竹才首次出現。
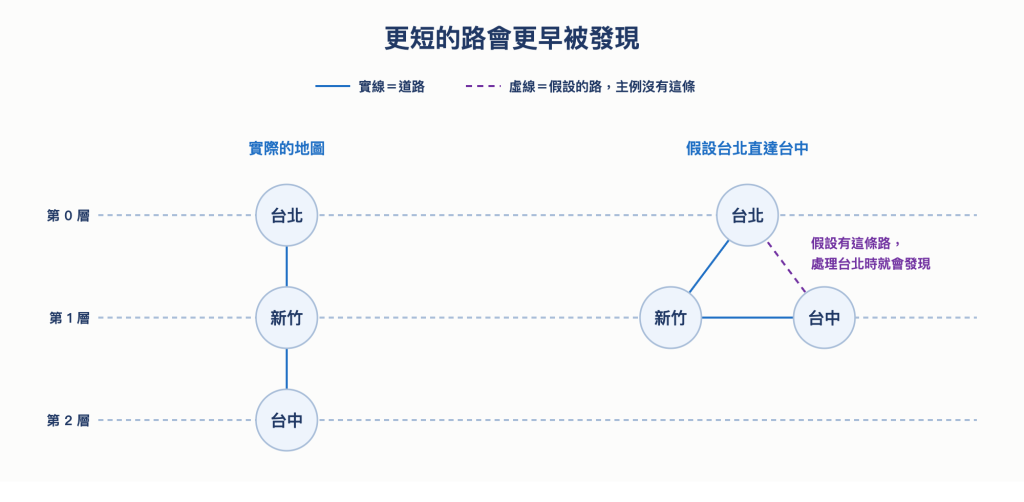
圖 10 假如台北能直達台中,第一輪就會發現它
如果城市更多、路徑更複雜,也能保證更短的路不會漏掉嗎?Day 04 介紹過 Loop Invariant(迴圈不變量):先說明每輪開始時應該成立的性質,再確認一輪結束後,這些性質仍然成立。對照 bfsDistances,要維持的是以下三項:
在每次
while迴圈開始之前:
- Queue 裡的記錄值由前到後不會變小。若 Queue 非空,最前面的記錄值為
d,後面只可能有d或d + 1。- 每個已發現城市的
distance記錄,都等於從起點到它的最少 edge 數。- 每個已發現的城市,不是在 Queue 等待,就是已經處理完;已處理完的城市,其所有鄰居都已經被發現。
第一項描述 Queue 的順序,第二項描述紀錄是否正確,第三項則把「已發現」與「已處理」接起來。第三項不表示整張圖都已經找到,只保證處理完一個城市後,它的鄰居就都有紀錄。把時間點放在每輪開始,也避開了「目前城市已經取出,但鄰居還沒看完」的中途狀態。
起點存在時,程式先記錄 台北 → 0,再把台北加入 Queue。Queue 只有一個城市,順序自然成立;台北到自己不需經過任何一條路,記錄值 0 也正確。唯一已發現的城市正在 Queue 等待,此時還沒有處理完的城市,因此第三項也成立。
假設這一輪開始時三項性質都成立,從 Queue 最前面取出城市 A,記錄值為 d。A 的鄰居有兩種情況:
distance 裡:直接跳過,原本的紀錄與 Queue 都不變。distance.get(A) + 1,也就是 d + 1,再將 B 加到 Queue 最後面。先看 Queue 的順序,取出 A 後,剩下的記錄值只有 d 或 d + 1,新加入的值也都是 d + 1,因此排在最後面仍然有序。若所有 d 都已經取完,下一輪最前面就變成 d + 1;如果 Queue 已清空,就沒有順序需要檢查。第一項能維持。
新鄰居 B 的紀錄是否正確,則需再推一步。依照第二項,A 的最少 edge 數確實是 d,沿 A–B 再走一條路,就有一條長度為 d + 1 的路。因此 B 的最少 edge 數不超過 d + 1;問題是,會不會還有一條不超過 d 的路?
先看 d 是 0 的情況,也就是 A 就是起點,這個情況要先單獨處理,因為接下來的推導會用到 d - 1。B 是尚未發現的新鄰居,起點一開始就已經發現,所以 B 不是起點,至少要走 1 條路才能抵達,記成 1 就是最少 edge 數。
d 至少是 1 時,假設 B 有一條更短的路徑,經過的路不超過 d 條。把時間停在本輪開始、A 還在 Queue 最前面的那一刻:此時每座城市只有兩種狀態,已發現(distance 裡有紀錄)或尚未發現。沿著那條假設的路徑,從起點逐一檢查每座城市當時的狀態:
d - 1。 「第一個」保證了排在 X 前面的城市當時全都已經發現,P 就是其中最後一個。路徑上相鄰的兩座城市之間必定有一條路,所以 P 與 X 互為鄰居,這一點第 3 步會用到。再數路:整條假設路徑最多 d 條路,而 P 後面至少還有 P–X 這一條,所以從起點走到 P 最多只用掉 d - 1 條。P 的最少 edge 數因此不超過 d - 1,依照第二項,它的記錄值也不超過 d - 1。若 P 還在 Queue,依照第一項,Queue 裡的記錄值由前到後不會變小,最前面的 A 是 d,排在它後面的每一個都不會小於 d。但 P 的記錄值不超過 d - 1,產生矛盾。
若 P 已經處理完,依照第三項,它的鄰居都應該已經被發現,而 X 正是它的鄰居,與 X 尚未發現矛盾。兩種狀態都不成立,因此假設的更短路徑不存在。
所以 B 不存在長度不超過 d 的路,而經過 A 又確實能用 d + 1 條路抵達,B 的最少 edge 數就是 d + 1。這個推理適用於 A 的每一個新鄰居;舊紀錄沒有改動,新紀錄也都正確,第二項於是維持。
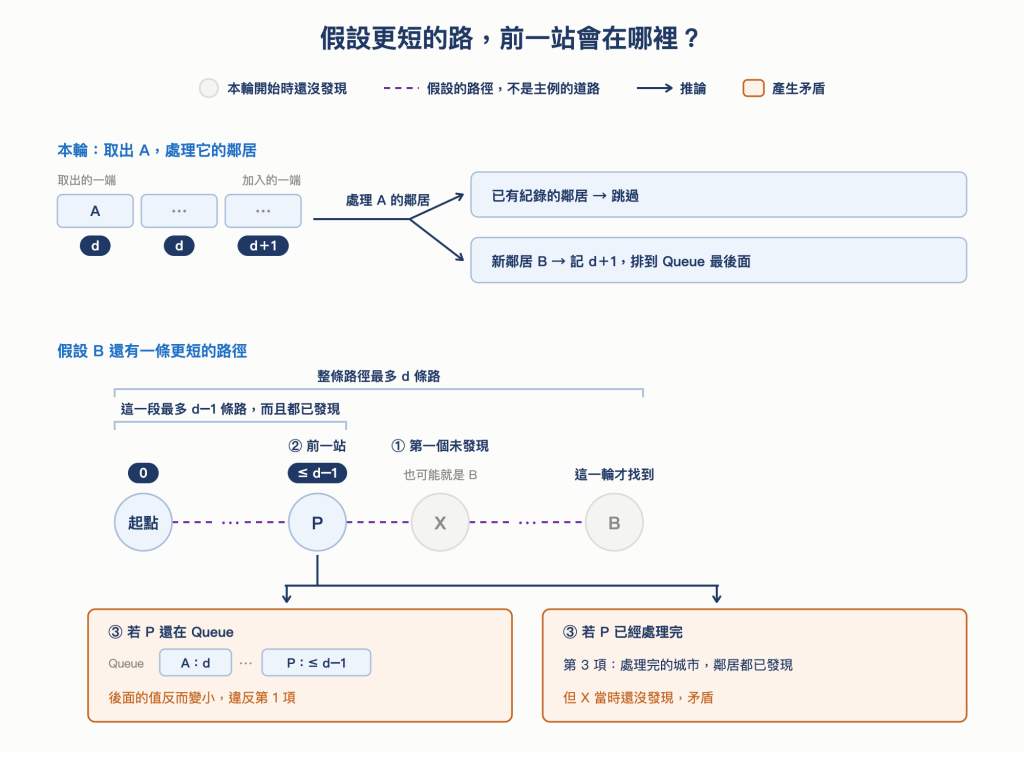
圖 11 更短路徑的前一站,兩種狀態都產生矛盾
最後看第三項。這一輪新發現的城市都已加入 Queue;A 的所有鄰居檢查完後,每個鄰居不是原本已有紀錄,就是剛剛新增紀錄。因此 A 可以列為已處理完,其他城市的狀態也符合原本的規則。到了下一輪開始,三項性質都仍然成立。
每個城市最多只加入 Queue 一次,每輪都取出一個城市,而這張 Graph 的城市數有限,因此迴圈最後會結束。Queue 清空時,依照第三項,每個已發現的城市都已經處理完;依照第二項,它們的紀錄都是最少 edge 數。
還需要確認的是,有沒有走得到、卻從來沒被發現的城市。假如有,沿一條從起點通往它的路,找出第一個未發現的城市 X。X 的前一站 P 一定已發現,而 Queue 已空,所以 P 已經處理完;但處理 P 時就應該發現鄰居 X,產生矛盾。所有可達城市都有紀錄,而且每筆紀錄都是正確的最少 edge 數。這也解釋了為什麼 BFS 可以直接跳過已經發現的城市,不必再用其他路徑更新距離。
第一次記下的距離不會被更短的路推翻,但其他路也可能同樣短。如果某個第 2 層城市分別和兩個第 1 層城市相連,兩邊都能用 2 條路抵達它。比較早被處理的那一邊會先發現它,另一邊之後看到時直接跳過,距離仍然是 2。
所以 BFS 不會在這些同樣短的路之間做比較,只留下最先發現的那一筆。這裡只要最少 edge 數,存一個距離就夠了;如果還需要最短那條路的實際路徑,需要另外處理,這會在之後的文章介紹~
同一層的先後順序也可以改變。若台北的鄰居排列改成先新竹、再宜蘭、最後桃園,台中就可能比苗栗先加入 Queue,但它們的距離仍然是 2,也不會讓第 2 層跑到第 1 層前面。
台中在輸出序列中排第幾個,還會受到同層城市數量與鄰居排列影響;distance 記錄的則是沿路走過的最少 edge 數,兩個數字回答的是不同問題。
BFS 和昨天的 DFS 都會查看起點能抵達的城市,但處理順序不同,保留下來等待處理的資料也不同。先用目前六城市、六條路的主例算 BFS 要做多少工作,再看走訪時需要另外存哪些資料。
先看 bfsDistances 的兩個迴圈。while 每次從 Queue 取出一個城市,裡面的 for 再查看這個城市的鄰居。從台北出發,6 個城市都能抵達,實際要做的工作如下:
| 工作 | 在主例中發生幾次 | 原因 |
|---|---|---|
| 將城市加入 Queue | 6 次 | 加入前就記錄為已發現,同一個城市不重複加入 |
| 從 Queue 取出城市 | 6 次 | 每個加入的城市最後都會取出處理 |
| 檢查鄰居是否已發現 | 12 次 | 台北、桃園、新竹各有 3 個鄰居,台中、宜蘭、苗栗各有 1 個 |
因此,雖然程式有兩層迴圈,內層並不是每次都檢查 6 個城市。處理台北時看 3 個鄰居,處理宜蘭時只看 1 個,全部加起來是 3 + 3 + 3 + 1 + 1 + 1 = 12 次。每次檢查都會查詢 distance.has(next),但只有第一次發現城市時,才會記錄距離並加入 Queue。
如果把城市數寫成 V、 edge 數寫成 E,加入 Queue 與取出的次數各自最多為 V。鄰居檢查則和 edge 數有關:台北–桃園這條路會在台北的名單出現一次,也會在桃園的名單出現一次。這張 Undirected Graph 的所有鄰居名單合計有 2E 筆,逐一檢查的工作量是 O(E)。
還有一項工作發生在 for 開始之前:neighbors(city) 會將鄰居 Set 複製成 Array。台北的名單要複製 3 筆,宜蘭的名單要複製 1 筆,整趟合計也是 12 筆。複製全部名單和掃描全部名單各是 O(E),相加仍是 O(E)。
在 Map/Set 查詢與更新、Queue 加入與取出採平均常數時間的假設下,城市的處理是 O(V),鄰居名單的複製與檢查是 O(E),因此 BFS 的時間複雜度為 O(V + E)。第一版 bfs 使用 visited 判斷是否已發現,再把取出的城市加入 order,每個城市同樣只記錄一次,時間複雜度也相同。
這裡算的是從起點能走到所有城市的情況。如果有不相連的區塊,就只處理可達的城市與它們的鄰居名單。這結論也和 Day 25 一樣,以目前的 Adjacency List 實作為前提;換成 Adjacency Matrix,每個城市都要掃完 V 格才能找出鄰居,worst case 就會是 O(V²)。
空間複雜度看的是「同時存活的最大資料量」。這裡沿用 Day 25 的 Auxiliary Space 計數方式,不計原本輸入的 Graph,也不把要回傳的結果計入。先列出 bfsDistances 建立的資料,區分回傳結果與額外工作空間:
| 走訪時建立的資料 | 保存什麼 | 最多需要多少空間 |
|---|---|---|
distance Map(回傳結果) |
已發現城市與起點之間的最少 edge 數 | 每個城市一筆,O(V);另列,不計入 Auxiliary Space |
| Queue | 已發現、還在等待處理的城市 | 同一個城市不重複加入,最多 V 個,O(V) |
neighbors(city) 回傳的 Array |
目前城市的鄰居名單 | 最多 V 個鄰居,O(V) |
鄰居 Array 要特別看它的使用時間。處理台北時,程式建立台北的鄰居 Array;等這份名單檢查完,才會從 Queue 取出桃園,再建立桃園的鄰居 Array。程式沒有把舊名單存到別處,不需同時保留所有城市的鄰居 Array。每次只需一份目前正在檢查的名單,而目前的 Graph 用 Set 避免重複鄰居,一份名單最多是 O(V)。
不計回傳的 distance Map,Queue 與目前的鄰居 Array 各需要 O(V) 空間,相加後仍為 O(V)。第一版不計回傳的 order,則還有 visited、Queue 與鄰居 Array,各自最多保存 V 筆資料,因此兩份 BFS 的 Auxiliary Space 都是 O(V)。若把回傳結果也一起算入,兩份結果各需 O(V),合計仍是 O(V)。
Queue 的大小是 O(V),但實際同時排著多少城市,會受到地圖形狀影響。先只比較 BFS 的 Queue 與遞迴 DFS 的 call stack,看看它們各自在什麼情況下變大。
如果把地圖改成一個極端的形狀:台北直接連到另外 5 個城市,而這 5 個城市只連回台北,彼此沒有路。這張圖仍然有 6 個城市,但道路改成只有台北與其餘城市之間的 5 條連線。
BFS 取出台北後,會一次把 5 個鄰居都排進 Queue。接下來每取出一個,就發現它只連回已經標記的台北,沒有新城市可加入。Queue 的數量因此從初始化的 1,變成 5,再依序降到 4、3、2、1、0。即使從台北到任何其他城市都只有 1 條路,隊伍仍可能很長。
遞迴 DFS 則先從台北進入其中一個城市,看完它只連回台北,就返回台北,再去下一個。若只數正在處理不同城市的呼叫,會同時保留台北與其中一個鄰居,深度是 2。Day 25 的程式是在進入函式後才檢查 visited,因此鄰居呼叫台北時,還會短暫多一層立即返回的呼叫。圖中的深度 2 只計算正在處理不同城市的呼叫,不包含這一層。
這裡比較的是 BFS 的 Queue 與遞迴 DFS 的 call stack,不能直接換成昨天的顯式 Stack 版。那版會把台北的鄰居一起推入 Stack,這張圖同樣可能一次存著 5 個城市;同樣是 DFS,保存待處理工作的方式仍要看實作。
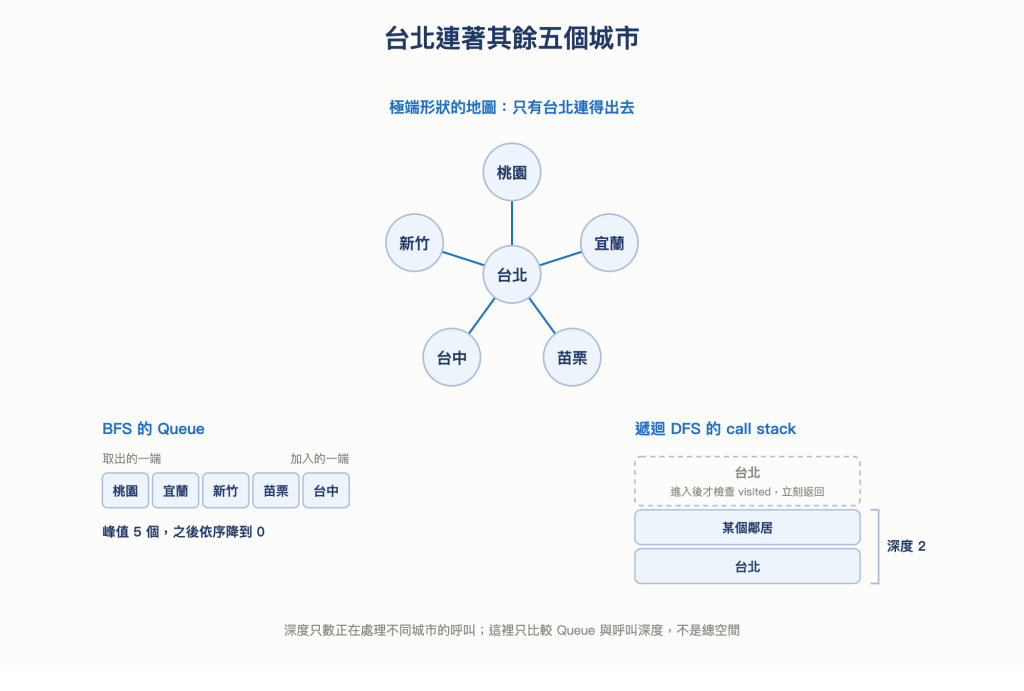
圖 12 從台北到其餘城市各走 1 條路,Queue 最多 5 個
另一個極端是 6 個城市只連成一條路:台北、桃園、新竹、台中、苗栗、宜蘭依序相連,沒有其他岔路。從台北開始,每個城市最多只會發現一個還沒走過的鄰居。
BFS 取出台北後放入桃園,取出桃園後放入新竹,一路以相同方式往下。只看 Queue,裡面最多只有 1 個城市。遞迴 DFS 卻必須保留尚未返回的呼叫,從台北深入到宜蘭時,6 個不同城市的呼叫都還在 call stack 裡;等宜蘭處理完,才一層一層返回。若道路繼續延長,這個深度也跟著增加。
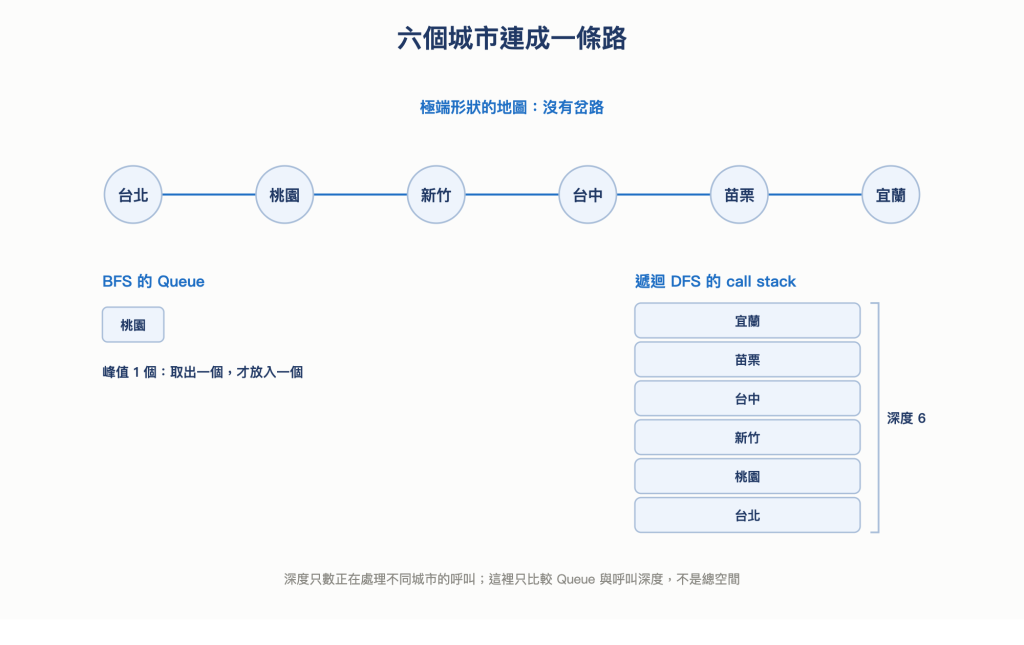
圖 13 隊伍裡最多只有 1 個城市,呼叫卻疊到 6 層
這兩張圖比較的是 Queue 裡同時等待的城市,以及遞迴 DFS 正在處理不同城市的呼叫深度。同樣 6 個城市,寬的地圖讓 BFS 的 Queue 變長,深的地圖讓 DFS 遞迴呼叫變深,這就是「BFS 看寬度、DFS 看深度」想描述的差異。
不過,圖 13 只能說明這張地圖的 Queue 最多有 1 個城市,不能據此把整份 BFS 的空間複雜度改成 O(1)。第一版的 visited 不是回傳結果,會一路累積全部城市,在這張長鏈上仍然是 O(V);距離版按這裡的算法不計入 distance,長鏈上的 Queue 與鄰居 Array 的確都只有常數,但那來自這張圖的形狀,換成圖 12 那張圖,Queue 一輪就會排到 5 個。同樣的,圖 12 的遞迴 DFS 雖然呼叫很淺,仍然需要 visited 與鄰居 Array。寬與深只解釋其中一部分資料為什麼變多,不能代替整份程式的空間計算。
BFS 和 DFS 都會處理可達的城市與鄰居名單,因此在 Adjacency List 上,時間複雜度同樣是 O(V + E)。選擇時更需要看的是走訪順序,以及題目是否需要最少 edge 數:
| 比較項目 | DFS | BFS |
|---|---|---|
| 走訪順序 | 沿一條分支深入,再回頭換分支 | 先處理較近的一層,再往外展開 |
| 首次抵達的路徑 | 不保證最少 edge 數 | 可以確定最少 edge 數 |
| 待處理資料 | 遞迴版使用 call stack;迭代版使用顯式 Stack | 使用 Queue |
| 時間複雜度 | O(V + E) |
O(V + E) |
| 適合的問題 | 需要先沿一條分支探索,再回頭處理其他分支 | 想先看起點附近,或要最少 edge 數 |
本篇兩份 BFS 的額外空間都是 O(V)。寬/深地圖的比較則說明,Queue 與遞迴 call stack 的實際大小,會隨 Graph 形狀而改變。
Day 25 的 DFS 實作還會保留多層鄰居 Array,或在顯式 Stack 中存入重複城市,因此額外空間為
O(V + E),原因已在該篇說明。這是目前寫法的成本;改成直接迭代鄰居集合、避免重複項目後,DFS 的額外空間也可以是O(V)。
這裡先從 GC 如何判斷物件是否仍可達看起,再看看 DevTools 如何把物件與引用呈現出來,以及其中的 Distance 為什麼能用今天的 BFS 計算。
前面幾篇實作 Linked List、Queue 時,一直在建立物件、修改引用。不過把 node 從串列移除,或把 Queue 的某一格刪掉之後,原本那個物件佔用的記憶體怎麼辦?JavaScript 會在建立物件時配置記憶體,也會由引擎的垃圾回收 (Garbage Collection,簡稱 GC) 機制找出可以回收的空間,讓之後的資料繼續使用。這是自動記憶體管理的一部分,不需要每次建立物件,都另外配上一行手動釋放的程式。
但引擎怎麼知道物件已經用完了?它無法直接知道我們接下來的業務邏輯還需不需要某筆資料,因此會從「程式是否還能沿著引用找到它」來判斷。即使頁面已經不顯示一筆資料,只要快取仍然指向它,它就可能繼續留在記憶體裡。
例如有一個仍被程式保留的 cache 物件,其中的 item 屬性指向一個叫做 data 的資料物件。另一個 holder 物件的 item 屬性,也指向同一個 data。移除 cache.item 只會斷掉其中一條引用;只要還能經由 holder.item 找到 data,它就仍然可達。刪除一個屬性,和回收它原本指向的物件,是兩件不同的事。
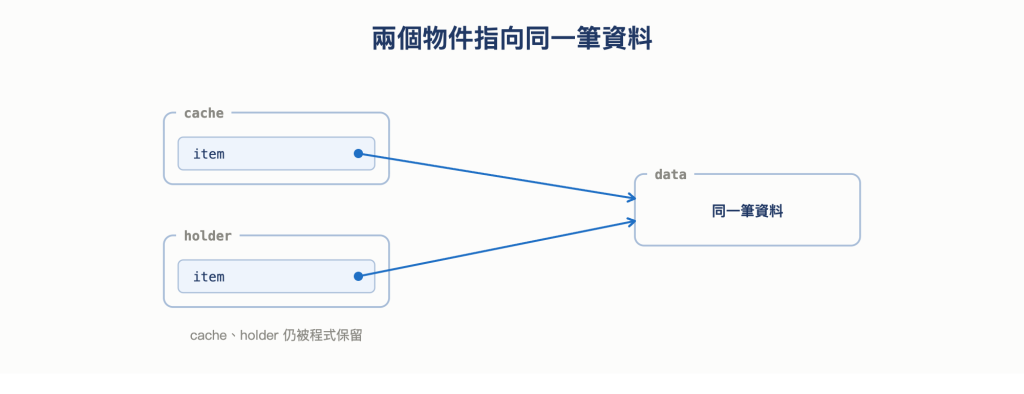
圖 14 兩個物件的屬性,指向同一筆資料
這些物件與引用正好構成 Directed Graph:物件是 vertex,指向其他物件的引用是 edge。Graph 走訪需要起點,GC 也一樣。引擎會從已知需要保留的起始來源開始,例如全域物件、目前執行中的函式所持有的引用,這些起始來源稱為 GC roots。它們是一組來源,不是隨意挑出一個物件,也不只有一個起點。V8 的 marking 說明就是從這些 roots 開始描述物件走訪。
先把物件關係當成暫時不變。這趟走訪會用標記記錄每個物件的處理進度,並用待處理集合保存等待檢查引用的物件。流程可以分成三個步驟:
這些狀態在 V8 的標記說明裡稱為三色標記 (Tri-color Marking),用白、灰、黑表示這一次標記的進度:
| 顏色 | 物件的狀態 | 對照今天的 BFS |
|---|---|---|
| 白色 | 尚未發現 | 還不在 visited 裡 |
| 灰色 | 已經發現,但還沒完成引用檢查 | 還在 Queue 裡等,或正在檢查鄰居 |
| 黑色 | 引用已經檢查完畢 | 這個城市的鄰居迴圈已經跑完 |
沿用剛才的例子,第一次發現 cache 時,它由白色變成灰色,加入待處理集合。查看 cache 的引用時,若 data 還是白色,就把 data 也標成灰色並安排處理;等 cache 的引用全部看完,cache 才變成黑色。這時 data 可以仍然是灰色,因為查看完一個物件的直接引用,不代表沿途所有物件都已經處理完。
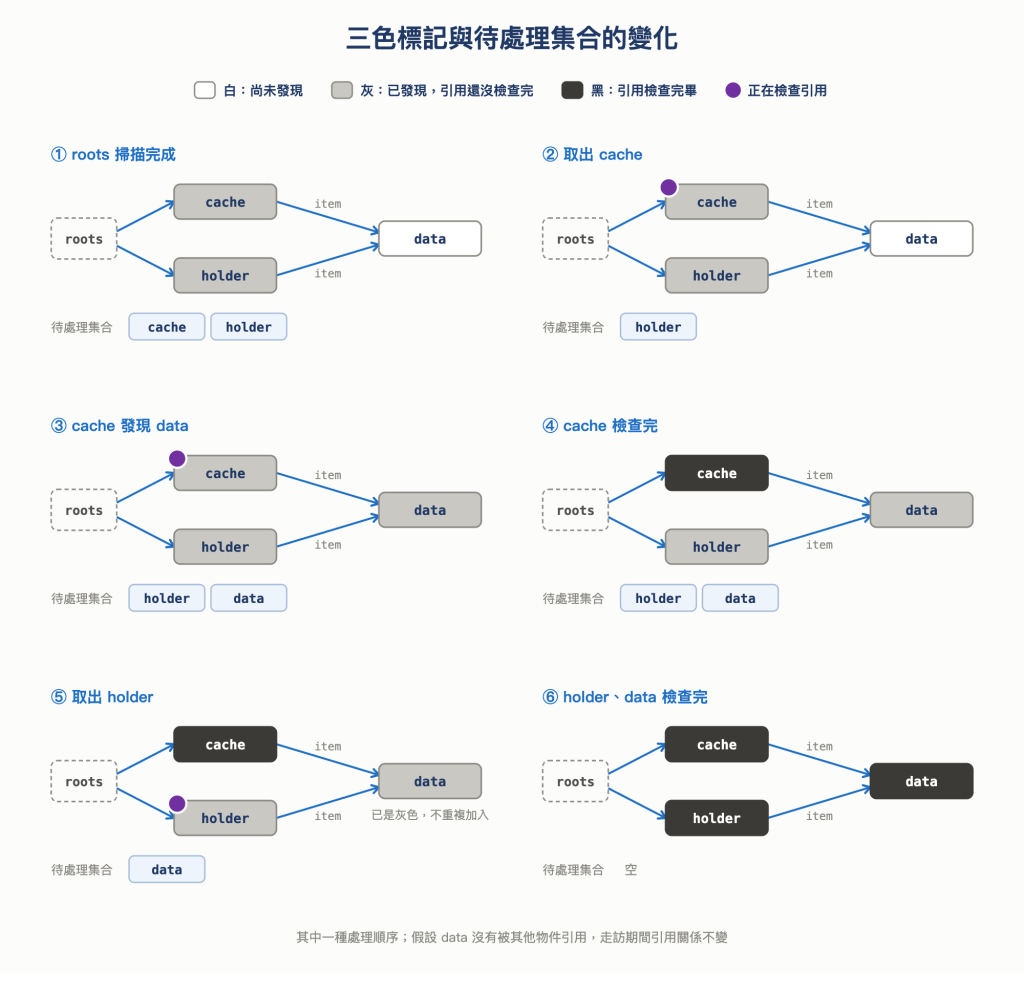
圖 15 取出後仍是灰色,引用檢查完才轉黑
對照今天的 BFS,這三種狀態其實早就藏在程式裡,只是我們沒有另外取名字。城市一加入 visited 就不會再移除,所以 visited 同時裝著灰色與黑色,能把兩者分開的是 Queue:在每輪 while 開始時,還在 Queue 裡等的城市是灰色,已經發現、卻不在 Queue 裡的城市是黑色。另外,dequeue() 只是取出城市,後面的鄰居迴圈還沒跑完,不能一取出就視為黑色。
前面證明用到的第三項性質,換成三色來說就是:黑色物件不會指向白色物件,因為處理完的城市,鄰居都已經被發現。三色標記要一路維持的就是這條規則。
當所有灰色物件都處理完,仍然是白色的物件才可判定為不可達;走訪中途的白色只代表還沒找到,不能立刻回收。記住發現狀態,也讓不同物件共享同一筆資料或引用形成環時,不會一直重複安排。即使兩個物件互相引用,只要從 roots 已經無法抵達它們,這兩個物件仍然可以被回收。
上面先假設走訪期間的引用關係不變,用來理解 GC 如何找出可達物件。這個問題只需要知道「能不能抵達」,不要求按照距離逐層處理,因此不一定要使用 BFS;而且找出可達物件只是 GC 的一部分,實際引擎還有其他工作要做。
回到前面 cache、holder 那個例子,現在可以把「刪除一個屬性」和「回收它原本指向的物件」這兩件事畫在一起比較。
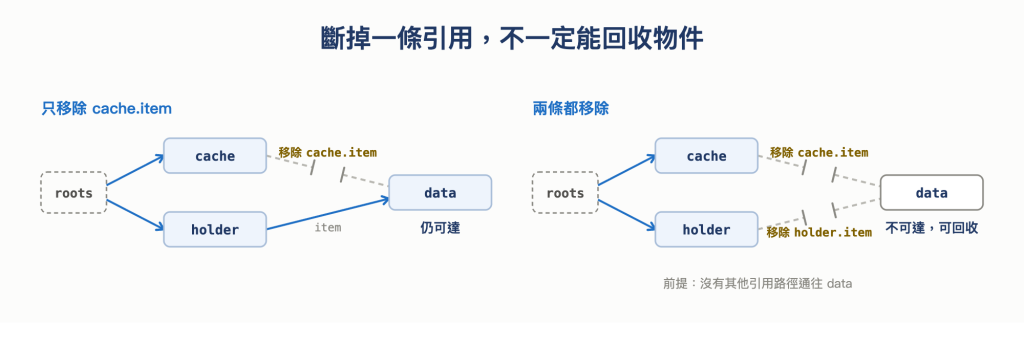
圖 16 所有可達路徑都斷開後,物件才可回收
另外,距離這件事會在另一個相關問題出現,當我們想檢查某個物件為什麼還留在記憶體裡時,可以怎麼觀察這張引用圖?
Chrome DevTools 的 Heap Snapshot,也就是堆積記憶體快照,會記錄某個時間點的物件及引用關係,讓我們檢查記憶體裡有哪些物件、它們佔多少空間,以及誰還保留著它們。這裡的 heap 指存放物件的記憶體區域,和 Day 22 取最大/最小值的 Heap 資料結構不同意思。
在 DevTools 的 Memory 面板選擇 Heap snapshot,再按 Take snapshot,就能取得一份快照。Chrome 會在拍攝前先進行垃圾回收,因此它適合用來觀察回收後仍保留的物件,不是把程式曾建立過的物件全列出來。官方操作說明也提供了快照的不同檢視方式。
預設的 Summary 會先依建構函式分組,展開後才能查看個別物件。回到剛才的例子,關閉資料畫面後,若那筆 data 仍出現在快照中,下一個問題就是「還有誰指向它」;假如 cache 或 holder 仍保留它,GC 就不能只因為畫面關閉而把它收走。
快照裡會呈現不同資訊。物件本身佔用多少空間,對應 Shallow Size 欄位;Retained Size 則是這個物件被移除之後能一起回收的空間,也就是它自己加上只能經由它抵達的那些物件;而 Distance 描述從 root 沿引用抵達物件的最短距離。前兩者看記憶體大小,最後一個看引用圖裡隔了多少步。
下圖是我在 google.com 的 Heap Snapshot。上半部是 Summary,右側可以對照 Distance、Shallow Size 與 Retained Size 欄位;下半部的 Retainers 則列出保留所選物件的引用關係,可以沿著它查看誰還指向這個物件。
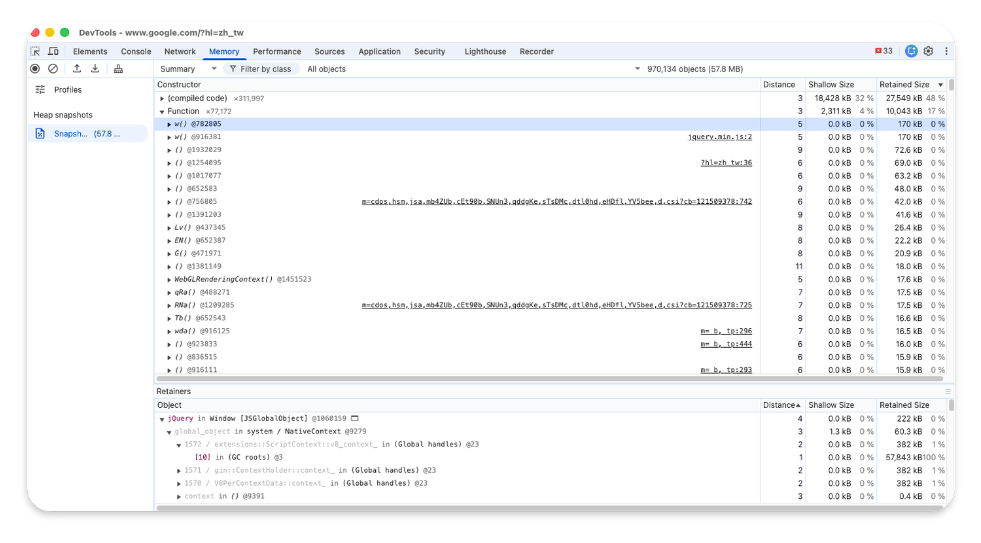
圖 17 google.com 的 Heap Snapshot(資料來源:自行截圖)
Distance 是從 root 沿引用往外算;Retainers 則是從選取的物件往回查。沿著最短引用路徑反查時,Distance 會逐步減 1;但 Retainers 也會列出其他保留路徑,因此不是每條分支都會逐層減 1。
先把實際引擎內部的 roots 簡化成一個示意起點 root。root → cache → data 表示經過兩次引用能抵達 data;另一條 root → holder → data 則是同樣長的路。正好對應今天的城市地圖:城市換成物件,道路換成有方向的引用,要計算的仍是最少 edge 數。
從示意 root 的距離 0 開始,先把 cache 與 holder 記成 1,再加入 Queue。取出 cache 時第一次發現 data,將它記成 2;之後取出 holder 又遇到同一個 data,因為已有紀錄,就直接跳過。兩條路共享同一個物件,不需要建立兩份 data,也不需要將它加入 Queue 兩次。如果 root 還直接指向 data,它就會在處理 root 時先被記成 1;之後從 cache 或 holder 再遇到它,也不會改成 2。這和前面台北若能直達台中,第一輪就會找到它,是相同道理。
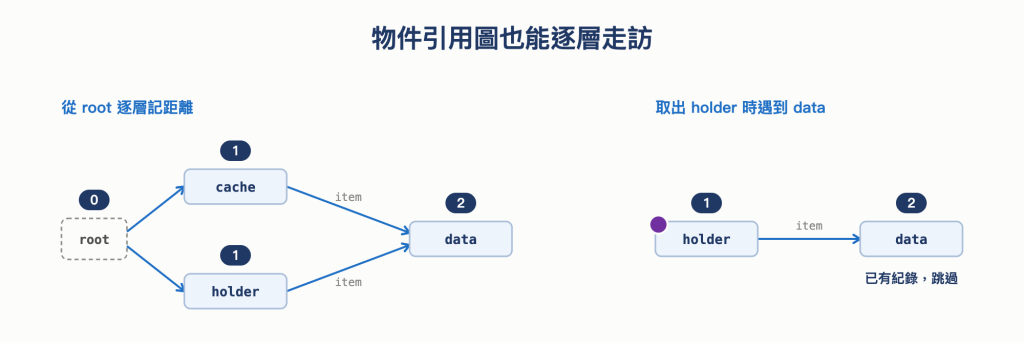
圖 18 沿引用逐層記距離,共享物件不重複加入 Queue
在 DevTools 的 HeapSnapshot.ts 中,calculateDistances 負責安排起始 node,bfs 則沿引用計算距離。原始碼用陣列搭配往前移動的讀取位置,先加入的物件先取出;發現尚未記錄的物件時,存下目前距離加 1,再放到待處理陣列尾端。雖然沒有像我們一樣呼叫 HeadIndexQueue,維持的仍是 FIFO;取出那一行還註明 shift generates too much garbage,同樣是用往前移動的位置來避開 shift()。
實際 DevTools 會區分不同 roots,也會篩選引用,因此圖 18 的距離 0、1、2 只用來示範 BFS 如何計算。另外,記憶體洩漏要判斷的是 Retainers 裡那些引用還需不需要,和 Distance 的資訊無關。
小小總結一下今天對 BFS 的認識~
實際使用時,還可以記住幾件事~
圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術