
今天要介紹的是幾個從演算法層級優化程式的小技巧,會從一些題目來看如何應用~
之前介紹的問題通常可快速找到對應解法,例如要把資料排好就去找排序演算法,要在城市之間找總票價最低的飛法就用 Dijkstra,按照演算法執行就好。但實際寫程式時問題通常更複雜,我們無法從問題情境中直接想到對應的演算法解法,或是想到的方法執行效率很慢,這時就可以用一些角度來重新思考問題~
在優化之前,要先知道目前的起點,所以我們要先算出目前做法的 Big O,後面才有基準判斷改寫後的成本有沒有降低,以及哪一段還有優化空間。
知道現在的成本之後,接著要問:對這個問題來說,理論上能想像到的最快是多少?
「理論上能想像到的最快」可稱為 Best-Imaginable Big O,也就是這個問題的「理想目標」,用來指引優化方向。它不保證一定達得到,也不是已經證明的最低成本。
舉例來說,如果任務是把一個 Array 裡的 N 個元素全部印出來,那每個元素至少都得被處理一次,所以這個問題能想像到最快的 Big O 就是 O(N)。不可能做到 O(1),因為不去碰某些元素,就不可能把它們印出來。
有了這兩個數字,就可以把它們擺在一起比較。如果目前是 O(N²)、理想是 O(N),中間的差距就代表這程式可能還有改善空間。
就算最後沒有達到理想目標,它還是會逼我們去問:現在這些工作裡,哪些其實可以消除?
接下來就來看看幾個可以思考的方向~
一樣先給一句話定義:
Recognizing Patterns 是去找出 input 與 output 之間藏著的規律,讓程式不必模擬整個過程就能直接得到答案。
有些解法需要大量運算,是因為我們照著題目的規則,把各種可能的過程逐一模擬出來。而如果我們能找出直接判斷結果的規律,並證明它成立,就能省掉中間的模擬步驟。那要怎麼找規律呢?找規律最實用的方法其實很土法煉鋼,就是列出大量的 input 和 output 例子,然後看它們之間有什麼關係。
聽起來很抽象,所以接著用實際問題情境來說明~
Coin Game 的規則為,桌上有一堆硬幣,兩個人輪流拿,每次可以拿 1 枚或 2 枚,拿走最後一枚的人輸。假設雙方都會採取最好的策略,此時若給定一開始的硬幣數,先手會贏還是會輸呢?
具體來說問題是這樣:
coins,一開始桌上的硬幣數,正整數true 代表先手會贏,false 代表先手會輸coins >= 1,雙方都不會失誤預期使用方式則是這樣:
firstPlayerWins(1); // false,桌上只剩一枚,先手只能拿走它
firstPlayerWins(2); // true,先拿 1 枚,對手被迫拿走最後一枚
firstPlayerWins(4); // false
照著規則想的話,硬幣足夠時,每個局面都有兩種選擇:拿 1 枚或拿 2 枚。如果拿完還沒結束遊戲,就繼續分析對手接下來的選擇,一路往下展開。
這樣展開會遇到昨天那種重複計算的情況。從 7 枚開始,「先拿 1 枚、對手再拿 2 枚」和「先拿 2 枚、對手再拿 1 枚」,都會回到剩 4 枚、輪到原本先手的局面。兩條不同的分支,接下來要解的卻是同一個問題。
雙方規則相同,勝敗只取決於剩下幾枚硬幣,所以可以用昨天的 memoization 把每個硬幣數的答案存起來,時間降到 O(N)。
但這題的 input 只有一個數字而已。有沒有可能連每個局面都不必算、不必存對應表,直接用 O(1) 得到答案呢?
首先,先土法煉鋼來產生一些例子看看~
| 硬幣數 | 先手會輸還是贏 |
|---|---|
| 1 | 輸 |
| 2 | 贏 |
| 3 | 贏 |
| 4 | 輸 |
| 5 | 贏 |
| 6 | 贏 |
| 7 | 輸 |
| 8 | 贏 |
| 9 | 贏 |
| 10 | 輸 |
前面幾筆可以自己推推看。剩 1 枚時只能把它拿走,所以先手輸。剩 2 枚時拿 1 枚,對手就只剩 1 枚、被迫拿走最後一枚,所以先手贏;剩 3 枚時拿 2 枚,結果一樣。那 4 枚呢?拿 1 枚會讓對手拿到 3 枚,拿 2 枚會讓對手拿到 2 枚,而 2 枚和 3 枚都是「輪到的人會贏」的局面,兩條路都會讓對手贏,所以 4 枚時先手輸。
列到 10 就可大概看出規律了,先手會輸的是 1、4、7、10,每隔 3 個出現一次。
1、4、7、10 這幾個數字各減 1 之後是 0、3、6、9,都可以被 3 整除。也就是說,先手會輸的條件是 (coins - 1) % 3 === 0。
不過這幾筆例子只是讓我們看見規律,還不足以宣稱它對所有硬幣數都成立。要能推到全部,得說得出理由。
要避免把「餘數 1 必敗」和「其他餘數必勝」當成彼此的前提,可以用 Day 04 提過的歸納法來想想看。
先看最小的局面:只有 1 枚時,輪到的人只能拿走最後一枚,所以必敗。接著先假設,比目前硬幣數更少的局面,都已經能按照除以 3 的餘數正確分成勝敗。現在再判斷目前這個更大的局面:
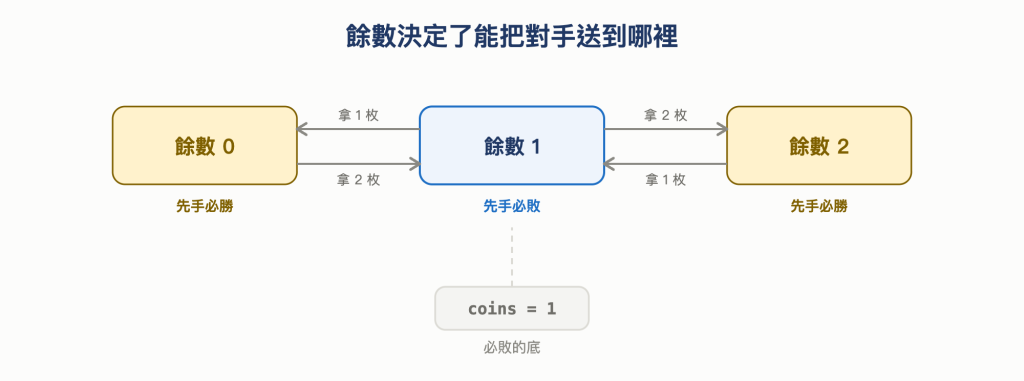
圖 1 餘數決定了能把對手送到哪裡
由上可知,每一步用到的,都是歸納假設中那些已經證明的較小局面。因此硬幣數除以 3 餘 1 時先手必敗,其餘情況先手必勝。
了解規則後,程式中就不需模擬各種情境了,只需要一個判斷式:
function firstPlayerWins(coins) {
  return (coins - 1) % 3 !== 0; // 餘數為 1 的局面,怎麼拿都會輸
}
不管硬幣有幾枚,都只做固定次數的運算,所以時間是 O(1),也沒有建立任何隨硬幣數增加的資料,空間也是 O(1)。
因此,解 Coin Game 的流程就從必須展開整棵分支,到每個局面只算一次,再到現在連算都不必算。
Sum Swap 的題目為,輸入兩個整數 Array,要從兩邊各挑一個值交換,讓交換後兩邊的總和相同。
具體來說問題和預期使用方式是這樣:
arrayA、arrayB 兩個整數 Array[indexA, indexB],分別是 arrayA 和 arrayB 裡要拿去交換的那個值的 index;不存在合法的交換就回傳 null
const arrayA = [2, 1, 8, 10, 5]; // 總和 26
const arrayB = [4, 7, 6, 3]; // 總和 20

sumSwap(arrayA, arrayB); // [3, 1],交換 arrayA 的 10 和 arrayB 的 7,兩邊都變成 23
sumSwap([1], [2]); // null,兩邊總和差是奇數,不可能有解
針對這問題,最直接的做法是先把兩邊的總和各算一次,然後每一組配對都試試看:把 arrayA 的某個值換成 arrayB 的某個值之後,兩邊會不會剛好相等。
function sumSwap(arrayA, arrayB) {
  let sumA = 0;
  for (const value of arrayA) sumA += value; // 總和先算好,之後每組配對只做加減

  let sumB = 0;
  for (const value of arrayB) sumB += value;

  for (let indexA = 0; indexA < arrayA.length; indexA += 1) {
    for (let indexB = 0; indexB < arrayB.length; indexB += 1) {
      const a = arrayA[indexA];
      const b = arrayB[indexB];
      if (sumA - a + b === sumB - b + a) return [indexA, indexB]; // 交換後兩邊剛好相等
    }
  }

  return null;
}
假設 arrayA 有 5 個元素、arrayB 有 4 個,總共有 20 組配對,最壞的情況得全部試過才知道答案。先算兩邊總和是 O(N + M),再試 N × M 組配對,完整寫出來是 O(N + M + NM);兩個 Array 都不是空的時候,NM 這一項會蓋過另外兩項,也就是 O(NM)。
那理想目標呢?至少得把兩邊的數字都看過一次才有辦法判斷答案,所以理想目標是 O(N + M)。
如何達到理想目標呢,就來運用第一個技巧 Recognizing Patterns,先土法煉鋼挑幾組來觀察看看規律~
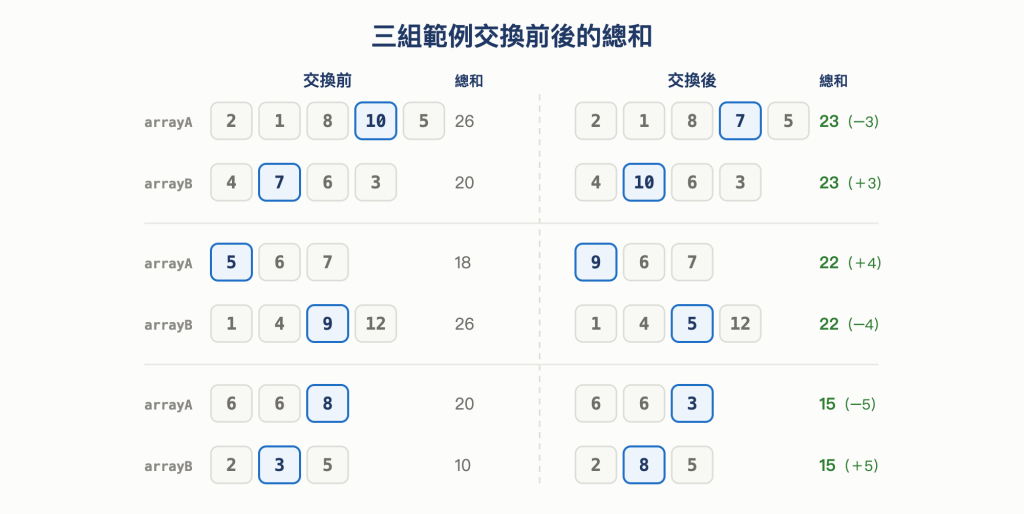
圖 2 三組範例交換前後的總和
三組的長度和數字大小都不一樣,交換後 arrayA 那一邊有時候變小、有時候變大。但有兩件事每一組都成立:交換前後,兩邊總和相加起來都沒有變;而交換後兩邊的總和,剛好都落在原本那兩個總和的正中間。
原因是交換只是把一個值從 arrayA 搬到 arrayB、同時把另一個值從 arrayB 搬回 arrayA,兩邊加起來的總量並沒有跟著改變。因此一邊減少多少,另一邊就一定增加多少。
回到一開始那組資料。arrayA 的總和是 26、arrayB 是 20,兩邊相加是 46,而且不管交換哪兩個值都還是 46。要讓兩邊相等,就只剩下一種可能,兩邊各是 23,也就是 26 和 20 的中點。
所以目標是 arrayA 要從 26 減少 3,arrayB 要從 20 增加 3。
把這個觀察寫成一個運算式看看。假設 arrayA 交換出去的值是 a、arrayB 交換出去的值是 b,交換後 arrayA 的總和是 sumA - a + b,arrayB 的總和是 sumB - b + a。要讓兩邊總和相等,運算式可以這樣寫:
sumA - a + b = sumB - b + a
sumA - sumB = 2a - 2b
a - b = (sumA - sumB) / 2
代入實際數字驗證一下,(26 - 20) / 2 = 3,而正確答案那一組交換的確實是 arrayA 的 10 和 arrayB 的 7,相差 3。
這裡把 (sumA - sumB) / 2 取名為 shift,意思是 arrayA 交換出去的值要比 arrayB 交換出去的值大多少。以這組資料來說 shift 是 3。
有了這運算式以後狀況就不同了,原本我們要問的是「arrayA 裡面有沒有哪個值可以和 b 交換」,得把 arrayA 整個掃過一次;現在則變成「arrayA 裡面有沒有 b + 3」,因為能和 b 配成一對的值只有這個。
因為 a 和 b 都是整數,a - b 也必須是整數,所以 (sumA - sumB) / 2 要除得盡才有解。兩邊總和的差是奇數時,這題不可能有合法的交換。
所以程式裡要處理這種狀況,兩邊總和的差是奇數就直接回傳 null。拿 [1] 和 [2] 來看,總和差是 -1,若硬算下去 shift 會是 -0.5;但 arrayA 和 arrayB 裡都只有整數,不可能找到相差 -0.5 的一對值。就算省略這道檢查,JavaScript 版本最後也會因為找不到配對而回傳 null;保留檢查,是為了把已經證明的無解條件寫進程式,也省下後續的搜尋。
找到 Sum Swap 的規律後,剩下的問題是:如何快速在 arrayA 裡找到 b + shift?
如果對每個 b 都逐一掃過 arrayA,整體仍然是 O(NM)。這時可以我們可以利用另一個技巧,Magical Lookup:
Magical Lookup 是先假設某個很慢的查詢可以變成
O(1),看整支程式會不會因此變快;會的話,就換一個真的能提供這種查找的資料結構。
Hash Table 就是能提供這種查找的資料結構之一,它的查找平均可以做到 O(1)。Day 01 有提到一個把 users.find 換成 usersById 的例子,實際上就是運用 Magical Lookup 的技巧,只是當時一眼就看得出要查什麼,而這題得先推導出規則才知道。
實際做法是先遍歷一次 arrayA,一邊累加總和,一邊把每個值對應到它的 index 存進 Map。可以先把它想成下面這種 key-value 對應:
indexOfValue = {
  // arrayA 的值: 該值所在的 index
  2: 0,
  1: 1,
  8: 2,
  10: 3,
  5: 4,
};
之後對 arrayB 的每個 b,只要問一次 Map 裡有沒有 b + shift 就可以了。
將上述的流程寫成程式碼如下:
function sumSwap(arrayA, arrayB) {
  const indexOfValue = new Map();
  let sumA = 0;

  arrayA.forEach((value, index) => {
    // 建立 Map
    sumA += value;
    indexOfValue.set(value, index);
  });

  let sumB = 0;
  for (const value of arrayB) sumB += value;

  if ((sumA - sumB) % 2 !== 0) return null;

  const shift = (sumA - sumB) / 2; // 算出配對值之間的差

  for (let index = 0; index < arrayB.length; index += 1) {
    const counterpart = arrayB[index] + shift;
    if (indexOfValue.has(counterpart)) {
      return [indexOfValue.get(counterpart), index];
    }
  }

  return null;
}
這裡用 has 判斷、而不是直接看 get 的結果,因為 arrayA 的 index 0 也是合法答案,而 0 在 JavaScript 裡是 falsy。
用同一組資料走一次流程看看。這時 shift 是 3,indexOfValue 也已經記下 arrayA 每個值的 index:
arrayB[0] 是 4,要找的 counterpart 是 4 + 3 = 7,indexOfValue 裡沒有這個 key,換下一個;arrayB[1] 是 7,要找的是 7 + 3 = 10,indexOfValue 裡有,記著的 index 是 3,於是回傳 [3, 1],不必再檢查 arrayB 剩下的值。
換成查表之後,時間複雜度會變怎樣呢?遍歷一次 arrayA 同時完成累加和建立 Map,是 N 步;走 arrayB 算總和是 M 步;再遍歷 arrayB 一次找配對又是 M 步。加起來大約 N + 2M,忽略常數後就是 O(N + M),剛好落在一開始訂的理想目標上。
重複的值會覆寫同一個 key,所以 Map 最多存 N 組 key-value,額外空間是 O(N)。比較兩種做法,差別如下:
| 做法 | 時間 | 額外空間 |
|---|---|---|
| 逐一試每一組配對 | O(NM) |
O(1) |
| 找出規律再查表 | O(N + M) |
O(N) |
這個 O(N + M) 是拿 O(N) 的額外空間換來的;資料量很小時,建立 Map 的實際成本也可能讓逐一比對更快。
再來看下一個優化小技巧,稱作 Greedy Algorithm:
Greedy Algorithm 是在每一步都根據目前已知的資訊,直接選擇當下看起來最好的選項,而不先把所有可能的後續發展都分析過。
Day 27 的 Dijkstra 就是利用這個原則,每一輪都從還沒確定的城市裡挑出紀錄最低的那個並把它確定下來;那篇花了很長的篇幅證明這樣挑為什麼是對的,前提是票價非負。局部的選擇要能成立,每一次都需要它自己的理由。
一樣來看應用 Greedy 策略的實際案例~從最單純的例子開始,輸入一個非空的數字 Array,回傳裡面最大的那個數字。
max([3, 9, 2, 7]); // 9
要找出一個 Array 裡最大的數字,可以讓每個數字和其他所有數字都比一次,那會是 O(N²)。但還有另一個做法,只要一邊走一邊記住目前看過最大的值就好:
function max(numbers) {
  let greatest = numbers[0]; // 先假設第一個最大

  for (const number of numbers) {
    if (number > greatest) greatest = number; // 遇到更大的就換掉
  }

  return greatest;
}
先假設第一個數字最大,是因為那時只看過它,它就是「目前看起來最好」的那個選擇。走完一輪留下來的一定是全部裡面最大的,這是一次走訪,屬於 O(N),而且已經是這個問題能做到的最快,因為至少得看過每個數字一次。
這題很單純,那如果問題再複雜一點,還能不能同樣只保留目前最好的那一個呢?
最大連續和的目標是找出一個 Array 裡連續的一段,使這段的總和最大。這樣的一段就是一個連續子 Array,下面都稱它為區段。
具體問題和預期用法如下:
numbers,一個整數 ArraymaxSubarraySum([3, -4, 4, -3, 5, -9]); // 6,來自 [4, -3, 5] 這一段
maxSubarraySum([1, 2, 3]); // 6,整個 Array 就是答案
第一個例子整個 Array 的總和是 -4,但把範圍縮小到 [4, -3, 5] 這一段,總和才是最大的 6。以下說明都會拿這組數字當例子。
直覺想到的做法可能是把所有連續區段都列出來相比,數量大約是 N² / 2 個。只要在內層迴圈往右走時順便累加,整體就是 O(N²)。
理想目標一樣是 O(N),至少要看過每個數字一次。
既然要一次走訪,最直接的 Greedy 想法可能是:用一個變數持續累加,另一個變數記住過程中看過的最大值。用這方式走一次看看:
| 步驟 | 元素 | 累加值(從開頭) | 目前最大 |
|---|---|---|---|
| 1 | 3 | 3 | 3 |
| 2 | -4 | -1 | 3 |
| 3 | 4 | 3 | 3 |
| 4 | -3 | 0 | 3 |
| 5 | 5 | 5 | 5 |
| 6 | -9 | -4 | 5 |
走完以後會得到 5,但答案卻是 6。
看來 greedy 的假設出了點問題~?問題在於這支程式從第一個元素加到底,它考慮的全都是「從開頭算起」的區段。而真正的答案 [4, -3, 5] 是從第 3 個元素才開始的,這種中途才起頭的區段,它完全沒有考慮。
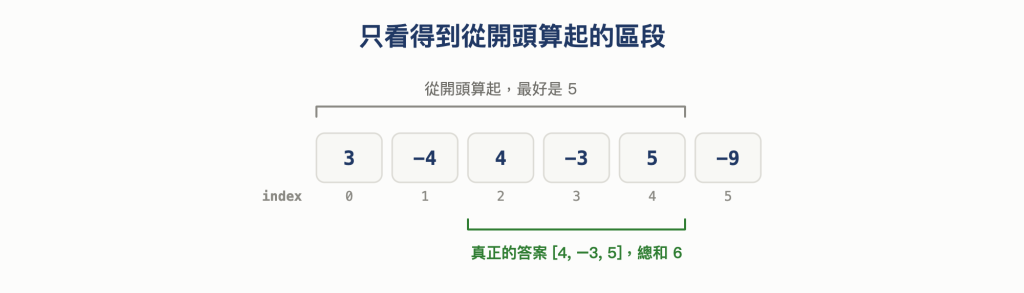
圖 3 只看得到從開頭算起的區段
發現了漏掉的區段以後,下一個想法可能是:那加總時遇到負數就重新開始好了。但這個想法會立刻被同一組數字推翻,答案 [4, -3, 5] 裡面就包含一個 -3,最好的那段是可以包含負數的。
那到底該在哪裡重新開始?沒頭緒的話,一樣先土法煉鋼,多找幾組數字,把每一格的累加值和真正的答案擺在一起看看。
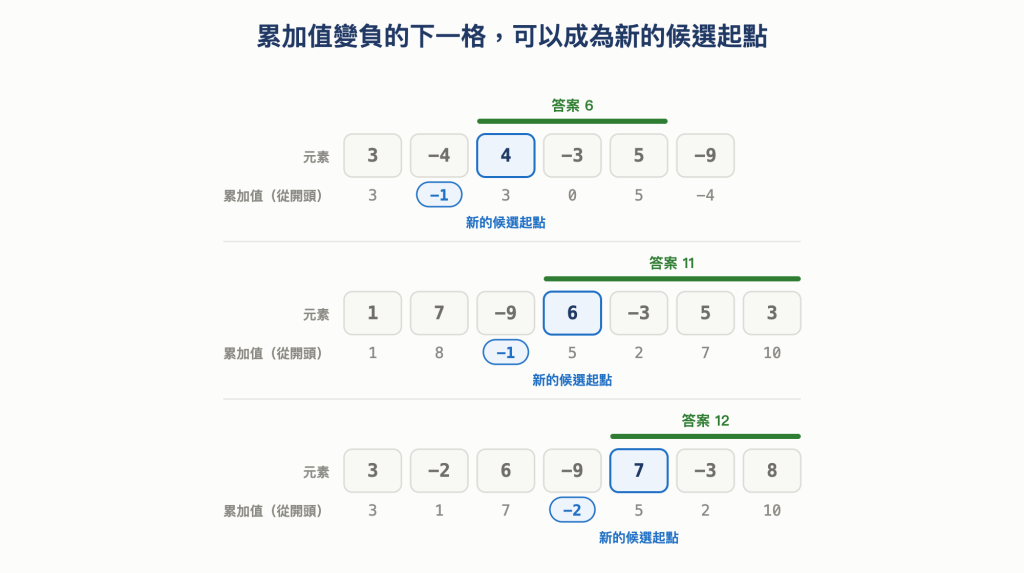
圖 4 累加值變負的下一格,可以成為新的候選起點
第一組就是剛才那張表的累加值。在這三組例子裡,答案剛好都出現在某次累加值變負之後。這還不能證明負累計後的下一格必然是最後答案,但它提供了一條線索:那裡可以當成新的候選起點,再繼續往後找。
所以要判斷的並不是眼前這個元素是不是負的,而是目前這個候選區段的累加值是不是已經變成負的。如果變成負的,就捨棄它,從下一格開始累計新的候選。不過這樣做真的不會錯過答案嗎?接下來仔細來看看~
假設累計到現在是 -3,而下一個數字是 5。帶著前面那段繼續加,會得到 -3 + 5 = 2;直接從 5 重新開始,會得到 5。後者比較大。
這件事可以推論到所有情況。如果目前累計是負的,那不管接下來那一段長什麼樣子,把已經累計成負數的這一段接在它前面,只會讓總和變得比原本更小。這一段就是它的前綴,而既然接上去只會更小,這個前綴不可能出現在最好的答案裡面,可以直接捨棄。
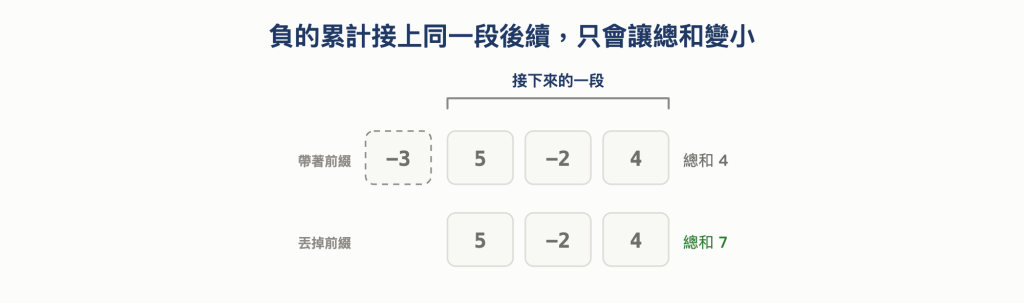
圖 5 負的累計接上同一段後續,只會讓總和變小
負的累計已經證明可以捨棄;反過來,如果目前累計是零或正數,帶著它繼續往後加,不會比從下一格重新開始更差,所以可以繼續保留。
因此,程式每走完一格,currentSum 保留的都是「以這一格為終點」的所有區段中,最大的總和;如果這些總和全都小於 0,就記成 0,表示全部捨棄。真正的答案也一定有個終點;當程式走到那一格時,currentSum 就會算到它,再由 greatestSum 把它留下來。所以這個做法不只能安全丟掉沒用的候選,也不會漏掉最大的那一段。
規則確定之後,就能寫出程式如下:
function maxSubarraySum(numbers) {
  let currentSum = 0;
  let greatestSum = 0;

  for (const number of numbers) {
    currentSum = Math.max(0, currentSum + number); // 用 max 確保不會取到負數
    if (currentSum > greatestSum) greatestSum = currentSum;
  }

  return greatestSum;
}
「要繼續帶著這個前綴,還是把它捨棄」才是這裡的 Greedy 選擇;greatestSum 只負責記錄到目前為止看過的最大值。
用這流程再走一次同一組數字看看:
| 步驟 | 元素 | currentSum |
greatestSum |
|---|---|---|---|
| 1 | 3 | 3 | 3 |
| 2 | -4 | 0 | 3 |
| 3 | 4 | 4 | 4 |
| 4 | -3 | 1 | 4 |
| 5 | 5 | 6 | 6 |
| 6 | -9 | 0 | 6 |
第 4 步累計是 1、還是正的,所以留著,而正因為留著,第 5 步才能接上 5 得到 6。
一次走訪是 O(N),過程中只維護兩個數值變數,額外空間 O(1)。
| 做法 | 時間 | 額外空間 |
|---|---|---|
| 列舉所有連續區段 | O(N²) |
O(1) |
| 一次走訪 | O(N) |
O(1) |
不過這程式有個前提藏在初始化裡。greatestSum 一開始是 0,等於先假設答案至少會是 0,而支持這個假設的正是「至少有一個正數」那個前提。
把前提拿掉就會有問題。輸入 [-5, -2, -8] 這種全是負數的 Array,如果規定輸出的那段不能是空的,答案應該是 -2,也就是單獨取最大的元素,但如果按照上面這支程式執行,會一路歸零,最後回傳 0。
要讓程式支援全負的輸入,初始化和比較都得換掉:currentSum 和 greatestSum 都改成用第一個元素開始,而每一步比的不再是「跟 0 比」,而是「單獨取目前這個值」和「接上前面那段」哪一個大。那就屬於另一個版本,不能沿用這裡的初始化卻聲稱它處理得了全負的輸入。
Dynamic Programming(DP) 是先定義一個子問題,再找出它和更小的子問題之間的關係。最大連續和這問題也能這樣看,關鍵在於如何定義子問題。
我們可令 dp[i] 是「結尾剛好落在 index i 的那些區段裡,總和最大的那一個」。它問的不是整個 Array 的答案,而是限定結尾在 i 的答案。會這樣定義是因為固定了結尾位置以後,dp[i] 才能從 dp[i - 1] 算出來。
結尾在 i 的區段只有兩種可能:
numbers[i] 自己i - 1 的區段再往右接上 numbers[i]
第二種可能若要最大,前面那段自然要取結尾在 i - 1 的最大值,也就是 dp[i - 1]。
所以關係式是:
dp[i] = max(numbers[i], dp[i - 1] + numbers[i]) // 兩種可能性找最大的那個
而每一個區段都一定結尾在某一格,所以最後的答案就是所有 dp[i] 裡最大的那個。拿同一組數字跑一次流程:
| index | 元素 | dp[i] |
dp[i] 是哪一段的總和 |
currentSum(greedy 版) |
|---|---|---|---|---|
| 0 | 3 | 3 | [3] |
3 |
| 1 | -4 | -1 | [3, -4] |
0 |
| 2 | 4 | 4 | [4] |
4 |
| 3 | -3 | 1 | [4, -3] |
1 |
| 4 | 5 | 6 | [4, -3, 5] |
6 |
| 5 | -9 | -3 | [4, -3, 5, -9] |
0 |
index 1 那一列可以看出關係式的兩種可能是怎麼選的:結尾在 index 1 的區段有 [3, -4] 和 [-4] 兩種,總和分別是 -1 和 -4,所以 dp[1] 取的是接上前面那段的 -1。
至於 dp 和前面 currentSum 的差別,只有 index 1 和 index 5 這兩列不一樣,剛好就是累計變負的那兩格:greedy 版把它們歸零,DP 版照實記下負數。但兩邊的答案都是 6,因為變負的那一格本來就不可能是最大值。
照這條關係式寫成程式,就是把每一格的 dp 都存下來:
function maxSubarraySumTable(numbers) {
  // dp 的 index 和 numbers 對齊,dp[i] 是「結尾剛好落在 index i 的區段裡,總和最大的那一個」
  const dp = [numbers[0]]; // 結尾在 index 0 的區段只有它自己
  let greatestSum = dp[0];

  for (let i = 1; i < numbers.length; i += 1) {
    dp[i] = Math.max(numbers[i], dp[i - 1] + numbers[i]); // 只有自己,或接上前面那段
    if (dp[i] > greatestSum) greatestSum = dp[i];
  }

  return greatestSum;
}
greatestSum 要另外存的原因是,答案是所有 dp 裡的最大值,而不是最後一格的 dp。以上面那組數字來說,答案 6 出現在 dp[4],而 dp[5] 是 -3。另外這程式從 numbers[0] 開始,比較的是「單獨取這個值」和「接上前面那段」。
再看一次關係式,dp[i] 只用到 dp[i - 1],比它更早的那些值算完就再也用不到了。這和 Day 28 從 fibTable 改成兩個變數的情況相同,所以這題也不需要真的存一個 dp Array,一個變數一路更新下去就足夠了,再加上一個負責記錄目前最大值的變數就能得出答案。
簡化後那一行會寫成 currentSum = Math.max(number, currentSum + number),也就是前面提過那個支援全負輸入的版本。
把它和 maxSubarraySum 的 Math.max(0, currentSum + number) 擺在一起,會發現兩支程式的差別只剩 Math.max 的第一個參數:
| 第一個參數 | 它的意思 | 需要的前提 |
|---|---|---|
number |
這一段至少要留下目前這個元素 | 沒有 |
0 |
這一段可以整段都不要,總和記成 0 | 至少有一個正數 |
0 那個選項要能成立,得先確定答案至少會是 0,而這正是「至少有一個正數」在保證的事。所以同一組 [-5, -2, -8],number 那版得到 -2,0 那版回傳 0。
兩種角度算的是同一件事,差別只在問法:greedy 問「前面那段該不該丟」,DP 問「結尾在這裡的最好是多少」。
依序遞增三個值這問題會給定一串依時間排好的數字,問裡面有沒有三個數字,依照原本的先後順序嚴格遞增。它只問是否存在,不需找出最大的增幅,三個數字在原本的序列裡也不必相鄰,下面簡稱遞增三元組。
具體來說問題和使用方式如下:
numbers,一個非空的數字 Array,排列順序就是時間順序true 代表存在這樣的三個值,false 代表不存在hasIncreasingTriplet([2, 1, 5, 0, 6]); // true,2 < 5 < 6,這三個值在序列裡並不相鄰
hasIncreasingTriplet([5, 4, 3, 2, 1]); // false,整串遞減
hasIncreasingTriplet([1, 1, 1, 2]); // false,相等不算遞增,湊不出三個
照題目的邏輯,直覺想法可能是三層迴圈,選出第一個、再從它右邊選第二個、再從第二個右邊選第三個,這樣會是 O(N³)。
那理想目標呢?答案取決於每一個數字,至少得把 Array 看過一次,所以理想目標是 O(N)。
Greedy 的想法是只維護兩個候選:目前最適合當第一個的最小值 lowest,以及在它前面已經有更小值的前提下、目前最小的 middle。middle 一開始還沒有合格的值,可以想成無限大。走訪時對每個數字做三種判斷:
lowest 小或相等就更新 lowest
lowest 大但不超過 middle 就更新 middle
middle 還大,代表三個遞增的值已經湊齊了,可回傳這樣做看起來是蠻合理的,因為 lowest 和 middle 越小,後面越容易出現比 middle 更大的第三個值。
[8, 9, 7, 10]:lowest 被蓋掉之後我們用 [8, 9, 7, 10] 這組數字來試跑一次流程看看:
8,lowest 變成 89,它比 lowest 大、比 middle 小,middle 變成 97,它比 lowest 小,所以 lowest 被更新成 710,它比 middle 大,回傳 true
這時會發現有個問題,回傳的那一刻,lowest 是 7、middle 是 9,但 7 是在 9 之後才出現的,7 < 9 < 10 根本不符合順序的要求。這樣回傳 true 是對的嗎?
是對的,只是理由不在這兩個變數當下的值裡面。middle 被設成 9 的那一刻,它成立的條件就已經滿足了,當時的 lowest 是 8,而 8 確實出現在 9 之前。後來 lowest 被 7 覆蓋掉,並不會取消「曾經有一個比 9 小、而且排在 9 前面的數字」這件已經發生的事。所以看到 10 > 9 時,能夠保證存在的那一組是 8、9、10。
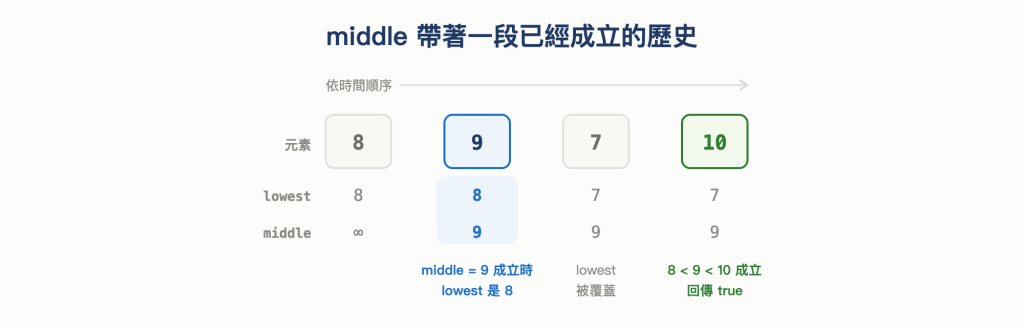
圖 6 middle 帶著一段已經成立的歷史
反過來,這個做法會不會漏掉某個遞增三元組呢?假設依序出現了 a < b < c。掃到 b 時,lowest 一定小於或等於 a,所以 b 會走到第二種判斷;若那時 middle 已經比 b 小,程式在那一刻就回傳 true 了。剩下的情況是 b 被設為 middle,等掃到 c 時,因為 c > b ≥ middle,一定會進入回傳 true 的分支。
根據上述流程,寫成程式如下:
function hasIncreasingTriplet(numbers) {
  let lowest = numbers[0]; // 先預設是第一個元素
  let middle = Infinity; // 還沒找到合格的中間值

  for (const number of numbers) {
    if (number <= lowest) lowest = number;
    else if (number <= middle)
      middle = number; // 它前面一定有過更小的值
    else return true; // 比 middle 還大,三個遞增的值湊齊了
  }

  return false;
}
這程式只需一次走訪,時間複雜度為 O(N),只維護兩個變數,額外空間 O(1)。
前面三個技巧都是用不同的角度思考同一件事:同樣的工作,能不能少做一點?
而第四個技巧則不討論工作步驟有多少,而是再往前思考了一步,想想看那個會造成操作步驟多的源頭,也就是資料結構,這技巧可稱為 Change the Data Structure:
Change the Data Structure 是把同一份資料改用另一種資料結構表示,看看問題會不會因此變簡單。
前面有提到,把 arrayA 存成 Map,這就算是換一種資料表示法,只是那次換的目的是加快查找。而 Change the Data Structure 這個技巧其實不限於查找,它有時候會讓我們發現,現在做的某些工作,需求根本沒有要求。
Group Sorting 的題目是給定一個整數 Array,預期輸出要把相同的值排在一起,但沒有規定群組之間的順序。
具體來說,問題與使用方式如下:
numbers,一個整數 ArraygroupSort([3, 1, 3, 2, 1, 3]); // [3, 3, 3, 1, 1, 2]
// 下面這幾種輸出同樣算對:
// [1, 1, 2, 3, 3, 3]
// [2, 1, 1, 3, 3, 3]
這題目第一時間想到的解法可能是將陣列排序,排好序後相同的值本來就會相鄰,成本是 O(N log N)。
但排序做的其實比題目要求的多。它除了讓同值相鄰,還決定了各個群組之間誰前誰後,而這件事題目根本沒有要求。
那理想目標是多少?輸出裡有 N 個元素,每一個都得被寫出來,所以是 O(N)。
要組出一個合法的輸出,需要知道的只有兩件事:
這兩件事用 Map 就能處理,key 是值、value 是次數。不過換成 Map 之後,原本的先後順序就找不回來了。
寫成程式如下:
function groupSort(numbers) {
  const counts = new Map();

  for (const number of numbers) { // 計數
    counts.set(number, (counts.get(number) ?? 0) + 1); // 數每個值出現幾次
  }

  const result = [];

  for (const [number, count] of counts) { // 重建
    for (let i = 0; i < count; i += 1) result.push(number); // 出現幾次就寫幾次
  }

  return result;
}
用前面那個例子跑看看,counts 會是 3 → 3、1 → 2、2 → 1,重建之後得到 [3, 3, 3, 1, 1, 2]。群組的順序跟著各個值第一次出現的順序,這只是 Map 的性質。
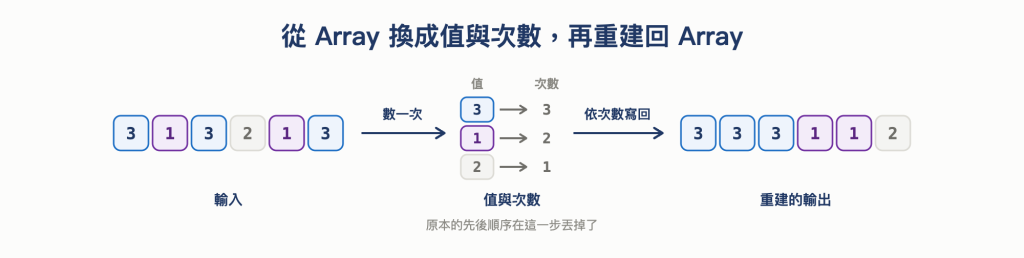
圖 7 從 Array 換成值與次數,再重建回 Array
計數那一輪走過 N 個元素。重建的部分看起來是兩層迴圈,容易誤以為是 O(NK),但外層跑的是 K 種值、內層總共 push 的次數剛好是 N,因為每個元素都只會被寫出去一次,兩層加起來還是 N 次。
所以時間是 O(N)。空間分成兩部分:Map 裡有幾種不同的值就佔幾格,把種類數記成 K,這部分是 O(K);另外開一個新 Array 來裝結果,是 O(N)。如果允許直接覆寫輸入,新輸出那份可以省掉,但計數表還是無法避免。
| 做法 | 時間 | 額外空間 |
|---|---|---|
| 一般比較排序 | O(N log N) |
依實作而定,見 Day 18 |
| 計數再重建 | O(N) |
O(K) 計數表 + O(N) 新輸出 |
如果群組之間也要由小到大排好,那就得額外把那 K 個 key 排一次。另一種情況是元素不再是單純的數字,而是 key 相同、其他欄位卻不同的物件。這時只存次數會遺失那些欄位,得改成把資料本身留下來。
今天這幾個範例做的事情其實很類似,都是拿掉某一段工作,且每次都能說出為何工作拿掉後,答案還是對的。
| 案例 | 省掉了什麼工作 | 憑什麼可以省 |
|---|---|---|
| Coin Game | 不必模擬每一種拿法 | 餘數 1 的局面只能送往必勝局面;其他餘數都能送回餘數 1 |
| Sum Swap(推導) | 不必試每一組配對 | 兩邊總和相加固定,相等時只能各在中點,配對的值因此是唯一的 |
| Sum Swap(查表) | 不必在 arrayA 裡逐一搜尋 |
Map 把「有沒有這個值」變成平均 O(1),換來的是 O(N) 的空間 |
| 最大連續和 | 不必列舉每一個區段 | 累計為負的前綴,接上任何一段後續都只會讓總和更小 |
| 遞增三元組 | 不必試每一組三元組 | middle 一旦被設定,就代表它前面確實出現過更小的值 |
| Group Sorting | 不必決定群組之間的順序 | 需求沒有要求這件事 |
把「優化之前」那一節和這四個小技巧接起來,就是一組提問的順序:現在多慢、該追求多快、有沒有規律可以取代模擬、慢的查詢能不能變成查表、哪些候選已經不可能更好、以及需求到底要的是什麼。
Missing Number 會給定一個由 0 到 N 的不重複整數組成的 Array,其中恰好缺了一個數字,要找出缺的是哪一個。
具體來說,問題設定和預期使用方式如下。
numbers,長度為 N 的 Array,內容是 0 到 N 之間的不重複整數,恰好缺了一個findMissingNumber([2, 3, 0, 6, 1, 5]); // 4,長度是 6,所以完整範圍是 0~6
findMissingNumber([1]); // 0
直覺做法是拿 0 到 N 的每個值去掃過整個 Array,看它在不在,時間複雜度為 O(N²)。或也可以先把所有數字丟進 Set,再從 0 往上逐一確認是否存在,那是 O(N) 時間、O(N) 空間。
那理想目標呢?缺的是哪一個取決於全部的數字,至少得把 Array 看過一次,所以理想目標是 O(N)。
這裡的規律其實在總和上。完整的 0 到 N 總和是固定的,缺了哪個數字,實際的總和就剛好少了那個值。以 [2, 3, 0, 6, 1, 5] 來說,長度是 6,完整範圍是 0 到 6,完整總和是 21,而實際總和是 17,21 - 17 = 4,4 就是遺失的那個數字。
function findMissingNumber(numbers) {
  const n = numbers.length; // 缺了一個,所以完整範圍是 0 到 n

  let fullSum = 0;
  for (let value = 1; value <= n; value += 1) fullSum += value; // 沒缺值時的總和

  let currentSum = 0;
  for (const value of numbers) currentSum += value;

  return fullSum - currentSum; // 少掉多少,缺的就是多少
}
兩輪各走 N 步,所以是 O(N),而且只用了兩個數值變數,額外空間 O(1)。和前面那個 Set 版本比起來,這題連 Set 都不必建。
兩數最大乘積會從一個 Array 裡任選兩個數字相乘,找出最大的乘積。
numbers,一個整數 Array,可能含有負數greatestProduct([5, -10, -6, 9, 4]); // 60,來自 (-10) × (-6)
greatestProduct([1, 2, 3, 4]); // 12,來自 3 × 4
直覺做法是列舉所有配對,時間複雜度為 O(N²)。
在列舉時,可能會想說「留住最大的兩個就好」,但第一個例子就推翻了這想法。[5, -10, -6, 9, 4] 裡最大的兩個是 9 和 5,乘積 45;而 (-10) × (-6) 是 60,60 才是答案。
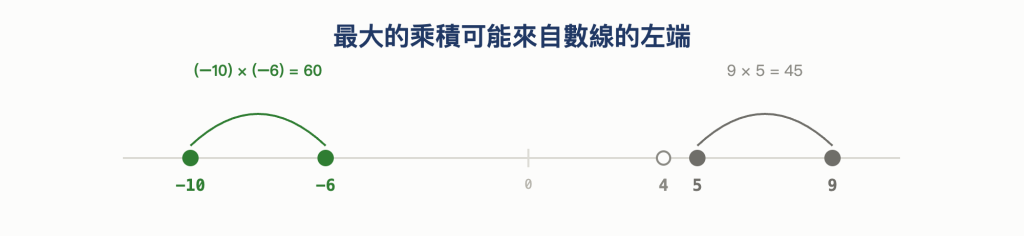
圖 8 最大的乘積可能來自數線的左端
原因是兩個負數相乘會變成正的,而且絕對值越大、乘積越大。不過這反例只證明了「最大的兩個數不一定夠」,還得說明為什麼只要再看最小的兩個。
想像先把數字從小排到大。要在兩個非負數中取得最大乘積,應該選最右邊、也就是最大的兩個;要在兩個負數中取得最大乘積,應該選最左邊、絕對值最大的兩個。一正一負的乘積是負數,只要還有非負的配對就不會更好;如果 Array 只有一正一負兩個數,這唯一的配對也同時被兩端包含。
所以最大的乘積只可能來自兩種組合:最大的兩個數,或最小的兩個數。這表示一次走訪裡要同時維護 4 個候選。重複出現的極值也可能組成答案,例如 [-10, -10, 5] 的答案是 (-10) × (-10) = 100,所以兩個 -10 都要留著。
function greatestProduct(numbers) {
  let greatest = -Infinity;
  let secondGreatest = -Infinity;
  let lowest = Infinity;
  let secondLowest = Infinity;

  for (const number of numbers) {
    if (number >= greatest) {
      // 相等時也往前擠,讓重複的極值佔住第二順位
      secondGreatest = greatest;
      greatest = number;
    } else if (number > secondGreatest) {
      secondGreatest = number;
    }

    if (number <= lowest) {
      secondLowest = lowest;
      lowest = number;
    } else if (number < secondLowest) {
      secondLowest = number;
    }
  }

  return Math.max(greatest * secondGreatest, lowest * secondLowest); // 最大的兩個,或最小的兩個
}
一次走訪時間複雜度為 O(N),四個變數空間複雜度為 O(1)。
單次買賣最大利潤會給一串依時間排列的價格,只能買一次、賣一次,而且必須先買才能賣,求最大的收益。
prices,依時間排列的價格 Array0
findGreatestProfit([10, 7, 5, 8, 11, 2, 6]); // 6,在 5 買進、11 賣出
findGreatestProfit([9, 7, 5, 3]); // 0,一路下跌,選擇不交易
直覺做法是列舉所有買賣組合,時間複雜度為 O(N²)。而每一天的價格都可能是買點或賣點,至少得把價格看過一次,所以理想目標是 O(N)。
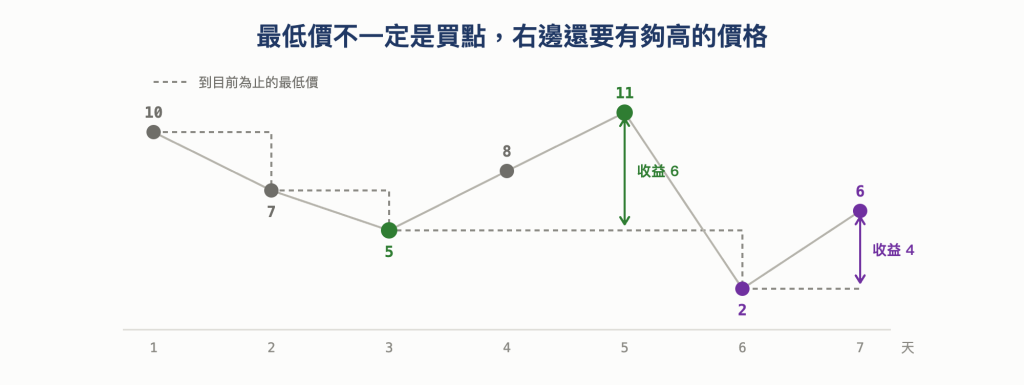
圖 9 最低價不一定是買點,右邊還要有夠高的價格
這題和前面幾題不太一樣,因為候選還帶著時間順序的限制。走到今天時,能當買點的只有今天以前看過的價格,未來的低價不能拿回來用。因此程式先把第一天當成買點候選,從第二天開始掃描。每天先用當天價格減掉先前的最低價,算出「今天賣出」能拿到多少;然後才把今天的價格納入之後的買點候選。這樣每一筆算出來的收益,都對應一組先買後賣的合法交易。
function findGreatestProfit(prices) {
  let buyPrice = prices[0];
  let greatestProfit = 0;

  for (let index = 1; index < prices.length; index += 1) {
    const price = prices[index];
    const potentialProfit = price - buyPrice; // 今天賣出能拿到多少

    if (potentialProfit > greatestProfit) greatestProfit = potentialProfit;
    if (price < buyPrice) buyPrice = price; // 算完收益,今天才納入之後的買點候選
  }

  return greatestProfit;
}
一次走訪時間複雜度為 O(N),兩個變數空間複雜度 O(1)。
最長連續整數序列會給一個沒有排序的整數 Array,要找出最長的連續整數序列有多長。連續指的是值連續,每一個都比前一個大 1,但它們在原本的 Array 裡不必相鄰。
numbers,一個沒有排序的整數 Array,可能含有重複的值longestSequenceLength([10, 5, 12, 3, 55, 30, 4, 11, 2]); // 4,來自 2-3-4-5
longestSequenceLength([100, 1, 50]); // 1,彼此都不連續
longestSequenceLength([]); // 0
直覺做法是先排序再走一次,時間複雜度 O(N log N)。而每個數字都可能落在最長的那一段裡,至少得把 Array 看過一次,所以理想目標是 O(N)。
優化的第一個念頭是把所有數字放進 Set,這樣「某個值在不在」就變成平均 O(1),接著對每個數字一直往後找 +1,記錄最長的那一段。
但這樣還不夠。以 [6, 5, 4, 3, 2, 1] 為例,從 5 會展開出 5-6,從 4 會展開出 4-5-6,從 3 會展開出 3-4-5-6,同一段序列被反覆走了好幾次,最壞情況會接近 O(N²)。查找本身是 O(1),不代表整支程式自然就是 O(N)。
修正的方式是只從序列的起點開始往後展開。判斷起點的方法為:如果 x - 1 也在 Set 裡,那 x 就不是起點,直接跳過。
這樣每個不同的整數只會在唯一一條序列裡被展開一次。把種類數記成 K,那所有展開加起來總共就是處理 K 個數字,而 K 不會超過 N。再加上建 Set 的 N 步和走訪的步數,整體時間複雜度 O(N)。
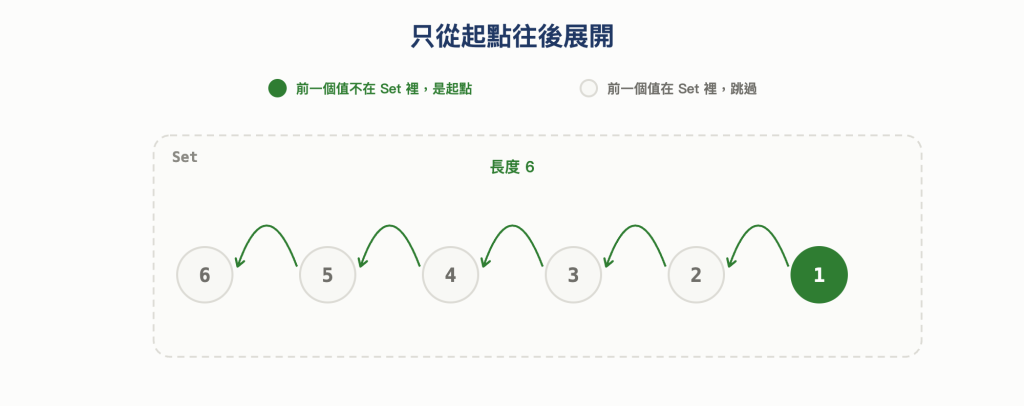
圖 10 只從起點往後展開
function longestSequenceLength(numbers) {
  const values = new Set(numbers);
  let greatestLength = 0;

  for (const number of values) {
    // 走去重後的 Set,不是原本的 Array
    if (values.has(number - 1)) continue; // 前一個值也在,代表這裡不是序列的起點

    let currentLength = 1;
    let current = number;

    while (values.has(current + 1)) {
      current += 1;
      currentLength += 1;
    }

    if (currentLength > greatestLength) greatestLength = currentLength; // 每段走完才更新
  }

  return greatestLength;
}
這支程式有兩個地方要留意。走訪的是去重之後的 values,不是原本的 Array,否則重複出現的起點會被反覆展開,最壞情況又回到 O(N²)。最長長度則是在每一段走完之後才更新,如果只寫在 while 裡面,長度為 1 的序列永遠進不了 while,答案就會錯。
小小總結一下今天這些小技巧~
Map 的成本算進去。 Sum Swap 換成 Map 之前,得先知道要找的是 b + shift 這個唯一的值;而換來的 O(N + M) 是拿 O(N) 的空間換的。[3, -4, 4, -3, 5, -9] 上只得到 5,而答案是中途才起頭的區段 [4, -3, 5],總和 6。是這個反例讓我們看見它只找得到從開頭算起的區段,也是理由讓「累計為負就丟掉」變得可靠。實際使用時,還可以記住幾件事~
O(1),不代表整支程式自然就是 O(N),最長連續整數序列就是靠「只從起點展開」才真的線性圖表說明:本文圖表由作者整理,並使用 Claude Code 協助繪製;內容與數據由作者確認。


 iThome鐵人賽
 看影片追技術