
Day 24,我整理了一份:
AI Requirement Checklist。
那張 Checklist 比較像是在一個 AI Idea 剛進來時,
快速掃:
Problem

AI Value

Context

Data

Boundary

Permission

Failure

Outcome
但最近我開始想到另一個場景。
假設今天 Requirement 已經過了。
Prototype 也做了。
Engineer 已經開始討論怎麼串。
甚至 Demo 都可以跑了。
接下來要回答的是另一個問題:
這個 Solution,真的 Ready 嗎?
所以如果明天要 Review 一個已經成形的 AI Product,
我會想用另一張表。
不是 Requirement Scan。
而是:
我會看五格。
第一格我還是會回到 User。
但這次不是問:
User 想完成什麼?
而是問:
現在這個 Solution,真的讓他完成得更好了嗎?
我會寫:
Target Task:

Current Baseline:

Expected Outcome:

Primary Success Metric:

Guardrail Metric:
例如:
Target Task
快速取得正確政策資訊

Current Baseline
平均需要人工轉手 2 次

Expected Outcome
大部分 Query 可以 Self-service

Primary Metric
Successful Task Completion

Guardrail
Wrong Answer / Unauthorized Answer
這一格如果寫不清楚,
我不太想往下 Review。
因為後面:
Model

Prompt

RAG

Agent
再漂亮,
也不知道在 Optimize 什麼。
第二格我會把整條 Journey 裡 AI 的角色畫出來。
不是只有:
AI 有沒有用?
而是:
Interpret

Recommend

Infer

Prepare

Execute

Confirm

Approve
哪些可以自己做?
哪些只能建議?
哪些需要 User?
哪些根本不應該由 Model 決定?
我會寫成:
AI MAY
理解 Intent
整理資訊
產生 Draft

AI MAY WITH CONDITIONS
低風險推斷
準備 Action

USER / RULE MUST DECIDE
付款
正式送出
敏感資料範圍
高風險不可逆操作
這一格真正 Review 的是:
System Boundary 清不清楚?
第三格不是列:
有 Error Message 嗎?
而是直接問:
這個 Product 最可能留下什麼爛攤子?
我會列 Top Failure Modes:
Wrong Intent

Wrong Data

Wrong Permission

Wrong Action

Partial Success

Timeout

User Changes Mind
然後每個 Failure 問四件事:
Detect
知道錯了嗎?

Recover
救得回來嗎?

Escalate
誰來接?

Visible
User 知道現在在哪裡嗎?
例如:
Failure
API 已成功建立申請,
但 Response Timeout

Risk
User 重試造成 Duplicate

Design
Idempotency / Status Check

User Experience
不要只顯示「失敗請重試」
這一格是我覺得很多 Demo 最容易跳過的地方。
第四格才進到:
Eval

Test

User Feedback

Production Data
我會寫:
Offline Eval
測什麼?

Golden Dataset
哪裡來?

Edge Cases
涵蓋什麼?

User Test
觀察什麼?

End-to-End Test
Task 真的跑完嗎?

Launch Threshold
多少才算 Ready?
我覺得 AI Product 有一個很重要的差別:
「看起來答得不錯」不能再當 Acceptance Criteria。
所以這一格一定要回答:
什麼叫 Pass?

什麼 Failure 不能接受?

什麼結果需要 Human Review?
最後才看:
Latency

Token

Infra

Human Intervention

Maintenance

Operation Cost
我會特別看:
Cost per Successful Task
而不是只看:
Cost per Query
假設:
一次 Query 很便宜
但 User 平均要問五次,
最後還要人工接手,
整個 Product 不一定便宜。
所以我會寫:
Avg Cost / Successful Task

Avg Human Touch / Task

Avg Turns / Success

P95 Latency

Escalation Rate
再問:
Usage 放大十倍之後,這個 Product 還合理嗎?
AI PRODUCT DESIGN REVIEW

1. OUTCOME
User 哪個 Task 真的變好了?
Primary / Guardrail Metric 是什麼?

2. DECISION
AI 可以 Interpret / Recommend /
Act 到哪裡?
Boundary 在哪?

3. FAILURE
最可能怎麼錯?
怎麼 Detect / Recover / Escalate?

4. EVIDENCE
憑什麼相信它 Ready?
Eval / Test / User Evidence 是什麼?

5. ECONOMICS
成功完成一個 Task,
到底花多少時間 / Token / Human Effort?
寫到這裡,我覺得可以把 Day 24 和今天分得很清楚。
Day 24 是:
Should we build this?
今天比較像:
Are we building this right?
前面是在避免:
Problem 都沒想清楚
↓
就進 Solution
後面是在避免:
Solution 已經能 Demo
↓
就以為可以 Production
兩個都是我現在覺得 AI Product 很容易踩的坑。
因為 AI 把中間那一段做得太快了。
如果有一個 AI Feature,
回答非常漂亮,
我現在可能還是會繼續問:
User 完成 Task 了嗎?

AI 做了哪些 Decision?

做錯之後怎麼辦?

我們怎麼知道它夠好?

成功一次要花多少資源?
因為最後上線的不是 Model。
是 Product。
AI Product Review 不能只 Review Output Quality,而要 Review 整個 System 是否能在清楚的 Boundary、可接受的 Risk 與合理的 Cost 下,穩定完成 User 的 Task。
所以如果明天有一個 AI Demo 放在我面前,
我現在大概不會先問:
用哪個 Model?
我會先拿出這一頁,
從 Outcome 開始看。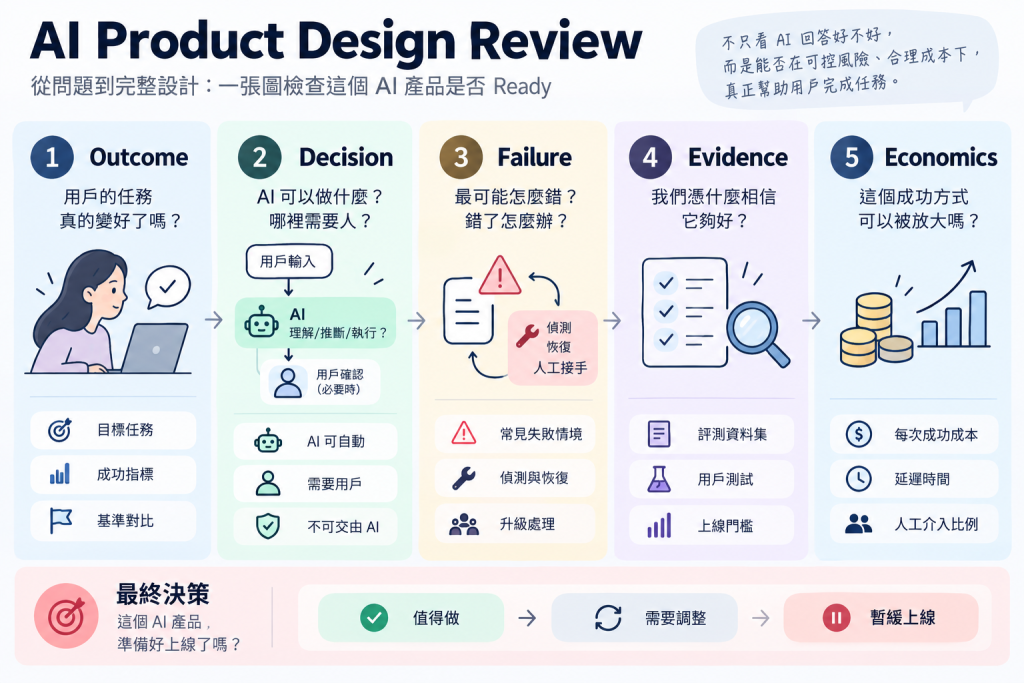


 iThome鐵人賽
 看影片追技術