
前面我們部署 FastAPI、Redis、PostgreSQL 時,通常希望它們一直保持運作。以 FastAPI 為例,只要服務還在線上,它的 Process 理論上就不應該自己結束。
這正是 Deployment 適合處理的工作。
Deployment 的核心想法是:
我希望指定數量的 Pod 持續處於可工作的狀態。
因此如果你建立:
replicas: 3
Kubernetes 就會盡量維持三個 Pod。
而且 Deployment 建立的 Pod,其 restartPolicy 是 Always。如果 FastAPI Container 一直執行完就退出,即使 Exit Code 是 0,Kubernetes 仍然會再次啟動它。假如不停「啟動 → 結束 → 啟動 → 結束」,最後甚至可能看到 CrashLoopBackOff。
但問題是,有些程式本來就應該執行完後結束。
例如:
Database Migration
資料批次處理
產生每日/月報
資料庫 Backup
寄送通知
一次性的初始化工作
假設 Migration 成功跑完:
python migrate.py
然後 Process 正常 Exit Code 0,這不是故障,而是:
工作完成了。
這就是為什麼 Kubernetes 除了 Deployment 之外,還需要 Job、CronJob、DaemonSet。
這一章最重要的觀念不是背:
Job
CronJob
DaemonSet
而是學會問:
這個 Controller 想維持的 Desired State 到底是什麼?
這一章不需要額外安裝任何 Kubernetes Plugin。
只要先確認:
kubectl get nodes
能正常看到:
NAME           STATUS   ROLES
controlplane   Ready    control-plane
node01         Ready    <none>
就可以繼續。
我們下面都使用:
cka-lab
這個 Namespace。
先確認它存在:
kubectl get namespace cka-lab
如果出現:
NotFound
就建立它:
kubectl create namespace cka-lab
後面所有 Job、CronJob、DaemonSet 都放在這裡。
Job 最適合拿來執行:
做完就可以結束
的工作。
例如現在建立一個非常簡單的 Job:
kubectl create job \
  hello-job \
  -n cka-lab \
  --image=busybox:1.36 \
  -- \
  sh -c 'date; echo "Ironman Job completed"'
這裡可以拆開理解。
kubectl create job hello-job
表示建立一個叫做:
hello-job
的 Job。
接著:
--image=busybox:1.36
代表 Pod 裡面的 Container 使用 BusyBox。
最後的:
-- sh -c '...'
就是 Container 真正要執行的 Command:
date
echo "Ironman Job completed"
也就是印出目前時間與一行文字,然後程式結束。
建立後查看 Job:
kubectl get jobs -n cka-lab
看到:
NAME        STATUS     COMPLETIONS   DURATION
hello-job   Complete   1/1           3s
這裡的:
1/1
非常重要。
意思是:
需要成功完成:1 次
目前成功完成:1 次
所以這個 Job 已經完成自己的任務。
Job 自己不會直接執行 Container。
它實際上的關係是:
Job
 │
 ▼
Pod
 │
 ▼
Container
所以再查看:
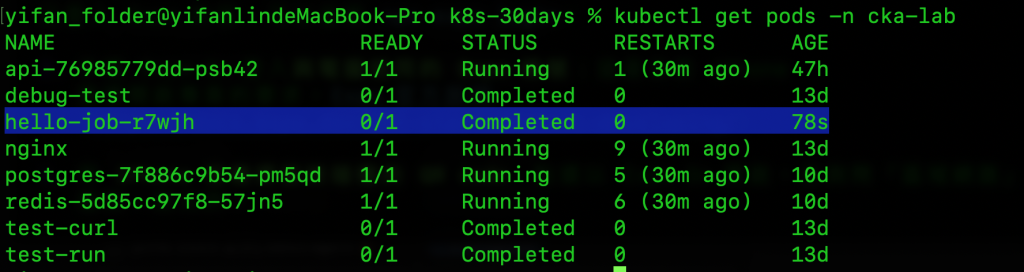
kubectl get pods -n cka-lab
你會發現一個類似:
hello-job-xxxxx
的 Pod,而且它的狀態可能是:
Completed
以前學 Deployment 的時候,看到 Pod 沒有 Running,可能直覺會覺得:
Pod 掛掉了嗎?
但對 Job 完全不是這樣。
Job 的 Desired State 本來就是:
工作成功完成指定次數。
因此:
Completed
反而就是我們想看到的結果。Kubernetes 官方對 Job 的定義也是如此:一般 Job 在 Pod 成功結束後,就會被視為完成。Job 的 Pod 只能使用 restartPolicy: Never 或 OnFailure。
要看程式到底輸出了什麼,當然可以先查 Pod:
kubectl get pods -n cka-lab
再:
kubectl logs hello-job-xxxxx -n cka-lab
但其實有更方便的方法:
kubectl logs job/hello-job -n cka-lab
這裡直接指定:
job/hello-job
kubectl 會幫你找到這個 Job 對應的 Pod。
就可以看到: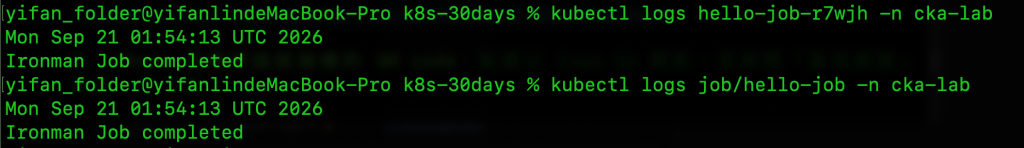
這種 Resource-oriented 的 kubectl 用法很值得熟悉。
例如之後你也會常看到:
kubectl describe job hello-job -n cka-lab
如果 Job 沒成功,第一步通常就是:
kubectl get pods -n cka-lab
kubectl logs job/hello-job -n cka-lab
kubectl describe job hello-job -n cka-lab
再搭配:
kubectl get events -n cka-lab --sort-by=.metadata.creationTimestamp
排查到底是 Image、Command、Scheduling 還是程式本身出了問題。
假設 Container 執行:
exit 1
代表程式失敗。
Job 並不會看到第一次失敗就直接放棄,而是可以重新嘗試。這和:
工作執行完、Exit 0
完全不同。
Exit Code 0:
成功
非 0:
失敗
Job 會根據像 backoffLimit 這類設定控制失敗後可以重新嘗試多少次。
所以 Job 的核心不是:
Pod 必須一直 Running。
而是:
最後這個工作到底有沒有成功完成。
Job 解決的是:
執行一次工作。
但假設今天需求變成:
每天凌晨兩點 Backup Database
或者:
每五分鐘產生一次報表
總不能每天人工:
kubectl create job ...
這時就需要 CronJob。
CronJob 可以理解成:
Job + Scheduler
它自己主要負責:
到了指定時間,建立一個 Job。
而真正執行程式的仍然是 Job 產生的 Pod。官方文件也是以 CronJob 定期建立 Job 的方式運作。
建立一個檔案:
vim report-cronjob.yaml
內容如下:
apiVersion: batch/v1
kind: CronJob

metadata:
  name: report-job
  namespace: cka-lab

spec:
  schedule: "*/5 * * * *"

  jobTemplate:
    spec:
      template:
        spec:
          restartPolicy: Never

          containers:
            - name: report
              image: busybox:1.36
              command:
                - sh
                - -c
                - 'date; echo "Generating report"'
存檔後執行:
kubectl apply -f report-cronjob.yaml
確認:
kubectl get cronjob -n cka-lab
也可以縮寫:
kubectl get cj -n cka-lab

*/5 * * * * 到底是什麼?CronJob 的:
schedule: "*/5 * * * *"
使用的是 Cron 格式。
五個欄位依序代表:
分鐘 小時 日期 月份 星期
所以:
*/5 * * * *
意思就是:
每五分鐘執行一次
注意 Kubernetes 這裡不是每五「秒」,CronJob 一般使用分鐘作為最小排程單位。
例如:
0 * * * *
代表:
每個小時的第 0 分鐘
而:
0 2 * * *
代表:
每天 02:00
這裡很容易搞混。
CronJob 並不是直接管理 Pod。
完整關係其實是:
CronJob
   │
   │ 到時間
   ▼
 Job
   │
   │ 建立
   ▼
 Pod
   │
   │ 執行程式
   ▼
Completed
所以 Troubleshooting CronJob 時,一定要先知道:
我現在是在排查哪一層?
假設你發現:
怎麼完全沒有 Pod?
不要第一時間只盯著 Pod。
先看:
kubectl get cronjob -n cka-lab
再看:
kubectl get jobs -n cka-lab
最後才看:
kubectl get pods -n cka-lab
如果:
CronJob 存在
↓
但 Job 完全沒有建立
問題比較可能在 Cron Schedule 或 CronJob Controller 這一層。
如果:
Job 已建立
↓
Pod 失敗
問題就比較可能在 Job Template、Image 或 Container Command。
理解 Controller 關係,比死背指令重要很多。
這是非常實用的技巧。
假設:
schedule: "*/5 * * * *"
你剛 Apply 完,不想坐著等五分鐘測試。
可以直接從這個 CronJob 建立一次 Job:
kubectl create job \
  --from=cronjob/report-job \
  report-manual \
  -n cka-lab
這裡的意思是:
不要等 CronJob 排程。

直接拿 report-job 裡面的 jobTemplate,
現在立刻建立一個叫 report-manual 的 Job。
這個功能是 kubectl 原生支援的。
接著:
kubectl get jobs -n cka-lab
應該會看到:
report-manual
查看結果:
kubectl logs job/report-manual -n cka-lab
如果看到:
Generating report
表示 Job Template 本身可以正常工作。
這在 Troubleshooting 非常有用,因為可以把問題拆開:
Job Template 有沒有問題?
以及:
Cron Schedule 有沒有問題?
不用兩個混在一起查。
DaemonSet 和 Job、CronJob 的概念又完全不同。
Deployment 通常問:
我要幾份 Pod?
例如:
replicas: 3
就是:
我要三個 Pod。
至於這三個 Pod 到底放在哪些 Node,再交給 Scheduler 處理。
DaemonSet 則不是這種思維。
它問的是:
哪些 Node 上應該各存在一份這個 Pod?
假設 Cluster 有:
worker1
worker2
worker3
你希望每台機器都有 Log Agent:
worker1
└── log-agent

worker2
└── log-agent

worker3
└── log-agent
這就是非常典型的 DaemonSet。
Kubernetes 官方也將 DaemonSet 定義為確保指定 Node 上執行一份 Pod 的 Controller。
常見情境包括:
Log Agent
Monitoring Agent
CNI Network Plugin
Storage Agent
Security Agent
因為這些程式通常不是:
整個 Cluster 隨便跑三份就好。
而是:
每台機器都需要一份。
建立:
vim node-agent.yaml
輸入:
apiVersion: apps/v1
kind: DaemonSet

metadata:
  name: node-agent
  namespace: cka-lab

spec:
  selector:
    matchLabels:
      app: node-agent

  template:
    metadata:
      labels:
        app: node-agent

    spec:
      containers:
        - name: agent
          image: busybox:1.36
          command:
            - sh
            - -c
            - 'while true; do echo "agent alive"; sleep 30; done'
然後:
kubectl apply -f node-agent.yaml
這個 Container 跟剛剛 Job 最大的差別之一,在於 Command:
while true
也就是無限迴圈:
印 agent alive
↓
睡 30 秒
↓
再印一次
↓
再睡 30 秒
↓
一直繼續
所以它本身就是一個應該長期執行的 Agent。
查看:
kubectl get daemonset -n cka-lab
可以縮寫:
kubectl get ds -n cka-lab
看到:
接著最重要的是:
kubectl get pods \
  -n cka-lab \
  -l app=node-agent \
  -o wide
-o wide 很重要,因為它會額外顯示:
NODE
例如:
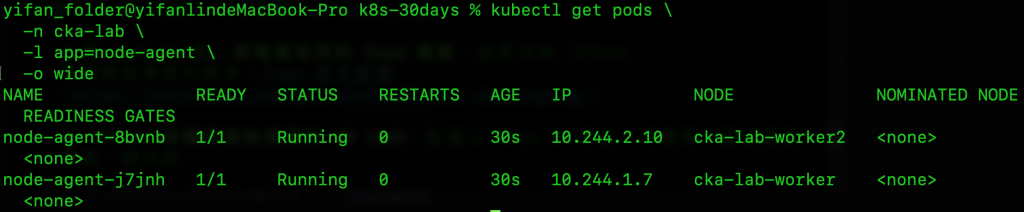
這時你就可以直接確認:
DaemonSet 到底在哪些 Node 上建立了 Pod?
假設你的 Cluster 是:
cka-lab-control-plane
cka-lab-worker
cka-lab-worker2
你可能原本以為:
目前有三個 Node
=
DaemonSet 應該有三個 Pod
結果卻只有:
cka-lab-worker
cka-lab-worker2
兩個 Pod。
這很可能是因為 Control Plane Node 有 Taint。
查看:
kubectl describe node cka-lab-control-plane
找到:
Taints:
在 kubeadm 建立的 Cluster 中,Control Plane 通常存在:
node-role.kubernetes.io/control-plane:NoSchedule
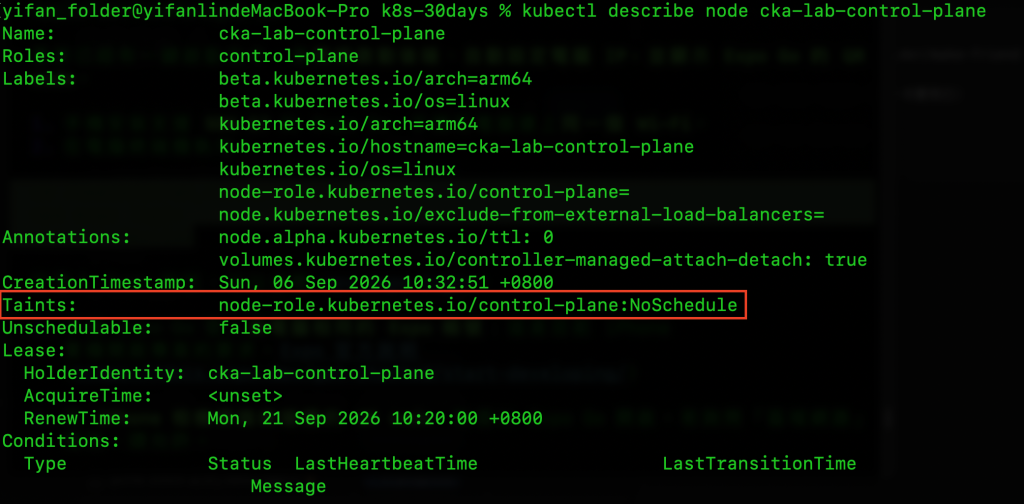
這是 kubeadm 用來避免一般 Workload 被排到 Control Plane 上的 Taint。
因此普通 DaemonSet 不一定能進去。
這正好把之前學過的:
Taint
+
Toleration
重新串起來。
假設你的需求真的就是:
每台機器都要收集 Log,
連 Control Plane 也不能漏掉。
這種情況不要急著把 Node Taint 刪掉。
比較合理的方法是在 DaemonSet Pod Template 裡加入對應的 Toleration:
vim node-agent.yaml
spec:
  containers:
    - name: agent
      image: busybox:1.36
      command:
        - sh
        - -c
        - 'while true; do echo "agent alive"; sleep 30; done'

  tolerations:
    - key: node-role.kubernetes.io/control-plane
      operator: Exists
      effect: NoSchedule
然後重新:
kubectl apply -f node-agent.yaml
再觀察:
kubectl get pods \
  -n cka-lab \
  -l app=node-agent \
  -o wide
如果環境符合條件,就可能變成:
NAME               NODE
node-agent-xxxxx   cka-lab-control-plane
node-agent-yyyyy   cka-lab-worker
node-agent-zzzzz   cka-lab-worker2
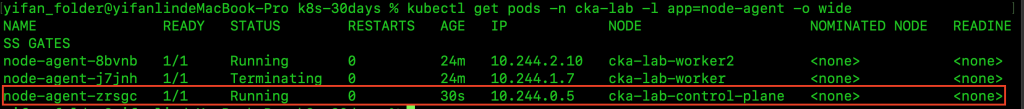
也就是:
controlplane
└── node-agent

node01
└── node-agent
這才真正呈現 DaemonSet 的概念。
要注意,DaemonSet 本身會自動帶有部分與 Node 狀態有關的 Toleration,例如 not-ready、unreachable 等,但 control-plane:NoSchedule 並不是因此就可以一律忽略;若 Control Plane 有這個 Taint,而你又需要 Agent 跑上去,就應該明確處理它。
學 Kubernetes Controller,建議不要用:
Deployment 是什麼?
Job 是什麼?
CronJob 是什麼?
DaemonSet 是什麼?
這種死背方式。
直接從 Desired State 思考會清楚很多:
| Controller | Kubernetes 想維持的狀態 |
|---|---|
| Deployment | 我希望有指定數量的 Pod 持續運作 |
| Job | 我希望這個工作成功完成 |
| CronJob | 我希望在指定時間建立 Job |
| DaemonSet | 我希望符合條件的 Node 各自有一份 Pod |
例如看到一個程式:
FastAPI Web Server
它應該一直提供服務:
Deployment
看到:
python migrate.py
Migration 成功做完就結束:
Job
看到:
每天凌晨 02:00 備份資料庫
就是:
CronJob
看到:
每台 Node 都需要安裝 Log Collector
就是:
DaemonSet
這樣你不是在背 Kubernetes 名詞,而是在判斷:
這個程式正常的生命週期到底長什麼樣子?
最後實際確認三種 Resource:
kubectl get jobs -n cka-lab
kubectl get cronjobs -n cka-lab
kubectl get ds -n cka-lab
看所有相關 Pod:
kubectl get pods -n cka-lab -o wide
Job 看 Log:
kubectl logs job/hello-job -n cka-lab
手動測 CronJob:
kubectl create job \
  --from=cronjob/report-job \
  report-manual \
  -n cka-lab
確認 DaemonSet 分布在哪些 Node:
kubectl get pods \
  -n cka-lab \
  -l app=node-agent \
  -o wide
如果做完實驗想全部清掉:
kubectl delete job hello-job report-manual -n cka-lab
kubectl delete cronjob report-job -n cka-lab
kubectl delete daemonset node-agent -n cka-lab
理解完這章之後,其實下一個問題就會自然出現:
前面 FastAPI 使用 Deployment 很合理,因為 Web Server 本來就是:
掛了重建
Pod 換一台通常也沒關係
但 PostgreSQL 不太一樣。
如果:
postgres-abc
死掉後 Kubernetes 隨便建立:
postgres-xyz
那資料在哪裡?Pod 名稱改變有沒有影響?如果未來有三台 PostgreSQL,每一台的身分與 Storage 又要怎麼維持?
這就是下一個 Controller:
StatefulSet
要解決的核心問題。


 iThome鐵人賽
 看影片追技術