
這可能是到目前為止,整個 Kubernetes 系列最重要的一篇之一。
前面我們已經做過很多次:
FastAPI → Redis
FastAPI → PostgreSQL
Pod → Service → Pod
看起來就像 Pod 天生可以互相連線。
但其實 Kubernetes Control Plane 本身並不負責把完整的 Pod Network 實作出來。Kubernetes 定義了「網路應該長什麼樣子」,真正負責讓 Pod 取得 IP、建立網路介面,以及讓不同 Node 上的 Pod 可以互相傳送封包的,通常是額外安裝的 Network Plugin(網路外掛)。Kubernetes 官方也明確說明,一個可正常工作的 Cluster 需要 Network Plugin 來實作 Pod Network。
而 Kubernetes 與這些網路外掛之間使用的一套標準,就是今天的主角:
CNI
Container Network Interface
先不要把 CNI 想成一套軟體。
CNI 是一套介面規範(Interface / Specification)。
你可以把它想成 Kubernetes 和網路系統之間約定好的「插座規格」。
例如 Kubernetes 建立一個新的 Pod 時,需要有人處理:
建立 Pod
↓
建立 Network Namespace
↓
建立網路介面
↓
分配 Pod IP
↓
設定 Route
↓
讓 Pod 可以和其他 Pod 通訊
真正做這些事情的可能是:
Calico
Cilium
Flannel
kindnetd
...
這些才是實際的 Network Plugin。
所以:
CNI = 規格 / Interface
Calico = 實作 CNI 的其中一套網路方案
這個差別一定要先記住。
Kubernetes 很重要的一個設計理念,就是它不想把所有功能全部寫死在 Kubernetes 裡面,而是透過 Interface 讓其他系統接進來。
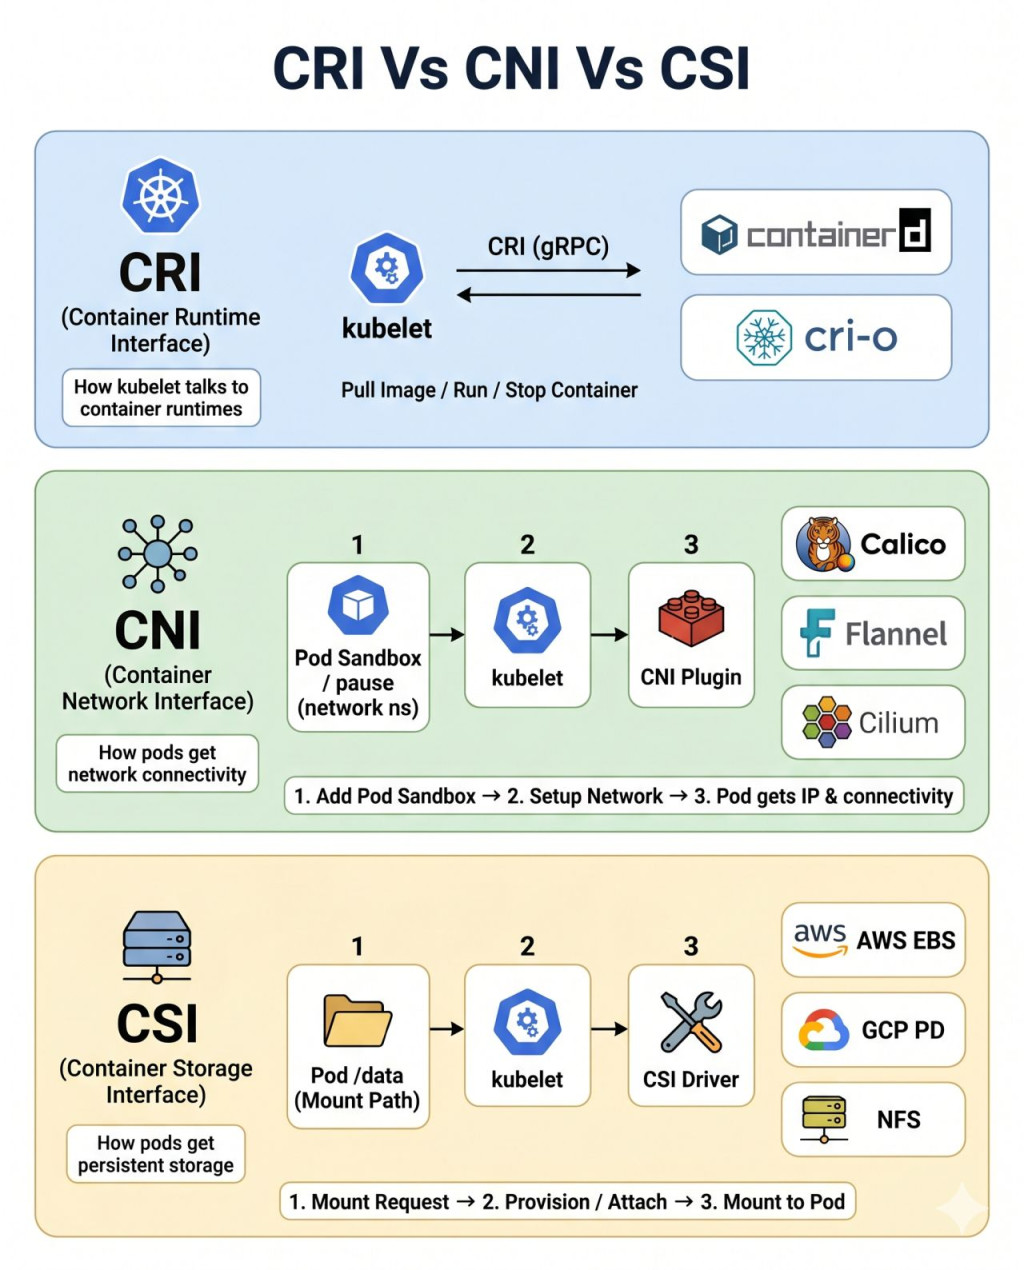
因此你很常看到三個縮寫:
CRI
Container Runtime Interface
CRI 解決的是:
kubelet 要怎麼和 Container Runtime 溝通?
例如:
kubelet
↓ CRI
containerd
↓
Container
接著是今天的:
CNI
Container Network Interface
它負責的是:
Container / Pod 的 Network 要怎麼建立?
例如:
Pod
↓
CNI Plugin
↓
取得 IP、建立介面、設定 Route
↓
Pod Network
第三個則是:
CSI
Container Storage Interface
CSI 解決的是:
Kubernetes 要怎麼和不同 Storage System 溝通?
例如 AWS EBS、Ceph、各種企業 Storage,都可以透過 CSI Driver 接進 Kubernetes。
所以最簡單的記法就是:
CRI = Runtime
CNI = Network
CSI = Storage
它們背後其實都是同一個思想:
Kubernetes 定義介面,實際功能可以交給外部元件實作。
因為我們一直使用:
kind
kind 是 Kubernetes IN Docker,也就是把 Kubernetes Node 建立成 Container,方便我們在自己的電腦上建立 Kubernetes Lab。
kind 預設會幫我們安裝一套比較簡單的網路實作:
kindnetd
所以之前建立 Cluster:
kind create cluster
之後,Node 很快就可以進入:
Ready
Pod 也可以正常取得 IP。
不是因為 Kubernetes 不需要 CNI,而是:
kind 已經偷偷幫我們準備好了。
kind 官方也說明,預設會使用 kindnetd,但可以透過 disableDefaultCNI: true 關閉它,再自行安裝 Calico 等其他 CNI。
是一套開源的容器網路介面(CNI, Container Network Interface)與網路安全方案,主要廣泛應用於 Kubernetes(K8s)、虛擬機及裸機環境。
它主要解決兩大核心問題:容器之間如何通訊(Networking),以及誰可以跟誰通訊(Network Security / Policy)。
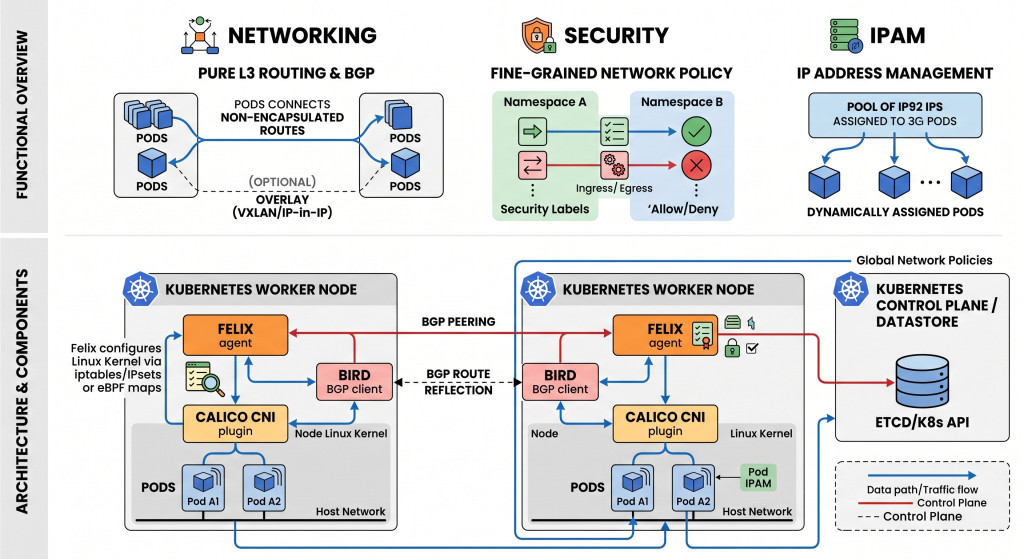
傳統的容器網路方案(如早期 Flannel)常使用封裝技術(Overlay Network,如 VXLAN),將 Pod 的流量打包在另一個封包裡,這會產生額外的 CPU 損耗與延遲。Calico 的最大特色在於採用了標準的 三層(Layer 3)路由架構:
純三層路由(Pure L3 Routing):
Calico 預設將每個 Kubernetes Node 視為一台路由器(Router)。當 Node 上的 Pod 建立時,Calico 會將 Pod 的 IP 作為一筆路由規則直接寫入 Node 的 Linux 核心路由表。
BGP 協定(Border Gateway Protocol):
每個 Node 上運行一個輕量級的 BGP 路由守護程式(基於 BIRD)。各 Node 透過 BGP 互相宣告各自負責的 Pod IP 網段,形成扁平且無封裝的路由網路。流量如同走在實體網路上,吞吐量高、延遲極低。
彈性模式(VXLAN / IP-in-IP):
若底層雲端環境或實體網路不支援 BGP(例如某些公有雲限制),Calico 也支援 Overlay 模式(VXLAN 或 IP-in-IP),能在限制條件下運作。
eBPF 支援:
除了傳統的 Linux iptables 轉發,Calico 提供基於 eBPF 的資料平面(Data Plane),能繞過 iptables 的效能瓶頸,提供線速(Wire-speed)的轉發效能與原生 DSR(Direct Server Return)。
細粒度的 NetworkPolicy(網路策略):
原生 K8s 提供的 NetworkPolicy 規則較基礎,而 Calico 提供更強大的擴充功能:
極佳的網路效能:
因採用純 L3 轉發或 eBPF,沒有雙重封裝的 overhead,適合大流量、低延遲的微服務架構。
IP 地址管理(IPAM):
動態分配與回收 Pod IP,支援以節點為單位分配連續網段(CIDR block),避免大規模叢集產生大量細碎路由條目。
跨環境一致性:
可同時管理混合雲、多叢集、甚至直接納管未跑在容器中的 Linux VM/裸機,使整個環境套用同一套防火牆策略。
| 元件名稱 | 職責說明 |
|---|---|
| Felix | 運行在每個 Node 上的 Daemon,負責將安全策略轉換為核心規則(iptables、IP sets 或 eBPF maps)。 |
| BIRD (BGP Client) | 負責 Node 之間的 BGP 路由廣播與同步。 |
| confd | 監聽資料庫(如 etcd 或 K8s API)的配置變更,並動態更新 BGP 設定檔。 |
| Calico CNI Plugin | 負責在 Pod 建立或銷毀時,設定網路命名空間(Network Namespace)與介面。 |
因為下一步我們要開始實作非常重要的:
NetworkPolicy
NetworkPolicy 是 Kubernetes 用來限制 Pod 網路流量的 Resource。
例如我們可以定義:
Redis
只接受
FastAPI Pod
連線
其他 Pod 即使知道 Redis 的 Service 名稱,也不能直接連進去。
問題是 NetworkPolicy 本身只是:
「我希望網路規則長這樣」
它是一份宣告。
真正負責把規則變成實際封包過濾行為的,是 Network Plugin。
所以:
NetworkPolicy YAML
        ↓
描述允許哪些流量
        ↓
Calico
        ↓
真的執行網路限制
如果你的 Network Plugin 根本不支援 NetworkPolicy,就算:
kubectl apply -f network-policy.yaml
API Server 一樣可以接受這份 Resource,但網路流量可能完全不受影響。Kubernetes 官方文件也特別強調,NetworkPolicy 必須搭配支援 Policy Enforcement 的 Networking Solution 才會生效。
因此今天我們要把 kind 原本的簡單網路換成:
Calico
Calico 同時提供 Kubernetes Networking 與 NetworkPolicy 能力。
今天我們甚至會直接把整個 Kubernetes Cluster 刪掉。
先確認,我們真正重要的東西應該都已經存在專案裡,例如:
app/
Dockerfile
k8s/
kind-config.yaml
接著就開始把 Cluster 刪掉:
kind delete cluster \
  --name cka-lab
確認:
kubectl get nodes
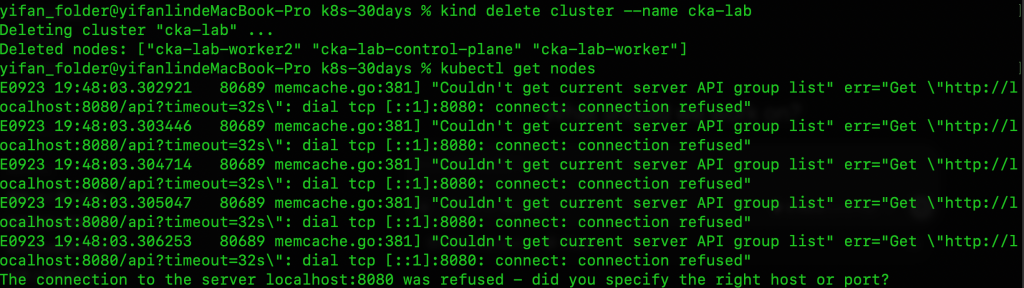
這時可能會因為原本的 Cluster 已經不存在而出現連線錯誤。
這是正常的。
但注意:
Cluster 消失了

FastAPI Code 還在
Dockerfile 還在
Kubernetes YAML 還在
kind Config 還在
所以我們隨時可以重建。
這正是 Infrastructure as Code 很重要的觀念:
Infrastructure is disposable (一次性的)
Configuration is reproducible
基礎設施可以被刪除,但建立它的方法必須能被保存並重複執行。
修改:
kind-config.yaml
內容:
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4

nodes:
  - role: control-plane
  - role: worker
  - role: worker

networking:
  disableDefaultCNI: true
  podSubnet: 192.168.0.0/16
這裡最重要的是:
disableDefaultCNI: true
意思就是:
kind,不要安裝你的預設 kindnetd,我要自己處理 CNI。
另外:
podSubnet: 192.168.0.0/16
Pod Subnet 是我們預留給 Pod 使用的一段 IP 範圍。
也就是未來可能看到:
192.168.10.5
192.168.20.8
192.168.30.12
這些 IP 都可以從這個範圍分配出去。
執行:
kind create cluster \
  --name cka-lab \
  --config kind-config.yaml
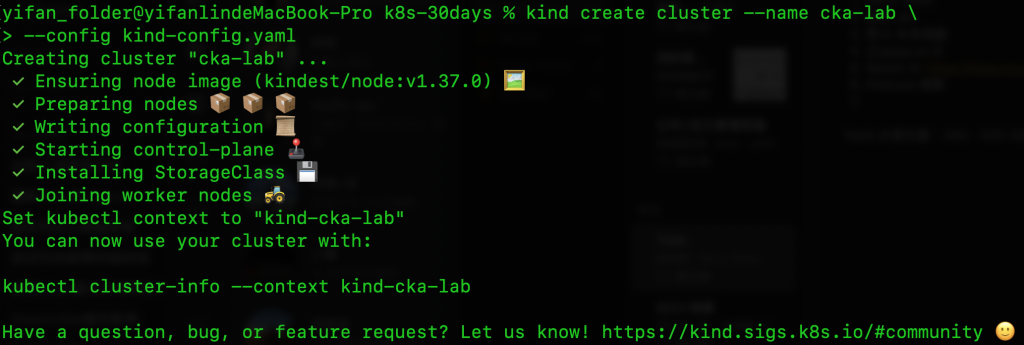
完成之後馬上看:
kubectl get nodes
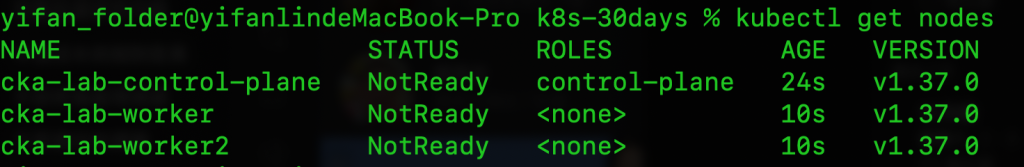
你很可能會看到:
NAME                    STATUS
cka-lab-control-plane   NotReady
cka-lab-worker          NotReady
cka-lab-worker2         NotReady
以前看到 NotReady 可能會覺得出錯了,但這次:
這正是我們故意製造出來的狀態。
因為目前:
API Server
Scheduler
Controller Manager
kubelet
containerd
這些 Kubernetes 核心元件已經存在。
但是:
CNI 尚未安裝
也就是:
Control Plane:有
Container Runtime:有
Pod Network:沒有
kubelet 沒辦法準備完整的 Pod Networking,因此 Node 還不能正常承接一般 Workload。
如果想看得更清楚,可以執行:
kubectl describe node cka-lab-worker
在 Conditions 或 Events 附近,通常可以看到和:
container runtime network not ready
NetworkPlugin
CNI
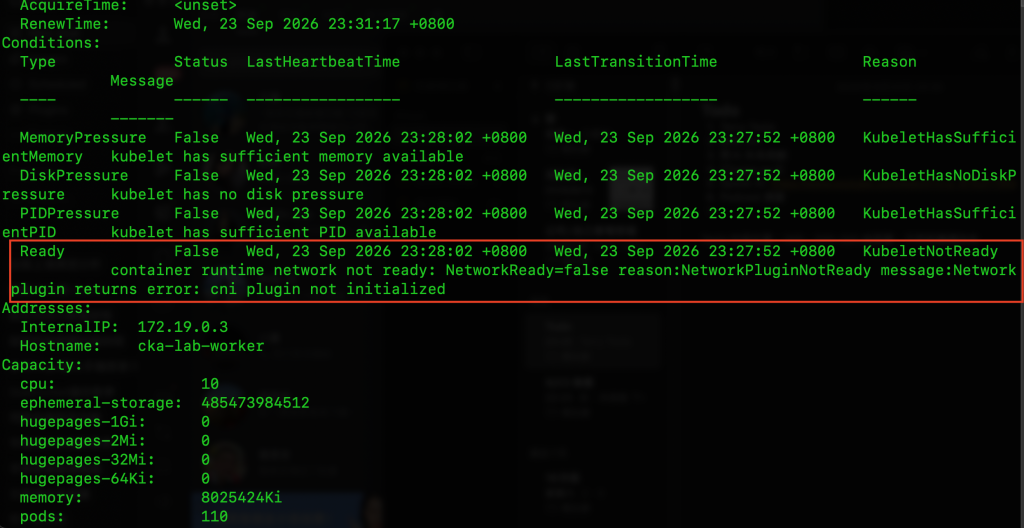
相關的訊息。
這是第一次真正看到:
CNI 並不是 Kubernetes 可有可無的裝飾品,而是 Pod Network 能不能正常運作的重要基礎。
現在我們已經故意建立了一個「有 Kubernetes、但沒有 CNI」的 Cluster,所以 Node 會維持在 NotReady。接下來就是要把 Calico 裝進來,讓 Pod Network 真正建立起來。
Calico 官方針對 kind 提供兩種安裝方式:Operator 與 Manifest。這篇我們採用 Operator,因為它比較符合 Kubernetes 的管理方式,也能順便理解 CRD 與 Operator 這兩個重要概念。
先講 CRD(Custom Resource Definition)。Kubernetes 原本只認識像 Pod、Deployment、Service 這些內建 Resource,但 Calico 有自己的 Installation、IPPool、BGPConfiguration 等 Resource,因此必須先透過 CRD 告訴 Kubernetes:「這些也是合法的 Resource 類型」。所以 CRD 可以理解成是在擴充 Kubernetes API,但它本身還不是 Calico 真正執行網路功能的程式。
另一個名詞是 Operator。Operator 可以先理解成「跑在 Kubernetes 裡面的自動管理程式」。我們不需要自己建立所有 Calico 元件,而是先建立 Tigera Operator,再建立一個 Installation Resource 告訴它:「我要一套 Calico」。Operator 看到之後,就會自動建立並維護 calico-node、calico-kube-controllers、Typha 等相關元件。
整體關係可以記成:
CRD
↓
讓 Kubernetes 認識 Calico Resource

Tigera Operator
↓
負責讀取這些 Resource

Installation Resource
↓
告訴 Operator「請幫我建立 Calico」

Operator
↓
自動建立 Calico Components
目前官方 Operator 安裝流程分成三步。
第一步先安裝 Calico CRDs:
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.32.2/manifests/v1_crd_projectcalico_org.yaml
執行後會看到很多:
customresourcedefinition.apiextensions.k8s.io/... created
這是正常的,代表 Kubernetes 正在加入 Calico 所需要的 Custom Resource 定義。
接著安裝 Tigera Operator:
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.32.2/manifests/tigera-operator.yaml
這一步會建立 tigera-operator Namespace、ServiceAccount、RBAC 與 Operator Deployment。剛建立時如果看到:
0/1 ContainerCreating
這要等一段時間,才變成:
1/1 Running
Operator Running 只代表「負責安裝 Calico 的管理程式已經啟動」,並不代表 Calico 已經全部 Ready。
第三步才是真正建立 Calico Installation:
kubectl create -f https://raw.githubusercontent.com/projectcalico/calico/v3.32.2/manifests/custom-resources.yaml
這個檔案會建立 Installation/default 等 Custom Resources。可以把它理解成我們正式向 Operator 下達需求:
我要一套 Calico,請按照這份設定建立。
這裡要特別注意 Pod CIDR。我們前面的 kind 設定是:
networking:
  disableDefaultCNI: true
  podSubnet: 192.168.0.0/16
而官方的 custom-resources.yaml 目前也是使用:
192.168.0.0/16
所以兩邊剛好一致。如果未來你把 kind 的 podSubnet 改成其他範圍,就要同步修改 Calico 的 IP Pool,不然兩邊的 Pod Network 設定會對不起來。
第三個指令執行完之後,不代表 Calico 會瞬間完成。這點很重要,因為第一次安裝通常需要下載不少 Image,例如 calico/node、calico/cni、calico-kube-controllers、Typha 等,所以可能需要等幾分鐘。
可以先執行:
kubectl get pods -A -w
-w 就是持續監看狀態。macOS 預設通常沒有 Linux 常見的 watch 指令,所以不需要另外安裝,直接使用 kubectl 自己的 -w 就可以。
這時很可能看到:
Pending
ContainerCreating
Init:0/3
Init:1/3
這些狀態不一定代表錯誤。
尤其 calico-node 很常出現:
Init:1/3
這表示這個 Pod 有三個 Init Container。Init Container 是正式程式啟動以前,先執行初始化工作的 Container。Calico 目前可能會看到像:
flexvol-driver
ebpf-bootstrap
install-cni
所以:
Init:1/3
意思是第一個初始化工作已經完成,後面兩個還在執行或等待,不是「Calico 壞掉三分之一」。
實際流程大概是:
calico-node Pod 建立
↓
flexvol-driver
↓
ebpf-bootstrap
↓
install-cni
↓
calico-node 正式啟動
↓
Running
而且其中某一步可能只是正在下載 Image。像我們實際看到 flexvol-driver 已經成功完成,但 ebpf-bootstrap 還在 Pull:
quay.io/calico/node:v3.32.2
這種情況就只是還在下載,不需要馬上刪 Cluster 重來。
如果想確認到底卡在哪裡,可以先找 calico-node:
kubectl get pods \
  -n calico-system \
  -l k8s-app=calico-node
再執行:
kubectl describe pod \
  -n calico-system \
  calico-node-你的Pod名稱
重點看最下面的:
Events:
如果看到:
Pulling image ...
通常只是還在下載。
如果後來看到:
Successfully pulled image ...
代表下載成功,流程會繼續。
真正比較需要處理的是:
ErrImagePull
ImagePullBackOff
CrashLoopBackOff
Failed
這些才比較像真正的錯誤。
因為我們是使用 Operator 安裝,也可以用:
kubectl get tigerastatus
來看 Calico 整體狀態。如果看到:
AVAILABLE     False
PROGRESSING   True
通常表示還在安裝中。
最後理想狀態會變成:
AVAILABLE     True
PROGRESSING   False
DEGRADED      False
這時你可能也會看到 CoreDNS 或其他 Pod 一直停在:
Pending
先不用急著一個一個除錯,因為現在真正的關鍵是 calico-node。
它們之間的關係其實是:
calico-node 初始化完成
↓
CNI 安裝完成
↓
Pod Network 可以運作
↓
Node NotReady → Ready
↓
CoreDNS 等其他 Pod 才開始正常啟動
所以目前只要先確保每一台 Node 上的 calico-node 都成功即可。
等一段時間後再執行:
kubectl get nodes
應該會慢慢看到: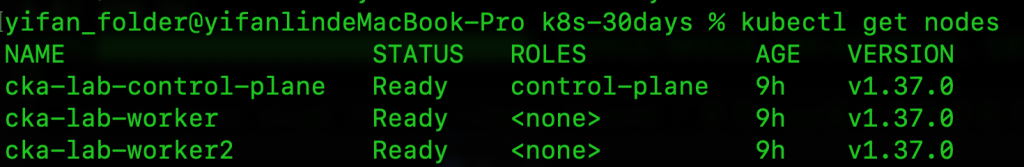
這一刻就是今天最重要的實驗結果。
原本:
Kubernetes
↓
沒有 CNI
↓
Node NotReady
現在變成:
Kubernetes
↓
Calico
↓
Pod Network 建立
↓
Node Ready
原本 kind 使用的是自己的預設 Network Plugin:
kind
↓
kindnetd
今天則變成:
kind
↓
Calico
但我們原本學過的 Pod、Deployment、Service、ConfigMap 完全不需要因此重新學一套。
原因就在於 Kubernetes 中間定義了 CNI 這層 Interface。
Kubernetes 負責規定:
Pod Networking 應該提供什麼能力。
Calico、Cilium、Flannel 等 Network Plugin 則負責:
具體怎麼把這些能力實作出來。
所以:
Kubernetes
↓
CNI Interface
↓
Calico / Cilium / Flannel ...
這就是 Interface 最大的價值:上層不需要知道底層到底怎麼完成工作。
因為前面整個 kind Cluster 已經刪掉,所以原本存在 Cluster 裡的:
Namespace
Deployment
Service
PVC
Secret
ConfigMap
當然全部都不存在了。
但我們的:
app/
Dockerfile
k8s/
kind-config.yaml
仍然保留,因此可以重新建立。
Cluster 可以消失,但只要設定與程式碼還在,就可以重新把環境建回來。
不過這裡有一個很容易忽略的地方:
Cluster 重建之後,原本手動設定在 Node 上的 Label、Taint 等設定,也會跟著消失。
因為我們不是把原本的 Node 重新啟動,而是:
舊 kind Cluster
↓
刪除舊 Node

重新建立 kind Cluster
↓
產生全新的 Node
例如前面的 FastAPI Deployment 有設定:
nodeSelector:
  disktype: ssd
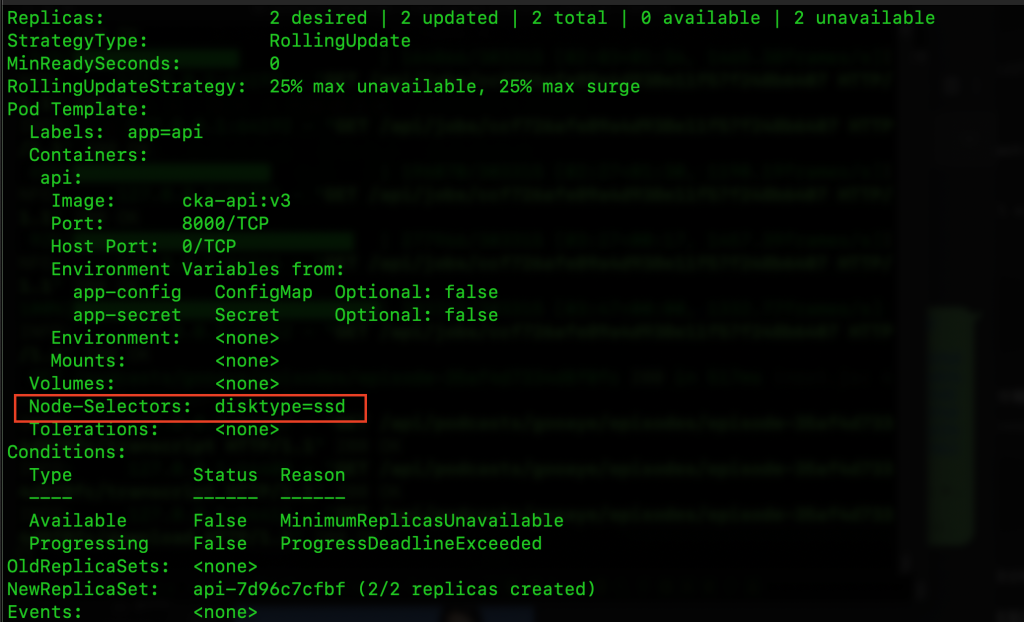
這代表 FastAPI Pod 並不是隨便一台 Node 都可以執行,而是要求:
Node 必須具有:

disktype=ssd
如果以前曾經執行:
kubectl label node \
  cka-lab-worker \
  disktype=ssd
這個 Label 是直接設定在舊 Node 上面的。
當整個 kind Cluster 被刪除之後,這個 Label 也會一起消失。
因此重新建立 Cluster 之後,可以先確認:
kubectl get nodes --show-labels
或者只看 disktype:
kubectl get nodes -L disktype
如果新的 Worker Node 沒有:
disktype=ssd
就重新加回去:
kubectl label node \
  cka-lab-worker \
  disktype=ssd
如果希望兩台 Worker 都可以承接 FastAPI Pod,也可以兩台都加:
kubectl label node \
  cka-lab-worker \
  disktype=ssd

kubectl label node \
  cka-lab-worker2 \
  disktype=ssd
再確認一次:
kubectl get nodes -L disktype
就會看到:
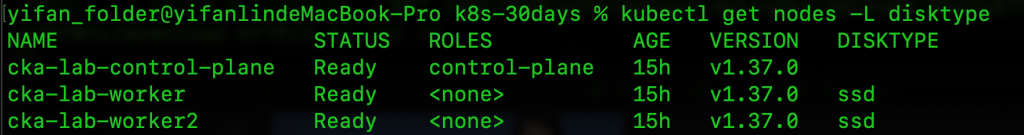
這樣 FastAPI Deployment 裡的:
nodeSelector:
  disktype: ssd
才真的有符合條件的 Node 可以選擇。
這也提醒我們:
kubectl apply -f k8s/
只能重新建立 YAML 裡描述的 Kubernetes Resource。
像這種以前透過:
kubectl label node ...
手動設定在 Node 上的狀態,Cluster 重建之後就必須另外恢復。
接著還要處理 Application Image。
我們自己的:
cka-api:v4
Image 可能只存在 Mac 的 Docker,因此新的 kind Cluster 也要重新載入。
不過這裡有一個很重要的地方:
kind load docker-image載入的 Image 版本,必須和 Deployment YAML 裡設定的image:完全一致。
我們的 API Deployment 定義在:
k8s/01-api.yaml
因此可以先確認目前使用的是哪個 Image:
grep -n "image:" k8s/01-api.yaml
這篇目前統一使用:
image: cka-api:v4
所以後面載入 kind Cluster 的也必須是:
cka-api:v4
可以先確認 Mac Docker 裡真的有這個 Image:
docker images | grep cka-api
確認存在之後,再執行:
kind load docker-image \
  cka-api:v4 \
  --name cka-lab
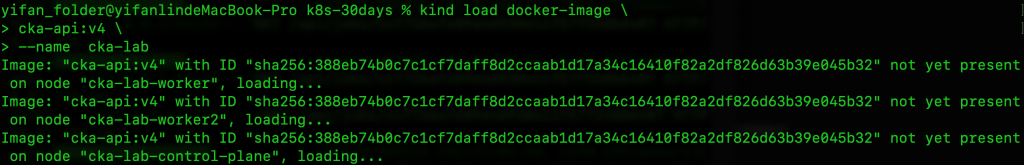
這個指令就是把 Mac Docker 裡的 Image 放進 kind Node 使用的 containerd。
因為 kind 的每個 Node 本身其實都是 Container,而 Kubernetes 在這些 Node 裡使用 containerd 作為 Container Runtime。
所以即使:
docker images
在 Mac 上看得到:
cka-api:v4
也不代表新的 kind Node 裡面已經有這個 Image。
可以把整個關係理解成:
Mac Docker
↓
kind load docker-image
↓
kind Node 裡的 containerd
↓
Kubernetes Pod 才能使用
而且不只是 Image 名稱要一樣,Tag 也必須一致。
例如:
Deployment 要:

cka-api:v3

但是 kind load 的是:

cka-api:v4
對 Kubernetes 來說,這就是兩個不同的 Image。
即使 Mac Docker 裡:
cka-api:v3
cka-api:v4
兩個都存在,只要新的 kind Cluster 裡沒有 Deployment 指定的那個版本,Pod 一樣無法正常啟動。
例如 Node 本地找不到:
cka-api:v3
kubelet 就可能嘗試往外部 Registry 找:
docker.io/library/cka-api:v3
但我們的 cka-api 是自己在本機 Build 的 Image,Docker Hub 上並沒有這個 Repository,因此就會出現:
ErrImagePull
↓
ImagePullBackOff
所以這裡一定要確認:
k8s/01-api.yaml

image: cka-api:v4

        ↓ 完全一致

kind load docker-image

cka-api:v4
確認 Image 版本一致之後,再重新部署:
kubectl apply -f k8s/
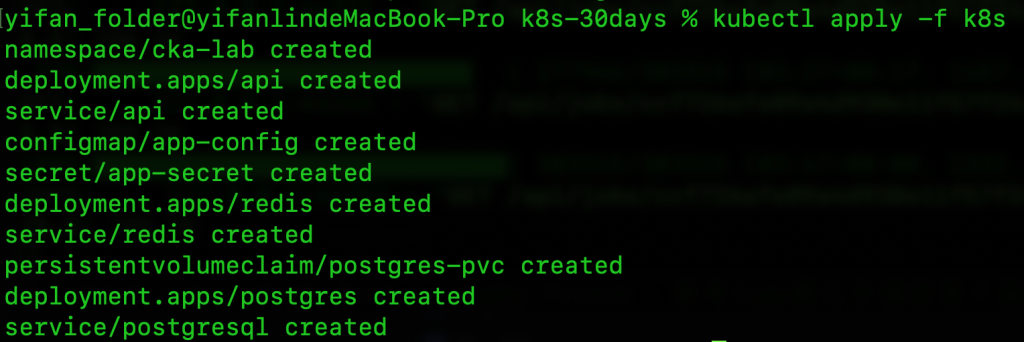
如果想更容易理解,可以按照依賴關係看:
Namespace
↓
ConfigMap / Secret
↓
PVC
↓
Redis / PostgreSQL
↓
FastAPI
↓
Service
不代表 Kubernetes 永遠都一定要嚴格照這個順序建立。
例如我們直接:
kubectl apply -f k8s/
Kubernetes 本身也會處理很多 Resource 之間的建立與等待。
只是在學習階段按照依賴關係理解,之後遇到問題時會比較容易知道是哪一層出錯。
另外,現在還要多記兩層:
Application YAML
↓
可能有 Node Scheduling 條件
↓
Node Label / Taint / Affinity
以及:
Deployment YAML
↓
指定 Image
↓
kind Node 必須真的擁有對應版本
所以 Cluster 重建之後,不只是 Application Resource 要恢復。
原本依賴的:
Node Label
Node Taint
Application Image
也都要重新確認。
先確認 Pod:
kubectl get pods \
  -n cka-lab
FastAPI、Redis、PostgreSQL 正常情況下都應該逐漸變成:
Running
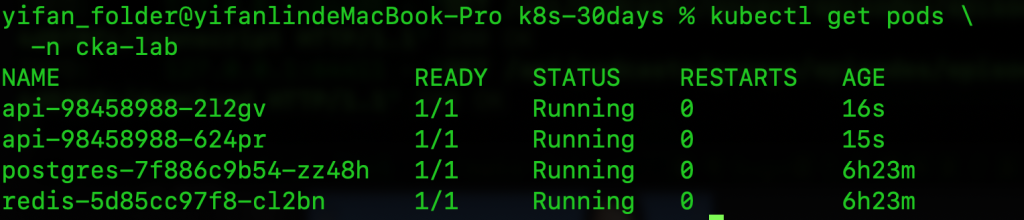
不過這裡不要只記得:
等到 Pod 變成 Running。
更重要的是要學會看:
Pod 到底卡在哪一個階段。
如果某個 Pod 長時間沒有變成 Running,可以執行:
kubectl describe pod \
  <POD_NAME> \
  -n cka-lab
然後看最下面的:
Events:
因為不同狀態通常代表完全不同的問題。
例如這次我們一開始遇到:
Pending
查看 Events 後看到:
0/3 nodes are available:
1 node(s) had untolerated taint(s),
2 node(s) didn't match Pod's node affinity/selector.
這代表 Pod 還卡在:
Scheduling
階段。
原因是 FastAPI Deployment 有:
nodeSelector:
  disktype: ssd
但是 Cluster 重建之後,新的 Worker Node 已經沒有原本的:
disktype=ssd
Label。
所以:
FastAPI Pod
↓
要求 disktype=ssd
↓
Scheduler 檢查所有 Node
↓
沒有符合條件的 Worker
↓
Pending
重新補上:
kubectl label node \
  cka-lab-worker \
  disktype=ssd
之後 Events 就會出現:
Successfully assigned ...
這代表:
Scheduling ✅
已經成功。
但是修好 Scheduling 之後,不代表後面一定全部正常。
這次 Pod 成功被排到 Worker 之後,又出現:
ErrImagePull
ImagePullBackOff
Events 顯示:
Failed to pull image "cka-api:v3"
這時問題已經不是 NodeSelector 了。
因為:
Successfully assigned
已經證明 Scheduler 成功找到 Node。
現在是下一個階段:
Pod 已經排到 Node
↓
kubelet 準備建立 Container
↓
尋找 Deployment 指定的 Image
↓
找不到
↓
ErrImagePull
↓
ImagePullBackOff
這時就應該確認:
grep -n "image:" k8s/01-api.yaml
以及:
docker images | grep cka-api
再確認我們載入 kind 的版本:
kind load docker-image \
  cka-api:v4 \
  --name cka-lab
三邊必須一致:
k8s/01-api.yaml
↓
image: cka-api:v4

Mac Docker
↓
cka-api:v4

kind Node
↓
cka-api:v4
如果其中一個還是:
cka-api:v3
就有可能再次出現:
ImagePullBackOff
因此這次實際上遇到了兩個連續、但完全不同的問題:
第一關:Scheduling

Node 沒有 disktype=ssd
↓
Pending
↓
補上 Node Label
↓
Successfully assigned ✅
接著:
第二關:Container Image

Deployment 指定的 Image
和 kind 裡實際存在的 Image 不一致
↓
ErrImagePull
↓
ImagePullBackOff
↓
統一 Image 版本
↓
Container 正常建立 ✅
所以 Kubernetes 除錯不能只看到第一個錯誤修好,就認為所有事情結束了。
Pod 每往下一個階段前進,都可能再暴露出下一個問題。
可以簡單記成:
Pending
↓
先檢查 Scheduling

Successfully assigned
↓
代表 Scheduler 已成功

ErrImagePull / ImagePullBackOff
↓
檢查 Image

CrashLoopBackOff
↓
Container 有啟動
但 Application 一直 Crash

Running
↓
Pod 正常執行
而最常用來判斷真正原因的就是:
kubectl describe pod \
  <POD_NAME> \
  -n cka-lab
搭配最下面的:
Events:
確認 FastAPI、Redis、PostgreSQL 都正常 Running 之後,再確認 Service:
kubectl get svc \
  -n cka-lab
接著建立 Port Forward:
kubectl port-forward \
  service/api \
  8080:80 \
  -n cka-lab
另外開一個 Terminal:
curl localhost:8080
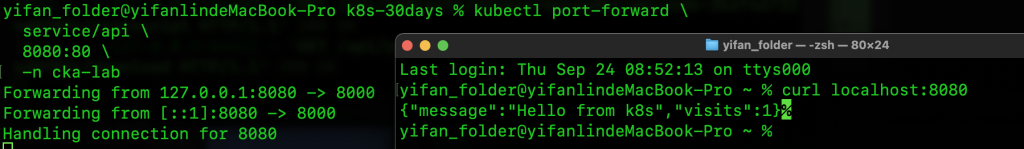
如果 API 可以正常回應,就代表整個環境已經成功恢復。
這裡也要注意:
如果 FastAPI Pod 還是:
Pending
或者:
ImagePullBackOff
這時候直接執行:
kubectl port-forward \
  service/api \
  8080:80 \
  -n cka-lab
可能會看到:
error: unable to forward port because pod is not running.
Current status=Pending
原因不是 Service 壞掉。
而是:
Port Forward
↓
找到 Service
↓
Service 要轉送到 FastAPI Pod
↓
FastAPI Pod 還沒有 Running
↓
無法 Forward
所以正確順序應該是:
Pod Running
↓
Service 有可用 Backend
↓
Port Forward
↓
curl 測試
今天完整走過的流程其實是:
Delete Cluster
↓
Recreate Cluster
↓
No CNI
↓
Node NotReady
↓
Install Calico
↓
Calico Images / Init Containers
↓
Pod Network Ready
↓
Node Ready
↓
Restore Node Labels
↓
Verify Deployment Image Version
↓
Reload Matching Application Image
↓
Redeploy Application
↓
Check Pod Scheduling
↓
Check Container Image
↓
Pods Running
↓
Service Restored
這次也讓我們實際看到:
Cluster 重建
並不只是重新執行:
kubectl apply -f k8s/
就一定全部恢復。
因為 Application 有時候還會依賴:
Node Label
Node Taint
Image
CNI
Storage
這些 Cluster 層級或 Node 層級的環境設定。
例如:
kubectl apply -f k8s/
可以重新建立:
Deployment
Service
ConfigMap
Secret
PVC
但它不會自動幫我們恢復以前手動執行的:
kubectl label node ...
也不會自動把 Mac Docker 裡的本地 Image 搬進新的 kind Node。
因此真正可重建的環境應該考慮:
Kubernetes YAML
+
Node 設定
+
Container Image
+
Network
+
Storage
而不是只有 Application YAML。
今天真正要記住的並不是 Calico 的三個安裝指令,而是 Kubernetes 很核心的一個架構思想:
Kubernetes
≠
所有功能全部內建
它大量透過標準 Interface 和外部元件合作:
CRI → Runtime
CNI → Network
CSI → Storage
今天我們真正操作的是:
Kubernetes
↓
CNI Interface
↓
Calico
↓
Pod Network
也因此可以理解,為什麼我們可以把:
kindnetd
換成:
Calico
但原本的:
Pod
Deployment
Service
ConfigMap
完全不需要重新學一套。
因為 Kubernetes 上層只需要知道:
CNI 應該提供什麼 Networking 能力
至於底層到底由:
Calico
Cilium
Flannel
哪一套實作,是 Network Plugin 自己負責。
更重要的是,我們真的親眼看到:
沒有 CNI
↓
Node NotReady

安裝 Calico
↓
calico-node 初始化
↓
Pod Network Ready
↓
Node Ready
但:
Node Ready
只代表 Node 本身已經具備正常工作的基本條件。
它不代表:
所有 Pod 一定可以 Running
因為 Pod 後面還要經過:
Scheduler
↓
選擇 Node

kubelet
↓
準備 Image

Container Runtime
↓
建立 Container

Application
↓
真正啟動
其中 Scheduler 還會判斷:
NodeSelector
NodeAffinity
Taint / Toleration
CPU / Memory
PVC
例如這次:
FastAPI
↓
nodeSelector: disktype=ssd
↓
Cluster 重建後 Label 消失
↓
找不到符合條件的 Worker
↓
Pending
最後重新補上:
kubectl label node \
  cka-lab-worker \
  disktype=ssd
Scheduler 才重新找到符合條件的 Node。
但是 Scheduler 成功之後,我們又遇到:
ImagePullBackOff
原因是:
Deployment Image
↓
cka-api:v3

實際重新載入 kind 的 Image
↓
cka-api:v4
版本不一致。
修正成:
Deployment
↓
cka-api:v4

kind load
↓
cka-api:v4
之後 Container 才能正常建立。
所以今天其實學到了兩個非常重要的除錯觀念。
第一個:
Pod Pending
≠
再等一下就好
而是:
Pod Pending
↓
kubectl describe pod
↓
Events
↓
找到 Scheduling 真正原因
第二個:
修好 Pending
≠
所有問題都結束
因為 Pod 往下一個階段前進之後,還可能遇到:
ErrImagePull
ImagePullBackOff
CrashLoopBackOff
所以更完整的 Kubernetes 除錯思路應該是:
看 Pod Status
↓
kubectl describe pod
↓
看 Events
↓
判斷現在卡在哪一層
↓
只處理那一層的問題
↓
重新觀察下一個狀態
這會是之後 Kubernetes 除錯最常使用的思考方式之一。
接下來有了支援 NetworkPolicy 的 Calico,就可以真正開始限制 Pod 之間的流量,例如:
FastAPI → Redis    ✅

其他 Pod → Redis  ❌
這時 NetworkPolicy 才會從一份 YAML,真正變成 Kubernetes 裡可以實際驗證的網路存取規則。


 iThome鐵人賽
 看影片追技術