
讀完能做到:說出
Session的四個核心屬性、用官方推薦的兩種正確方式更新 state(而不是直接改物件)、知道 Rewind 能救你什麼、不能救你什麼,以及升級到 ADK 2.0 時 session 資料庫為什麼可能需要遷移。
官方文件開場用了一個很生活化的比喻:你跟朋友傳訊息,不會每一則都重新自我介紹一次,對話有它自己的脈絡。Agent 也一樣——沒有一個機制記住「這段對話目前談到哪」,agent 就只能每次都當作第一次見面。Session 就是專門用來追蹤與管理這些個別對話串的物件,管理它的是 SessionService。
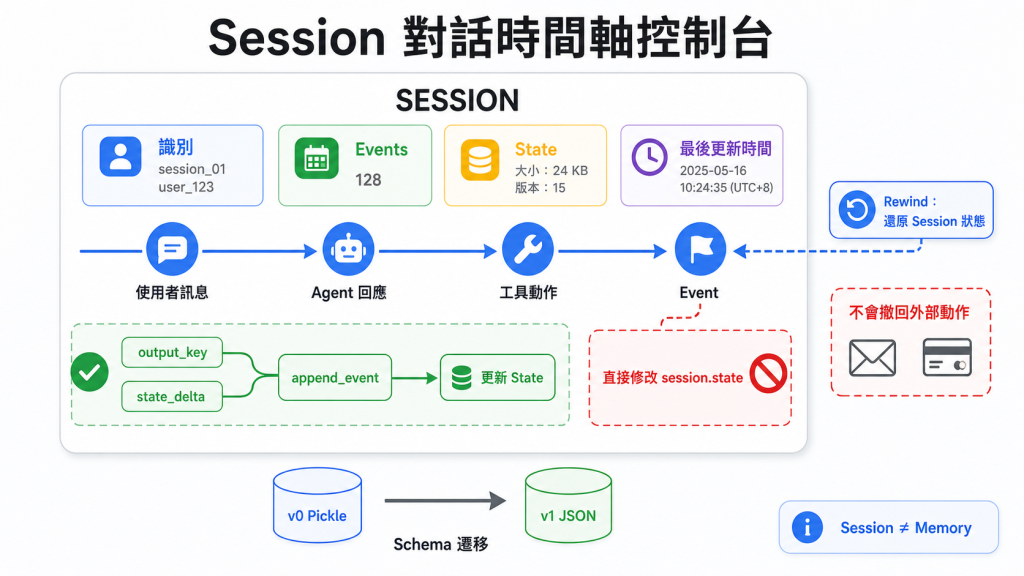
使用者開始跟 agent 互動時,SessionService 會建立一個 Session 物件,作為這一段特定對話串的容器,裡面裝著:
id、app_name、user_id)——id 是這段對話串的唯一識別碼;app_name 標示這段對話屬於哪個 agent 應用;user_id 把對話跟特定使用者連結起來。events)——這段對話串裡發生的所有互動(使用者訊息、agent 回應、工具動作)按時間順序排列的清單。state)——只跟這一段、目前進行中的對話相關的暫存資料,agent 互動過程中的便條紙。last_update_time)——這段對話串最後一次有 event 發生的時間戳記。from google.adk.sessions import InMemorySessionService, Session
temp_service = InMemorySessionService()
example_session = await temp_service.create_session(
app_name="my_app",
user_id="example_user",
state={"initial_key": "initial_value"}
)
print(f"ID: {example_session.id}")
print(f"State: {example_session.state}") # 這裡只顯示初始 state
print(f"Events: {example_session.events}") # 一開始是空的
官方特別加註一句容易被忽略的話:這裡看到的 state 只是初始值——之後所有的更新,都要透過 event 完成,不是直接改物件屬性。這句話看似平淡,卻是整篇文章接下來要花最多篇幅解釋的規則。
一輪對話裡,Session 與 SessionService 協作的簡化流程是:開始或接續(呼叫 create_session 開新對話,或用既有 session id 接續)→ 提供 Context(Runner 取得 Session 物件,讓 agent 能存取這段 session 的 state 與 events)→ Agent 處理(分析問題,可能參考 state 與 events 歷史)→ 回應與 State 更新(agent 產生回應,Runner 把這一切包成一個 Event)。
SessionService 實作InMemorySessionService——開發用,程序結束就沒了。VertexAiSessionService——託管在 Google Cloud(Python / Go / Java / Kotlin v0.7.0)。免建 GCP 專案的捷徑:Google Cloud Agent Platform express mode 讓你只用一把 API key 就初始化 VertexAiSessionService(agent_engine_id=APP_ID),不用傳 project/location。代價是專案只有 90 天效期、額度受限(免費層每分鐘 10 次 session 建立/更新、30 次 event append)——寫 demo 很夠,正式上線前得掛付款帳戶解除限制。DatabaseSessionService——自己的資料庫(Python / Go)。文件有專節談 Concurrency and locking,多實例部署時一定要看——這是自建 session 儲存最容易忽略、卻在高併發下最先出問題的部分。FirestoreSessionService(僅 Java)——接 Google Cloud Firestore 的第四種官方實作。兩個容易踩的雷:google-adk 與 google-adk-firestore-session-service 兩個依賴版本要對齊;綁定的 FirestoreDatabaseRunner 內部會初始化 GcsArtifactService,沒設定 gcs.adk.bucket.name 屬性會在啟動時直接丟 RuntimeException——這種「等你部署那一刻才發現」的坑,比程式碼寫錯更難排查。長對話的效能考量:不管用哪一種 SessionService,session 存活得夠久,事件歷史就會一直長大——每次 invocation 都把完整歷史整包載入,遲早會拖慢回應也拉高成本。RunConfig 的 get_session_config(Python-only)就是為此設計:用 num_recent_events 或 after_timestamp 限制載入的事件範圍,不用整包歷史都吃進來。細節與另外兩個容易被忽略的一般性 RunConfig 欄位(include_thoughts_from_other_agents、model_input_context)見 [[ADK Runtime 與開發介面]]。
session.state 是輕量的 key-value store,用四種前綴決定作用域:app:(整個 app 的所有使用者共享)、user:(綁定使用者,跨他的所有 session)、temp:(本次 invocation 結束就丟棄)、無前綴(存活於該 session)。
官方對「怎麼改 state」的說明,分成正確做法跟危險做法兩邊講得很清楚。正確做法是透過 Context(CallbackContext 或 ToolContext)上的 state 屬性去改,例如 callback_context.state['my_key'] = 'new_value',這種寫法會被框架自動追蹤成 event 的一部分。危險做法是拿到一個從 SessionService 直接取回的 Session 物件後,直接改它的 state——這繞過了整個事件記錄系統。
具體有兩種推薦更新方式。第一種是最簡單的 output_key,適合把 agent 的文字回應直接存進 state:
from google.adk.agents import LlmAgent

greeting_agent = LlmAgent(
    name="Greeter",
    model="gemini-flash-latest",
    instruction="Generate a short, friendly greeting.",
    output_key="last_greeting"  # 回應會被存進 state['last_greeting']
)
第二種是更完整的 EventActions.state_delta,適合一次改多個 key、非字串值、或指定 user:/app: 作用域:
from google.adk.events import Event, EventActions
import time

state_changes = {
    "task_status": "active",
    "user:login_count": session.state.get("user:login_count", 0) + 1,
    "user:last_login_ts": time.time(),
    "temp:validation_needed": True  # 會被丟棄,不會留在最終 state 裡
}
actions_with_update = EventActions(state_delta=state_changes)
system_event = Event(invocation_id="inv_login_update", author="system",
                      actions=actions_with_update, timestamp=time.time())
await session_service.append_event(session, system_event)
append_event 內部會做四件事:把 event 加進 session.events、讀出 state_delta 套用到對應作用域、更新 last_update_time、以及序列化同一 session 的併發更新——DatabaseSessionService 對該 session 取鎖,但 InMemorySessionService 不是 thread-safe 的,多執行緒環境下直接用它有競態風險,這點在寫教學程式碼範例時很少被提到,卻是真正上生產環境會咬人的地方。
為什麼不能直接改 state? 官方列了四個具體後果:繞過事件歷史、失去可稽核性;破壞持久化(DatabaseSessionService/VertexAiSessionService 很可能根本不會存下這個變更);不是 thread-safe,可能競態遺失更新;忽略時間戳與相關 event 邏輯。
還有兩件跟 state 相關、常被忽略的事:
ParallelAgent 這類並行流程時必須理解這個行為,否則會遇到「明明剛寫進去的值,另一個平行分支讀不到」的詭異現象。詳細可參考官網最下面說明修改state 的警示。Rewind 讓你把 session 退回到某個較早的請求狀態——適合「使用者說錯了、重來一次」,或除錯時想重現特定的對話狀態。用法是指定一個要撤銷的 invocation:如果你有三個請求 A、B、C,想退回到 A 的狀態,就指定 B(會撤銷 B 跟 C 的變更)。
from google.adk.runners import InMemoryRunner

runner = InMemoryRunner(agent=agent.root_agent, app_name=APP_NAME)
session = await runner.session_service.create_session(app_name=APP_NAME, user_id=USER_ID)

await call_agent_async(runner, USER_ID, session.id, "set state color to red")
events_list = await call_agent_async(runner, USER_ID, session.id, "update state color to blue")

rewind_invocation_id = events_list[1].invocation_id
await runner.rewind_async(
    user_id=USER_ID,
    session_id=session.id,
    rewind_before_invocation_id=rewind_invocation_id,
)
運作原理值得說清楚:Rewind 不是把記錄刪掉,而是建立一個特殊的「rewind 請求」,把 session 的 state 與 artifacts 恢復到 rewind 點之前的狀態。所有請求,包括被倒帶的那些,都還留在記錄裡,供之後除錯、分析或稽核用;只是系統在準備下一次送給模型的請求時,會忽略被倒帶掉的那些請求——效果上就是模型「忘記」了 rewind 點之後的互動。
三個限制一定要知道:
Session 是單一對話的短期脈絡;跨 session 的長期記憶是另一個機制(Memory,之後章節細講)。這是最容易在教學文章裡講混的地方——一個常見的錯誤心智模型是「session 存久一點不就等於 memory 了」,但兩者的儲存後端、查詢方式(session 依 id 取回、memory 靠語意搜尋)、跟生命週期設計目的完全不同。把兩者混為一談,最常見的後果是工程師想省事只用 session 硬撐長期記憶的需求,結果查詢效能與擴充性都撐不住。
Session 跟 State 解決的是「這段對話記得住什麼」;但記得住不代表便宜——對話一長,塞進模型的 context 就跟著變大,延遲跟成本都會被拖著往上走。明天要處理的正是這個問題:Context 壓縮與 Token 最佳化。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor
下一章 Day 10 - 像管理原始碼一樣管理 Context:壓縮與 Token 最佳化


 iThome鐵人賽
 看影片追技術