
主張:ADK 的
Session(對話紀錄)跟 Live API session(即時連線)是兩個完全不同的東西,搞混這件事,你寫出來的語音 agent 遲早會在某個深夜炸掉。
讀完能做到:分清楚 ADK Session 與 Live API session 的差異,並用adk web跑起一個能講話、能看鏡頭的 agent。
前幾天你可能已經在 adk web 裡跟自己寫的 agent 打過幾百輪文字對話。今天開始的三天,主題換成語音跟視訊——你的 agent 終於可以真的「聽」你講話、「看」你的鏡頭,而不是只會讀你打的字。
在你動手之前,先講一個幾乎所有人第一次碰 ADK 語音功能都會踩到的坑。假設你做了一個客服語音 agent,用 DatabaseSessionService 把對話存進 PostgreSQL,理論上使用者掛斷再打進來,agent 應該記得剛剛聊到哪。結果你發現——每次連線大概撐個十分鐘就斷了,斷線之後好像「失憶」了一部分,對話變得怪怪的。你開始懷疑是不是資料庫寫入有問題,或者是不是 session 沒存好。
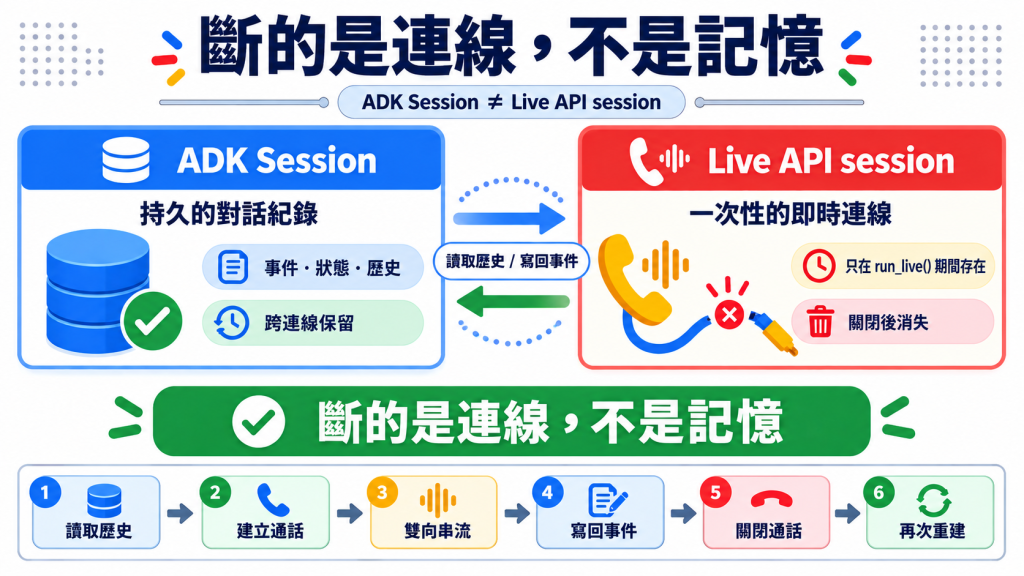
答案跟你的資料庫一點關係都沒有。你撞到的是 ADK Session 和 Live API session 是兩個不同生命週期的東西——這是官方開發指南在 Part 1 跟 Part 4 都特別拉出來強調的一點,因為幾乎每個人都會搞混。
ADK Session(由 SessionService 管理)是持久的對話儲存——它可以橫跨好幾個小時、好幾天,甚至好幾個月,存放對話歷史、事件、狀態。它在你呼叫 run_live() 之前就存在,結束之後也還在。
Live API session(由 Google 的 Live API 後端管理)則是一次性的串流連線上下文——只在 run_live() 的事件迴圈跑著的時候存在,你呼叫 LiveRequestQueue.close() 它就沒了。它會受平台的連線時長限制(後面會講到大概 10 分鐘這件事)。
兩者怎麼合作?當你呼叫 run_live():
SessionService 把既有的 ADK Session 讀出來session.events 裡的對話歷史去初始化一個新的 Live API sessionSession
run_live() 結束時,Live API session 消失,但 ADK Session 繼續留著run_live()(或應用程式重啟後),ADK 從 Session 讀歷史,建一個全新的 Live API session所以你資料庫裡的對話紀錄一直都是完整的——斷線斷的只是那條「即時通話線路」,不是你的記憶。真正會讓你在生產環境吃虧的,是不知道這件事之後,把兩者的責任混在一起處理:比如試圖手動「保存」Live API session 的狀態,或者以為 ADK Session 也有那個十分鐘的限制而過度設計重連邏輯。這個區分,會在明天講 RunConfig 的時候繼續深挖——因為 Live API session 本身還可以透過 session resumption 跨多個連線延續。今天,你只需要記住這個心智模型就夠了。
官方文件把 ADK 的語音/視訊層叫做 ADK Gemini Live API Toolkit,用一句話講完:它把 Gemini Live API 的低延遲雙向語音視訊能力,包成 ADK 的宣告式設定。
「雙向」(Bidi, Bidirectional)是這裡的關鍵字。傳統的 AI 互動像寄 email——你送出一則完整訊息,等對方回一則完整訊息。Bidi-streaming 像講電話——雙方都能同時說、同時聽,而且你可以打斷對方。你正在聽 agent 解釋量子物理,突然插一句「等等,什麼是電子?」,它會立刻停下來回答你,而不是把準備好的長篇大論講完。
這件事之所以難做,是因為背後牽涉到管理 WebSocket 連線與重連邏輯、協調工具呼叫與回應處理、跨 session 保存對話狀態、協調多模態輸入的並發資料流、還要處理開發環境跟正式環境的平台差異。Raw Live API(google-genai SDK)把這些全部丟給你自己處理;ADK Gemini Live API Toolkit 把它們變成宣告式設定——這是官方文件用一張表格直接對比的重點,ADK 幫你做掉的部分包括:
LiveRequestQueue 與 run_live() 這組非同步協調框架而不是你自己土法煉鋼。
Live API 有兩種存取路徑,官方在後續文件裡統稱它們為 "Live API",只有在講平台專屬差異時才會分開講:
| Gemini Live API | Gemini Live API (Agent Platform) | |
|---|---|---|
| 存取方式 | Google AI Studio | Google Cloud |
| 認證 | API key(GOOGLE_API_KEY) |
Google Cloud 憑證 |
| 適合 | 快速原型、開發、實驗 | 正式部署、企業應用 |
| Setup Complexity | 最低(只要一把 API key) | 需要建好 Google Cloud 專案 |
| Session Duration | 純語音 15 分鐘/加視訊 2 分鐘 | 兩種模式都是 10 分鐘 |
| API 版本 | v1beta |
v1beta1 |
| 端點 | generativelanguage.googleapis.com |
{location}-aiplatform.googleapis.com |
表格裡的 Session Duration 就是開頭那個十分鐘的來源——Agent Platform 兩種模式都是 10 分鐘,AI Studio 則是純語音 15 分鐘、加上視訊只剩 2 分鐘。怎麼突破這個上限,明天講 RunConfig 時會拆。
切換平台不需要改程式碼,只要改環境變數 GOOGLE_GENAI_USE_ENTERPRISE(FALSE 用 AI Studio,TRUE 用 Agent Platform)。這代表你可以本機用免費 API key 開發,上線再切到企業級基礎設施,程式碼一行都不用動——只是這個切換帶來的 session 時長差異,明天講 RunConfig 的時候會看到,兩個平台的限制其實不太一樣。
官方文件用一張表把責任分得很清楚:
Agent 定義(model、tools、instruction)LiveRequestQueue(緩衝並排序使用者訊息)、Runner(協調 session、提供 run_live())、RunConfig(串流行為設定)、以及內部的 LLM Flow 與協定轉譯資料流長這樣:
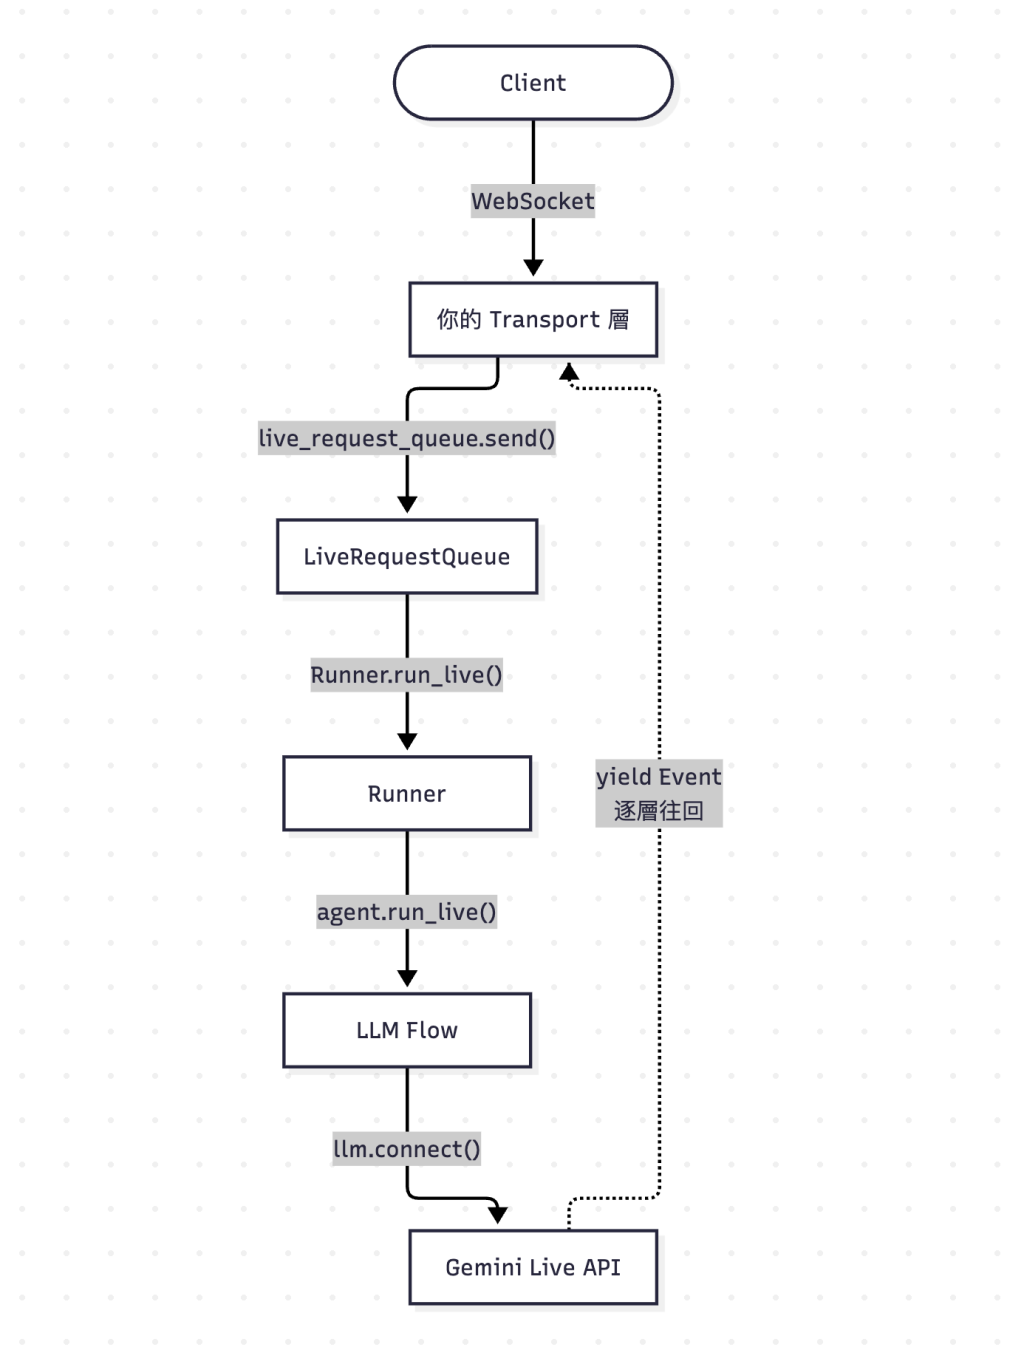
Client 透過 WebSocket 連到你的 Transport 層,一路往下交給 LiveRequestQueue、Runner.run_live()、agent.run_live(),最後由 LLM Flow 呼叫 llm.connect() 接上 Gemini。回程反過來,一路 yield Event 回到你的 Transport 層。
ADK 把一個語音 session 的生命週期切成四個階段:
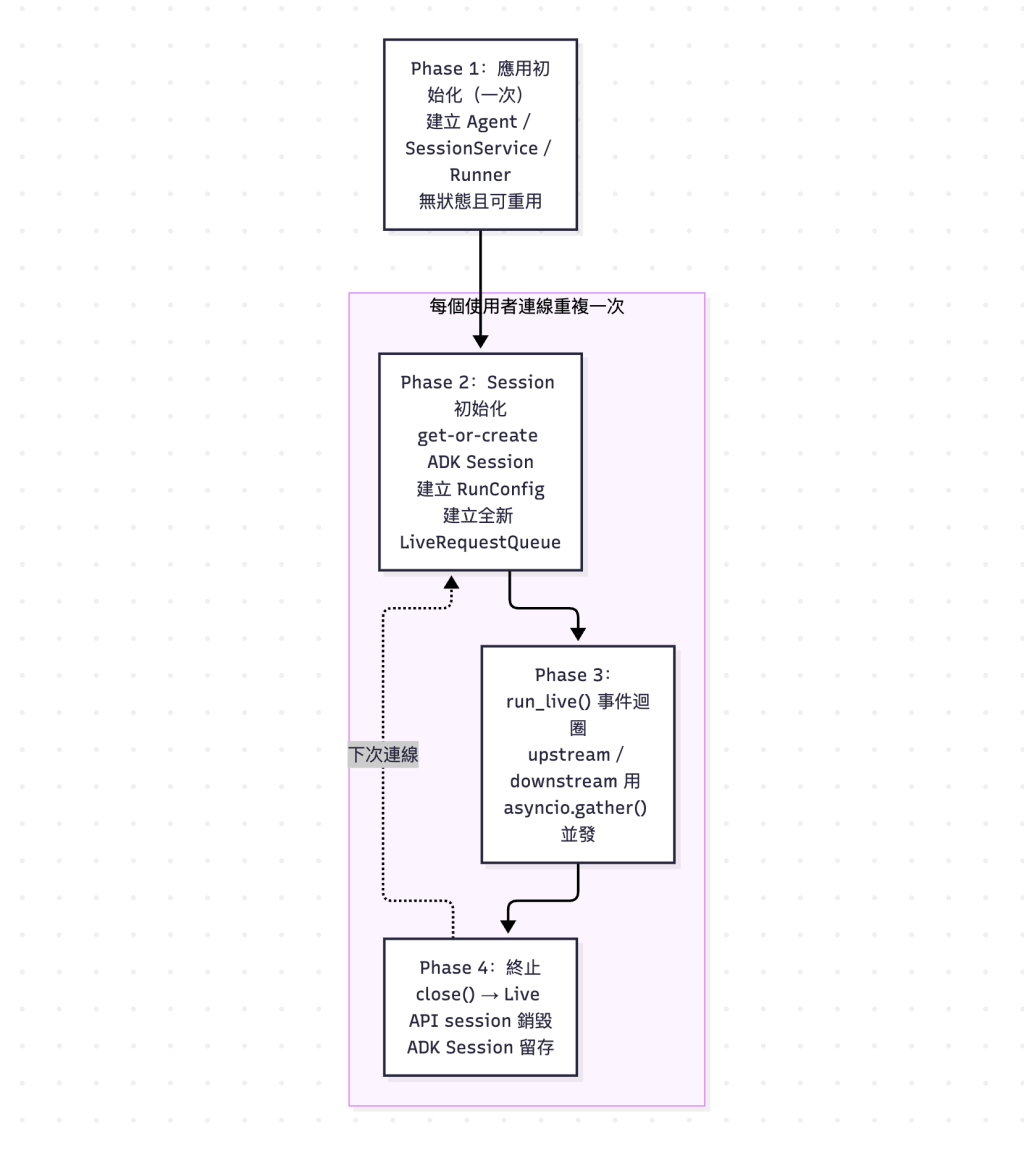
Phase 1:應用初始化(整個應用程式啟動時做一次)——建立 Agent、建立 SessionService、建立 Runner。這三個物件是無狀態且可重用的,只建一次,所有使用者的 session 共用。
Phase 2:Session 初始化(每個使用者連線做一次)——用 get-or-create 模式拿到 ADK Session、建立這次連線專用的 RunConfig、建立一個全新的 LiveRequestQueue。官方特別提醒:LiveRequestQueue 絕對不能跨 session 重用,每次 run_live() 呼叫都要一個新的 queue,重用會導致訊息順序錯亂與狀態汙染。
Phase 3:run_live() 事件迴圈——這是真正雙向串流的地方:一個 upstream task 把使用者訊息送進 queue,一個 downstream task 從 run_live() 收 Event 往外送,兩者用 asyncio.gather() 並發跑。
Phase 4:終止——呼叫 live_request_queue.close(),讓 run_live() 的 async generator 優雅結束,Live API session 隨之銷毀,但 ADK Session 留下來。
上面那四個階段,等你要自己寫 FastAPI server 時每一步都得自己接。但今天先不用——adk web 已經把 Transport 層跟四階段生命週期都包好了,你只要負責 Agent 定義那一塊(自己寫 transport 的完整範例在官方 dev guide Part 1)。
理論講完,來跑一個真的能講話的 agent。跟 Day 2 一樣的流程,先裝好環境:
python3 -m venv .venv
source .venv/bin/activate   # macOS/Linux
pip install google-adk
專案結構跟平常一樣簡單:
adk-streaming/
└── app/
    ├── .env
    └── google_search_agent/
        ├── __init__.py
        └── agent.py
agent.py 幾乎跟 Day 3 你寫過的 agent 一模一樣——這是 ADK 語音功能最讓人安心的地方,不需要為了支援語音重寫 agent 定義,差異全部在後面的 RunConfig 上:
from google.adk.agents import Agent
from google.adk.tools import google_search  # Import the tool

root_agent = Agent(
   # A unique name for the agent.
   name="basic_search_agent",
   # The Large Language Model (LLM) that agent will use.
   # 兩個平台的 native audio 模型 ID 不同,AI Studio 用這個:
   model="gemini-2.5-flash-native-audio-preview-12-2025",
   # 若走 Agent Platform,改成 "gemini-live-2.5-flash-native-audio"
   # A short description of the agent's purpose.
   description="Agent to answer questions using Google Search.",
   # Instructions to set the agent's behavior.
   instruction="You are an expert researcher. You always stick to the facts.",
   # Add google_search tool to perform grounding with Google search.
   tools=[google_search]
)
model 這欄不能留空也不能隨便填——不是每個 Gemini 模型都支援 Live API。上面兩個 ID 是官方開發指南 Part 1 列出的預設值(ADK 文件 2026-08 版本),模型汰換很快,跑不動時去 Gemini API 模型清單 查標了 Live API 的最新 ID。填錯的話 adk web 會回 500,log 裡是 ValueError: Model xxx not found.(Day 23 會細講 Native Audio 與 Half-Cascade 兩種模型架構的差異)。
.env 設定跟平台選擇綁在一起。用 AI Studio 的話,先去 Google AI Studio 按 Create API key 拿一把(免費額度足夠跑完今天的範例),貼進 .env:
GOOGLE_GENAI_USE_ENTERPRISE=FALSE
GOOGLE_API_KEY=PASTE_YOUR_ACTUAL_API_KEY_HERE
用 Agent Platform 的前置作業比較多:要有一個 Google Cloud 專案、裝好 gcloud CLI、跑 gcloud auth login、再到 Console 啟用 Agent Platform(aiplatform)API。第一次碰 GCP 的話這段會花掉你半小時以上,想快點聽到聲音就先用上面的 AI Studio 路線。
GOOGLE_GENAI_USE_ENTERPRISE=TRUE
GOOGLE_CLOUD_PROJECT=PASTE_YOUR_ACTUAL_PROJECT_ID
GOOGLE_CLOUD_LOCATION=us-central1
你在網路上會看到很多教學寫 GOOGLE_GENAI_USE_VERTEXAI,那是舊名,現在還能用但會噴 deprecation warning,GOOGLE_GENAI_USE_ENTERPRISE 是目前的正式名稱。
跑之前有一個容易被忽略的小步驟——設定 SSL_CERT_FILE,語音跟視訊測試都需要它。macOS/Linux:
export SSL_CERT_FILE=$(python3 -m certifi)
Windows PowerShell 要用另一種寫法:
$env:SSL_CERT_FILE = (python3 -m certifi)
Windows 使用者如果 adk web 噴 _make_subprocess_transport NotImplementedError,改用 adk web --no-reload。
然後跟平常一樣啟動 dev UI:
cd app
adk web
提醒一下,adk web 只是開發用的 dev UI,別直接拿去接正式流量。
打開瀏覽器(http://127.0.0.1:8000),選 google_search_agent,重新整理一次頁面,再點麥克風圖示啟用語音輸入,問「What is the weather in New York?」——你會聽到 agent 用語音即時回答,而且答案是它真的呼叫 google_search 查出來的,不是憑空編的。切換到視訊同樣要先重新整理,再點攝影機圖示,問「What do you see?」,它會描述鏡頭看到的畫面。
注意:native-audio 模型不能同時用文字聊天——adk web 上打字會直接報錯,這不是 bug,是模型架構的限制(Day 23 會解釋為什麼)。
串流(語音/視訊)模式跟平常的文字模式比起來,少了一部分你可能習慣依賴的掛鉤點:
before_model_callback、after_model_callback 這兩個不會被觸發,只有文字模式的 run_async 路徑才會執行它們。before_agent_callback、after_agent_callback)跟 tool callback(before_tool_callback、after_tool_callback)照常運作,LongRunningFunctionTool 和 ExampleTool 也是。SequentialAgent 能接語音;LoopAgent 和 ParallelAgent 接上串流會直接丟出 NotImplementedError。白話講:如果你在 Day 12 的 model callback 裡放了 guardrail(例如過濾模型輸出的敏感字詞),語音模式下這段邏輯根本不會跑。要保住這層防護,就把邏輯搬到 agent callback 或 tool callback。同理,架構裡用了 LoopAgent 或 ParallelAgent 的話,語音功能現在還接不上去。
今天先建立了兩個心智模型:ADK Session 與 Live API session 是分開的,以及四階段生命週期把責任切得很乾淨。你也跑起了第一個能講話、能看鏡頭的 agent——但它用的都是 RunConfig 的預設值。明天要拆開 RunConfig 這個黑盒子:為什麼 session 十分鐘就斷、要不要開 session resumption、context window compression 什麼時候該用、以及一個幾乎所有人上線前都會忽略的成本控管陷阱——max_llm_calls 對 BIDI 串流完全不生效。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術