
主張:A2A 解決的不是「怎麼讓 agent 溝通」,而是「什麼時候真的需要讓 agent 跨網路溝通」——大多數人一開始都用錯了場景。
讀完能做到:判斷一個多 agent 需求該用 A2A 還是 local sub-agent,並說得出至少四個「不該用 A2A」的具體反例。
這兩天你組過的 agent 團隊——委派、共享 session state、context 隔離——全部發生在同一個程序裡。coordinator 跟 subagent 之間的通訊快到你感覺不到延遲,因為那本質上就是記憶體內的函式呼叫。
但如果你想合作的對象是一個獨立的服務,跑在另一台機器、由另一個團隊維護,甚至是用 Java 寫的?這時候 local sub-agent 的模式就完全不適用了——你需要一個跨網路的通訊標準。Agent2Agent(A2A)Protocol(見 a2a-protocol.org)正是為了這個場景設計的開放標準,而且 ADK 已經把它拆成兩個角色,讓你不用自己重新發明一套跨程序的溝通機制。
發起呼叫的那一邊,你面對的是一個叫 RemoteA2aAgent 的代理人——寫法跟你平常接的 local sub-agent 幾乎一樣,內部卻是把每一次互動轉成一次網路請求。被呼叫的那一邊,你的 agent 會被包進一台 A2A Server,對外用標準協定接收請求,再轉交給底下真正在跑的 agent 程式碼。下面這張圖就是這兩個角色實際的關係:
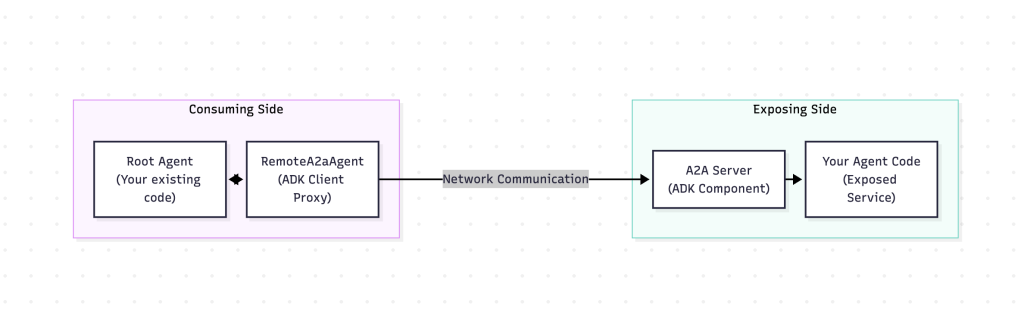
(圖:consuming 端的 RemoteA2aAgent 透過網路呼叫 exposing 端的 A2A Server,底下才是真正在跑的 agent 程式碼。概念取自 Introduction to A2A)
我看過有團隊把一個只做欄位驗證的 DataValidator 拆成獨立的 A2A 服務,理由是「微服務比較乾淨」。結果一次原本在記憶體裡、幾毫秒就跑完的函式呼叫,變成一次 HTTP round-trip 加兩次 JSON 序列化,還多了一個可能在半夜掛掉、需要你起床處理的服務。判斷該不該跨網路,比學會怎麼跨網路更重要。
Local Sub-Agents:在同一個應用程序內執行,像內部模組或函式庫,用來把程式碼組織成邏輯上可重用的元件。溝通直接發生在記憶體裡,沒有網路開銷。
Remote Agents(A2A):獨立執行的服務,透過網路溝通,A2A 定義了這層溝通的標準協定。
官方給的具體例子涵蓋四種場景:
官方文件點名了四種常見誤用,拆成 A2A 反而不划算:
DataValidator sub-agent)——這種情境用 local sub-agent 效能與簡潔度都更好。RealTimeAnalytics sub-agent)。ADK 把 A2A 協定的實作細節抽象成兩個核心概念:
to_a2a(),它把 agent 包成一個 Starlette app,再交給 uvicorn 服務起來;「A2A Server」是官方文件用來稱呼這台伺服器的概念名詞,不是一個你能 import 的類別。RemoteA2aAgent 的元件當 client,它知道怎麼跟你剛剛暴露出來的服務溝通,底層的網路通訊、認證、資料格式轉換全部被抽象掉。從開發者的角度看,一旦連接建立好,跟遠端 agent 互動的體驗跟呼叫本地工具或函式幾乎沒有分別——ADK 把網路層藏起來了,讓分散式 agent 系統用起來跟本地系統一樣直覺。
A2A 的核心其實是一份 JSON——Agent Card。它掛在一個固定路徑 /.well-known/agent-card.json 上,是一支 agent 對外的自我介紹:叫什麼名字、會什麼技能(skills)、吃什麼輸入格式(defaultInputModes)、支不支援串流(capabilities)、要透過哪個網址與哪種傳輸協定跟它說話(supportedInterfaces)。用 to_a2a() 暴露 agent 時,ADK 會自動從你的 agent 程式碼(工具、描述、模型設定)產生這份卡片,不用自己手刻。
Day 20 你會親手跑起官方那個會滾骰子、check 質數的 hello_world_agent,逐字節錄一份實際拿到的卡片:
{
    "name": "hello_world_agent",
    "description": "hello world agent that can roll a dice of 8 sides and check prime numbers.",
    "supportedInterfaces": [
        {
            "url": "http://localhost:8001",
            "protocolBinding": "JSONRPC",
            "protocolVersion": "1.0"
        }
    ],
    "version": "0.0.1",
    "capabilities": {
        "streaming": false,
        "pushNotifications": false
    },
    "defaultInputModes": ["text/plain"],
    "defaultOutputModes": ["text/plain"],
    "skills": [
        { "id": "hello_world_agent", "name": "model", "tags": ["llm"] },
        { "id": "hello_world_agent-roll_die", "name": "roll_die", "tags": ["llm", "tools"] },
        { "id": "hello_world_agent-check_prime", "name": "check_prime", "tags": ["llm", "tools"] }
    ]
}
Consuming 端的 RemoteA2aAgent 要接上一支遠端 agent,第一步就是去抓這份卡片——抓到之後才知道該怎麼發請求、對方能不能做你要它做的事。這就是為什麼 A2A 敢說自己是「正式契約」:能力清單是機器可讀的 JSON,不是寫在 README 裡靠人工對齊。
ADK 的 A2A 整合針對複雜的 agent 系統提供三項能力保證:
假設你有一個 Customer Service Agent,需要向一個獨立的 Product Catalog Agent 查詢產品資訊。
在還沒導入 A2A 之前,如果 Product Catalog Agent 是一個由別的團隊維護的獨立服務,Customer Service Agent 沒有一個標準、直接的方式去查詢它。導入 A2A 之後,Product Catalog Agent 透過 A2A Server 把自己的能力暴露成一個服務,Customer Service Agent 則透過 RemoteA2aAgent 消費這個服務——用起來就像呼叫一個工具一樣自然,ADK 把底層通訊全部處理掉。這種設計讓職責分離清楚,也讓專職 agent 的整合變得容易。
進到實作層,ADK 把 A2A 拆成兩條獨立的學習路徑:
A2aAgentExecutor 修掉 A2A 與 ADK 同時開串流時的三個老問題:使用者訊息在 task history 裡重複、遠端 agent 的輸出被誤判成 thought、巢狀 sub-agent 的輸出遺失。踩到這三個症狀再回頭查它就好。這兩條路徑不是二選一,大多數真實系統兩者都會用到:你可能同時暴露自己的某個 agent 給別人用,又消費另一個團隊暴露出來的服務。
理論講完了,Day 20 直接動手:先把一支 agent 用 to_a2a() 暴露成 A2A 服務,再從另一支 agent 用 RemoteA2aAgent 把它接起來——包含官方範例裡那個會滾骰子、check 質數的完整雙 agent demo。動手前先說一句:A2A 的元件不在 google-adk 的預設安裝裡,第一步會是 pip install "google-adk[a2a]"。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術