
讀完能做到:幫 agent 掛上模型端 context caching 並讀懂它有沒有真的命中,也知道二進位資料(檔案、圖片、音訊)為什麼不該塞進 session state,該用 Artifacts 搭配 lazy loading 來管理。
Day 10 講的 Context Compaction,處理的是「舊的對話怎麼變小」。今天要講的 Context Caching,處理的是另一半問題:如果同一段長 instruction、同一批大型資料集,會在多次請求裡重複出現,有沒有辦法讓模型端直接記住這段內容,不用每次都整包重新傳送?官方原話講得很直接——每次都重傳這份資料「slow, inefficient, and can be expensive」,用 context caching 能明顯加快回應、降低每次請求送進模型的 token 量。
需要 Gemini 2.0 以上的模型。跟 Day 10 的壓縮設定一樣,這個功能掛在 App 物件層級,用 ContextCacheConfig:
from google.adk import Agent
from google.adk.apps.app import App
from google.adk.agents.context_cache_config import ContextCacheConfig

root_agent = Agent(
    name="my_caching_agent",
    model="gemini-flash-latest",  # Gemini 2.0 以上才支援 context caching
)

app = App(
    name='my-caching-agent-app',
    root_agent=root_agent,
    context_cache_config=ContextCacheConfig(
        min_tokens=2048,    # 低於這個 token 數不快取
        ttl_seconds=600,    # 快取存活 10 分鐘
        cache_intervals=5,  # 同一份快取最多重用 5 次
    ),
)
官方範例原本把 root_agent 寫成 # configure an agent using Gemini 2.0 or higher 這樣的留白註解,是為了把焦點放在 ContextCacheConfig 上——但照抄那段執行會因為缺 name/model 丟出 pydantic 的 ValidationError: name Field required,這裡補上最小可執行的 name/model 讓範例能直接跑;你自己接上的話,換成前幾天建好的 agent 設定即可。
四個參數連同官方預設值一起記下來:
min_tokens(預設 0):低於這個 token 數的請求不快取,因為快取本身有建立開銷,太小的請求快取反而更慢。ttl_seconds(預設 1800,30 分鐘):快取存活多久。cache_intervals(預設 10):同一份快取內容最多被重用幾次,即使 TTL 還沒到期,用滿次數也會失效。create_http_options:設定建立快取那次呼叫的 timeout,逾時就直接失敗、改走不快取的路徑,不會讓整個請求卡住。usage_metadata官方 cache_analysis 範例示範了 Python 端怎麼確認快取有沒有真的命中:看 event 的 usage_metadata,cached_content_token_count 是不是非 0:
if event.usage_metadata:
    if event.usage_metadata.cached_content_token_count:
        # 非 0 代表這次請求命中了快取
        ...
該範例的 README 講得更直接:「Successful cache hits are indicated by non-zero cached_content_token_count values.」如果這個值一直是 0,官方列的排查順序是:模型名稱是否打對、內容是否達到 min_tokens 門檻(該範例設的是 4096)、以及是不是透過 App 設定(而不是把 agent 單獨拿去跑,跳過了 App 這層)。
如果你的需求是「整個 session 都要用同一段固定指令」,官方建議改用 agent 的 static_instruction 參數,而不是硬靠 context caching 去湊——這是兩個不同層次的最佳化,caching 針對的是重複內容的傳輸成本,static_instruction 針對的是指令本身的組織方式。範例可參考 adk-python repo 的 contributing/samples/context_management/static_instruction。
Day 9 講過一句話——state 是輕量 key-value store,大型資料不該塞進去。那大型資料該放哪?答案是 Artifacts。它是 ADK 管理具名、有版本的二進位資料的機制,讓 agent 跟工具能處理純文字之外的東西——檔案、圖片、音訊——而不是只能傳字串。支援 Python v0.1.0 起。
一個 Artifact 本質上是一段二進位資料,在特定作用域(session 或 user)內由一個唯一的 filename 字串識別。作用域由檔名格式決定:一般檔名(如 "report.pdf")預設綁在當前 session,只有那個 session 存取得到;檔名加上 "user:" 前綴(如 "user:profile.png")就會綁在使用者身上,該使用者的任何 session 都能存取。
每次用同一個檔名存檔都會建立一個新版本——這代表 Artifacts 天生支援版本追蹤,不用自己額外做版本號管理。統一用標準的 google.genai.types.Part 物件表示,跟 LLM 訊息的 part 用同一種結構:
import google.genai.types as types

image_bytes = b'\x89PNG\r\n\x1a\n...'

image_artifact = types.Part(
    inline_data=types.Blob(
        mime_type="image/png",
        data=image_bytes
    )
)
mime_type 不是裝飾用的欄位——它是日後正確解讀這份資料的必要資訊。Artifact 不會直接存在 agent 或 session state 裡,它的儲存與取回由一個獨立的 Artifact Service 負責(BaseArtifactService 的實作),常見的有 InMemoryArtifactService(測試或暫時儲存)與 GcsArtifactService(用 Google Cloud Storage 做持久儲存,版本控管由服務實作自動處理)。
存取 Artifact 的方法都掛在 CallbackContext/ToolContext 上:
save_artifact:存檔,同一個檔名再存一次就是新版本。load_artifact:讀檔,預設讀最新版本,也可以指定版本號。list_artifacts:列出目前作用域內有哪些檔名。delete_artifact 只存在於底層的 artifact_service 物件上,要拿到 artifact_service 本身才能呼叫。⚠️ 用這幾個方法之前,Runner 一定要先掛好 artifact_service(例如 Runner(..., artifact_service=InMemoryArtifactService())),沒掛的話呼叫時會直接丟 ValueError: Artifact service is not initialized.——這是官方文件明講的必要條件,不是選用設定。
LoadArtifactsTool:Lazy Loading 的實作這裡要接回 Day 10 的主題——如果 artifact 本身很大(比如一份完整的分析報告,或使用者之前上傳的一份文件),你當然不會想把它整份塞進每次送給模型的 context 裡,那等於是把 Context Compaction 好不容易省下來的空間又整份還回去。
ADK 的解法是 LoadArtifactsTool:讓 agent 自己決定何時要把某個 artifact 真正載入 context——預設狀態下 artifact 不會出現在 context 裡,只有 agent 判斷需要用到它的內容時,才主動呼叫這個工具把它載進來。這正是「lazy loading」這個詞在 ADK 語境下的具體實作,而不是一個抽象概念。
from google.adk.agents import LlmAgent
from google.adk.tools.load_artifacts_tool import LoadArtifactsTool

root_agent = LlmAgent(
    name="artifact_reader",
    model="gemini-flash-latest",
    instruction=(
        "Answer questions about available user files. "
        "Call load_artifacts before answering when you need file contents."
    ),
    tools=[
        LoadArtifactsTool(),
    ],
)
同樣要提醒:這個 agent 掛的 Runner 也必須配置 artifact_service,否則 artifact 的列出與載入都會失敗。
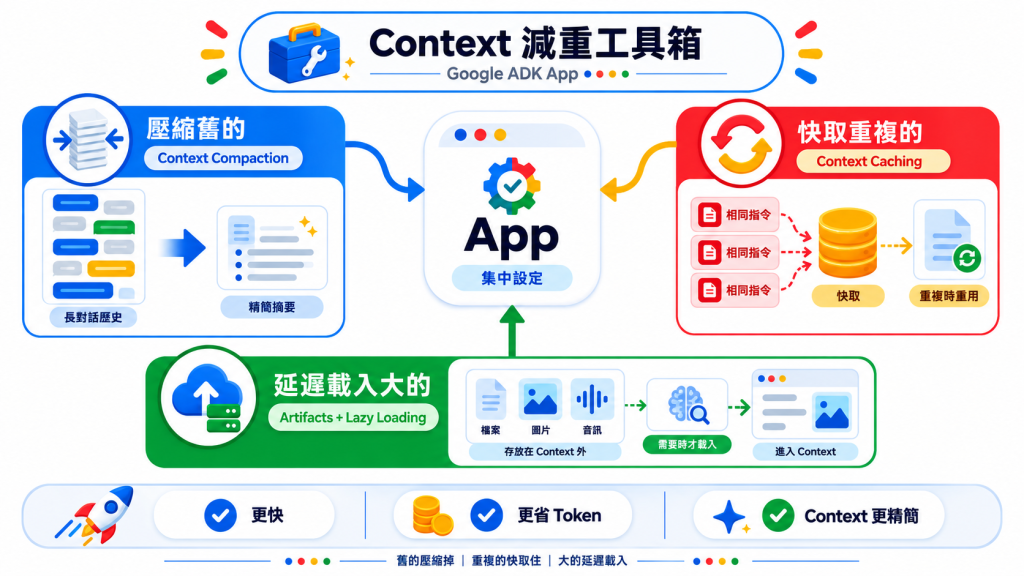
今天把 Context Caching 跟 Artifacts 放在同一天,不是因為它們功能相似,而是因為它們解決的是同一個更大問題的兩個面向——「怎麼在不犧牲功能的前提下,讓 context 保持精簡」。Caching 處理的是「重複的東西不要重傳」,Artifacts 搭配 lazy loading 處理的是「大的東西不要常駐在 context 裡」。這兩個機制加上 Day 10 的 Compaction,構成了 ADK 在 token 成本這條戰線上的完整武器庫:舊的壓縮掉、重複的快取住、大的延遲載入。
三個機制的共通點也值得記下來——全部都是掛在 App 這個容器物件上,而不是分散在各個 agent 裡,這也是為什麼 App 官方定位成「集中設定」的一個具體例子。
省 token 的武器庫講完了,接下來要換一個角度——不是「怎麼讓 context 變小」,而是「agent 內部的執行流程,究竟是靠什麼在串起來」。明天進入第二篇的收尾:Callbacks、Events 與 Plugins,這三者是 ADK 2.0 之後注入自訂邏輯的正式管道。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術