
讀完能做到:知道要在哪個掛載點攔截 agent 行為、看懂一個 event 到底代表什麼、以及為什麼做安全 guardrail 時官方建議你用 Plugin 而不是 Callback。這是第二篇「裝備升級」的最後一天,也是理解後面所有多 agent 編排的地基。
前六天講了工具、MCP、grounding、session、context 最佳化——但這些東西怎麼串起來,變成一個真正在跑的 agent 系統?答案是:session 裡發生的每一件事,都是一個 Event。使用者的訊息是 event、agent 的回覆是 event、工具呼叫是 event、連 state 或 artifact 的更新都是包在一個 event 裡發生的。
理解這一點,是理解 ADK 2.0 之後整個 graph 執行引擎的前提——event 是整個系統狀態一致性的唯一真相來源。下一節會看到,這條原則具體落實成一條規則:連 state 變更本身,都要包在 event 裡才算數。
概念上,Event 是 LlmResponse 的擴充——除了回應內容本身,還加了幾個 ADK 專屬欄位:
author:誰發的,'user' 或 agent 名稱invocation_id:標記整輪互動(同一次使用者輸入觸發的所有 event——包含中間的工具呼叫、模型回應——共用同一個 invocation_id)id:這個 event 自己的唯一識別碼timestamp:發生時間actions:EventActions,管副作用與控制流——待會會看到,這個欄位才是真正有戲的地方branch:階層路徑(多 agent 樹狀結構裡,標記這個 event 是從哪一條 agent 路徑產生的,例如 root_agent.sub_agent)官方文件用四個實用問題當骨架,教你怎麼「讀」一個 event:
is_final_response()
最後那一項官方建議直接用 helper,不要自己重造判斷邏輯——串流輸出(partial=True)跟工具呼叫的中繼結果,都會讓「這是不是最後一句話」變得沒有表面上看起來那麼直觀。
實際的 event 長什麼樣,看幾個典型例子最快:
| 這是什麼 event | 認出它的特徵 |
|---|---|
| 使用者輸入 | actions 通常是空的 |
| agent 最終文字回應 | partial 為 false 或 None;turn_complete 只有串流模式才會是 true,非串流模式通常是 None |
| 串流中的文字片段 | partial: true,後面接一串同樣標記的 event |
| 工具呼叫請求 | content.parts 裡放的是 function_call |
| 純 state/artifact 更新 | content 甚至可能是 null,只靠 actions.state_delta 或 artifact_delta 傳遞資訊 |
| agent 之間的責任轉移 | actions.transfer_to_agent |
LoopAgent(會重複執行子 agent 直到滿足條件的內建 workflow agent,第三篇會展開)裡子 agent 想跳出迴圈 |
actions.escalate: true |
實務提醒:非串流模式下 partial、turn_complete 常常是 None 而不是 False/True,直接寫 if event.turn_complete: 容易誤判成「還沒結束」。判斷是不是最終回應,一律用前面提到的 event.is_final_response() helper,不要自己比對這兩個欄位。
表格最後兩列值得多停留一下,因為那兩個欄位不是只有框架會設——Day 6 的工具函式,透過 tool_context.actions,可以直接自己設定它們:
tool_context.actions.transfer_to_agent = "support_agent":偵測到某個確定性條件(例如查詢裡出現「緊急」關鍵字)時直接觸發轉移,完全不用等模型自己生成一次 transfer_to_agent 的 function call。tool_context.actions.escalate = True:LoopAgent 裡的工具可以直接喊停,比靠一個獨立的 LLM 檢查 agent 判斷「該不該停」更確定,也更省一次模型呼叫。這正是貫穿這三十天的那條線——什麼交給模型決定、什麼用確定性程式碼鎖死——在事件系統這一層的具體切入點。
驅動這一切的心跳是 Event Loop,分工很清楚:Runner 是 orchestrator,管理整體執行流程;執行邏輯(Agent、Tool、Callback)負責做事,做完之後 yield 出一個 event。官方用 yield / pause / resume 的循環描述這個過程——執行邏輯把 event 交給 Runner,Runner 負責持久化、狀態提交、路由到下一步,再把控制權交還。
Day 1 提過 ADK 2.0 之後禁止手動 append event——精確地說,是 graph 節點不能自己把 event 塞進 session,必須把 event yield 出來,交由框架呼叫 SessionService.append_event。append_event 這個方法本身仍然公開存在,只是呼叫它的人從「你的節點程式碼」變成了「框架」,這條界線正是接下來狀態一致性討論的關鍵。
這裡有一個新手很容易誤解、但寫過生產程式碼就會踩到的細節:透過 CallbackContext 或 ToolContext 改的 state,不會立即生效(Python v2.8.0 實測這兩個名字已經統一成同一個 Context 類別,CallbackContext/ToolContext 只是保留下來的別名;官方文件仍把它們當兩個獨立型別描述,這裡先沿用文件寫法,實際寫程式時不用擔心要記兩套 API)。它走的是這條路:
EventActions.state_delta
SessionService.append_event 讀到這個 event,才真正套用到持久化儲存也就是說,狀態變更永遠是跟著 event 串流按時間順序記錄的,不是你一改就馬上落地。這也是為什麼繞過 event 系統、直接改 session 物件的 state 會被官方明確警告——那筆變更根本不會被記錄成任何 event,之後排查問題時完全對不上時間軸。
連帶的還有 "dirty reads"(借用資料庫的講法:讀到別人還沒 commit 的資料):同一個 invocation 內,可能讀到尚未提交的 state 變更。寫 ParallelAgent(讓多個子 agent 平行執行的內建 workflow agent,同樣留到第三篇展開)這類並行流程時,這個行為會直接影響你的邏輯是否正確——如果你以為兩個平行分支之間可以即時看到彼此剛寫入的 state,實際跑起來很可能不是這樣。
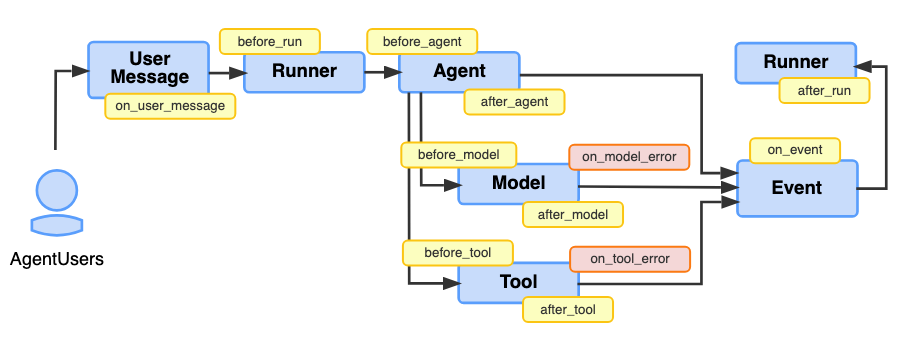
Callbacks 是掛在 agent 執行生命週期特定時點的自訂函式,用來觀察、修改、或直接攔截 agent 行為。核心掛載點分三類:
| 類別 | Callback |
|---|---|
| Agent 生命週期 | before_agent_callback、after_agent_callback |
| LLM 互動 | before_model_callback、after_model_callback |
| 工具執行 | before_tool_callback、after_tool_callback |
除了這六個,LlmAgent 還多了 on_model_error_callback 與 on_tool_error_callback 兩個錯誤處理掛載點——遇到模型或工具丟例外時觸發
來源:官網
Agent 層的兩個包住「整個請求處理過程」——從收到輸入到產出最終答案,中間所有的模型呼叫、工具呼叫全都在裡面。一個 before_model_callback 的實際簽章長這樣:
from google.adk.agents import LlmAgent
from google.adk.agents.callback_context import CallbackContext
from google.adk.models import LlmResponse, LlmRequest
from typing import Optional

def simple_before_model_modifier(
    callback_context: CallbackContext, llm_request: LlmRequest
) -> Optional[LlmResponse]:
    """Inspects/modifies the LLM request or skips the call."""
    agent_name = callback_context.agent_name
    last_user_message = ""
    if llm_request.contents and llm_request.contents[-1].role == 'user':
         if llm_request.contents[-1].parts:
            last_user_message = llm_request.contents[-1].parts[0].text
    # ... 檢查/修改 llm_request,或回傳一個 LlmResponse 直接跳過這次模型呼叫 ...
callback_context、llm_request 這兩個參數名不能隨意更改——ADK 是用 keyword argument 呼叫 callback 的,改了名字會在執行期直接噴 TypeError: got an unexpected keyword argument(實測於 Python v2.8.0)。掛上這個 callback 本身很直接:把它指定給 LlmAgent(before_model_callback=simple_before_model_modifier, ...) 就是掛載動作,其他五個掛載點是同一套指定方式。
這個回傳值的設計值得注意——before_model_callback 如果回傳一個 LlmResponse,框架就會直接用這個回應,完全跳過真正的模型呼叫。這是做快取、做內容安全過濾(發現違規內容直接擋掉,不用真的把它送去給模型)最直接的切入點;before_tool_callback 也是同樣的模式,可以在工具真正執行之前攔截並改變行為。
這個特性有個附帶好處:只要 before_model_callback 回傳了 LlmResponse,整個流程完全不會碰到真正的模型——想先動手驗證 guardrail 邏輯本身,不需要 API key、不需要登入 GCP,本機就能跑通。
這裡有一個真的會讓人抓頭的地雷,藏在 after_agent_callback 裡。三個 after_ callback 看起來是同一套模式,回傳非 None 的值時語意卻不一樣:
| Callback | 回傳非 None 的語意 |
|---|---|
after_model_callback |
取代原本的 LlmResponse |
after_tool_callback |
取代原本的工具結果 |
after_agent_callback |
附加在 agent 輸出之後,多出一個 event |
差別就卡在最後一列。如果你抱著「取代」的直覺,把 agent 剛產生的結果原封不動 return 回去——想著「反正沒改,這樣應該等於什麼都沒做」——Python 端會因此多發出一個內容一模一樣的重複 event,使用者畫面上就會看到同一句話被講兩次。
正確的「什麼都不做」寫法只有一種:return None。
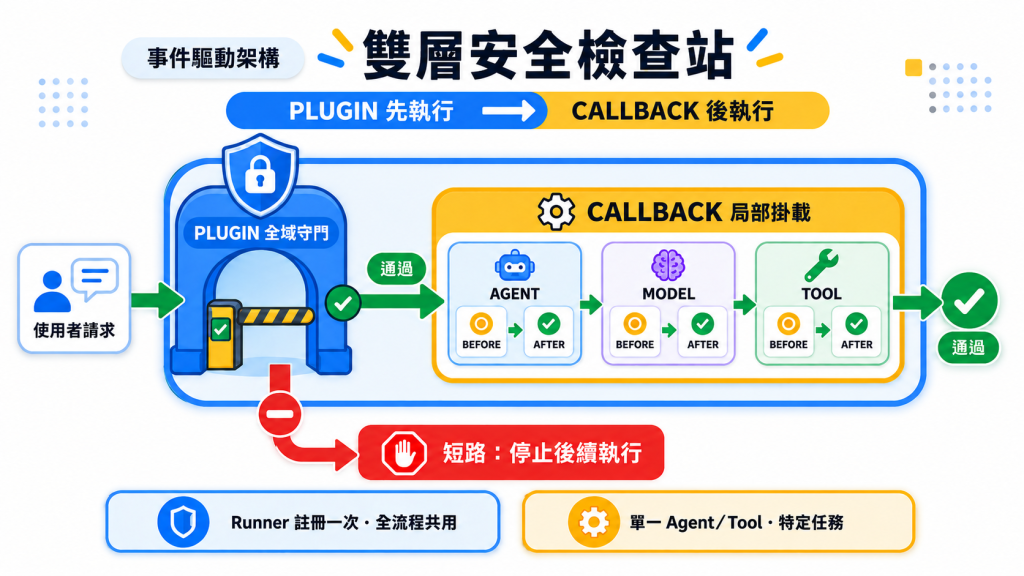
Plugin 是一段自訂程式碼模組,透過 callback 掛鉤在 agent workflow 生命週期的各個階段被執行,用在適用於整個 agent workflow 的功能上。
Plugin 建立在 Callback 之上——這是 ADK 可擴充架構的關鍵設計元素。兩者的差異有兩層:第一層是作用範圍——一般的 Agent Callback 是設定在單一 agent、單一工具、針對特定任務的;Plugin 則是在 Runner(或透過 App 帶入,見下方範例)上註冊一次,它的 callback 就全域套用到那個 runner 管理的每一個 agent、工具、LLM 呼叫。第二層是掛載點的數量——Plugin 除了跟 Agent Callback 同名的那幾個,還多出 before_run_callback、after_run_callback、on_user_message_callback、on_event_callback、on_agent_error_callback、on_run_error_callback 這類 Agent Callback 沒有的 hook。其中 on_event_callback 特別值得點名——它在每個 event 要被串流給 client 之前觸發,讓你能直接修改 event 本身,是這篇「事件驅動架構」裡唯一一個直接對 event 動手的掛載點。這些差異決定了兩者的自然分工——需要「只在這個 agent 這樣做」時用 Callback,需要「整個系統一致地這樣做」時用 Plugin。
官方給的典型應用有五類:
前兩類官方已經有現成品可以直接掛,不用自己寫:LoggingPlugin 與 BigQueryAgentAnalyticsPlugin。想看每個掛載點實際觸發的順序,Runner(..., plugins=[LoggingPlugin()]) 一行就夠了——這也是理解今天整篇「執行順序」最快的驗證方法。
官方明確給了一個提示(Tip):實作安全 guardrail 與政策時,用 Plugin 比用 Callback 更模組化、更有彈性——這句話值得特別記住,因為很多人的直覺是「先加個 callback 應付一下」,結果後來發現同樣的邏輯要在十個 agent 裡各貼一次,這時候才想到應該一開始就用 Plugin。
有一件事在 ADK 2.0 之後從「有幫助」變成「唯一正式管道」——用 Plugin 跟 Callback 做橫切關注點(cross-cutting concerns),已經不是錦上添花的選配功能,而是官方認可、注入自訂執行邏輯的正式方式,因為 2.0 的 graph engine 對「誰能改 event、誰能改流程」的掌控比 1.0 版本嚴格得多。
想自己寫一個 Plugin,最小骨架長這樣(繼承 BasePlugin,方法一律要 async def、參數是 keyword-only,實測可跑於 Python v2.8.0):
from google.adk.plugins.base_plugin import BasePlugin

class PolicyPlugin(BasePlugin):
    async def before_tool_callback(self, *, tool, tool_args, tool_context):
        if tool.name == "delete_user":
            return {"error": "沒有權限"}  # 回傳非 None 就直接擋下,工具本體不會執行
        return None
註冊時掛到 Runner(..., plugins=[PolicyPlugin(name="policy")])。
一個官方打包好、可以直接掛的例子:ReflectAndRetryToolPlugin(Python v1.16.0 / Go v0.5.0)。工具呼叫失敗時攔截錯誤、把結構化錯誤說明回饋給模型讓它反思修正,再自動重試到上限。以下範例假設你前面已經有一個 root_agent(例如 Day 3 建的那個):
from google.adk.apps.app import App
from google.adk.plugins import ReflectAndRetryToolPlugin

app = App(
    name="my_app",
    root_agent=root_agent,
    plugins=[ReflectAndRetryToolPlugin(max_retries=3)],
)
這正好補上前面「ADK 2.0 自動攔截例外以支援自動重試」這句話缺的另一半——RetryConfig 只負責「要不要重試」,這個 plugin 負責「讓模型知道上次錯在哪、下次該怎麼改」。
順帶一提,Plugin 不只能掛在 App 上,也可以直接掛在 Runner(plugins=[...])——兩種寫法都有效,前面「在 Runner 上註冊一次」講的是機制本身,App 只是另一個能把 plugins=[...] 帶進去的入口。
這是這篇文章最值得記住的一句話:Plugin 的 callback 一律先於物件層(agent/tool)的 callback 執行,而且會短路後者。如果一個 Plugin 的 before_tool_callback 已經回傳了結果(例如判斷使用者沒有權限,直接擋下來),那麼這個工具自己定義的 before_tool_callback 根本不會被執行。這個順序邏輯是設計出來支撐「Plugin 適合做全域政策執行」這個定位的——政策層要能夠真正擋住底下的行為,而不是被個別 agent 的 callback 繞過去,順序上就必須是 Plugin 先跑。
第二篇「裝備升級」到今天走完七天:工具、MCP/OpenAPI、Grounding、Sessions、Context 壓縮、Caching 與 Artifacts,最後用 Callbacks/Events/Plugins 把整個執行模型串起來。這七天累積的東西,是接下來第三篇「戰術編排」的地基——從 Graph Workflows 開始,你會看到今天講的 Event、State delta、Plugin 優先序,全部變成理解一個節點怎麼跟另一個節點交接資料的關鍵詞彙。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術