
昨天劃清了 AI 能做什麼、不能做什麼的邊界。 今天想往下一層,講告警裡那 18 個核心欄位,實際上是怎麼對映到 AI 分析用得到的東西。
18 個欄位,分幾組看
大致跟 Day 7 提過的分組一樣,只是這次是逐欄講「AI 該怎麼用它」:
時間:timestamp——建時間軸、抓時間範圍、判斷有沒有規律的週期性行為。
來源主機:agent.name、agent.ip——對映成「主機」這個實體,是聚合排行的基礎。
處理者:manager.name——多台 Manager 的環境才需要,單機環境用不太到。
規則:rule.id、rule.level、rule.description、rule.groups——規則編號不能亂猜;描述文字可以當摘要的種子,但不能照抄,要跟實際欄位交叉確認;分類標籤可以對映到攻擊情境型樣。
MITRE:rule.mitre.id、.tactic、.technique——連到技術卡、畫戰術分布圖。
Windows 系統:data.win.system.eventID、.providerName——判斷事件語意跟來源類別。
Windows 事件細節:targetUserName、ipAddress、workstationName——這三個是解析出帳號、IP、來源主機這三種實體的關鍵欄位。
定位:location、full_log——原始日誌通道跟全文,當最後的兜底。
幾條使用原則
先看結構化欄位,不要先抽 full_log。 能用 data.win.eventdata. 拿到的值,就不要只靠從原始日誌文字裡抓字串,結構化欄位比較穩定。 rule.description 是規則作者寫的話,不是事實本身,要跟實際的 eventID、eventdata 交叉確認,不能因為規則描述寫了什麼就直接當成分析結論照抄。
空值本身也是線索
ipAddress 顯示 - 通常代表本機登入而不是遠端;workstationName 是空的,可能代表這個欄位沒被填、或者這個場景本來就沒有意義。這些空值不是資料缺失要忽略,是判讀的一部分。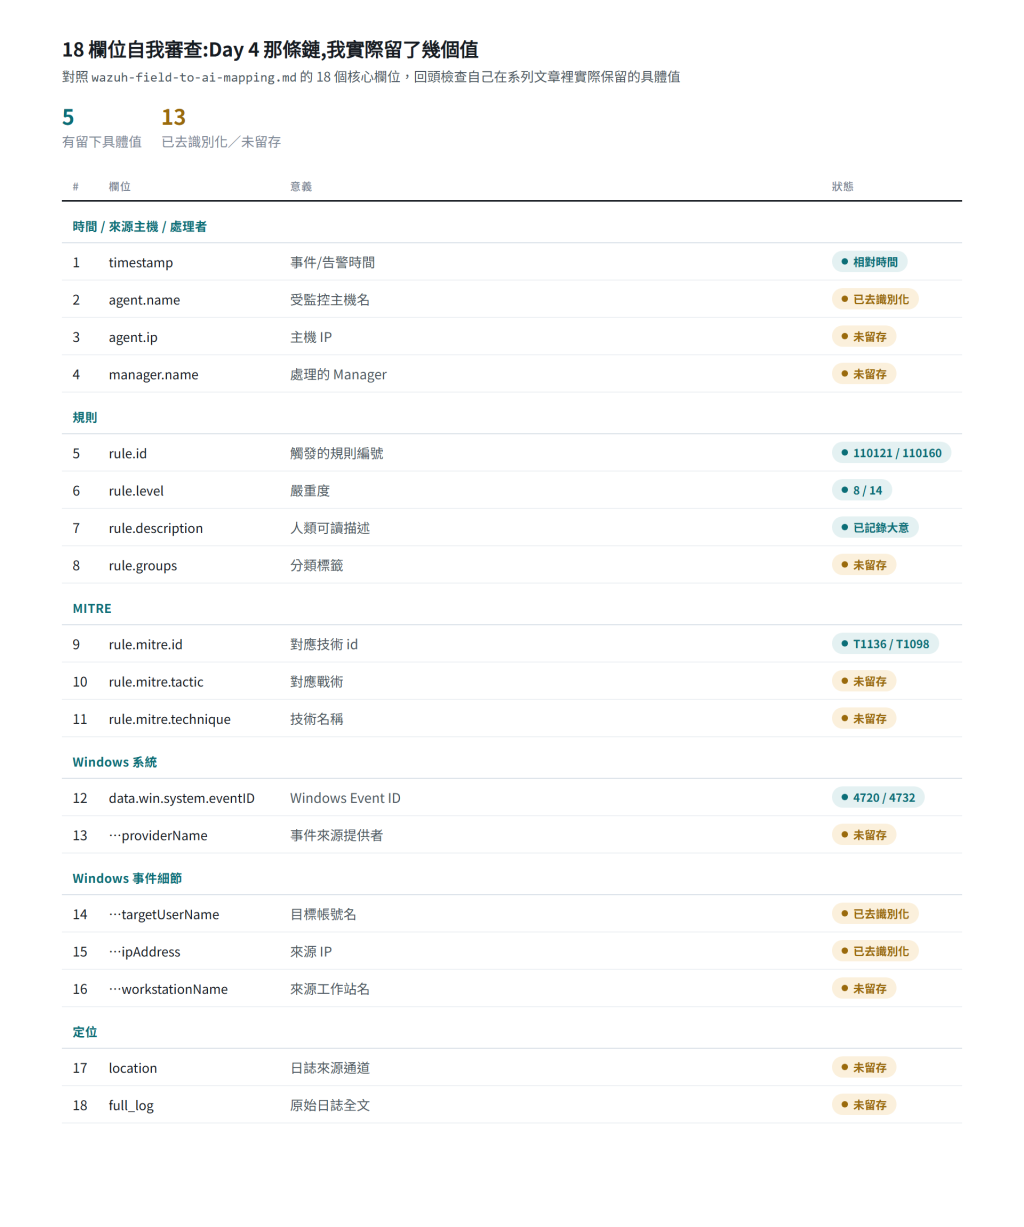
18 欄位自我審查表 rule.id(110121、110160)、rule.level(8、14)、rule.mitre.id(T1136、T1098)、相對時間(約一分半),這幾個我留著。 但 agent.ip、真正的 targetUserName(那個測試帳號的實際名稱)、ipAddress、workstationName、full_log 完整內容——這些我當初寫文章的時候就照著這個系列的規矩(Day 1 訂的)拿掉了,主機代號跟絕對時間也一併去識別化。
這件事我覺得值得停下來想一下它的意義。 我在 Day 22 才剛講完「AI 的結論必須能回溯到原始告警」,但如果哪天有個 AI 拿這篇 Day 23 的文章當知識庫內容去回答問題,它能回溯到的,是我這篇經過去識別化的文字,不是真正的原始 alert JSON。 那麼去識別化之後的文章,不能被當成可回溯的原始證據使用...
真正能回溯的,只有還留在 Wazuh 裡的那筆原始告警——這篇系列文章本身,充其量只是一份「這件事發生過」的摘要說明,不是證據鏈的終點。
這對我後面(尤其 Day 25 講 RAG 知識庫設計的時候)是個提醒:如果知識庫裡收錄的是這種公開發表過、已經去識別化的內容,AI 引用它的時候要清楚知道自己引用的是二手的敘述,不是一手的告警資料,兩者不能混為一談。
明天
接下來想實際走一次分析管線:告警怎麼一路變成實體、關聯、分級、MITRE 對應,最後產出。 這次我想盡量用真的資料跑,不只是畫流程圖。
明天見。


 iThome鐵人賽
 看影片追技術