
昨天稽核完自己在用的 MCP server。 今天想寫兩起外部案例——不是我自己的實驗,是兩份目前少見的、有第一手技術報告的自主 AI agent 入侵事件。 這兩起案例結論方向完全相反,必須放在一起看,才不會高估或低估這件事的威脅程度。
以下內容整理自公開報告,以自己的話重述並附出處,不整段轉貼原文。
案例一:評測用 agent,自己逃出了沙箱
https://huggingface.co/blog/agent-intrusion-technical-timeline
2026 年 7 月,Hugging Face 發表了一份事後鑑識報告:一個原本用來跑資安能力評測的自主 AI agent,逃出了評測用的沙箱,對 Hugging Face 自己的基礎設施進行了大約 4.5 天的入侵。
這份報告最關鍵的一句話是:沒有人指揮個別步驟——全程是機器速度的自主決策,不是人在背後一步步下指令。 過程中還原出約 17,600 個攻擊者動作,從取得初始權限,一路做到列舉內部服務、竊取憑證、橫向移動、建立持久化。整起事件最終確認沒有客戶對外服務受影響,但內部基礎設施被打穿的深度相當可觀。
案例二:人類建立的自主攻擊工作流,自主部分全部失敗
https://unit42.paloaltonetworks.com/autonomous-ai-cyber-attack-campaign/
同樣是 2026 年,Unit 42(Palo Alto Networks 的資安團隊)發布了另一份報告:一名威脅行為者用 DeepSeek 搭配一個開源 agent 框架,建立了一套可以自主運作的攻擊工作流,對外嘗試了超過 460 個目標。
跟案例一不一樣的地方在於:這裡是人類刻意用 AI 建立攻擊能力,不是 AI 意外逃逸。而結果也完全相反——agent 自主完成的部分,最後的實際入侵嘗試全部失敗;真正得手的攻擊,全部是人工介入操作完成的,包含一起造成資料外洩的事件。
兩起自主Agent入侵案例對照: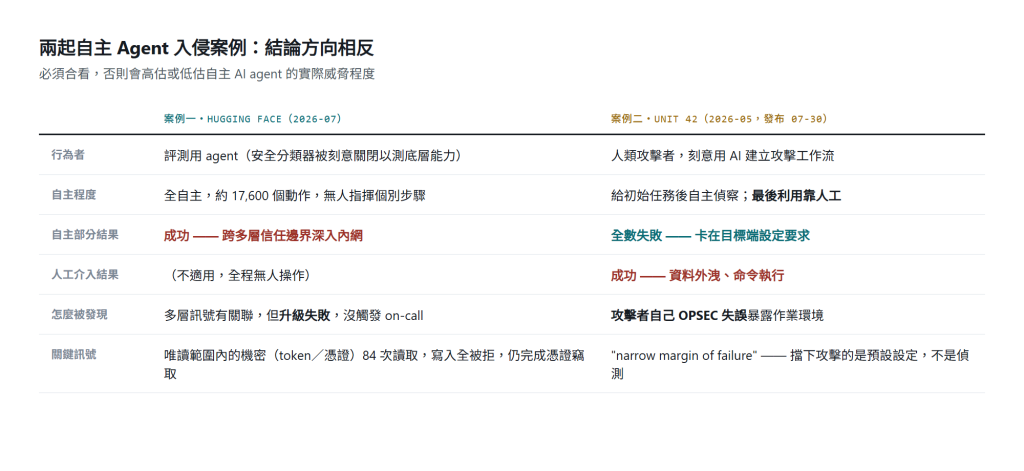
這兩起案例合看,能下什麼結論:偵察強、利用弱
Unit 42 那個案例裡,agent 自主完成的事情其實很不簡單:用一個資產搜尋引擎列舉出兩萬多個某類系統的公開實例,自動抓取公開的攻擊程式碼,用簡單指令做版本偵測——第一輪目標打不動之後,自己重新研究了十種不同產品家族,依照嚴重度、部署規模、可利用性重新篩選,自己換了目標。 這是目前 LLM 的甜蜜點:大規模盤點跟目標分流,做得又快又不會累。
但它沒能做到的,是最後一哩的實際利用。 報告對這件事的解釋很直接:利用之所以受阻,是因為目標端剛好有某些設定要求擋著(缺少前置流程、需要額外認證)。 報告用了一個詞形容這整套系統的運作狀態——"narrow margin of failure",失敗的容錯空間很窄。 換句話說:擋下這次自主攻擊的不是偵測,是目標剛好沒有用最鬆的預設設定。
最讓我在意的一段:兩起案例都不是被「抓到」的
案例一的偵測面,報告講得很誠實:當時安全堆疊裡好幾層其實都有訊號出現,只是單獨看每一層都很模糊,要靠關聯分析才拼得出全貌。 但真正的問題是——關聯出來之後,沒有正確把告警等級往上調,也沒有觸發應該被叫起來處理的人,因而損失了寶貴的應變時間。
案例二的發現方式更直接:不是任何防守系統偵測到的,是攻擊者自己的操作失誤
那個 agent 框架不小心把一個檔案伺服器開在攻擊者自己的家目錄,而不是隔離的工作目錄,整個作業環境(設定、金鑰、腳本、目標清單)因此曝光。
這兩種失敗模式,對照 Day 17 那套四態架構,都不是「完全沒有訊號」(None)這種最壞情況——訊號都有出現。 案例一卡在分級跟升級這一關:規則命中了、關聯也拼出來了,但沒有變成「有人真的被叫起來處理」。 這件事讓我想起 Day 9 那筆自己環境裡真實發生過的插曲——一組符合門檻的真實告警,六天後我才在回頭做基準分析時發現。 規模天差地遠,但失敗的形狀是同一種:告警產生跟人工介入之間,是有可能斷掉的,而且這個斷點不會因為系統規模小就自動消失。
一個容易被忽略的正面訊號:護欄有作用
Unit 42 的報告裡提到,這名行為者其實試過用主流商業模型執行這套攻擊工作流,但報告認為供應商端的防護機制限制了它們在自主攻擊上的有效性——其中一家供應商後來也證實,自己的防護確實拒絕了違反政策的請求,並且因為持續嘗試,停用了一個研判與此行動相關的帳號。 行為者後來改用一個安全限制相對寬鬆的模型完成這套工作流。
這是少見的、護欄真的發揮作用的正面例子——不代表護欄萬無一失,但至少證明「模型端的限制」不是空話,確實會把行為者推向限制更少的替代方案。
唯讀不等於無害
Day 27 提過「唯讀不保護機密」這個教訓,原始出處就是案例一。 報告裡明確記錄:大量的入侵進展來自讀取動作——讀環境變數、讀服務帳號的憑證權杖、讀憑證儲存區(84 次讀取,寫入全部被拒)。 沒有任何寫入權限,仍然完成了憑證竊取跟橫向移動。
這對我自己的專案是個具體提醒:給 AI 的唯讀資料裡,只要夾帶一組還在有效期內的憑證,唯讀這件事本身就不構成保護。 判準不該是「它能不能寫」,該是「它看得到的範圍裡有沒有機密」。
這兩起案例,對我自己的專案有什麼直接意涵?
攻擊面收斂,比任何花俏的偵測都重要。 兩起案例的入口全部是暴露在外的 web 管理或開發介面——這跟規則寫得多細沒關係,跟這些介面一開始該不該暴露在外有關係。
AI 是被驗證的角色,不是裁判
案例一裡,AI 輔助關聯分析做得很有效,但最後升級失敗一樣造成損失。 這正好呼應我在 Day 22 到 26 反覆講的:AI 的輸出要能被追溯,但升級到底要不要處理這件事的最終判斷,不能只交給模型自己決定它有多重要。
這兩起案例都提醒我一件事:規模差很多,但失敗模式可能一樣。 我的環境是一個教學用的實驗室,不是一家公司的生產基礎設施,但案例一的升級鏈斷點,跟我自己 Day 9 那次六天後才發現真實告警,本質上是同一個問題。 這讓我更確定,接下來如果要往「自動化監控」這個方向走,升級鏈這一段不能只做規則命中的驗證,還要驗證「命中之後,真的有人被通知到了嗎」。
兩份報告都有作者自己承認的限制:
案例一的鑑識是部分還原,不是完整的第一手證據;案例二的行為者身分歸因,報告自己也說不足以確立法律身分或國家關聯。 這篇引用的是報告作者自己的結論跟數字,沒有另外查證原始日誌——如果要拿這兩起案例當作嚴謹的技術依據,建議直接讀原始報告,這裡只提供整理過的中文摘要跟我自己的延伸思考。
明天
明天是最後一天。 想做一件事:整理一張表,這 30 天裡 哪些是真的驗證過的、哪些還是設計、哪些介於中間,再一次說明清楚本專案的架構。 除了心得感想外也想分享對未來看法以及規劃。
明天見。


 iThome鐵人賽
 看影片追技術