
昨天測完防幻覺規格,發現一個真實的縫。 今天想講另一件事:把 Wazuh 接給 LLM 用自然語言查詢。
為什麼想做這件事?
Day 3 那張三層架構圖裡,分析層跟 Wazuh 之間本來就有一條「即時證據」的箭頭,但當時是設計上的意圖,沒有實際接上。 這件事我後來真的做了:讓 Codex CLI 透過 MCP(Model Context Protocol)連到 Wazuh,可以直接用自然語言問「這台主機最近有什麼告警」,不用自己開 Dashboard 手動查。
設計上的三層唯讀邊界
接這種東西最讓我在意的問題是:AI 會不會因此拿到超過它該有的權限。 所以設計上疊了三層:
Wazuh 帳號本身唯讀:另外建一個唯讀 API 帳號,不是拿管理員帳號給 AI 用。
MCP 工具面唯讀:選一個本身就不提供任何寫入工具的 MCP server,而不是靠設定去關掉某些功能。
網段限制:MCP 只允許連到 Wazuh Manager 跟 Indexer 的特定連接埠,不碰資料平面本身。
實際採用的是一個開源、Rust 寫的 stdio MCP server,特性是整包工具就是唯讀查詢,沒有任何寫入或 Active Response 的工具存在——這比「設定成唯讀」更保險,因為不是靠一個開關擋著,是這個工具原本就不會寫。
MCP - Model Context Protocol,模型上下文協定是由 Anthropic 於 2024 年底推出的開放標準協定,旨在為大型語言模型(LLM)與外部資料、工具及企業系統之間建立一套標準化的連線方式。
可以把 MCP 想像成 AI 世界的 USB 介面——過去不同的 AI 應用若要連接各種資料庫、檔案或 API,開發團隊都得為此寫死專屬的串接邏輯;而有了 MCP 後,只要工具和 AI 雙方都支援這套標準,就能像插上 USB 一樣安全、快速地互通有無。
真的接起來之後,能查到什麼?
實測 Codex CLI 啟動 MCP 之後,列出來的工具都是查詢類:agent 清單、agent 上跑的程序、告警摘要、規則摘要這類——沒有出現任何寫入或 active response 相關的工具。
用自然語言問過一次「這台主機是不是有可疑行為」,AI 的回答方式我覺得值得記錄:它沒有直接斷定「已入侵」,而是把「可疑檔案落地」「程序存取異常」這類線索串成一條待調查的可能行為鏈,同時明講證據還不夠、需要進一步查哪些欄位。這個語氣正好呼應 Day 26 測出來的那套規則——單一證據弱,不能一步跳到定論。
MCP下指令畫面: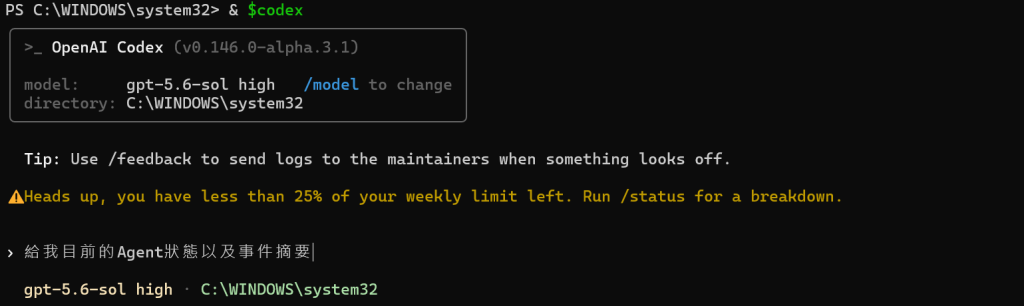
Agents 狀態查詢: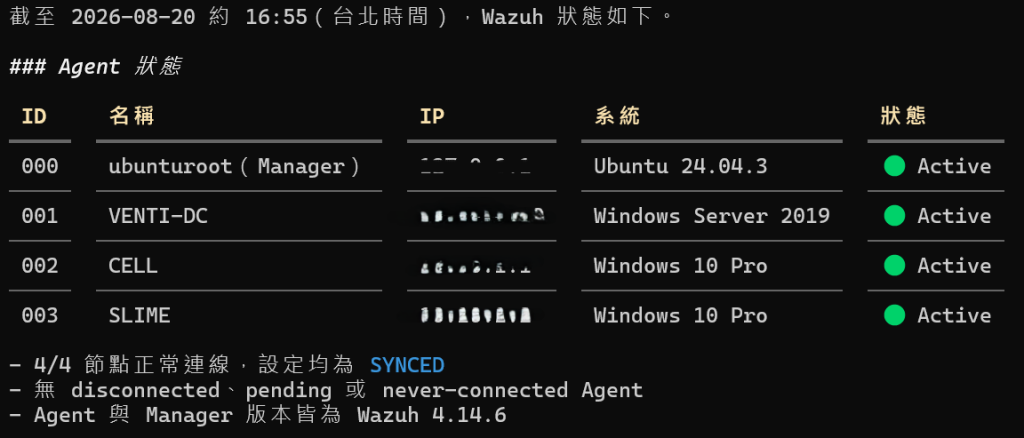
事件分析: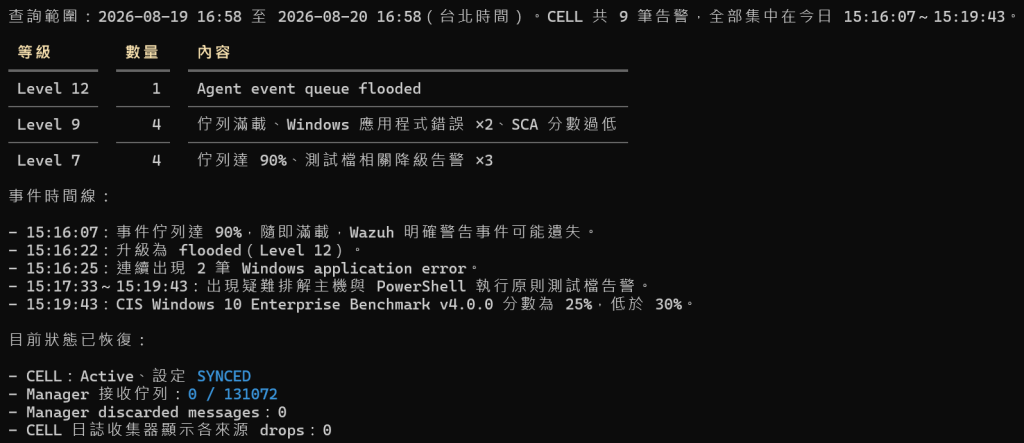
更深一層的教訓:唯讀不保護機密
寫到這裡,想帶進另一起案例給我的提醒(Day 29 會細講)。 那起自主 agent 入侵事件裡,攻擊者幾乎全靠讀取動作就完成了憑證竊取——讀環境變數、讀 service account token、讀憑證儲存區,寫入動作全部被擋下,但這不影響結果。
這件事直接推翻我原本一個沒說出口的假設:我以為「唯讀」主要是防止破壞。 實際上唯讀範圍內如果剛好夾帶著機密——例如告警的 full_log 欄位可能含有帳密——那麼「唯讀」完全不構成保護,它只是換了一種方式讓機密離開它該待的地方。 這代表在把告警內容送進模型之前,理論上應該要先確認 full_log 這類欄位有沒有夾帶敏感內容並先遮蔽——這件事我目前還沒有做...
一個順便發現的架構限制
實作定期自動掃描的時候確認了一件事:MCP 本身完全被動,LLM 也沒有背景計時器,聊天視窗關掉,一切就不存在。「叫它自己每小時查一次」這種指令不會生效,任何真正的「定期自動」都得靠外部排程器去呼叫,MCP 跟 LLM 都只是被呼叫的那一方。 這算是打通自動化過程中一個不算隱晦、但容易被想像力腦補掉的事實。
明天
接下來想稽核我正在用的這個 MCP server 本身——不是它的使用方式,是它的原始碼跟依賴鏈乾不乾淨。
明天見。


 iThome鐵人賽
 看影片追技術