
今天不寫新東西,做三件事:重新把架構講一次、列出這 30 天裡驗證了哪些東西,最後講講心得跟接下來打算怎麼走。
重新講一次架構
這座 SOC 分三層,Day 3 畫過一次圖:蒐集層(Wazuh Agent 採集 Windows/AD 事件,Manager 解碼比對規則產生告警)、分析層(AI 拿告警跟知識庫做摘要、分級、關聯、MITRE 對應)、呈現層(儀表板跟問答介面)。 資料單向往下流,但信任不是單向的——分析層的結論理論上要能回溯到蒐集層的原始告警,這條線 Day 22 講過,Day 26 實際測過。
整體拓譜: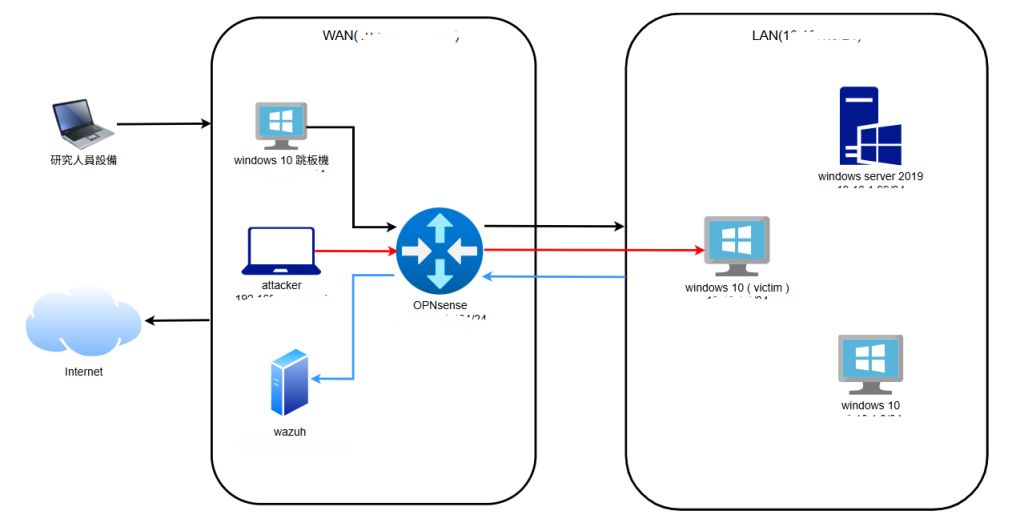
三層關係: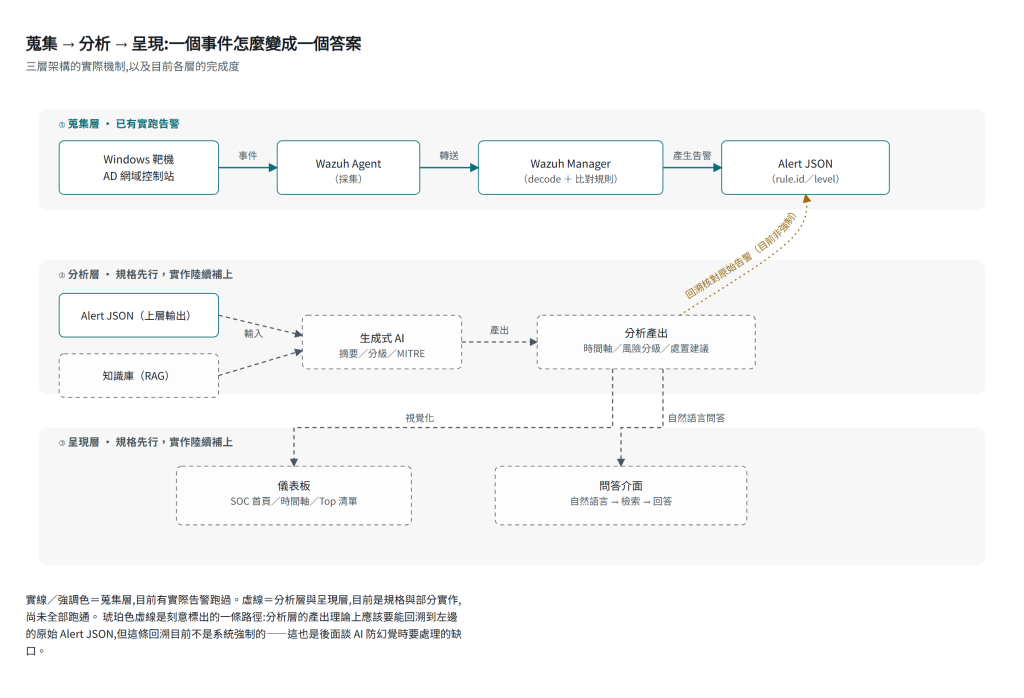
30 天走下來,這三層的完成度不一樣,而且差距比我一開始想的更清楚:蒐集層最扎實,有實際跑過的事件鏈、有真實踩過的坑;分析層在方法論跟防幻覺這一側做得比較深(Day 22-26),但知識庫檢索、分析管線的自動化程度還很低;呈現層目前是 4 個 widget 有做出來。
三層之外,還有一條後來加進來的線:把 Wazuh 接給 LLM 查詢(Day 27-28)。 這條線讓我意識到,前面三層的邊界之外,還有一個新的攻擊面——AI 跟監控系統之間的那條管線本身。
心得:比技術更讓我意外的,是自己的思考習慣被改了
寫這 30 天,技術上學到的東西不少,但真正讓我意外的,是幾件關於「怎麼做這件事」的體會。
1. 先查證再寫,比寫完再修正省事得多
前十天我常常是寫完才發現角度不對(Day 6 的 GPO 路徑、Day 13 的因果鏈)。 後二十天養成習慣,動筆前先回頭讀一次原始文件,好幾次(Day 12、13、15)因此在寫出來之前就抓到排程原本設想跟事實不符的地方。 這個習慣帶來的複利效果,比任何單篇技術內容都值錢。
2. 猜錯的方向不只一種,悲觀跟樂觀都要驗證
Day 9 猜噪音是全面性問題,猜得太樂觀式的悲觀(以為情況更糟);Day 19 猜欄位型別會出錯,猜得太悲觀式的樂觀(以為會出包結果沒有)。 兩次猜錯的方向完全相反,但教訓一樣:猜測終究只是猜測。
3. 同樣的形狀,不一定是同一件事
一開始只覺得這是規則誤判的道理(Day 9 磁碟清理事件),後來發現它也適用在「我以為自己在保護什麼」這個更根本的假設上(Day 19 dashboard 唯一浮出的訊號是監控系統自己)。 這條線索最後在 Day 29 收到最大的迴響——一家公司的生產基礎設施,跟我一個教學用的實驗室,失敗模式是同一種:升級鏈會斷,規模大小不影響這件事發不發生。
4. 真正做過的東西,永遠比設計文件更有說服力
Day 19 做出 4 個 widget、Day 24 跑出一段真實輸出、Day 26 真的測了自己的規格——這幾篇的含金量,不是靠篇幅堆出來的,是靠「這件事真的發生過」堆出來的。 這也是為什麼我後來會建議自己:與其繼續寫更多沒測過的規則,不如先把手上能測的一小塊做完。
對未來的看法:AI 接進防守方,能力邊界比想像中窄,但缺口一樣真實
寫到 Day 29 那兩起外部案例,我對「AI 接進資安領域」這件事的看法,跟開始寫這系列之前不太一樣了。
一開始我比較擔心的是「AI 會不會太強、做出人類做不到的事」,但寫完之後我更擔心的是平凡的失敗模式,會不會因為 AI 的介入而被放大——分級跟升級這一段,不管是人還是 AI 在做決策,只要規則寫得不夠嚴謹,一樣會斷。 唯讀的資料介面,不管是給人看還是給 AI 看,只要裡面夾著機密,防護就一樣沒有意義。
AI 沒有創造新的失敗模式,它只是讓既有的失敗模式跑得更快、更頻繁。 這對防守方來說,不是一個「AI 有多聰明」的問題,是一個「地基打得夠不夠扎實」的老問題,換了一個新的殼。
接下來打算怎麼走?
這 30 天裡真的浮出來、還沒處理的具體項目,按我自己覺得的優先順序排:
最後一句話
30 天前 Day 1 開場用的是一則非攻擊的 Level 12 告警,提醒自己「AI 的判讀不算證據」;30 天後,我覺得這句話應該倒過來再講一次:不管做判讀的是 AI 還是我自己,沒有新鮮證據,就不能做完成宣稱。
謝謝看完這 30 天的你 φ(゜▽゜*)♪


 iThome鐵人賽
 看影片追技術