
主張:graph 跟 dynamic workflow 給的是精細控制,但 multi-agent 編排真正的起點,是三個更基礎的固定積木——
SequentialAgent/ParallelAgent/LoopAgent。九成的多步驟需求,這三個積木就夠用,也是目前跨語言支援最完整的編排手段(Python/TypeScript/Go/Java 四種語言都有)。
讀完能做到:判斷一個多 agent 任務該用哪個模板,並知道LoopAgent為什麼不會自己停下來。
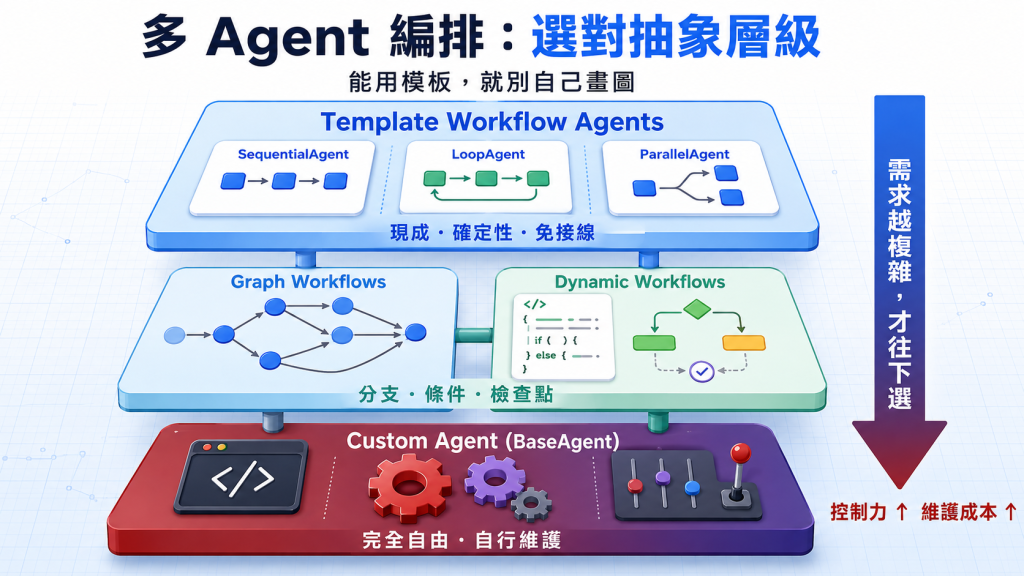
如果把 multi-agent 編排想成一個光譜,graph 跟 dynamic workflow 站在最有彈性、也最需要自己動手設計的一端。白話講:graph 是你自己畫節點(node)跟邊(edge),指定資料怎麼在 agent 之間流動、什麼條件下走哪條分支;dynamic workflow 則乾脆放棄畫圖,改用你熟悉的 if/for 這類程式語言控制流去決定要跑哪個 agent——這兩者 Day 13、Day 14 已經各自拆開講過。
今天要認識的,是站在另一端、最基礎的形式——Template workflow agents。基礎不代表次要:多數多步驟任務根本用不到 graph 的節點與邊,這三個積木就是你會第一個伸手拿的工具。
Template workflow agents 是 ADK 1.0 時代就存在的東西,繼承自 BaseAgent,執行邏輯完全確定性(deterministic),不受任何 AI 模型控制——子 agent 本身可以是不是 LLM 驅動都行,但「怎麼跑」這件事,是模板物件的固定邏輯決定的,不是推理決定的。三個積木分別是:
SequentialAgent:依序執行,固定順序,靠 output key 在 sub-agent 之間傳資料。LoopAgent:反覆執行整組 sub-agent,但終止條件要自己實作,不然就是無窮迴圈。ParallelAgent:同時執行所有 sub-agent,分支之間互不相通,適合彼此獨立的任務。官方文件開頭就講明白它跟後起編排方式的關係:從 ADK 2.0 開始,Python 與 Go 版的模板工作流已經被更彈性的 graph-based workflows 與 dynamic workflows 取代。
graph 與 dynamic workflow 是官方認定的「進階版」,而模板這三個積木,才是理解 multi-agent 編排概念最基礎的起點——不需要學節點、邊、條件路由這些額外概念,三行程式碼就能組出一條可靠的多 agent 流程。而且別忘了——graph 跟 dynamic workflow 目前只有 Python 跟 Go 支援,如果你的專案是 TypeScript 或 Java,模板還是你唯一的多 agent 編排選項。
運作方式:呼叫 run_async() 時,依 sub_agents 清單指定的順序,逐一呼叫每個 sub-agent 的 run_async()。所有 sub-agent 共享同一個 InvocationContext(可以先理解成「這次呼叫的執行環境」,裡面帶著 session state 與服務參照),代表它們共享同一份 session state(包含 temp: 這個臨時命名空間),跨步驟傳資料因此變得直接。
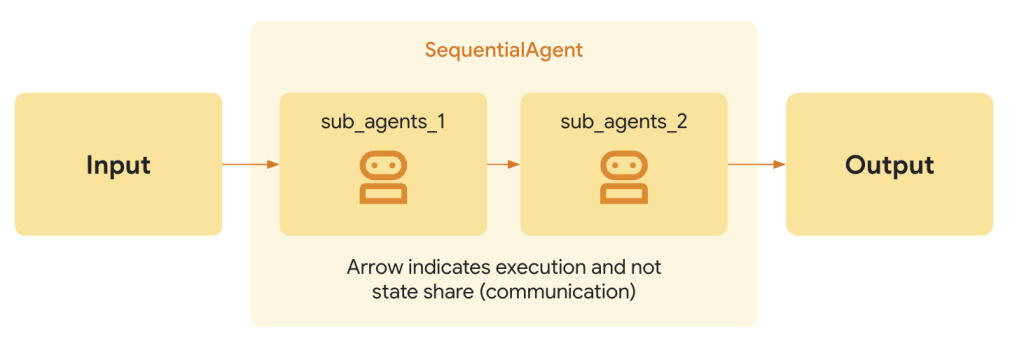
最典型的用法是有明確先後依賴的任務——先抓網頁內容、再摘要,這種順序不能顛倒的流程。官方給的完整範例是一條三段式的程式碼開發管線:Code Writer 依規格寫程式碼 → Code Reviewer 審查並給意見 → Code Refactorer 依審查意見重構:
from google.adk.agents import LlmAgent, SequentialAgent

GEMINI_MODEL = "gemini-2.5-flash"

code_writer_agent = LlmAgent(
    name="CodeWriterAgent",
    model=GEMINI_MODEL,
    instruction="""
    You are a Python Code Generator.
    Based *only* on the user's request, write Python code that fulfills the requirement.
    Output *only* the complete Python code block, enclosed in triple backticks (```python ... ```).
    """,
    description="Writes initial Python code based on a specification.",
    output_key="generated_code"
)

code_reviewer_agent = LlmAgent(
    name="CodeReviewerAgent",
    model=GEMINI_MODEL,
    instruction="""
    You are an expert Python Code Reviewer.
    **Code to Review:**
    ```python
    {generated_code}
    ```
    ...
    """,
    description="Reviews code and provides feedback.",
    output_key="review_comments"
)

code_refactorer_agent = LlmAgent(
    name="CodeRefactorerAgent",
    model=GEMINI_MODEL,
    instruction="""
    You are a Python Code Refactoring AI.
    **Original Code:**
    ```python
    {generated_code}
    ```
    **Review Comments:**
    {review_comments}
    ...
    """,
    description="Refactors code based on review comments.",
    output_key="refactored_code"
)

code_pipeline_agent = SequentialAgent(
    name="CodePipelineAgent",
    sub_agents=[code_writer_agent, code_reviewer_agent, code_refactorer_agent],
    description="Executes a sequence of code writing, reviewing, and refactoring.",
)
這裡的資料流機制值得看清楚:每個 agent 用 output_key 把自己的回應寫進 state,下一個 agent 直接在 instruction 裡用 {key} 模板讀出來——code_reviewer_agent 讀 {generated_code},code_refactorer_agent 同時讀 {generated_code} 和 {review_comments}。三個 output_key(generated_code、review_comments、refactored_code)串成一條完整的資料鏈,不需要額外寫任何膠水程式碼。
這正是 Day 14 提到的兩套資料流機制裡的第二套:graph 建議用 Event.Output,prebuilt workflow agents 走的是 OutputKey + state 這條路。同一個框架、兩套機制並存,寫程式碼時要清楚自己現在站在哪一邊。
運作方式:依順序呼叫 sub-agent 清單裡每一個的 run_async(),跑完一輪再重來。官方文件特別用粗體強調一件事必須記住:LoopAgent 本身不會自己決定何時停止。你不寫終止機制,它就是一個無窮迴圈——這正好呼應這系列 Day 1 提過的「無窮迴圈」症狀之一,只是這次的成因不是 prompt 設計,而是模板本身的行為預期。
兩種常見的終止策略:
LoopAgent 上設定最大迭代次數,跑滿次數強制停下。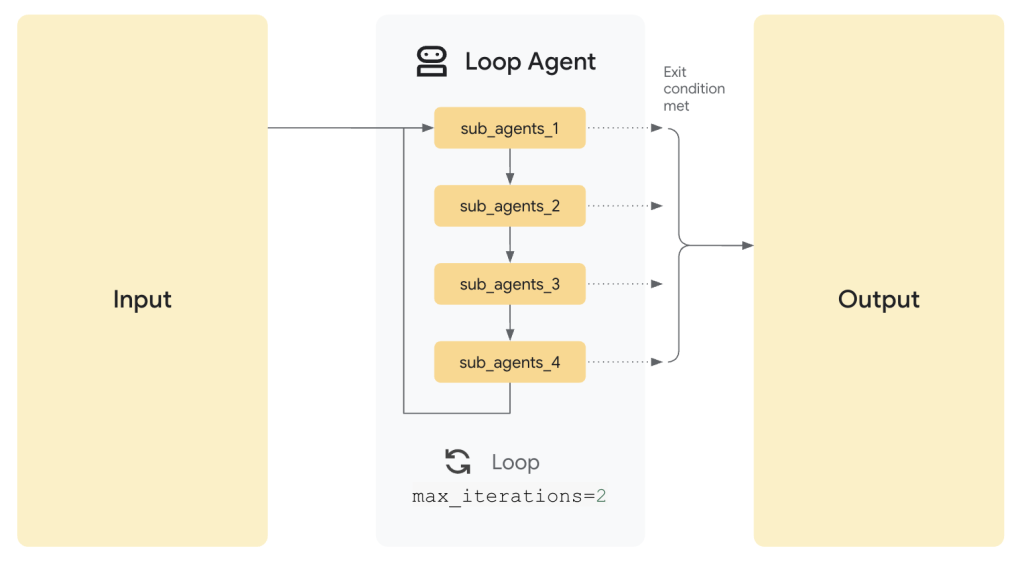
官方的完整範例是迭代式文件改善——Writer Agent 生成/修訂草稿,Critic Agent 給批評意見,兩者循環運作。以下這行是官方文件的示意片段,WriterAgent/CriticAgent 只是佔位名字,不是可以直接執行的完整程式:
from google.adk.agents import LoopAgent

refinement_loop = LoopAgent(
    name="RefinementLoop",
    sub_agents=[WriterAgent, CriticAgent],
    max_iterations=5
)
CriticAgent 可以被設計成在品質達標時回傳一個「STOP」訊號提前結束整個迴圈;max_iterations=5 則是最後一道防線——即使沒有任何 agent 主動喊停,最多也只會跑五輪,不會無限燒 token。這兩種策略不是互斥的,實務上通常兩個一起用:優先靠 escalation 提前結束,max_iterations 當保底。
「STOP 訊號」具體怎麼發?官方範例是給負責評估的 sub-agent 掛一個 exit_loop 工具,呼叫它就把 escalate 設成 True:
from google.adk.tools.tool_context import ToolContext

def exit_loop(tool_context: ToolContext):
    """Call this function ONLY when the critique indicates no further changes are needed, signaling the iterative process should end."""
    print(f"  [Tool Call] exit_loop triggered by {tool_context.agent_name}")
    tool_context.actions.escalate = True
    tool_context.actions.skip_summarization = True
    # Return empty dict as tools should typically return JSON-serializable output
    return {}
把這個函式塞進 CriticAgent 的 tools=[exit_loop],agent 判斷品質已經達標就呼叫它,LoopAgent 讀到 escalate=True 就會提前跳出迴圈,不用等到 max_iterations 耗盡。
運作方式:sub_agents 清單裡的每一個 agent 幾乎同時啟動,各自在獨立的執行分支裡運作。執行期間分支之間不會自動共享對話歷史或 state;全部完成後,ParallelAgent 提供存取每個結果的方式,但結果的順序不保證是確定的。
適用情境是多來源資料檢索、重運算量的獨立任務——只要子任務彼此沒有相依關係,平行化能大幅縮短總處理時間。關鍵前提是每個 sub-agent 必須能在不依賴其他 sub-agent 的情況下獨立運作。
官方用「crucial」這個詞強調一件事:ParallelAgent 裡的 sub-agent 是獨立運作的。如果你需要它們之間溝通或共享資料,必須自己明確實作,三種可能做法:
InvocationContext:當成資料存放區傳給每個 sub-agent,但要小心管理併發存取(例如用鎖)避免 race condition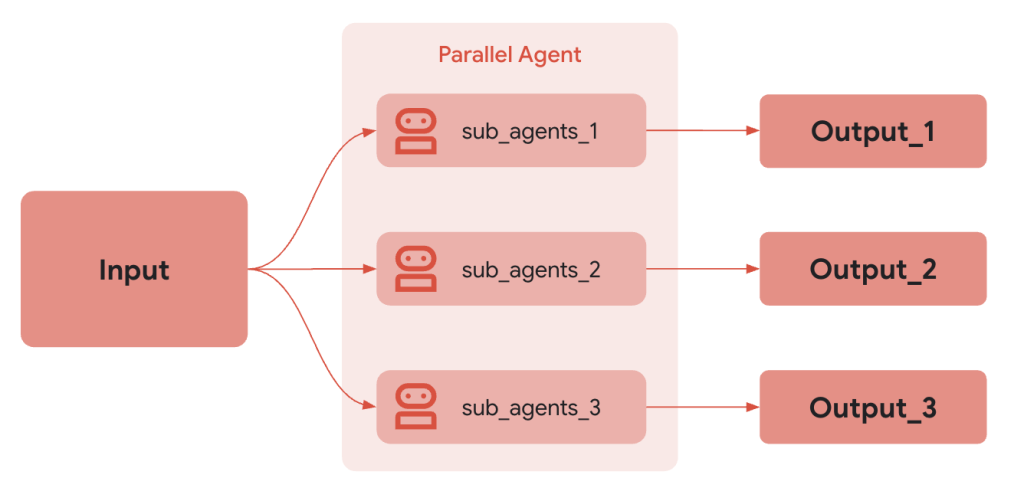
一個常見的組合技是把 ParallelAgent 巢狀放進 SequentialAgent——先平行 Fan-Out,SequentialAgent 確保接下來的彙整步驟一定等平行分支全部完成才開始:
# Conceptual Code: Parallel Information Gathering
from google.adk.agents import LlmAgent, ParallelAgent, SequentialAgent

fetch_api1 = LlmAgent(name="API1Fetcher", instruction="Fetch data from API 1.", output_key="api1_data")
fetch_api2 = LlmAgent(name="API2Fetcher", instruction="Fetch data from API 2.", output_key="api2_data")

gather_concurrently = ParallelAgent(
    name="ConcurrentFetch",
    sub_agents=[fetch_api1, fetch_api2]
)

synthesizer = LlmAgent(
    name="Synthesizer",
    instruction="Combine results from {api1_data} and {api2_data}."
)

overall_workflow = SequentialAgent(
    name="FetchAndSynthesize",
    sub_agents=[gather_concurrently, synthesizer] # Run parallel fetch, then synthesize
)
# fetch_api1 and fetch_api2 run concurrently, saving to state.
# synthesizer runs afterwards, reading state['api1_data'] and state['api2_data'].
這個模式在 Day 17 講七個多 agent 模式時還會再遇到——它就是 Parallel Fan-Out and Gather Pattern 的具體實作。
| 模板 | 特性 | 何時用 |
|---|---|---|
SequentialAgent |
固定順序,共享 context,靠 output_key 傳資料 |
任務有明確先後依賴,例如「先查資料再摘要」 |
LoopAgent |
反覆執行,自己必須實作終止條件 | 需要迭代改善的任務,例如反覆修訂文件或程式碼 |
ParallelAgent |
同時執行,分支間互不相通 | 子任務彼此獨立,追求速度(多來源檢索、重運算) |
如果連 LoopAgent 的條件式終止都滿足不了你的需求——例如「執行完三個子 agent 後,依某個 sub-agent 寫進 state 的結果決定要不要重跑第一步」這種跨步驟的條件分支——三種模板都天生做不到,因為它們的編排邏輯是寫死的,不接受你插入任意 if/else。這時候的最後一條路是自己繼承 BaseAgent,實作核心非同步方法(Python 是 _run_async_impl)寫你自己的編排邏輯,細節見官方文件(Custom agents)。
⚠️ 這是 ADK 2.0 之前的做法,2.0 之後你應該先評估 Day 13 的 Graph Workflows 或 Day 14 的 Dynamic Workflows 能不能做到你要的事,做不到才回頭寫 Custom Agent。
把這三天的內容串起來看:graph 給你精細的節點與邊控制,dynamic workflow 給你程式語言原生的控制流,而模板給你三個現成、免接線的常見模式。實務上的判斷邏輯很簡單——能用模板解決的就別自己拉graph;等你真的需要條件分支、fan-out/join、巢狀流程這些更精細的控制時,再降到 graph 那一層自己動手。
三者不是三選一的競賽,是同一組編排思維在不同抽象層級的落地方式,而且可以混用:一個 SequentialAgent 裡的某個步驟完全可以是一整張 graph。
模板積木講完了,接下來要往「多 agent 怎麼分工」這個更大的主題走。Day 17 會攤開官方文件裡完整的七個多 agent 設計模式——包括這篇提到的 Sequential Pipeline 跟 Parallel Fan-Out/Gather 在內——並提醒你 Agent Routing 這個功能目前只有 TypeScript 能用。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術