
前面幾天修過 recompile,也繞開過 graph break,也就是 Dynamo 半路遇到吃不下的東西,把一張圖切成兩張。不過這些手法一直是碰到問題才撿一把來用。出事當下最需要的是一張清單,慢了先開哪個 log,編譯掛掉又該交出什麼給 issue。今天把整個系列用過的診斷工具收齊成一個工具箱,拿診間的檢查流程來比喻,log 是問診紀錄,explain 是健檢總表,depyf 是 X 光片,minifier 是最後才上場的手術刀。症狀走一遍流程,每站留下證據,病灶自己會浮出來。本篇實驗全部在本機 CPU 上跑(torch 2.8.0),完整程式與 log 在 code/day27/。
正文開始!
工具照症狀選,先把決策表攤開。
| 症狀 | 工具 | 拿到什麼 |
|---|---|---|
| 沒變快,懷疑圖被切碎 | TORCH_LOGS="graph_breaks" |
每個 break 的位置與理由 |
| 越跑越慢,一直在編譯 | TORCH_LOGS="recompiles" |
每次 recompile 踩到哪條 guard |
| 想驗收生成的 kernel | TORCH_LOGS="output_code" |
Inductor 的最終產物 |
| 想要一份總覽報告 | torch._dynamo.explain |
圖數、break 數、guard 清單 |
| 想對照改寫後的程式 | depyf |
bytecode 反編譯回 Python |
| 想把中間產物留檔 | TORCH_COMPILE_DEBUG=1 |
每一站的 dump 目錄 |
| 編譯掛掉,要回報 bug | TORCHDYNAMO_REPRO_AFTER |
自動縮小的最小重現 |
表的順序就是排查的順序。break 決定圖有幾張,recompile 決定同一張圖付了幾次編譯費,這兩項是成本大頭,確認沒問題才輪得到懷疑 kernel 的品質。實驗品是同一個小函式,故意埋一個資料相依的分支,每把工具都拿它開刀。
def f(x, n):
    y = torch.sin(x) + 1
    if y.sum() > 0:
        y = y * 2
    return torch.relu(y) * n
順帶一提,前三列的 TORCH_LOGS 不是三個獨立開關,而是整條 pipeline 共用的日誌系統。每個元件把自己的產出登記成一種 artifact,用逗號隔開就能同時開好幾個,這個系列每次實驗開場那行環境變數開的就是這些。七把工具的成本也不一樣。TORCH_LOGS 完全不用改程式,設個環境變數重跑一次就有,explain 要改一行呼叫方式,depyf 得額外安裝。排查總是從最便宜的 log 開起。
排查的第一步永遠是數 break,因為它決定手上有幾張圖,後面每一筆成本都要乘上這個數字。開 TORCH_LOGS="graph_breaks" 編譯一次(節錄)。
Graph break in user code at /Users/wchiu/Documents/GitHub/gmc-ithome/code/day27/debug_toolbox.py:21
Graph Break Reason: Data-dependent branching
Explanation: Detected data-dependent branching (e.g. `if my_tensor.sum() > 0:`). Dynamo does not support tracing dynamic control flow.
Hint: Use `torch.cond` to express dynamic control flow.
位置、理由和替代方案一次到齊,斷點的原因正是講 graph break 時拆過的資料相依分支。這份 log 是流水帳,想要一份總表可以改用 torch._dynamo.explain,它拿同一套 trace 流程把函式走一遍,回來的是一份結構化報告(節錄)。
Graph Count: 2
Graph Break Count: 1
Op Count: 6
Break Reasons:
  Break Reason 1:
    Reason: generic_jump TensorVariable()
Ops per Graph:
  Ops 1:
    <built-in method sin of type object at 0x108f20ae8>
    <built-in function add>
    <built-in function gt>
  Ops 2:
    <built-in function mul>
    <built-in method relu of type object at 0x108f20ae8>
    <built-in function mul>
兩張圖、一個 break,六個 op 怎麼分家一清二楚。報告後半還列出十幾條 guard,也就是講 Guard 時看過的那些通行條件,一條沒過就得 recompile。explain 不需要改環境變數,適合寫進測試當防線,例如斷言 break 數量是零,誰把 break 寫進模型,CI 就亮紅燈。
break 數完換 recompile。輸入從 32x32 換成 48x48 再換成 64x64,開 TORCH_LOGS="recompiles"(節錄)。
Recompiling function f in /Users/wchiu/Documents/GitHub/gmc-ithome/code/day27/debug_toolbox.py:19
triggered by the following guard failure(s):
- 0/0: tensor 'x' size mismatch at index 0. expected 32, actual 48
哪條 guard 倒的、期望什麼、實際來了什麼,一行講完。log 裡緊接著還有一筆幾乎一樣的紀錄,主角是 graph break 切出來的下半段,也就是 resume function。圖被切成兩張,recompile 帳單也是兩份,這正是 break 要排在 recompile 前面數的原因。至於 64x64 那次 log 上什麼都沒有,因為第一次 recompile 時 automatic dynamic 已經把 size 升格成符號,第三種 shape 拿同一把鑰匙通行。判讀重點是頻率,冷啟動出現幾筆是正常熱身,跑了幾百個 step 還在冒,就代表有某個 guard 永遠追不上輸入的變化。這正是排查 recompile 要抓的病。
前兩站看的是編譯器的決定,要看它生出什麼就開 TORCH_LOGS="output_code"(節錄)。
cpp_fused_add_gt_sin_sum_0 = async_compile.cpp_pybinding(['const float*', 'float*', 'float*', 'bool*'], '''
Output code written to: /tmp/torchinductor_day27/az/cazeciyh4zabf6wptfnqxwr5taumzppx4ksurrzbmo7wl6ivevph.py
cpp_fused_mul_relu_0 = async_compile.cpp_pybinding(['const float*', 'float*'], '''
Output code written to: /tmp/torchinductor_day27/c5/cc5whbo7fduoh4jvrq5dsve47xysjz5zycoukvicxpd7ga64bo7z.py
kernel 名字怎麼讀,講 fusion 時已經拆過。這裡多一層資訊,兩顆 kernel 分屬兩個檔案,graph break 的痕跡一路留到了產物層。想把中間產物,也就是編譯途中每一站的半成品,整包留下來慢慢看,改開 TORCH_COMPILE_DEBUG=1,它會把整趟編譯 dump 成一個帶時間戳的目錄(節錄)。
torch_compile_debug/run_2026_08_25_23_18_14_169341-pid_21348/torchdynamo/debug.log  (0 KB)
torch_compile_debug/run_2026_08_25_23_18_14_169341-pid_21348/torchinductor/model__0_inference_0.0/fx_graph_readable.py  (1 KB)
torch_compile_debug/run_2026_08_25_23_18_14_169341-pid_21348/torchinductor/model__0_inference_0.0/ir_pre_fusion.txt  (3 KB)
torch_compile_debug/run_2026_08_25_23_18_14_169341-pid_21348/torchinductor/model__0_inference_0.0/output_code.py  (4 KB)
torch_compile_debug/run_2026_08_25_23_18_14_169341-pid_21348/torchinductor/model__1_inference_1.1/output_code.py  (3 KB)
檔名就是站名,從 ATen 圖、融合前的 node 清單到最終產物,這個系列一路上攔下來看的東西,這裡一次到齊。兩個 model 目錄再次對應被 break 切開的兩張圖。出事時整包壓縮起來,就是一份可以慢慢驗屍的病歷。
Dynamo 的最終輸出是一段改寫過的 bytecode,講 codegen 時只能對著反組譯的指令逐條腦補。第三方套件 depyf 專治這件事,用一個 context manager 包住編譯,就把改寫後的 bytecode 反編譯成等價的 Python 存進指定目錄。編譯後的 f 長這樣(節錄)。
def __transformed_code_0_for_f(x, n):
    graph_out_0 = __compiled_fn_1_89e14957_0209_4616_b549_7f48ffb1c65c(x)
    y = graph_out_0[1]
    if graph_out_0[0]:
        return __resume_at_88_2_e7cec4f6_aeac_4bf8_9722_71df3ad0abfe(n, y)
    return __resume_at_98_3_3fa5dcb9_e634_4fa3_85dd_70ae18cd87d5(n, y)
整個 graph break 的機制濃縮在六行裡,前半段計算收進一個 compiled function,if 留在 Python,兩條路各自接一個 resume function。dump 目錄裡每個 compiled function 從 FX Graph 到 kernel 都各有一份檔案,猜測和現實對不上時,這疊 X 光片可以一層層對下去,比對著 bytecode 考古省力得多。
把排查流程用動畫走一遍。
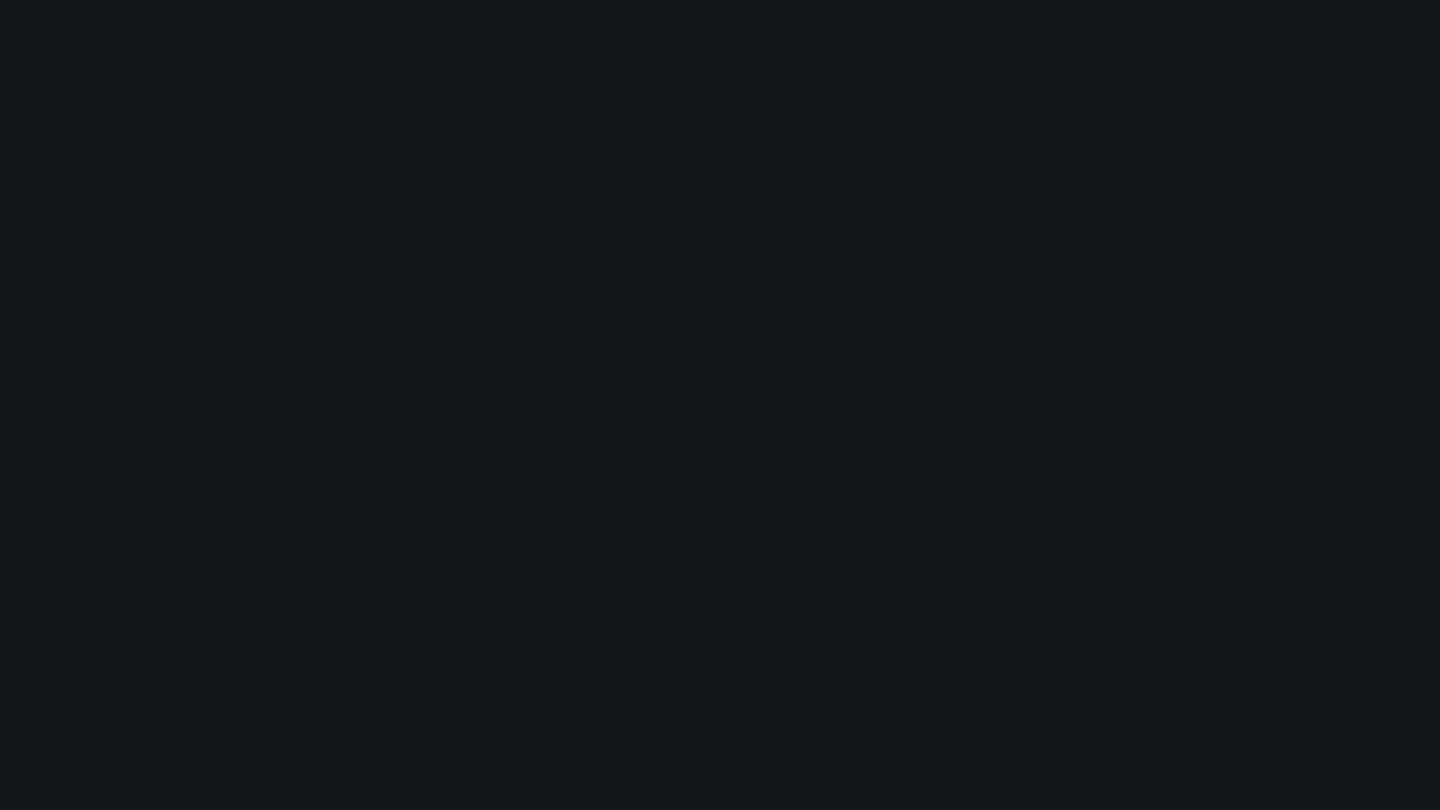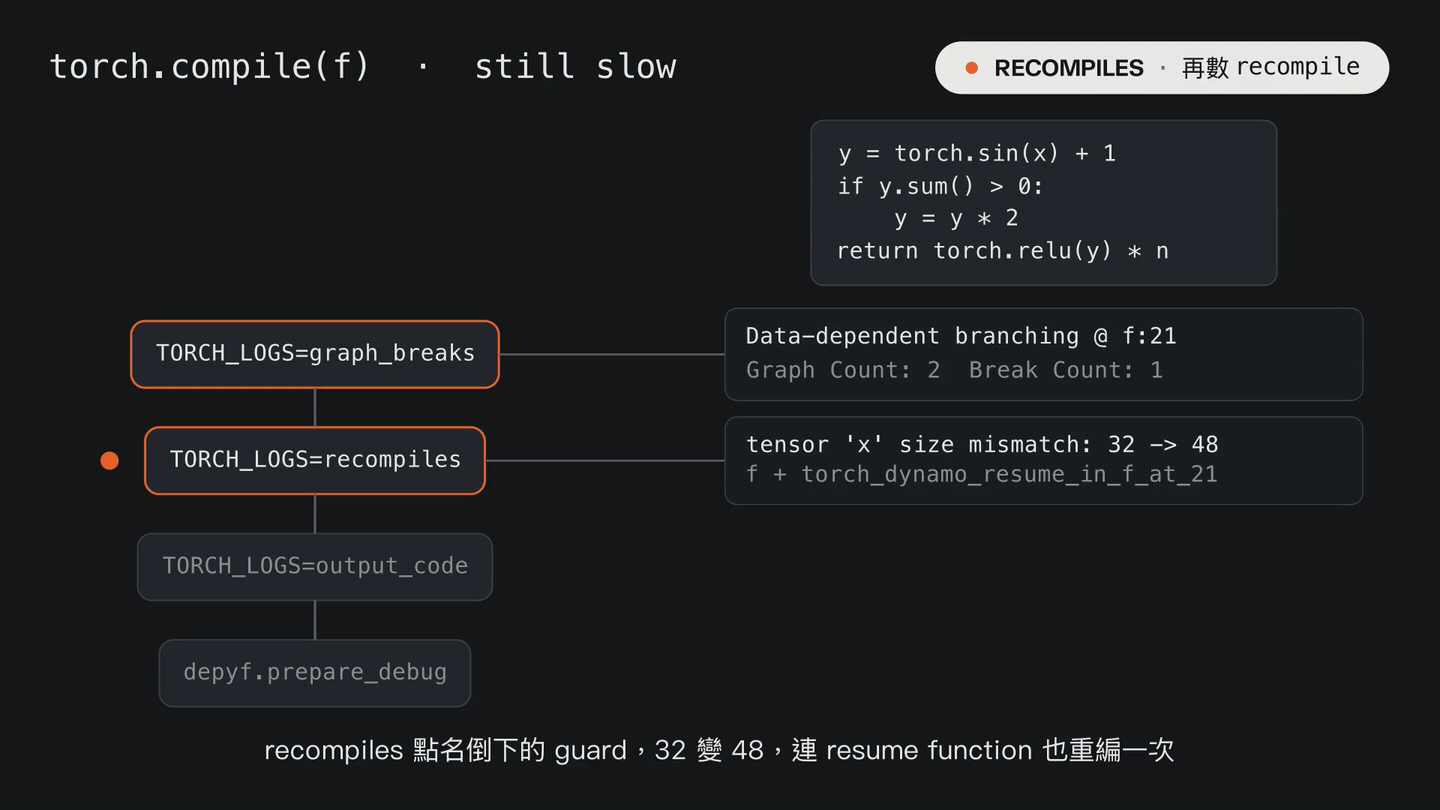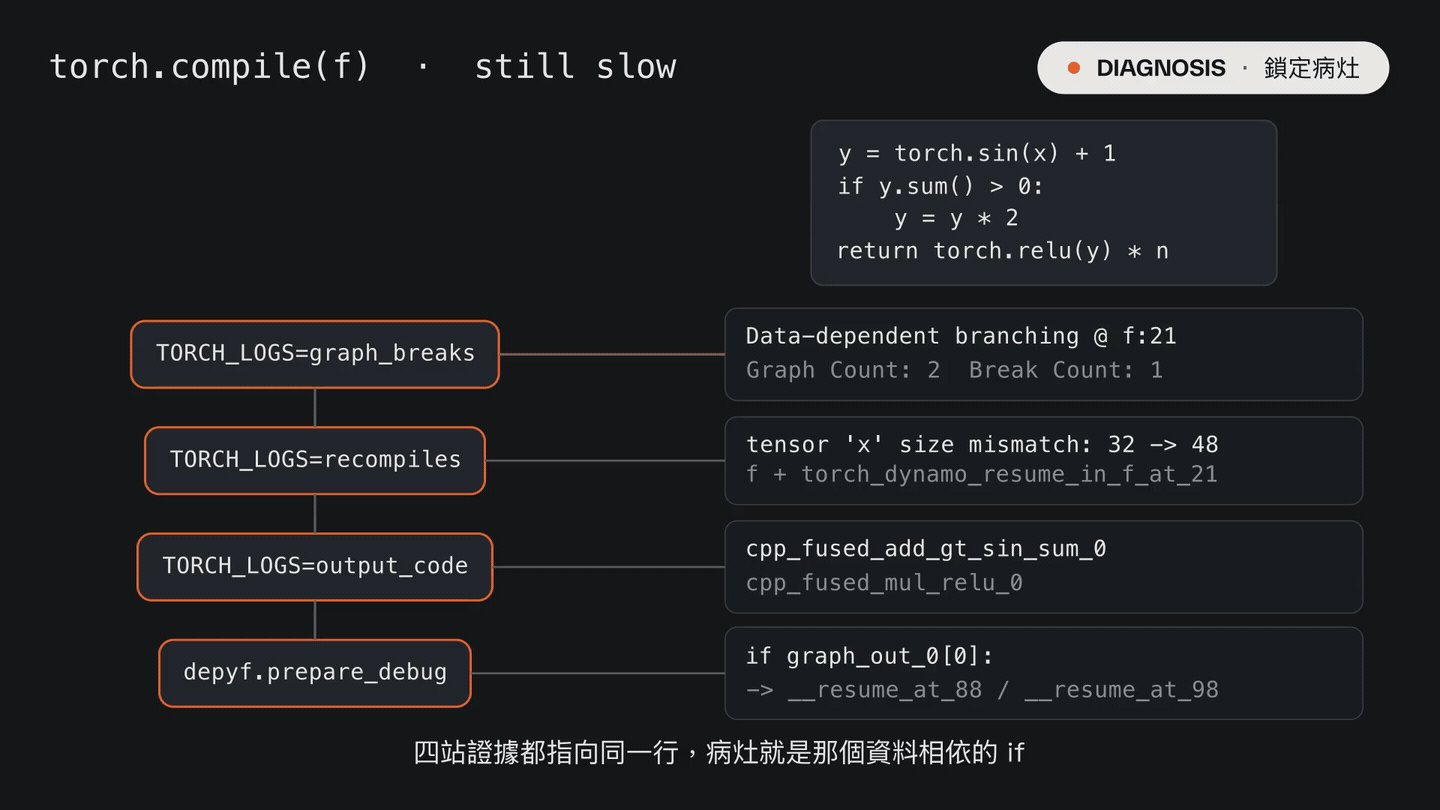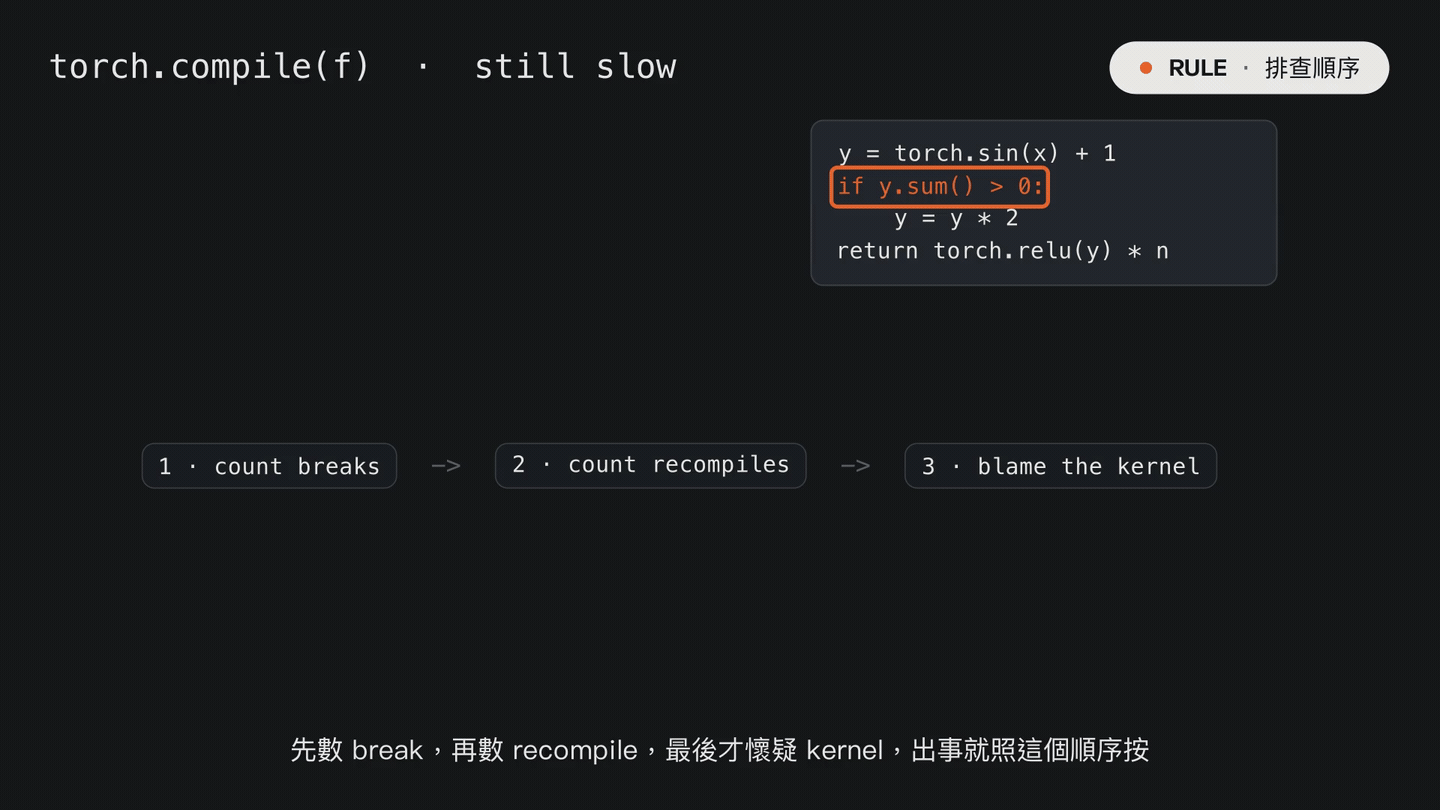
圖一:除錯工具箱的看診動線。一條「變慢了」的症狀掛號進來,graph_breaks 找到斷點的位置與理由,recompiles 點名倒下的 guard,output_code 驗出兩顆分家的 kernel,depyf 把改寫後的 bytecode 攤成可讀的 Python,四站證據收齊,病灶鎖定在那行資料相依的 if。
前面的工具處理的都是「不夠快」,minifier 處理的是「掛掉了」。真實模型幾百個 op,編譯途中丟出例外時不可能把整個模型貼進 issue,得先把圖削到最小。設 TORCHDYNAMO_REPRO_AFTER="dynamo" 之後,backend 一丟例外,Dynamo 就把當下那張圖連同輸入打包成一支重現腳本。示範方式是故意寫一個看到 relu 就翻臉的 backend,拿五個 op 的小函式去撞。
BackendCompilerFailed: day27_bad backend cannot handle relu
minifier_launcher.py written: True
launcher 裡是完整的犯罪現場,出事那張圖連同輸入 tensor 一起存檔。跑起來它會拿同一個 backend 反覆實驗,每輪砍掉一部分 node,錯誤還在就繼續砍,錯誤消失就把 node 放回去換個方向(節錄)。
SUCCESS: Went from 7 to 6 nodes
SUCCESS: Went from 5 to 4 nodes
Wrote minimal repro out to repro.py
小圖四輪就砍到底,最後吐出的 repro.py 是一支可以獨立執行的腳本,圖只剩一行計算。
def forward(self, y):
    z = torch.relu(y);  y = None
    return (z,)
兇手就是 relu,其他 op 全被證明無辜。這份腳本可以直接附進 bug report,維護者不需要模型和資料就能重現。它還有幾種本篇沒跑的模式,設成 "aot" 對付 AOTAutograd 之後才爆炸的案子,連數值不對這種 accuracy bug 都能用同一套流程自動縮小。
工具箱收好,最後把排查順序釘在蓋子上。先數 break,圖有幾張,後面的帳就乘幾倍。再數 recompile,看 guard 為什麼一直倒。這兩關都過了還是慢,才輪到懷疑 kernel 的品質。編譯掛掉的場合直接跳關,請 minifier 削出最小重現再回報。每把工具對應的都是這個系列某一天拆過的機制,現在 log 的每一行應該都讀得出弦外之音了。
只剩最後一塊拼圖。torch.compile 的 backend 是一個開放的介面,Inductor 只是預設選項,剛才那個看到 relu 就翻臉的假 backend 其實已經摸到了門把。明天就正式自己寫一個 backend,把這個系列學到的東西接成一條真的能跑的編譯路。那我們明天見!


 iThome鐵人賽
 看影片追技術