
昨天的結尾留了一句「shape 要穩定」。不只 CUDA Graph 怕變動,整個 torch.compile 都建立在「這張圖的假設還成立」上。假設一塌,Guard 驗票失敗,Dynamo 就再編一張圖。偶爾一次是機制正常運作,每次呼叫都來一次就是事故,加速全被編譯本身吃掉。更麻煩的是撞到上限後整個函式會默默退回 eager,一句錯誤訊息都沒有。今天就來處理這場事故,recompile 怎麼發生、怎麼用 log 找到兇手、怎麼對症下藥。
正文開始!
講 Guard 時說過,Dynamo 在 trace 時把假設寫成 Guard,掛在編好的成品上。當時只說驗票失敗就 recompile,這裡把後半段補完。掛回函式上的不是一張圖,而是一串 cache entry。
這串清單不是免費的。圖越養越多,命中前要驗的 Guard 也越多。所以 recompile 爆炸的帳有兩筆,比較容易察覺的的是每次 recompile 的編譯費,而另一種就是就算最後命中了,每次呼叫都得先白白驗一輪,執行期的固定開銷又被拉長。
機制還有一根內建保險絲。同一個函式的 entry 有上限,recompile_limit 預設 8,撞到後 Dynamo 直接放棄這個函式,從此走 eager。邏輯很務實,都失敗八次了,多半是有東西每次都在變,再編下去只是把時間丟進水裡。
實驗照舊在本機 CPU 上跑(torch 2.8.0),完整程式在 code/day26/。第一個實驗品是訓練迴圈裡很容易長出來的寫法,函式讀了全域 step 計數器。
step = 0

def poly(x):
    return ((x * step).sin() + x.cos() * 0.5).relu().sum()
step 每呼叫加一,開 TORCH_LOGS="recompiles" 連跑十次,每次 recompile 都會印出死因(節錄)。
Recompiling function poly in /Users/wchiu/Documents/GitHub/gmc-ithome/code/day26/recompile.py:9
    triggered by the following guard failure(s):
    - 0/1: G['step'] == 1
    - 0/0: G['step'] == 0
Dynamo 把從 global 讀進來的 Python 數值當常數烙進圖裡,也就是對這個值特化,Guard 記下它必須等於 0。step 變成 1 就驗票失敗,再編一張烙著 1 的圖,然後是 2、是 3,每張圖只服務一個值。時間帳單長這樣。
call 0 (step=0):   4.514 s
call 1 (step=1):   0.831 s
call 2 (step=2):   0.809 s
...
call 7 (step=7):   0.838 s
call 8 (step=8):   0.004 s
call 9 (step=9):   0.000 s
first 8 calls total: 10.19 s
前八次呼叫總共付了 10.19 秒,養出八張圖,每張只用過一次。這還是一行的玩具函式,真實模型的一次冷編譯貴得多。然後 call 8 突然只剩 4 ms,不是修好了,是保險絲斷了。
torch._dynamo hit config.recompile_limit (8)
   function: 'poly' (/Users/wchiu/Documents/GitHub/gmc-ithome/code/day26/recompile.py:9)
   last reason: 0/7: G['step'] == 7
再拿 step=999 呼叫也只花 0.17 ms,答案還是正確的,因為整個函式已經退回 eager,加速歸零。這一切只出現在 log 裡,程式安靜得像沒事,正是 recompile 爆炸最難以察覺的地方。
同一份程式再跑幾組對照,把常見的爆炸源分成四類。分類只看一個問題,那個會變的東西 Dynamo 有沒有機制接得住:
tensor 'x' rank mismatch. expected 1, actual 2。符號能代替某一維的長度,代替不了維度的數量,四種 rank 就是四張圖。no_grad 裡外交替呼叫同一個函式,log 印出 GLOBAL_STATE changed: grad_mode。有沒有 grad 生出來的圖本來就該不一樣,兩張圖各守一邊,怎麼交替都有現貨。dtype 和 device 換來換去也是同一類,種類有限就有限。___check_obj_id 這種失敗。Guard 驗的是 code object 的身分,迴圈裡重建同一行 lambda 不會炸,程式碼真的不一樣的函式才會一個一張圖。shape 那一類還有一個容易漏掉的角落。batch 裡混進 1 筆的時候,明明是 dynamic 的圖還是又編一張,log 講得很清楚(節錄)。
- 0/1: 2 <= x.size()[0] # return (x @ x.T).relu().sum() # code/day26/recompile.py:22 in net (user code shown is first use of this value--the guard itself is not due user code but due to 0/1 specialization in the framework; to avoid specialization try torch._dynamo.mark_unbacked(tensor, dim))
講 dynamic shape 時提過,0 和 1 永遠被特化,符號的下界是 2。最後一個 batch 落單剩 1 筆,就會多養一張圖。
把整場事故走一遍。
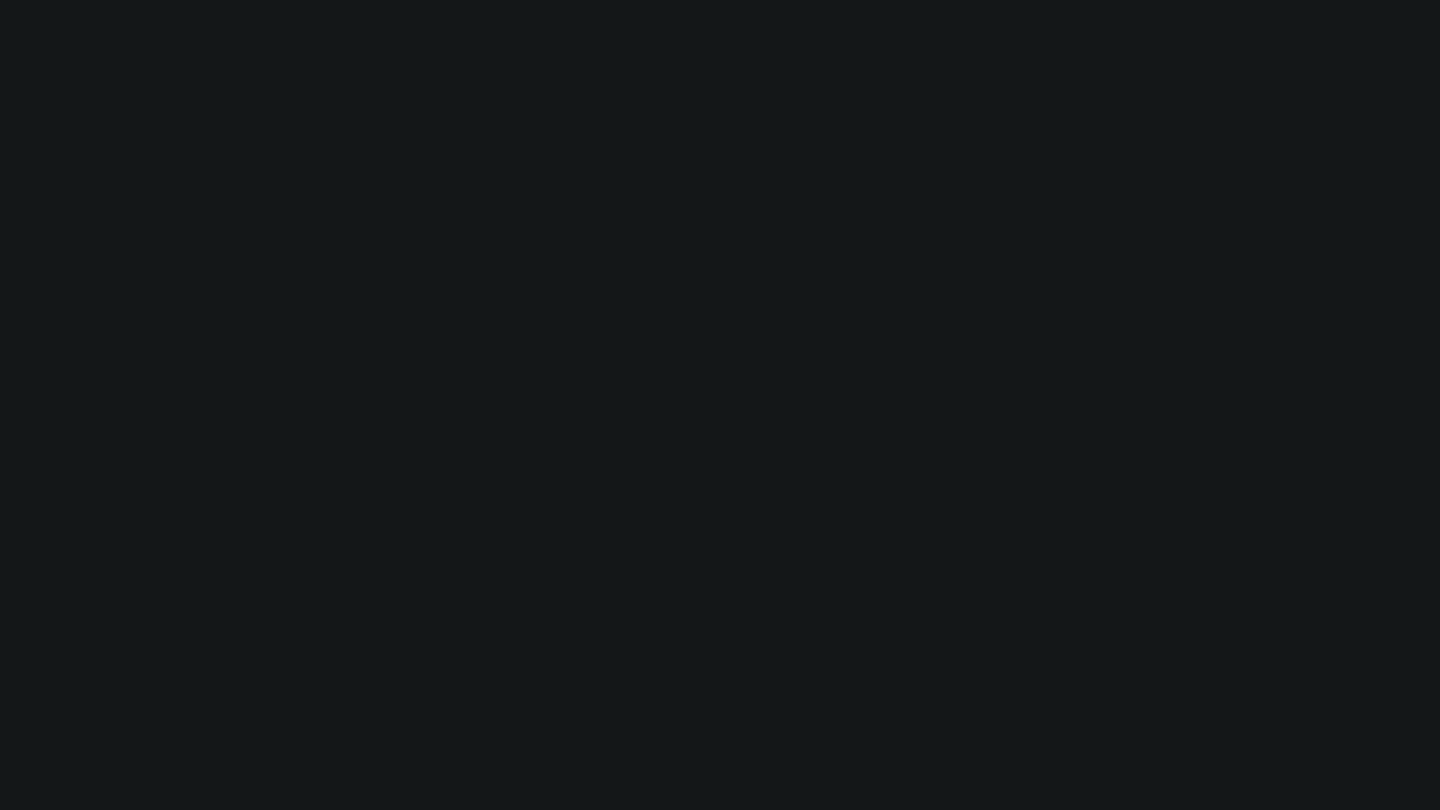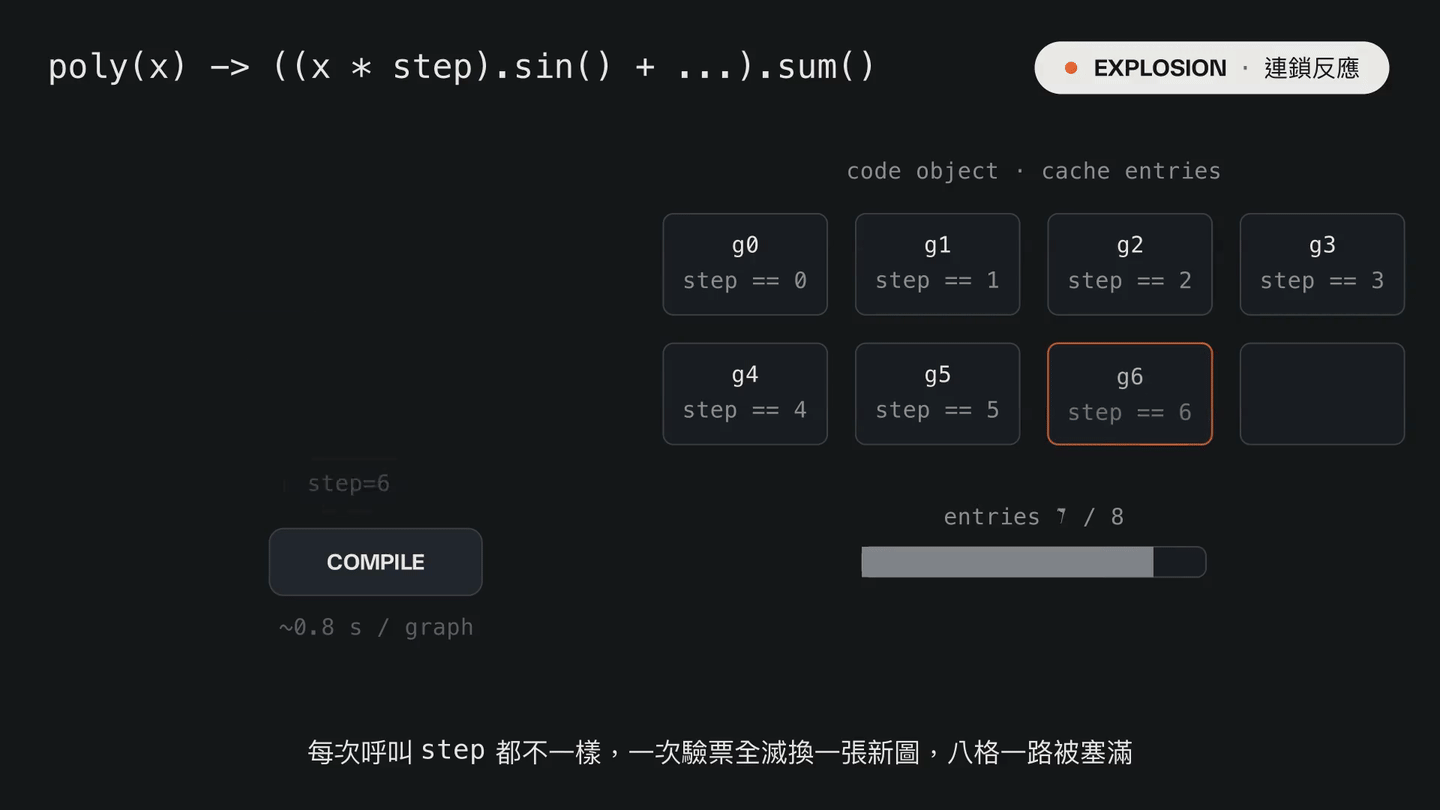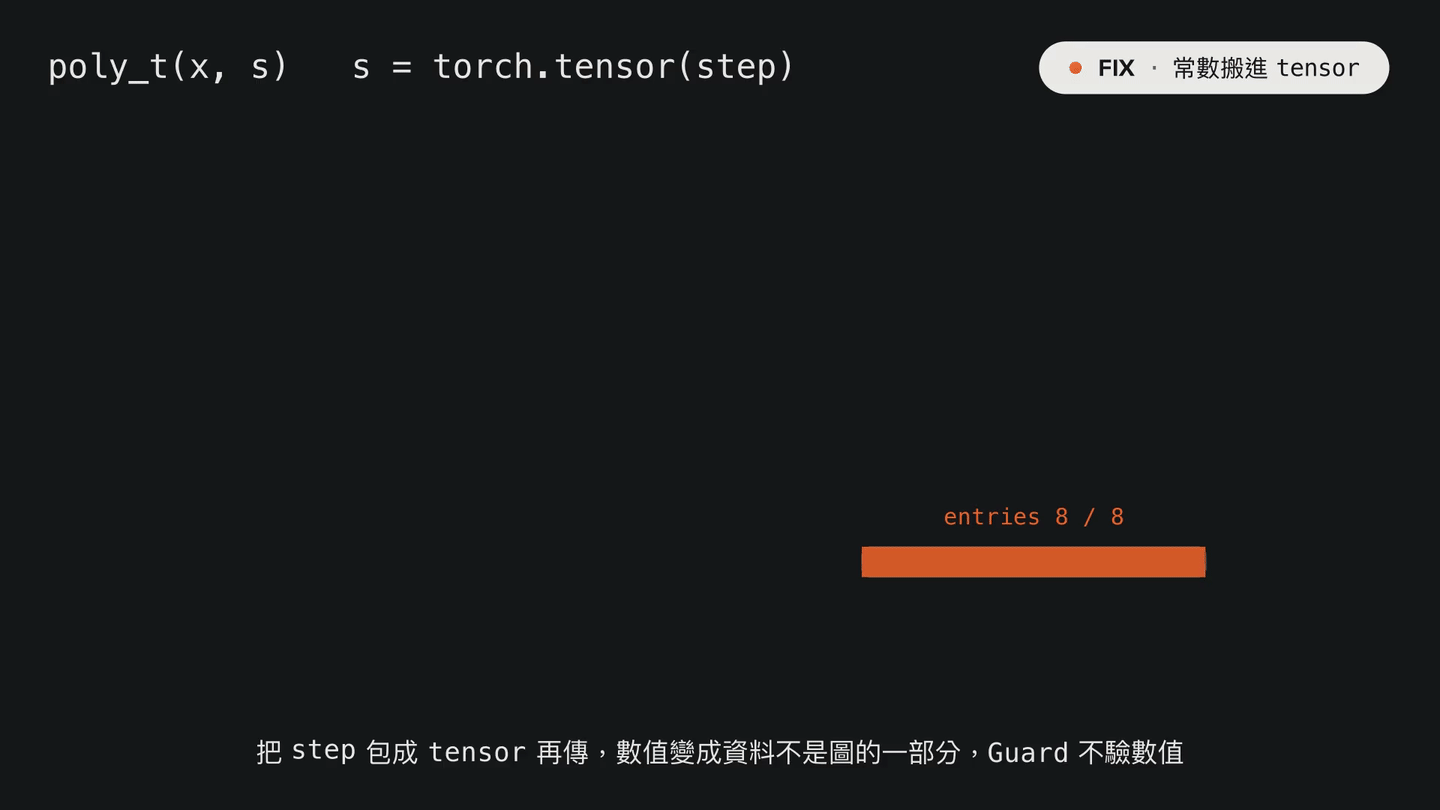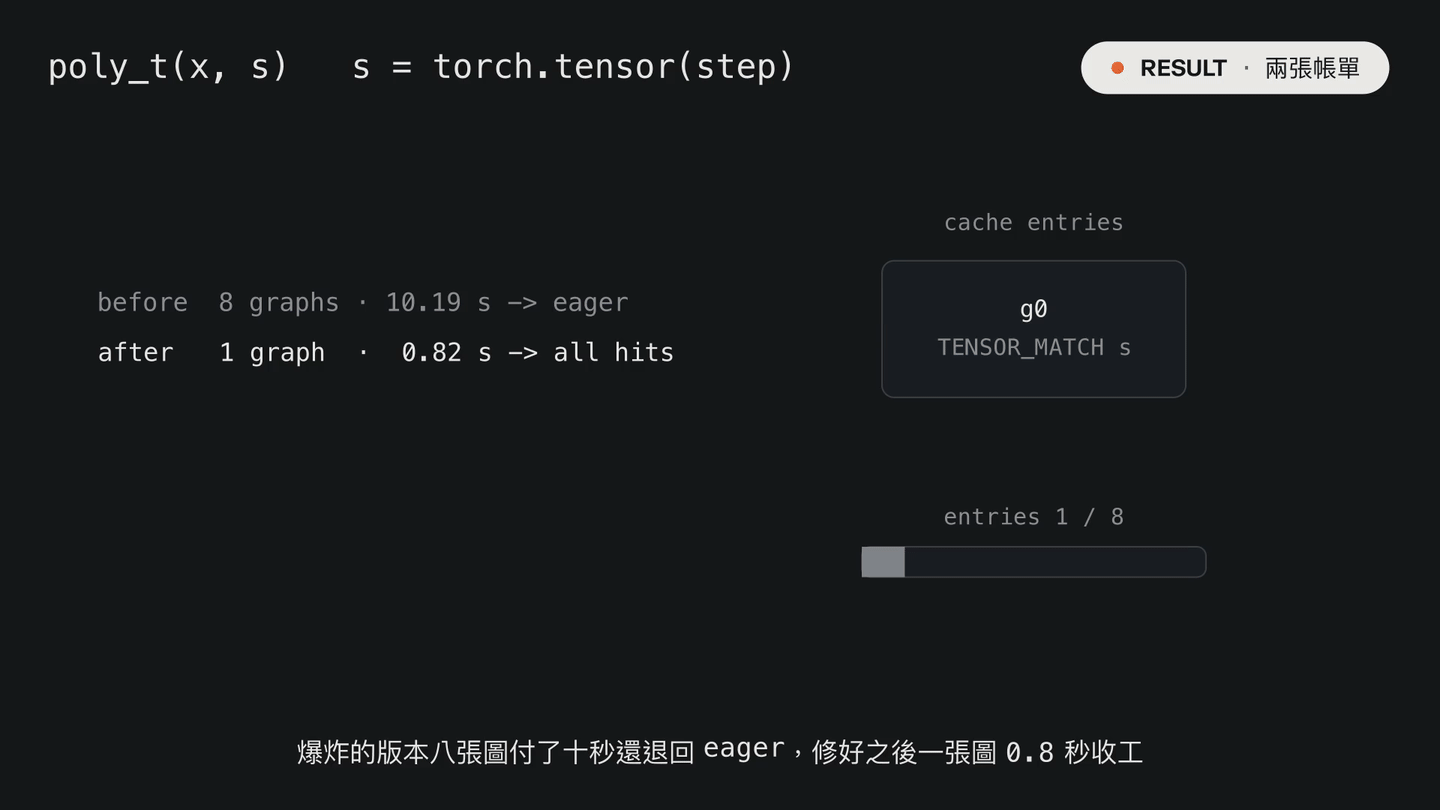
圖一:recompile 爆炸的全景。每次呼叫先沿著 code object 上的 cache entry 驗票,step 變了誰都接不住,只好再編一張圖塞進新的一格,計數條一路逼近 recompile_limit 的 8。爆表之後 Dynamo 拉下閘門,之後的呼叫全部改道 eager,編譯的加速歸零。下半場把常數搬進 tensor,同一串呼叫全部命中同一格,櫃子從此只需要一格。
診斷手法剛剛已經示範過,就是開著 TORCH_LOGS="recompiles" 重現一次問題。這個開關只在 recompile 時印字,正常命中一個字都不吐,掛在正式環境也不吵。拿到 log 之後有三個讀法。
0/2 前面是第幾個 frame,也就是第幾個被接管的函式,後面是第幾個 cache entry。一次 recompile 會列出每個舊 entry 的死因,清單一次比一次長,本身就是爆炸的心電圖。G['step'] == 1 是被烙死的 Python 常數,rank mismatch 是 shape,GLOBAL_STATE 是全域狀態,___check_obj_id 是物件身分。hit config.recompile_limit 只在撞牆那刻印一次,長跑的服務很容易錯過。懷疑退回 eager 時,拿小腳本重現比在正式環境守株待兔省事。兇手分幾類,處方就分幾類,對照組全部實跑過。
torch.tensor(float(i)),十個值一張圖,第一次 0.817 秒之後每次都在 0.1 ms 以下。數值進了 tensor 就從圖的一部分變成資料,Guard 不再驗它的內容。最怕的是讓函式從 global 裡自己撿。mark_dynamic 事先講明白,六種 batch 從頭到尾一張圖,連 automatic dynamic 那次試探性的 recompile 都省了。嫌一個一個標麻煩就用 dynamic=True 宣布所有維度可變,代價是少了按 shape 特化的機會,kernel 可能慢一些。rank 變動沒有符號可救,只能在進函式前把輸入整成固定的維度數。grad mode 這種有界的 recompile 不用修,兩張圖共存本來就是 cache 的正常用法,值得動手的是每次呼叫必炸的那種。保險絲也可以調,recompile_limit 改大能多撐幾張圖,但只是延後爆炸,因為多大的櫃子都會滿。
把今天的事故報告歸檔。recompile 的本質是 Guard 驗票失敗後再塞一張圖進 cache,一張 0.8 秒,八張就是十秒,撞上 recompile_limit 後整個函式退回 eager 而且不吭聲。爆炸源就那四類,Python 常數、rank 與 0/1、全域狀態、函式身分。診斷開 TORCH_LOGS="recompiles" 讀失敗的 Guard,處方是常數進 tensor、shape 標 dynamic、輸入固定 rank。
今天靠一個 log 開關就破了案,但 torch.compile 的疑難雜症不只 recompile,圖被切碎、結果不對、速度沒變快,各有各的查法。明天就把除錯工具箱攤開,TORCH_LOGS 全家桶、tlparse、minifier,看看官方配了哪些好用的傢伙在工具箱裡面。那我們明天見!


 iThome鐵人賽
 看影片追技術