
前幾天把診斷 torch.compile 的工具一件一件收進了工具箱,今天可以做一件更過癮的事,自己下場把 pipeline 的第三站接管過來。畫 pipeline 地圖時說過,前兩站交出來的是一張標準的 FX Graph,第三站可以換掉,Inductor 只是 PyTorch 自帶、也最成熟的那一個。這句話今天要兌現。所謂 backend,就是站在第三站接手那張圖的那段程式,我們由淺入深寫三個。
正文開始!
寫 backend 之前先把契約講清楚。一個 backend 就是一個 Python 函式,收兩樣東西,回一樣東西。收的是 Dynamo 抓好的 GraphModule,也就是把 FX Graph 包成可以直接執行的物件,以及一串 example inputs,也就是這次呼叫真的傳進來的那幾個輸入。回的是一個 callable,任何可以被呼叫的東西都算。改寫後的 bytecode 執行到圖的位置時,呼叫的就是你回傳的那個。契約就這麼一句話,沒有要繼承的類別,也沒有要實作的介面。
這份契約把時間切成兩段。backend 本體在編譯期執行,一張圖一生只來一次,回傳的 callable 才是執行期的常客。所以再貴的分析、改寫、程式碼生成都可以放心塞進 backend 本體,那是一次性的成本,執行期的快慢完全取決於你交出去的那個 callable。義務也只有一條,回傳的 callable 吃的參數和吐的結果要跟圖的輸入輸出對得上,語意等價是你自己的責任。
這代表最小的合法 backend 短得驚人,直接把 GraphModule 自己的 forward 回傳出去就行,圖照原樣用 eager 執行。而 Inductor 忙了整整一個 Part 3,最後交出來的也不過是一個 callable。兩者在契約面前完全平等,這就是介面設計得薄的好處。
第一個 backend 只多做一件事,把收到的東西印出來再原樣放行。以下實驗都在本機 CPU 上跑(torch 2.8.0),完整程式在 code/day28/。
def observer(gm, example_inputs):
    calls["observer"] += 1
    print(f"[observer] call #{calls['observer']}")
    print(gm.graph)
    for i, t in enumerate(example_inputs):
        if isinstance(t, torch.Tensor):
            print(f"  input[{i}]: shape={tuple(t.shape)} dtype={t.dtype}")
        else:
            print(f"  input[{i}]: {type(t).__name__} = {t}")
    return gm.forward
拿一個 relu 加一的小函式,用 torch.compile(f, backend=observer) 編譯後呼叫一次。
[observer] call #1
graph():
    %l_x_ : torch.Tensor [num_users=1] = placeholder[target=L_x_]
    %y : [num_users=1] = call_function[target=torch.relu](args = (%l_x_,), kwargs = {})
    %add : [num_users=1] = call_function[target=operator.add](args = (%y, 1), kwargs = {})
    return (add,)
  input[0]: shape=(4, 8) dtype=torch.float32
matches eager: True
這就是 backend 收到的原料。圖還停在 Dynamo 這一層,node 的目標是 torch.relu 和 operator.add 這種 Python 層函式,跟使用者寫的程式一一對得上。example inputs 給的是帶著 shape 和 dtype 的真實張量,想在編譯期先試跑量測或驗證,直接拿這串輸入餵圖就行。回傳 gm.forward 之後圖照跑,結果和 eager 一致。
第二次用同樣 shape 呼叫,log 一片安靜,observer 的計數停在 1。Guard 檢查和編譯成品的快取都發生在 backend 被呼叫之前,是 Dynamo 的地盤。你的 backend 再簡陋,也自動繼承整套上游機制,驗過放行,不會 recompile。
換一個 shape 再呼叫,Guard 失敗觸發 recompile,observer 第二次被叫醒,收到的圖也變了樣。
[observer] call #2
graph():
    %s77 : torch.SymInt [num_users=0] = placeholder[target=s77]
    %l_x_ : torch.Tensor [num_users=1] = placeholder[target=L_x_]
    ...
  input[0]: SymInt = s77
  input[1]: shape=(6, 8) dtype=torch.float32
第二張圖多了一個 SymInt 的 placeholder,example inputs 裡也混進了一個不是張量的符號,這是講 dynamic shape 時看過的自動放寬。寫 backend 的人只要記住一件事,輸入不保證都是張量。
graph break 也照常上班。函式要是中途斷開,Dynamo 會切出好幾張子圖,每張子圖各自把 backend 叫起來編一次。自訂 backend 接手的從來不是「整個函式」,而是 Dynamo 切好的每一段安全區。
旁觀證明了我們拿得到圖,下一步證明圖可以改。FX Graph 是普通的 Python 資料結構,走訪 node、換掉目標、重新生成程式碼,三步完成一次改寫。
def relu_to_sigmoid(gm, example_inputs):
    n = 0
    for node in gm.graph.nodes:
        if node.op == "call_function" and node.target is torch.relu:
            node.target = torch.sigmoid
            n += 1
    gm.recompile()
    print(f"[rewriter] replaced {n} node(s): relu -> sigmoid")
    return gm.forward
拿 [-2, 0, 2] 對答案。
eager    f(t): tensor([1., 1., 3.])
[rewriter] replaced 1 node(s): relu -> sigmoid
compiled f(t): tensor([1.1192, 1.5000, 1.8808])
sigmoid(t)+1 : tensor([1.1192, 1.5000, 1.8808])
eager 版是 relu 的結果,編譯版和 sigmoid 加一逐位一致,這顆 op 真的被換掉了。使用者的 Python 程式碼一個字都沒動,動的是它被抓下來的那張圖。程式一旦變成資料,改寫它就只是普通的資料處理,這正是圖表示法的價值。故意把語意改壞只是為了讓證據夠明顯,實務上同一套手法溫和得多,例如統計每種 op 出現幾次、在特定 node 前後夾一段 profiling、把某個 op 換成數值上更穩的等價寫法。Inductor 的各種圖層最佳化,起點也不過就是這三步。
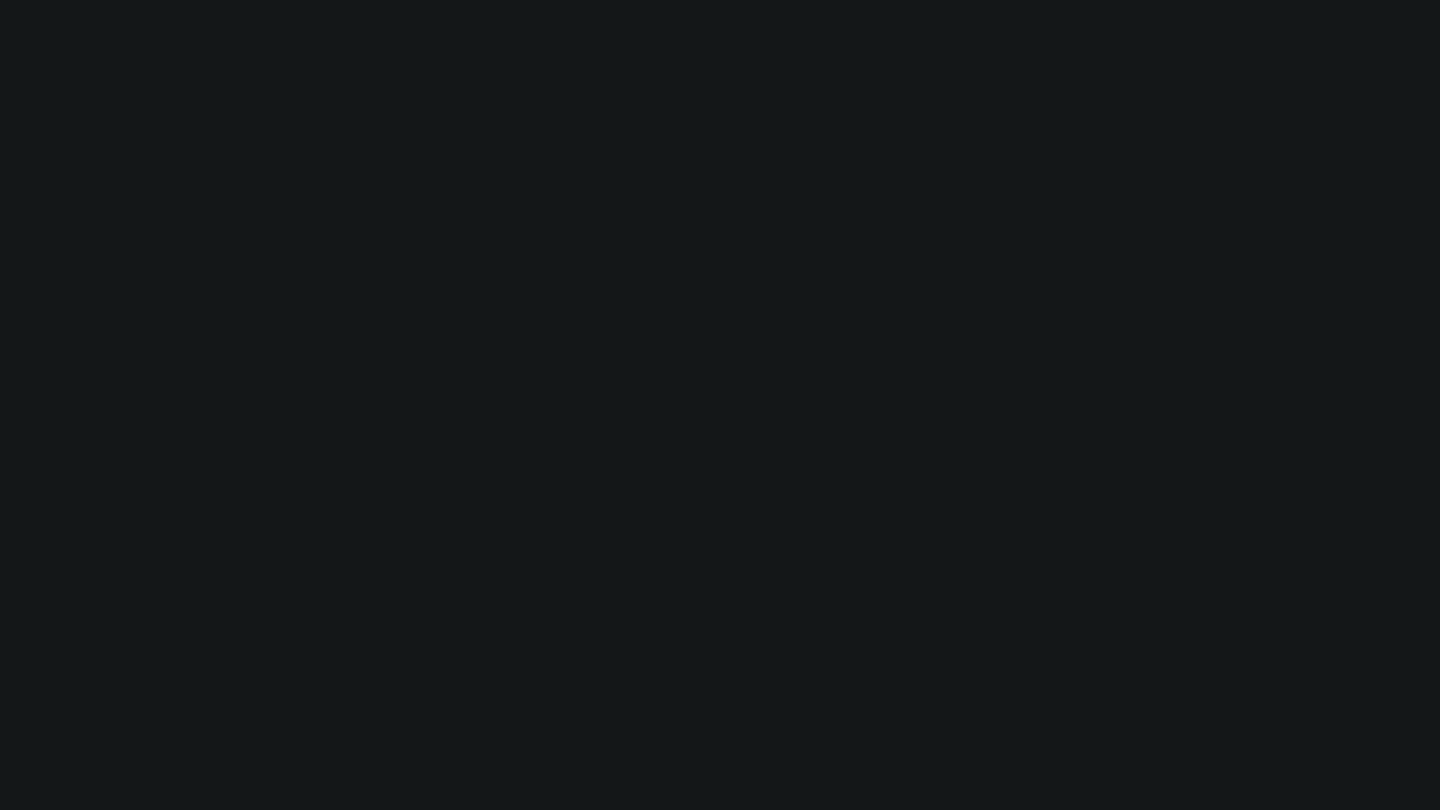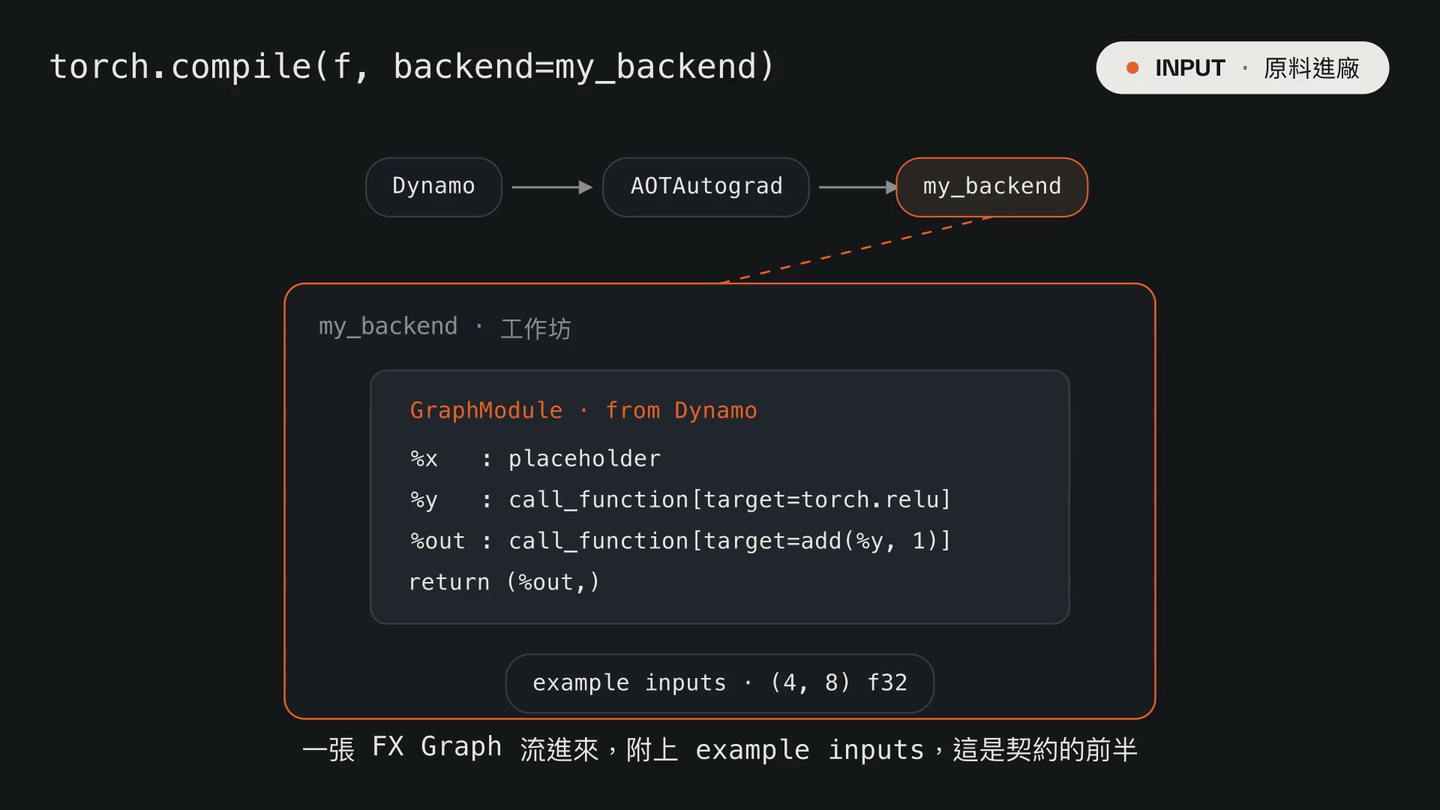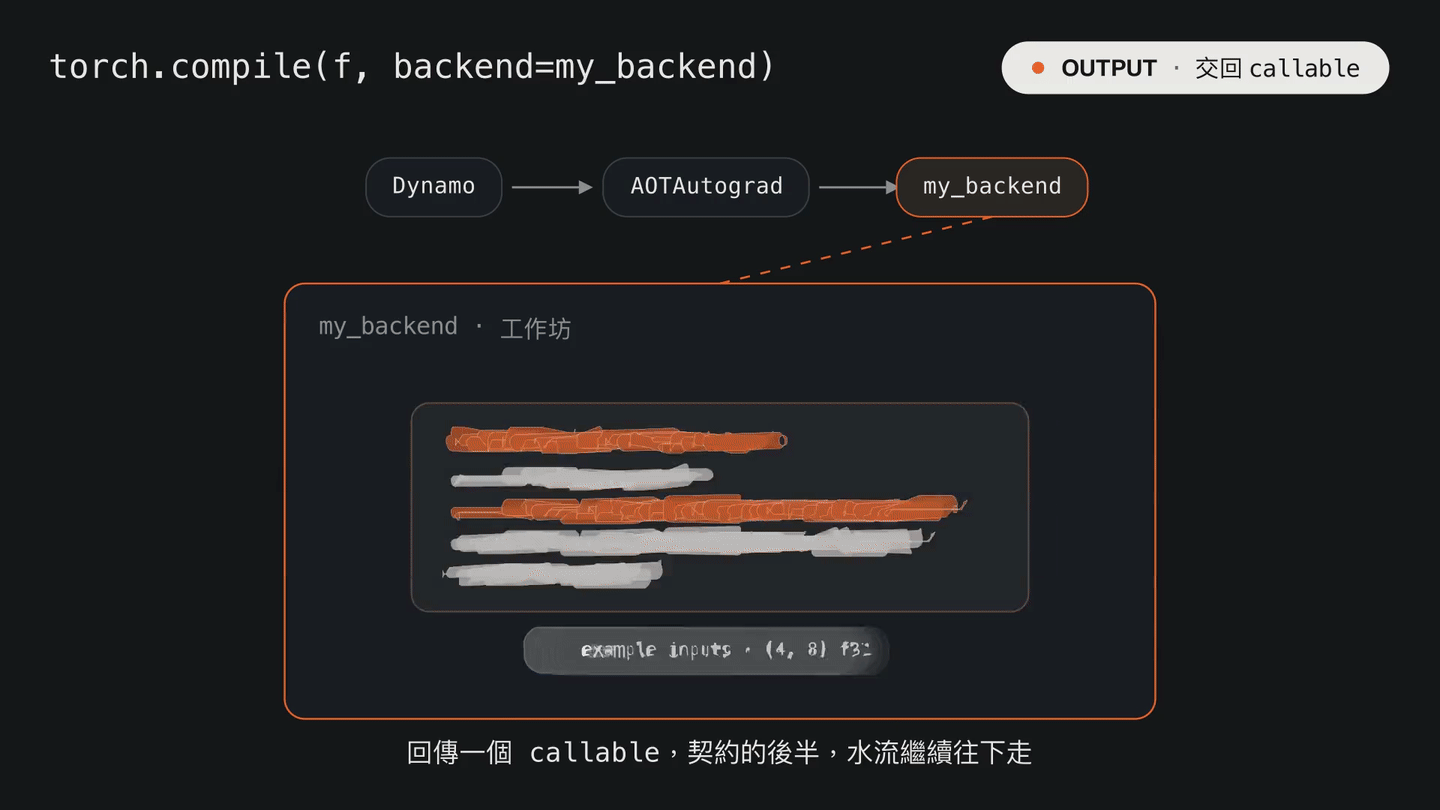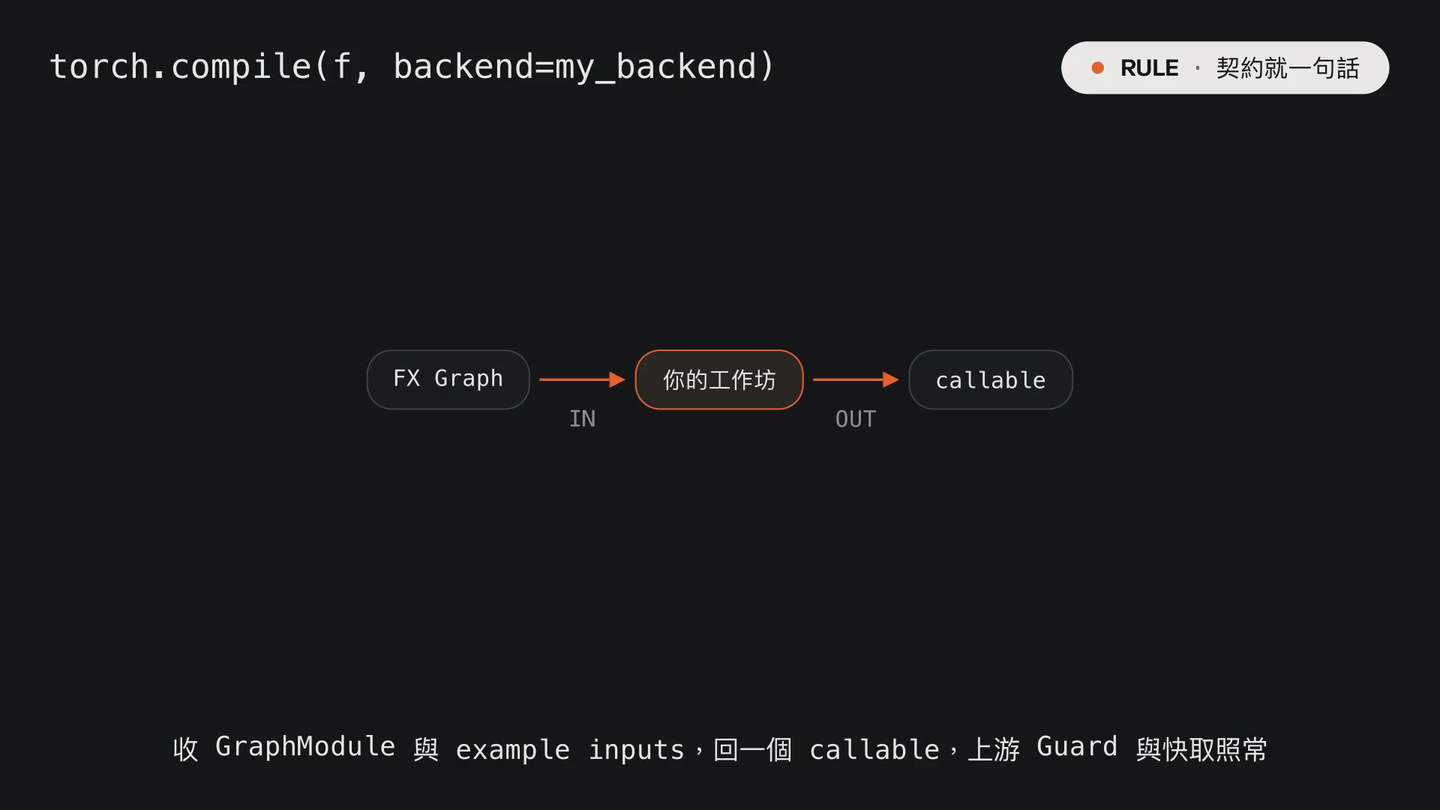
圖一:pipeline 第三站的交接。Inductor 的廠房被拔下,插上自己的小工作坊,一張 FX Graph 流進來,逐 node 檢視,把 relu 換成 sigmoid,交回一個 callable,水流繼續往下走,上游的 Guard 與快取渾然不覺。
Dynamo 層的圖貼近使用者,但對編譯器來說太高階,in-place 和 view 還在,backward 也還沒展開。這些是 AOTAutograd 負責的髒活,不用自己重寫,用 aot_autograd 把自己的編譯函式包起來,就能站到跟 Inductor 一樣的位置。
def fw(gm, example_inputs):
    print("[wrapper] fw_compiler got:")
    print(gm.graph)
    return gm.forward

aten_backend = aot_autograd(fw_compiler=fw)
同一個函式再編一次,fw 收到的圖換了一副面孔。
[wrapper] fw_compiler got:
graph():
    %arg0_1 : [num_users=1] = placeholder[target=arg0_1]
    %relu : [num_users=1] = call_function[target=torch.ops.aten.relu.default](args = (%arg0_1,), kwargs = {})
    %add : [num_users=1] = call_function[target=torch.ops.aten.add.Tensor](args = (%relu, 1), kwargs = {})
    return (add,)
node 的目標從 torch.relu 變成 torch.ops.aten.relu.default。這是一張 ATen 圖,每個 node 都換成了 PyTorch 底層那組 operator,純函數式、operator 集合小而穩定,正是編譯器該吃的形狀。需要訓練的話再多傳一個 backward 用的編譯函式就行。Inductor 的正職也是當 aot_autograd 手下的編譯函式,我們此刻站的就是它平常站的月台。兩層各有客群,做貼著使用者程式碼的分析工具就留在 Dynamo 層,接真正的 code generator 就包一層下到 ATen 層。
最後一步是掛牌。傳函式物件只有自己能用,用 register_backend 給它一個名字,任何人都能用字串指名。
list_backends(): ['cudagraphs', 'inductor', 'onnxrt', 'openxla', 'tvm']
registered: True
observer calls via registry: 1
list_backends() 列出的就是這張註冊表。名單裡的 onnxrt、tvm、openxla 全是靠同一套機制接進來的第三方後端,套件裝好名字就自動出現。我們的 observer 掛上名字後,用 backend="day28_observer" 一樣叫得動,計數器如實跳了一格。所謂生態系插槽,拆開來就是一個 dict 加一點套件掃描。
老實說,多數人永遠不需要寫 backend,Inductor 已經很好,加速交給它就是了。值得動手的場景有三種。
回頭看,今天沒有學新機制,而是把整個系列的知識換一個站位再用一次。契約是收 GraphModule 和 example inputs、回一個 callable。上游的 Guard、快取、dynamic shape 對自訂 backend 一視同仁。一開始畫地圖時說第三站可以換,今天真的換給你看。
不過 torch.compile 再怎麼換後端都還是一個 JIT,編譯發生在部署機的第一次呼叫,Python 直譯器也一直在場。想把編譯徹底搬到上線之前,甚至讓成品脫離 Python、在 C++ 環境裡直接執行,就需要另一條路。明天來看 torch.export 和 AOTInductor 這對搭檔,把整條 pipeline 從即時編譯改成事先出貨。那我們明天見!


 iThome鐵人賽
 看影片追技術