
30 天前,這個系列從一個很簡單的問題出發,一行 torch.compile 背後到底發生了什麼。它常被當成黑魔法,加上去就變快,卻很少人說得清快在哪、為什麼沒效。今天是最後一天,不打開新的原始碼,只把前面二十九天拆下來的零件收回同一張桌上,拼成一張帶得走的地圖。這張地圖只回答三個問題,什麼時候快、為什麼慢、壞了怎麼修。正文開始!
一行 torch.compile 落下之後,程式依序經過四站,這是開頭畫過的骨架,只是每站的行李都重得多。
第一站 Dynamo 把圖從 Python 手裡拿出來。Day 3 看到它靠 CPython 的 frame evaluation hook 在 bytecode 執行前攔截,Day 4 和 Day 5 看到它逐條模擬指令、用替身物件追蹤值,Day 6 的 Guard 記下這張圖成立的前提,Day 7 到 Day 9 則把被改動的狀態記帳、把圖存進中央倉庫、改寫出新的 bytecode。碰到吃不下的東西就 graph break,Day 10 看到一次 break 把函式切成兩張圖中間夾一段 eager,Day 11 讓 shape 可以是符號,一張圖吃下所有 batch size。
第二站 AOTAutograd 把 forward 圖展開成能訓練的樣子。Day 12 把 forward 和 backward 一起 trace 成 joint graph,Day 13 的 functionalization 讓 in-place 和 view 從圖裡消失,Day 14 把大 op 拆成基本運算,Day 15 用 min-cut 決定 backward 存誰、重算誰。全程踩在 Day 16 的 FakeTensor 上,只推形狀、不算數值。
第三站 Inductor 把圖變成程式碼。Day 17 和 Day 18 把 ATen 圖 lower 成 loop-level IR,Day 19 和 Day 20 由 scheduler 依讀寫關係決定誰跟誰融合,Day 21 和 Day 22 分別生出 GPU 的 Triton 和 CPU 的 C++,Day 23 用 autotune 挑最快的寫法,Day 24 把成品鎖進快取,編譯費只付一次。
最後一段是執行期與實戰。Day 25 的 CUDA Graph 把整串 kernel launch 錄成一次 replay,Day 26 診斷 recompilation 爆炸,Day 27 整理除錯工具,Day 28 動手寫了一個 backend,Day 29 用 torch.export 和 AOTInductor 讓模型不帶 Python 也能跑。
這四站不是黑箱接黑箱,每站的中間產物都印得出來,Dynamo 的 FX Graph、AOTAutograd 的 ATen 圖、Inductor 的 kernel 都是。任何一站出狀況,你都能停在那站把東西攤開來看。
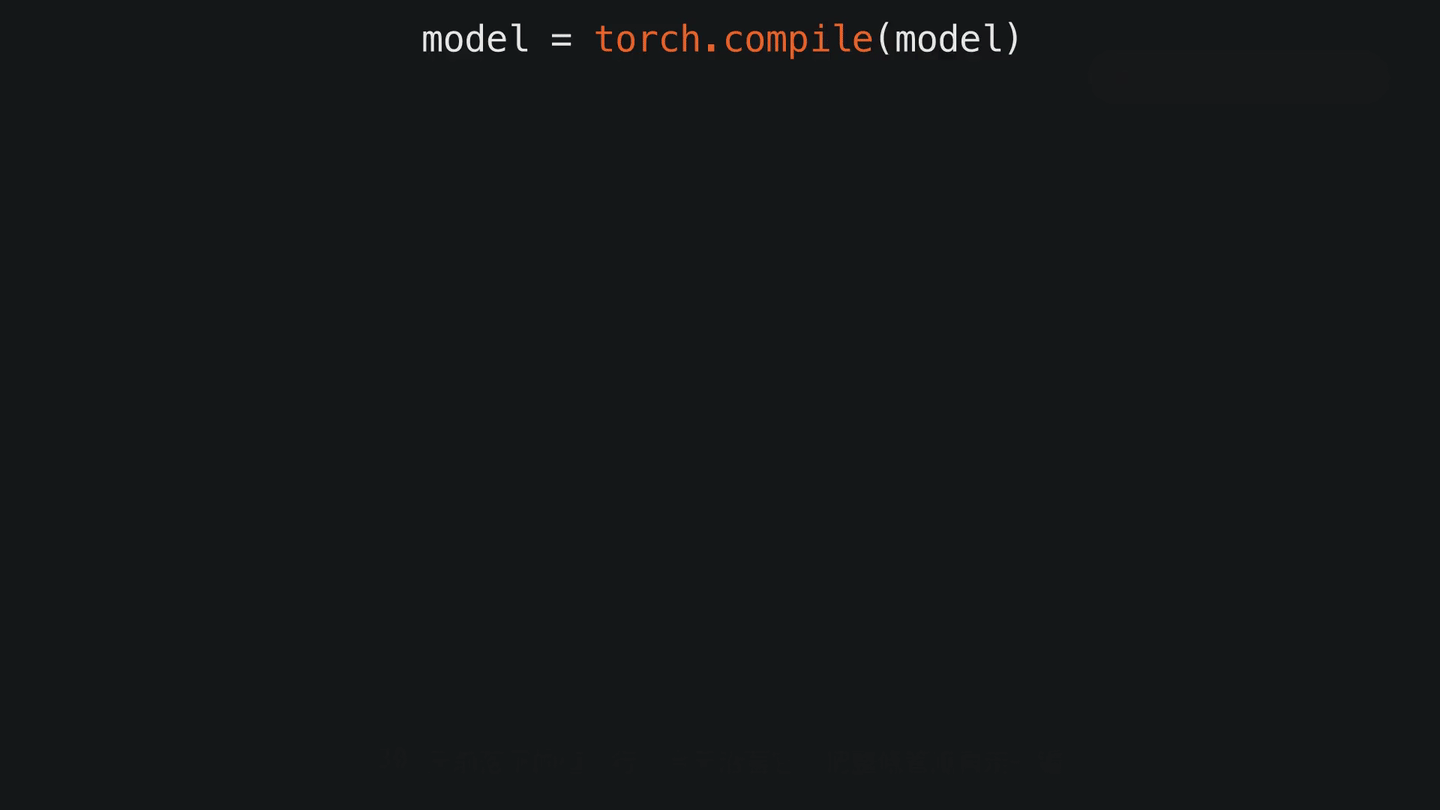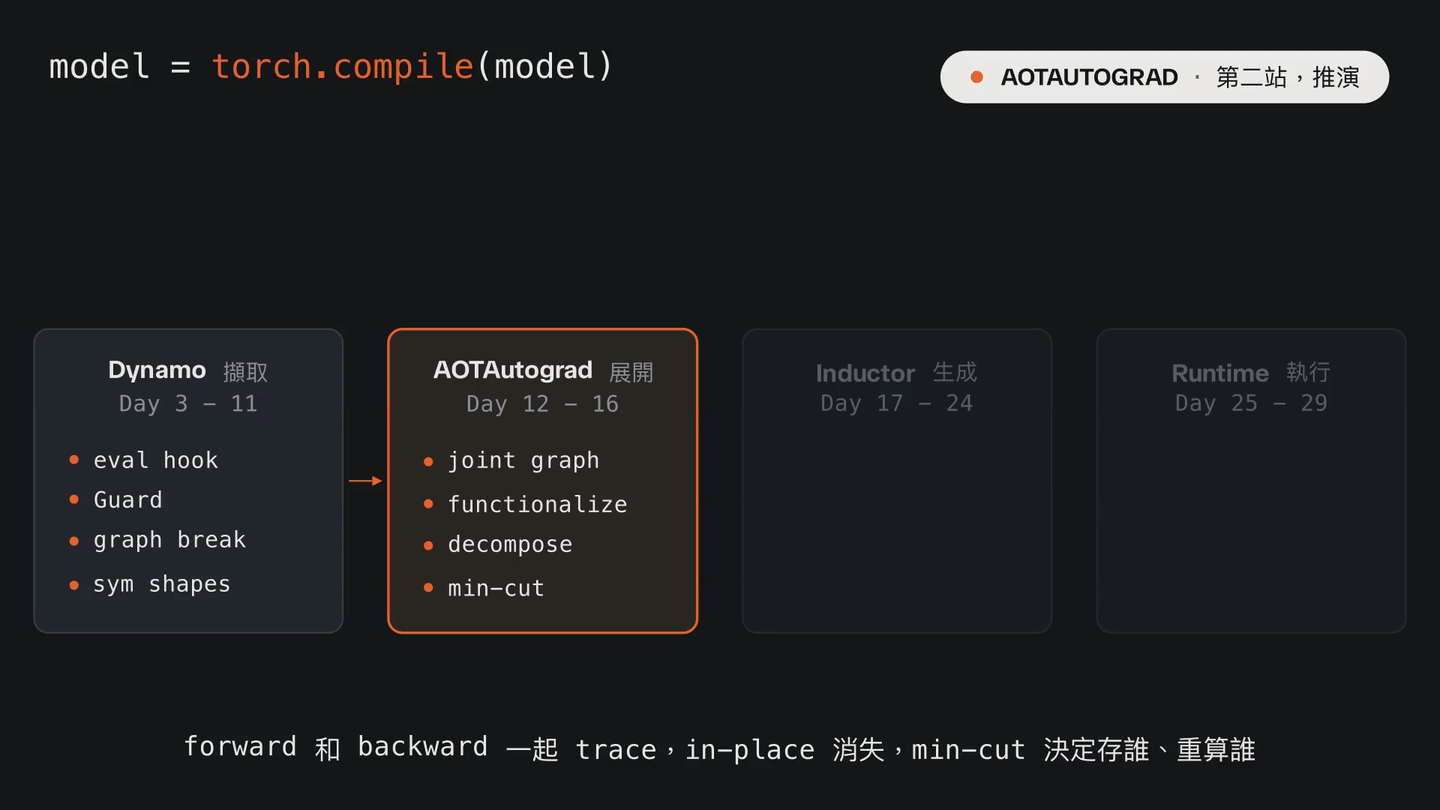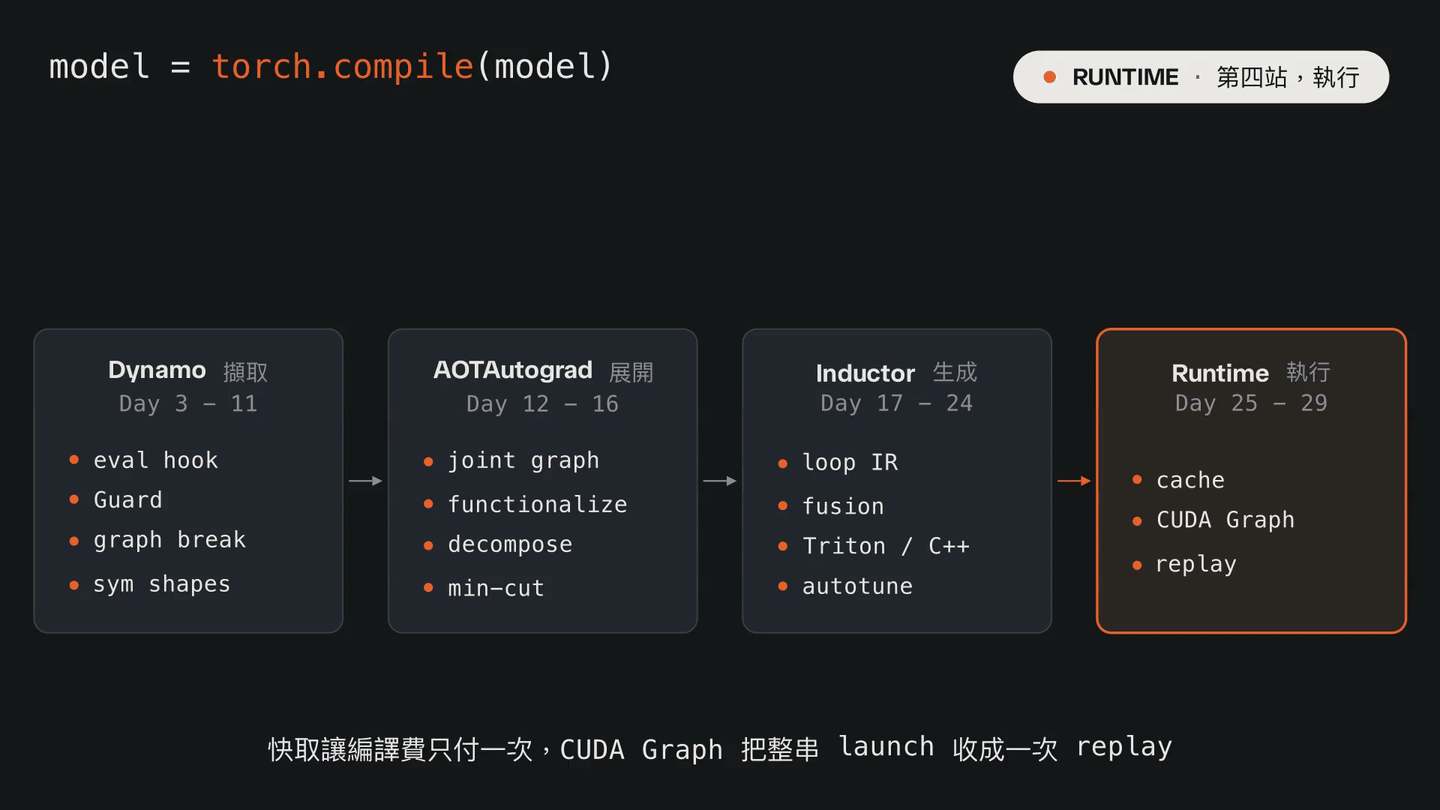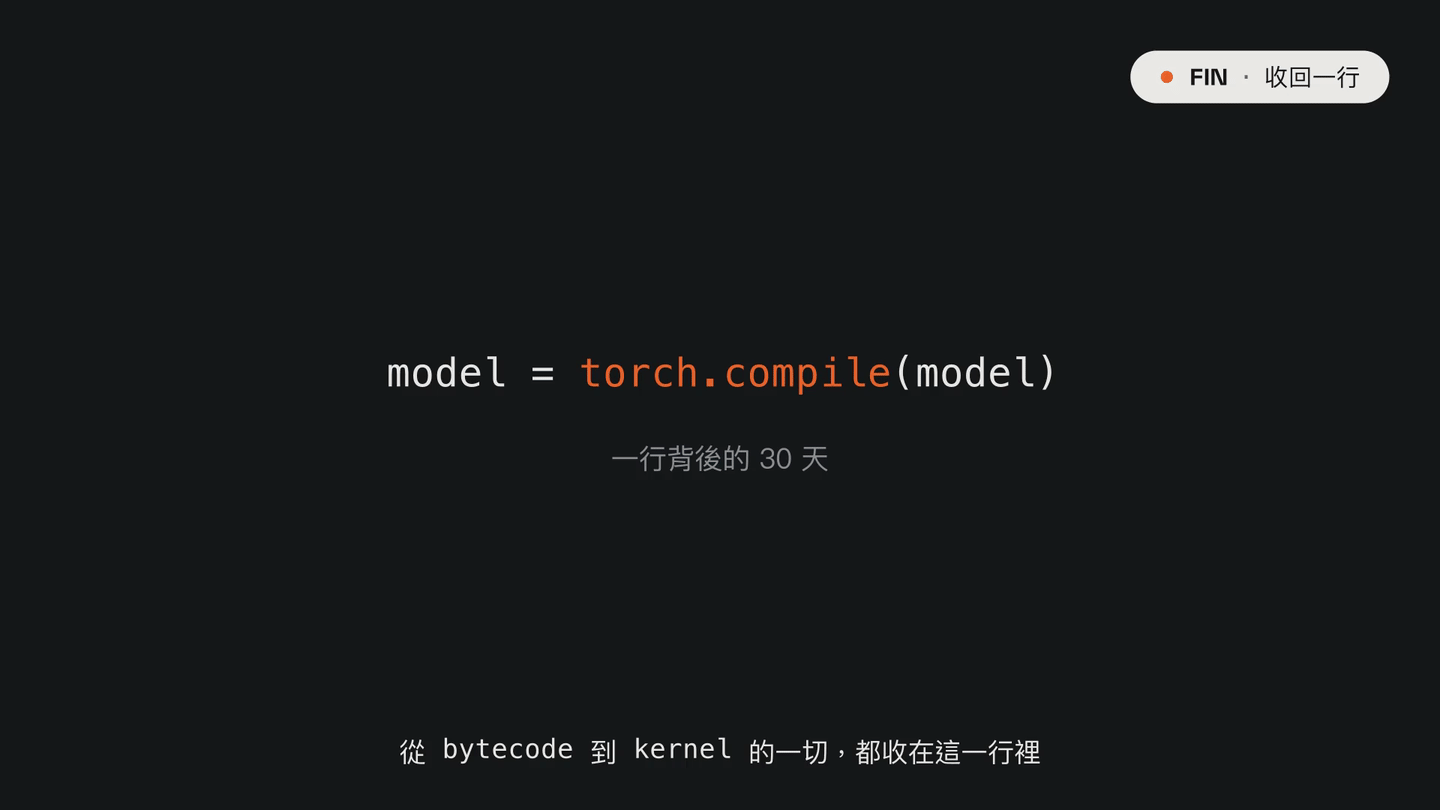
圖一:30 天的路線圖。一行 torch.compile 落下,鏡頭沿 pipeline 走過四站,Dynamo 亮起 eval hook 與 Guard,AOTAutograd 亮起 joint graph 與 min-cut,Inductor 亮起 fusion 與 Triton,執行期亮起 cache 與 CUDA Graph,最後整條 pipeline 一起點亮,收回最初的那一行。
實測過的加速來源有三種,各自挑體質,所以「加了會快多少」只能實測。哪一種輪得到你,只看一個問題,你的模型把時間花在哪裡。
慢的原因也量過三種,差別在這筆成本付在哪個時間點。
這三種慢都不是 bug,而是設計裡明碼標價的成本。重點不是成本存不存在,而是你付出去的有沒有賺回來。每小時重啟一次的服務,和編一次跑一個月的訓練 job,對同一筆帳的感受完全不同。
把散落的工具收成一個固定順序,先數圖、再數編譯、最後看產物。
torch._dynamo.explain 列出每張圖、每個 break 的位置和原因,fullgraph=True 把 break 升級成錯誤,TORCH_LOGS="graph_breaks" 適合掛在長跑的 job 上。兇手常不在報告第一行,而在被 inline 的函式深處。TORCH_LOGS="recompiles" 印出哪一條 Guard 沒過,shape 引起的可以用 mark_dynamic 提前宣告,順便把「符號被默默押死」變成大聲的失敗。啟動變慢就查快取,先看 counters 是 hit 還是 miss,再開 log 對鑰匙。TORCH_LOGS 印出中間產物,看誰跟誰融了、生出來的 kernel 是不是你想的那顆,perf_hints 還會告訴你 CUDA Graph 有沒有真的上車。如果要把整個系列壓縮成一個觀點,筆者會選這個,編譯器就是一連串「先付出、後回收」的賭注。Dynamo 付出 trace 時間,賭 Guard 之後每次都通過。特化把常數烤死,賭它不會變。fusion 和 autotune 燒掉編譯時間,賭執行次數夠多。CUDA Graph 押死位址,賭 shape 穩定。快就是賭贏了,慢就是賭輸了,修就是弄清楚它替你下了什麼注,然後幫它把注下對。有了這個視角,torch.compile 就不再神秘,它只是一個把賠率誠實寫在 log 裡的賭徒。
系列到這裡就完賽了。第一天說過,這些問題都有明確的答案,只是需要耐心打開那個超大的黑盒子。三十天下來,希望這個盒子在你眼裡已經透明。整個系列的文章、實驗程式、log 和動畫都整理在 gmc-ithome,每篇引用的數字都能在對應的 code 目錄裡重跑出來。
如果想繼續往下走,給三個方向。第一個是官方的 Dynamo deep dive 和 troubleshooting 文件,很多這裡用比喻講的東西,那邊有正式名字。第二個是 ASPLOS 的 PyTorch 2 論文,那是整套設計的正式論述,讀到這裡的你應該不會吃力。最後是原始碼本身,挑一個講過的檔案,開著 log 拿自己的模型對照著讀,不懂的分支就寫個小實驗踩出來,那是理解最深的一條路。
最後,謝謝一路讀到這裡的你,也謝謝「源來適你」的小夥伴們陪著走完。第一次參賽就選了這麼硬的題目,能寫完靠的是每天知道有人在等更新。願你下次再看到那行 torch.compile,看到的不是黑魔法,而是一條你親手走過的 pipeline。


 iThome鐵人賽
 看影片追技術