

品管圈成果發表會,下午最後一場。三位評審都做了十幾年,其中兩位還帶過自己的圈。評分表是五分量表,八個項目。
同一份報告,三個人交上來的總評是四分、三分、二分。差兩級——在五分量表上,那是「這組做得不錯」和「這組沒抓到重點」的差別。
散會後,品管承辦同仁彙整電子評分紀錄,邀請評審核對分歧,我也一起參與討論。這是團隊定期校準判準的工作,不是為了裁決誰對,是為了看評分表哪裡出問題。
給四分的那位說:「他們資料收得很紮實,前後測都有,圖表也做得清楚。」
給二分的那位說:「真因驗證是跳過的。他們從魚骨圖直接跳到對策,中間那一步沒做。」
第三位聽完兩邊,說了一句讓我記到現在的話:「你們兩個講的我都同意。」
這才是真正麻煩的地方。不是有人看錯了,是三個人看的是同一份報告的不同部分,而且各自的理由都成立。
你這禮拜大概也遇過同一件事:同一支 PR 換一個人審,結論就變。哪些 comment 是必改、哪些只是意見、這個 case 算不算 blocker——你們心裡都有一把尺,而那把尺沒寫下來,也沒量過彼此差多少。
差別只在於:我們的評分表是寫下來的,寫下來還是不一致。 這件事打掉一個很常見的幻想——「把標準寫清楚就好了」是不夠的,寫清楚只是把不一致從無限縮到有限。怎麼再往下縮,明天整篇談。
這叫評分者間信度(inter-rater reliability)。品質評分的原罪就在這裡:判準是文字,文字要人解讀,而解讀會分岔。這不能靠「找更資深的評審」解決——越資深的評審,判斷框架越完整,也就越不一樣。
不一致有三種型態。混在一起看什麼都看不出來,拆開來就各有各的修法:
| 型態 | 長相 | 能不能修 |
|---|---|---|
| 系統性偏移 | 某位評審整體就是給得比較嚴。他排出來的名次跟別人一樣,但絕對分數低一截 | 好修。分數不能直接比,排序可以用 |
| 界線不重疊 | 大家對「很好」和「很不行」都同意,但「還可以」跟「不太行」之間那條線,畫在不同地方 | 難修,但這正是要修的東西 |
| 隨機分歧 | 同一位評審換一天看同一份圈報告,會給不同分 | 修不了,只能靠增加評分者去稀釋 |
人最常見的是第二種。 而且它有個特徵:分歧集中在中間,兩端幾乎不會吵——開場那三位評審沒有一個人把它評成五分或一分。這跟你們的 severity 分級一模一樣:P0 跟 P3 沒有人吵,P1 跟 P2 之間永遠在吵。
量這件事有兩把尺,kappa 和 ICC。公式我不打算講,網路上到處都是,而且你要的不是公式:
這是我讀這類文章最不耐煩的地方:講了一堆係數,然後不告訴我門檻。所以我要說明我為什麼也不給——那是一個決定,不是一個省略。
第一,門檻是用途的函數,不是統計的函數。 同一個一致性水準,拿來「挑哪幾份送人複核」和拿來「決定這個單位年度考評扣幾分」,該要求的高度差非常遠:前者判歪是某位同仁多花二十分鐘看一份沒問題的病歷,後者判歪是一整個單位一年的士氣。你不會用同一條 SLO 去管一個內部工具跟一個對外收錢的 API——信度門檻也得跟後果一起訂。
第二,單列一個係數,讀者無法判斷它適用在哪裡。 沒有交代評分對象、判準版本與比較方式,數字就容易脫離情境被拿去套用——那正好是 Day 19 一直提醒的事。
我能給的是三件立刻用得上的事:
一、看排序,不要看絕對值。 如果評審之間只是系統性偏移,名次是一致的——那你就可以用它排出「哪幾份最該送人看」,即使分數本身不能比。大多數場景要的是排序,不是絕對值,而排序的信度門檻遠低於絕對值。 你們的 alert 也一樣:真正要的是「先看哪一個」,不是「這一個的嚴重度精確等於幾」。
二、逐項目看,不要看總體。 總體的一致性數字沒有行動價值,它是八個項目平均出來的,好項目會把壞項目蓋掉。你要的是一張逐項目排序的清單——最不一致的那一項,就是你明天要改的那一項。
三、看到低一致性,先去看送進去的案例。 ICC 對「這批案例有多不一樣」非常敏感。送去評的圈報告品質都差不多,ICC 就會很低——不是評審不一致,是根本沒有東西可以區辨。這跟一組全綠、其實什麼都沒斷言的 unit test,是同一個病。
還有一件事沒有門檻可談,但一定要記得:一致不等於對。三個評審一起錯得很整齊,ICC 一樣很漂亮。 信度是效度的必要條件,不是充分條件——這個順序 Day 19 講過。
這一段在工程上最容易做錯,而做錯了不會報錯,只會給你一個看起來很正常、其實不能解讀的數字。
一、完全交叉:每個評分者要評同一組案例。
最常被違反的一條。實務上很自然會變成「評審 A 評前十份,評審 B 評後十份」——效率高,但這樣算不出評分者間信度:沒有任何一份圈報告被兩個人評過,你只會得到兩組不能互相比較的分數。
搬到 AI 流程也一樣:為了省 token 讓三個模型各跑三分之一的案例,等於什麼都沒驗到。要量一致性,就必須付出重複計算的成本——你也不會為了省時間,讓每個 test 只在三分之一的 commit 上跑。
二、每一格必須獨立產生。
評審之間不能互相看到分數,看到了就會收斂——收斂出來的一致性是假的。所以共識會議永遠是「先各自打分,再開會討論歧異」;順序反過來,你量到的是誰講話比較大聲。
AI 流程裡的具體形式是:不要把三個模型串成一條鏈讓後面的看到前面的輸出,要並排跑,各自拿到一樣的輸入。這聽起來理所當然,但只要用的是某種 agent 框架,很容易在不注意的時候讓 context 洩過去。
三、每一格要有理由文字,不能只有分數。
分數用來算一致性,理由用來做根因分析。只有分數,你會知道「第四個項目大家不一致」,但不知道為什麼——而「為什麼」才是你要拿去修評分表的東西。
開場那三位評審就是這樣:光看四分、三分、二分,你什麼也不知道;要等他們講出「資料收得紮實」跟「真因驗證跳過了」,才看得出問題出在評分表沒規定這八個項目之間怎麼權衡。
四、必須是同一把尺。
同一版評分表、同一版 prompt、同一個模型版本。中途換了任何一項,前後的分數就不是同一個測量。所以 prompt 要當成有版本控的資產來管(Day 27 談),而且有個不直覺的推論:你不能一邊改 prompt 一邊看一致性有沒有變好,除非每改一次就重跑整組案例。 案例池要固定、要能重跑——它就是你的 regression suite。
五、空格不能安靜地消失。
跑批次總有幾格是空的:某個模型對某一份圈報告吐出來的東西,parser 接不住。只留下「所有評分者都有輸出」的案例方法學上乾淨,但被剔掉的那幾份,很可能就是最難的那幾份(Day 19 講過這個偏誤,這裡是第二次現身)。所以剔掉多少、剔掉的長什麼樣子,要跟一致性報在一起。
把 N 個模型當成 N 個評分者,用同一套信度工具去量——這個決策的回報比我預期的大,因為量下去之後看到的東西跟量人不一樣。
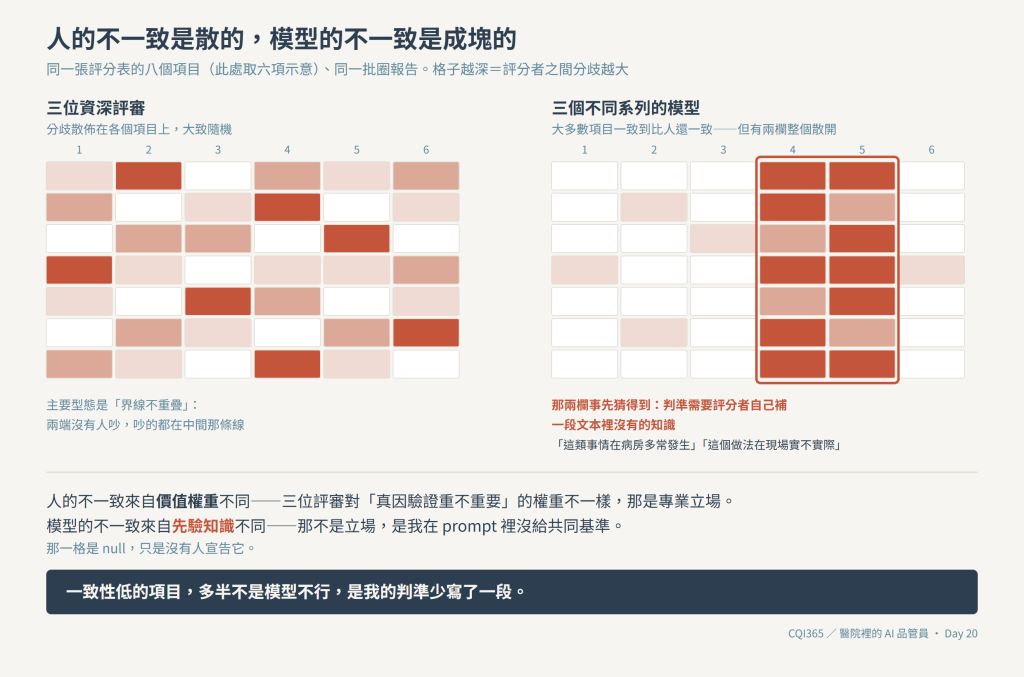
人的不一致是散的,模型的不一致是成塊的。
人那邊,分歧散佈在各個項目上,大致隨機,主要型態是「界線不重疊」。模型不是這樣:大多數項目上模型彼此高度一致,一致到比人還一致;但有少數幾個特定項目,模型會集體散開。 不一致不是均勻攤在整張評分表上,是集中在幾個格子裡。
而且那幾個格子事先猜得到:
| 項目的性質 | 模型之間 |
|---|---|
| 判準可以直接從文本讀出來(有沒有寫前後測、有沒有列出對策負責人) | 高度一致 |
| 判準需要評分者自己補一段文本裡沒有的知識(這類事情在病房多常發生、這個做法在現場實不實際) | 明顯散開 |
原因不難理解,但很關鍵:
人的不一致來自價值權重不同,模型的不一致來自先驗知識不同。
三位評審對「真因驗證重不重要」的權重不一樣,那是專業立場的差異。三個模型對「這類事件一年大概發生幾次」的估計不一樣,那不是立場,是它們各自從訓練資料帶來的世界模型不同——我在 prompt 裡沒給共同基準,那一格是 null,只是沒有人宣告它。
這改變了我對「一致性低」的解讀:
一致性低的項目,多半不是模型不行,是我的判準少寫了一段。
它把一個看起來無解的問題(模型就是不一致啊),變成一個有動作可做的問題。明天整篇談怎麼補。
還有一件量人不會遇到的事:給模型一個一到五分的量表,它們明顯傾向避開兩端——大量的三分,少數四分和二分,幾乎沒有五分和一分。
這個傾向麻煩在它看起來像好消息:大家都給三分,一致性當然很高。但這種一致性不區辨——一整批分數幾乎一樣的結果,排不出優先順序,也挑不出該送品管室複核的圈報告。它跟 flaky 剛好相反:flaky 你一眼看得見,這一種你看不見。
這是前面「ICC 對案例間差異敏感」的鏡像:不是案例沒拉開,是評分者自己把分數壓扁了。所以看一致性一定要同時看分數分佈。一個給分全部集中在中間的評分者,和一個亂給分的評分者,在信度指標上可能長得一樣,但前者更難發現。
而「往中間靠」是有方向的失效——有方向就修得動:寫錨點時把兩端寫成明確可判定的條件,讓它有依據敢給。這是明天的事。
人的評分者間信度一年做一次已經很奢侈:湊齊三位資深評審坐下來評同一批圈報告,成本高到只能當研究做。換成模型評分者之後,成本結構整個改變:
固定的案例池
   ↓
三個獨立模型並排評分(同一版評分表、同一批案例)
   ↓
逐項目算一致性 + 逐項目看分數分佈
   ↓
輸出:一份「哪些項目最不一致」的排序清單
   ↓
改評分表 → 重跑整組 → 看那幾個項目動了沒有
這條迴路可以每天跑。它把「調評分表」從憑手感改成有回饋訊號的迴圈——改了一句話,立刻知道哪個項目變好、哪個變壞。
**這條迴路我還沒有真的跑起來,是我打算這樣做。**而我想要它的理由,你大概比我更清楚:你們有 CI 之後才敢重構——我要的是同一個東西,只是我改的不是程式碼,是評分表。
模型不是在取代評審,是在用很便宜的方式,提前把評審會吵的地方指出來。
不需要 ICC,不需要三個模型,也不需要跟主管報備。
找一份上禮拜已經被評過、被審過的東西——一份圈報告、一份稽核回覆、一支已經 approve 的 PR 都可以。請第二個人在看不到第一份結論的情況下,用同一張表再判一次。然後把兩張表並排,圈出不一樣的那幾格,讀那兩個人各自寫的理由。
你不會得到一個係數,但你會得到一張清單,上面是你的判準裡沒寫完的地方。信度分析真正的產物一直都是這張清單,係數只是它的摘要。
明天處理那張清單上最頑固的一項:怎麼讓不同的評分者——人或模型——對「三分」有共識。


 iThome鐵人賽
 看影片追技術