

Day 1 留了一個反思:回看過去參與的預警系統,我曾把注意力放在模型預測得準不準,較少追問單位收到預警後怎麼接手。今天從那個案例裡的數字談起。
那套系統預測的是透析中低血壓(intradialytic hypotension,IDH)——洗腎病人在透析過程中血壓掉下來。一位病人每週來三次、一次坐四個小時,機器旁邊那位護理師手上不只他一個人。血壓掉下來的那一刻要有人處理,但在那之前的十幾分鐘,沒有人知道它要來。
我們做的就是把那十幾分鐘拿回來:接上透析機本來就一直在跑的那條監控訊號,加上病人自己的基線資料,在血壓掉下去之前先報出來。
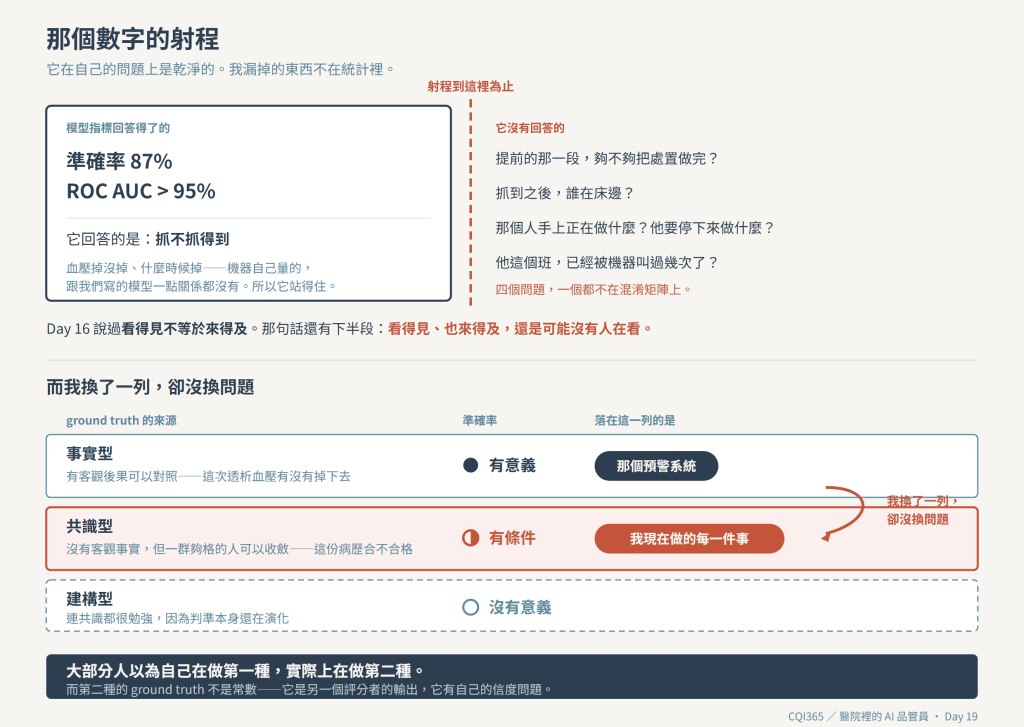
當時的模型指標是:**準確率 87%,ROC AUC 超過 95%。**這裡保留數字,是為了討論它回答了什麼問題,以及還漏了什麼。
那時候,我很容易把這個數字當成整套系統的成績,直到討論走到單位收到預警之後的流程。
而這篇要講的是那之後的事:
後來我才明白,那個數字回答的不是我真正該問的問題。
先說清楚免得誤會:我不是要說那個 87% 是假的。 它是真的——而且這是最麻煩的地方,它是這 30 篇裡唯一一個站得住腳的準確率。
準確率能成立,需要三個條件同時滿足:正確答案事先存在,在系統被建出來之前;它獨立於被測系統;它被相關的人同意,不是某一個人說了算。
IDH 三條全過。血壓掉沒掉、什麼時候掉,透析紀錄裡本來就有,是機器自己量的,跟我們寫的模型一點關係都沒有;而它要不要算數,沒有人會吵。
那是一個有事實可以對的任務。所以準確率、precision、recall、AUC 在那裡全部有意義,因為預測與後續紀錄之間有可核對的對象。
然後我換了一種材料。
回到品質工作,稽核小組要確認電子病歷的完整性,評審要看圈報告的方法論,病安小組要核對通報分類。我很自然地把同一個問法帶了過來:那這一套的準確率是多少?
這個問題在這裡沒有答案。不是「還沒算出來」,是問題本身不成立。
「這份護理紀錄晚兩小時補登算不算缺失」「這份圈報告的真因驗證做得算不算紮實」——這些命題沒有「正確」這個屬性,只有「站不站得住」。它可以被辯護、被推翻,但不能被查證。IDH 那邊有一台血壓計,這邊沒有。
撞到這面牆之後,品管界做的不是繼續找那組不存在的答案,而是換掉問題。不問準不準,只問兩件事:信度——這把尺穩不穩定,同一份病歷量兩次一不一樣,換一位委員量一不一樣;效度——這把尺量的是不是你真正想量的東西。
用你熟悉的說法:信度是 flaky test 的反面;效度是「你的測試測的是需求,還是測到你自己的實作」。
而且順序不能顛倒:先信度,後效度。 一把每次量都給不同讀數的尺,你連問它量得準不準都沒有意義。而幾乎每一場 AI demo 都是反過來做的:先秀一個好看的答案,然後再也不回頭問它下次會不會一樣。
那個 87% 在自己的問題上是乾淨的。我漏掉的東西不在統計裡。
那個數字回答的是「它抓不抓得到」。它沒有回答:抓到之後,誰在床邊、那個人手上正在做什麼、他要停下來做什麼,以及他這個班已經被機器叫過幾次了。
Day 16 講可偵測性時我寫過:預警系統就是把可偵測性做成產品,而看得見不等於來得及。那句話還有下半段,是我自己拿分數換來的:看得見、也來得及,還是可能沒有人在看。
那件事 Day 24 整篇談。今天只留一句當起點:我對一個系統問過最漂亮的一個問題,而它剛好不是最重要的那一個。
把場景換到你熟悉的地方。準確率、precision、recall、F1、benchmark 分數都不是壞東西,它們只是有適用範圍——而那個範圍,寫在你的標註是怎麼來的這件事上:
| 類型 | 正確答案從哪來 | 準確率有沒有意義 |
|---|---|---|
| 事實型 | 有客觀後果可以對照。這次透析血壓有沒有掉下去、這筆交易後來有沒有被判定為詐欺 | ✅ 有。這是準確率真正適用的地方 |
| 共識型 | 沒有客觀事實,但一群夠格的人可以收斂到共識。這份病歷合不合格、這份圈報告幾分 | ⚠️ 有條件。你得先證明那個共識本身是穩定的 |
| 建構型 | 連共識都很勉強,因為判準本身還在演化 | ❌ 沒有。這時談準確率是在自欺 |
IDH 落在第一列,我現在做的每一件事落在第二列。我花了好幾年才發現自己換了一列。
大部分人以為自己在做第一種,實際上在做第二種。
第二種的關鍵是:當正確答案來自共識,那組答案本身就是一個測量結果,它有自己的信度問題。你的 ground truth 不是常數,它是另一個評分者的輸出。
一、分母是誰定的沒人問。 這一年品管室看過不只一份 AI 病歷審查的評估簡報,第十幾張投影片上總有一個很大的數字,通常在九成上下。我學會的第一個追問是:那組正確答案是誰標的、幾個人標的。答案幾乎都一樣:一位很資深的病歷管理師。一位。
那個數字的意思因此變成:這套系統跟某一個人有九成的時候意見相同,而兩邊都沒有被驗證過。更遠的後果是:模型優化的目標變成「跟這個人像」。這是把 bus factor 寫進 loss function。
二、標註本身有雜訊,所以準確率的天花板不是 100%。 同一位委員隔一個月看同一份圈報告,分數會變。任何系統跟他的一致性,上限就卡在他的自我一致性——超過的部分不是變準了,是學會了模仿這位標註者的雜訊。這在機器學習裡叫 noise ceiling:一個宣稱準確率非常高的系統,在共識型任務上通常不是特別好,而是特別可疑。
三、類別不平衡。 當九成的病歷本來就合格,一個永遠回答「合格」的系統準確率就有九成。所以投影片上真正該出現的是兩個數字:它抓到的問題裡有幾成是真的、真的有問題的它漏掉幾成。這兩個你們有現成的名字,precision 和 recall;而前面那一個,我在 Day 9 給過它中文名字,當時就寫它比準確率重要:複核成立率。那五個字現在開始還債。
那些簡報看完的某一次散場,老周跟我一起走出會議室。他是資訊室的,話很少,但每一句都很難回答。他問:「那我們到底該問廠商什麼?」
要答得出這句,你得先知道:在沒有正確答案的地方,還能驗證什麼。
我把驗證拆成四個問題。它們能成立的唯一原因是同一個:都不需要標準答案,只需要「可比較的重複」。
問題一:一致不一致。 同一份輸入換一個評分者,結論會不會變?人與人之間的不一致是品質評分的原罪——三位資深評審看同一份圈報告,分數差兩級是常態。模型之間也不一致,且型態跟人不一樣,明天整篇談。只用一個模型你就看不見這個維度,你以為的「答案」其實是一次抽樣——跟只跑一次就宣告 flaky test 通過,是同一種樂觀。
問題二:穩不穩定——這就是自我一致率。 同一份輸入、同一個評分者,跑兩次一樣嗎?隔一個月再跑一樣嗎?這個東西 Day 2 已經命名過了,當時那句定義可以直接搬過來:這是 flaky,只是 flaky 的不是測試,是判斷。
它是四個問題裡唯一一個你今天下午就能跑出來的:不需要標註、不需要專家、不需要送 IRB,只要把同一批病歷存起來、定期重跑、比對。跑出不同答案的那幾份,就是你的判準最脆弱的地方。而「隔一個月再跑」有更難的版本:模型換版之後尺會悄悄換掉,而且不報錯——那是第五週的主題。
問題三:判不動的時候說不說得出來——這就是棄權率。 這一條接上 Day 16 的偵測性:系統能不能在「這份病歷我判不動」的時候說出來,而不是硬給一個判定?這個 Day 2 也命名過,那句話我現在收回來用——棄權率如果是零,不代表資料很乾淨,代表這個欄位沒有在運作。 一個從來不說「判不出來」的評分者,跟一個從來沒有 log 過任何一行 WARN 的服務,是同一種安靜。
你當然可以要它多輸出一個把握程度,它一定會給你一個數字;但那個數字跟它對不對的關聯比你以為的弱得多——後面有一整節在講,因為 Day 9 就卡在那裡。
問題四:對已知的壞東西有沒有反應。 前三個都在問系統跟自己、跟別人比起來如何;第四個是唯一能碰到「對不對」的路:如果我事先知道這份文件有問題,它抓不抓得到? 沒有標註資料,那就自己造——缺陷是你放的,於是你有了一組「不是共識、但確實存在」的正確答案。Day 22 整篇談,今天只留一句:沒有測資的時候不要放棄測試,要去造測資。你們叫它 fault injection,我們叫它陷阱池,是同一個念頭。
這四題接起來就是一條迴路:固定的案例池 → 幾個獨立評分者跑同一套判準 → 每一格都輸出(分數+理由+引用的原文句+把握程度)→ 一條獨立的 pipeline 去算前面那四件事。最後一段最重要:信度分析的產出不是拿來發表的指標,是拿來除錯的清單——一張「哪些稽核條目需要重寫」的清單。驗證那一條為什麼必須獨立,Day 23 整篇談。
決定一:用多個不同的模型,而不是同一個模型跑多次。 同一個模型調高 temperature 跑很多次,量到的是採樣雜訊;不同模型系列各跑一次,量到的是判準的歧義。我要的是後者,因為真正想知道的不是模型抖不抖,是我寫的那份稽核條目到底寫得夠不夠死。同一個模型跑一百次,會用同一種方式誤解你的判準一百次,然後給你一個非常漂亮、也非常沒有資訊量的一致性。
還有一條路我不選:拿當前最強的模型當標準答案,其他模型跟它比。 它很誘人,因為你立刻有了 ground truth;但那只是把某一個模型的系統性偏誤升格成標準——跟前面那位「一位,但非常資深」的標註者,是同一個錯誤換一件衣服穿。更基本的原則只點一句、Day 23 展開:造題目的模型不能改考卷。
決定二:每一格輸出都要帶著證據句。 評分的輸出不是一個數字,是四樣東西:分數、理由、它依據的原文句子、以及把握程度。第三樣最重要,而我這樣設計,賭的不是事後查核,是它會改變模型的行為——當你要求「給分必須引出病歷裡哪一句話支持它」,我希望模型找不到那句話的時候會退回一個保守的判定,而不是編一個很有道理的理由。**這一點我還沒有實測過,它是這條規則的設計意圖,不是我量到的結果。**但就算行為沒有改變,這條規則也還是划算的:它把「說服我」換成了「指給我看」,而後者事後查得動。
這也是「可歸責」的最後一哩。單位主管問「憑什麼說我們這份不合格」的時候,我要拿得出那一句話:一個給得出分數但指不出證據的系統,在我這一行不能上線——不是因為它不準,是因為它讓我沒辦法負說明責任。exit code 不能出席委員會。
決定三:把「無法解析」當成一種結果,不是一個雜訊。 跑批次總有一些輸出是壞的,工程上的直覺是重試,重試還是壞就跳過,記一行 log。問題在於:這些被跳過的案例不是隨機的。 它們往往是住院天數最長、轉過三個科、家屬有意見的那幾本病歷——最需要判斷的那幾份。丟掉它們,剩下的是被挑過的簡單題,你算出來的指標都被系統性高估了。所以解析失敗率要跟其他指標一起報:你不會接受一個只統計成功請求的延遲儀表板。
Day 9 全量跑完之後,我們要求每一筆判定多帶一個把握程度欄位,本意是拿來排複核順序。結果分佈擠成一團,判錯的跟判對的看不出差別。那一篇我只寫到「這個欄位排不了序」就停住了——我當時只知道它壞了,不知道它為什麼壞。
現在可以回答了,而答案就在前面那張三種 ground truth 的表上。
模型的把握程度反映的主要是**「這個答案有多典型」**,不是「有多對」。而錯誤的答案常常正好是最典型的那一個——最符合這一類病歷一般長相的那個判斷。兩者在最危險的地方對齊:一個穩定地、有自信地、往典型答案偏的系統。
而這件事在事實型任務上沒有那麼嚴重:IDH 那邊,信心有一個真的存在的事件可以校準——血壓掉了就是掉了。換到共識型任務,「對」本身沒有實體,它能校準的只剩下「像不像」。
把握程度不是壞掉了。是我把一個在事實型任務上堪用的欄位,原封不動搬到了一個沒有事實的任務上。
我沒有拿掉那個欄位,只是不再拿它當分流的唯一依據。它現在的用途是另一種信號:當多個模型的把握程度彼此分歧,那份病歷值得人去看一眼——不是因為誰沒把握,是因為他們對「這題難不難」都沒有共識。
信度這四題第四週會全部回答完,但效度沒有一篇能單獨回答,我要說明為什麼。
效度問的是「這把尺量的是不是你真正想量的東西」,而那個東西不寫在系統裡,寫在使用它的人身上——這份稽核清單有沒有讓病歷真的變好。它在第四週的任何一條 pipeline 裡都看不到,要到第五週由現場的行為來回答。Day 24 那個場景——護理長開啟電子稽核清單,前幾筆留有核對說明,往下捲卻有大量未完成的回覆欄——那就是一次效度檢定,只是沒有人把它叫做效度檢定。
這也是那個 87% 教我的事的通用形式:一個信度很漂亮的數字,跟一個回答了對的問題的數字,是兩件事。
回到老周那句話。我後來給他的清單是這五句——你明天要坐進哪一場評估會議,可以直接抄:
這五個問題沒有一個在問準確率。而一家廠商如果答得出這五題,投影片上那個數字是九十二還是八十七,已經不重要了。
如果你只帶一句話走:
準確率是拿系統的答案去跟正確答案比。當正確答案不存在的時候,你只剩下拿它跟自己比、跟別人比、跟你刻意造出來的錯誤比——而這三條路,其實一直都比較誠實。
這一半的驗證工作就是這個系列在講的那一半:規則寫不下來的那一半。你的系統裡也有——哪些 PR 該擋、哪個 alert 值得半夜叫人、這份設計文件算不算寫完了。你沒有 ground truth,只有共識,而你多半沒量過那個共識有多穩。
明天先處理最基本的那一塊:人跟人之間,本來就不一致。這不是意外,是原罪。


 iThome鐵人賽
 看影片追技術