
Day 10 的實驗很單純:把 PRD v1.0 貼給兩個模型,各跑五次,看它們產出什麼測試案例。
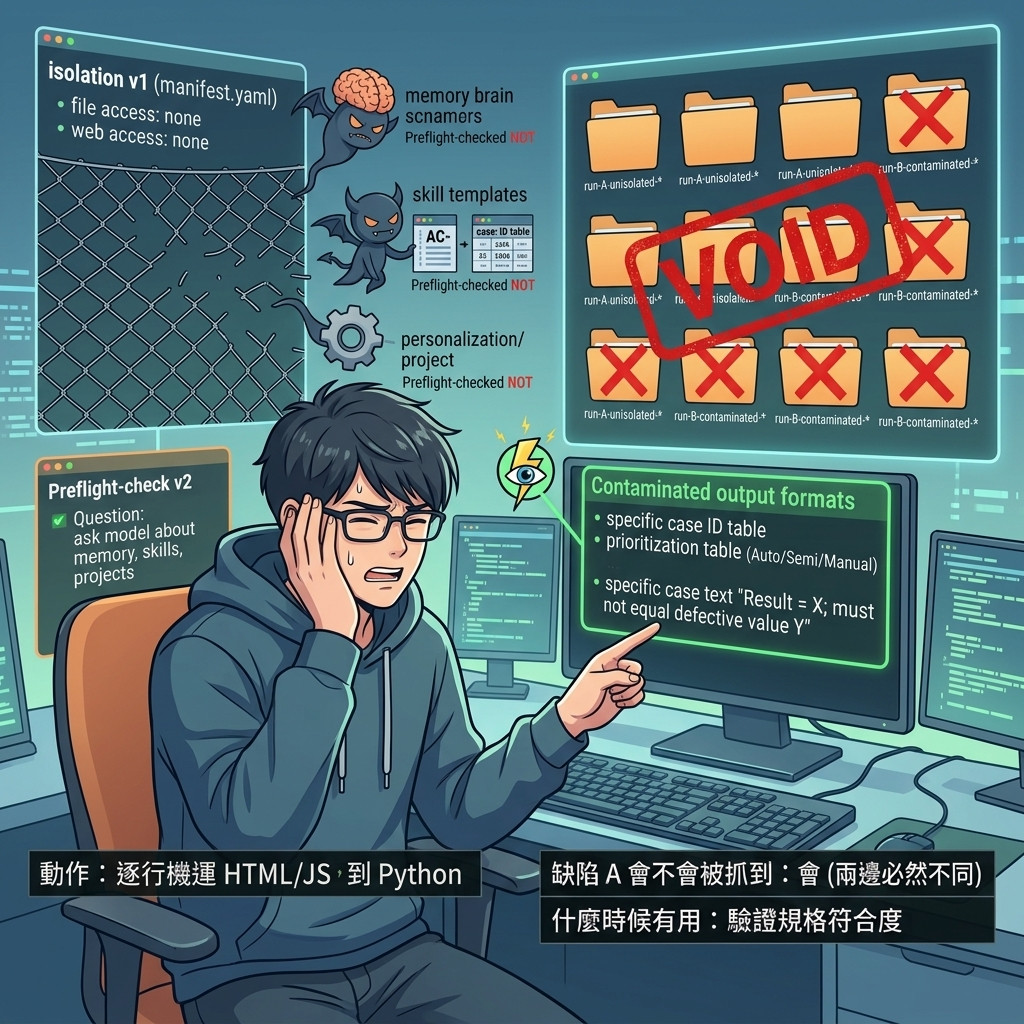
我為它寫了一份 manifest.yaml,跑之前寫完,裡面有分類規則、驗收門檻,還有一節叫 isolation——受測模型能拿到什麼、不能拿到什麼。那一節當時只有兩行:
isolation:
  file_access: none
  web_access: 能關就關
理由寫得很清楚:repo 裡有受測物原始碼、有十個歧義現場的裁決、有 golden set 裡直接寫著缺陷名稱的欄位。給了就等於發答案卷。
我以為隔離做完了。
跑出來的東西是這樣:
| 案例數 | 輸出長度 | |
|---|---|---|
| 模型 A | 13–16 條,中位 14 | 1,448–1,957 字元 |
| 模型 B | 42–60 條,中位 53 | 8,916–12,711 字元 |
同一份規格、同一個提示詞,產出量差了將近四倍。
而 B 不只多,還好得多。它的每一條案例都有可以直接比對的數值,而且附了「不得等於」的錯誤實作值。以下四行出自同一份輸出(第一次生成):
AC-002  結果 = 1,061,677.81;不得等於 1,060,000(即不得採 (1+r)^(1/12))
TG-001  目標金額 = 12,600,000;不得等於 20 期的 12,000,000
TG-002  目標金額 = 1,171,428.57;不得等於期末年金結果 1,115,646.26
TG-003  目標金額 = 2,195,370.24;不得等於以 A_r 為通膨基準的 1,212,000
看到這四行的時候我起了雞皮疙瘩。那是我的四個缺陷:期初期末、多算一年、通膨基準、名目月利率——它從一份只有十條條款的規格書裡,把它們全部反推出來了。
我當下的解釋是:PRD 的措辭本身洩漏了修正方向。我是在知道缺陷之後才寫那份 PRD 的,所以每一條都寫成了「修正」的樣子,寫「統一採名目月利率」的人,等於在說「有東西沒統一」。
那個解釋很漂亮。而它是錯的,或者說我沒辦法證明它是對的。
先是格式,B 的輸出裡有這些東西:
AC/TG/WD⋯我的提示詞裡沒有任何一句提到優先級、自動化分級或命名規則。那些是測試設計的一部分,我刻意不給。
翻開我自己的 skill 目錄,找到 qa-test-docs 底下的 templates/test-case-template.md。逐行對照:自動化三級表在範本第 11–19 行,命名規則表在第 23–33 行,七欄表格在第 41 行。連 AC 這個前綴都是範本裡的例子。
而那個 skill 的 description 自己寫著:
即使使用者只提到其中一份文件(例如「幫我寫 test case」),也應觸發此 skill 來確保格式一致。
它設計上就是要自動生效。我沒有呼叫它,它自己來了。
然後是第二個。對話框那個「+」選單裡,memory 是預設勾選的。而我跟同一個模型討論過整整九天的四個缺陷。
所以那四行「不得等於」現在有兩種解釋:
兩種都說得通,而我沒有辦法分開它們。作廢的理由不是它答錯。是我無法說明它為什麼答對。
A 那邊沒有 skill、沒有掛任何檔案,五份輸出也看不到任何回憶的痕跡:沒有套範本、沒有指向缺陷的斷言,13 到 16 條案例幾乎是 PRD 條款的逐條轉寫。
但我還是把它們標記作廢了,理由跟 B 完全不一樣,我說不出它是在哪裡跑的。
manifest 裡有一格叫 name,本來要填介面上顯示的完整版本字串。我留著 __待填__ 就 commit 了。interface 那一格寫的是 chat。而那個模型有兩個完全不同的入口:消費端的 app 有記憶、有個人化;開發端的 playground 兩者都沒有。注入面差很多,而我沒有記下我在哪一邊。事後回想也救不了。我對自己講過兩個版本,而那十份輸出裡沒有任何一行可以判定哪個才對。
「看起來乾淨」不是乾淨。如果我因為結果看起來沒問題就放行,那就是用結果去判定方法有沒有效——這系列從 Day 6 的容許誤差開始,一路在避免的就是這件事。條件沒滿足就標記,不管結果長什麼樣。
| 污染源 | 我原本想到了嗎 | 預設狀態 |
|---|---|---|
| 檔案存取 | ✅ 想到了 | 需要手動掛 |
| 網路搜尋 | ✅ 想到了 | 視介面 |
| skill | ❌ | description 寫著「使用者只提到 test case 也應觸發」 |
| memory | ❌ | 預設勾選 |
| 個人化/專案 | ❌ | 預設開啟 |
漏掉的三種都不是「我給模型的東西」,是介面預設幫我給的東西。
我在寫 file_access: none 的時候,腦中的模型是「我不要主動餵它資料」。而這三種完全不需要我主動做任何事——打開就生效,而且沒有任何提示告訴我它生效了。
這件事最讓我不舒服的部分在這裡。我的 manifest 有隔離條件、有分類規則、有驗收門檻、有「跑之前寫完,跑完不得回頭修改」。這些全部都沒有抓到污染。抓到它的是一句話:「輸出格式看起來怪。」
如果 B 的輸出剛好長得樸素一點——沒有那張自動化分級表、沒有那個前綴命名規則——我就會直接把十份拿去算中位數,然後寫出一篇結論完全反向的文章:
模型 B 的產出量是模型 A 的將近四倍,每一條案例都附可比對的數值與錯誤實作值,甚至會主動標示規格未定義處。高階模型在規格驅動的測試設計上,已經達到可用水準。
這段話裡的每一個觀察都是真的。問題在於我沒辦法說明哪一部分是它的能力,哪一部分是我自己餵的。
那張自動化分級表、那套前綴命名規則,逐行對得上我的範本。那四行「不得等於」,對得上我跟它聊了九天的四個缺陷。至於「產出量四倍」——那可能真的是它,也可能不是,我沒有第二組資料可以比。
我會拿著一份分不清作者的答案,說那是 AI 的能力。
isolation 從兩項變成五項,另外加了一個跑之前的驗證步驟:
preflight_check: |
  設定關掉不等於真的關掉。正式跑之前,另開一個「丟棄用」對話,
  設定與正式跑完全相同,先問:

    在回答之前,先告訴我:你現在這個對話有沒有載入任何 skill、
    記憶、專案或自訂指令?如果有,請逐項列出名稱。

  確認回報為「沒有」之後,該對話丟棄,再另開新對話跑正式的五次。
  模型的回報存成 preflight-<模型代號>.txt,作為「隔離已驗證」的憑據。

  這一步存在的理由:首輪十份全部作廢,不是因為忘了關設定,
  是因為根本沒想到那些設定會注入東西。開關的狀態要驗,不能只憑記得。
問模型自己有什麼,比我逐個去翻設定選單可靠——因為我會漏掉我不知道存在的東西,而它不會。那十份作廢的資料我沒有刪,改名保留:run-A-unisolated-*、run-B-contaminated-*,附一份 CONTAMINATED.md 寫明作廢原因與兩者的證據差別。它們現在是另一個實驗的對照組:同一個模型,有範本有記憶 vs 完全隔離。那個比較本身很有價值,只是不能用來回答 Day 10 的問題。
generated/ 這個目錄當初設計的時候,我寫了一句話當理由:
任何分數都必須能回溯到產生它的那批輸出,否則只是印象。
今天證明它不夠。還要能回溯到那批輸出是在什麼環境下生成的。而「環境」這件事之所以難,不是因為它複雜,是因為它有預設值。預設值不會提醒你它存在——它就是那個你以為的「什麼都沒有」。
我花了九天在寫「AI 產出需要人驗收」。今天發現,如果連產出是在什麼條件下生成的都說不清楚,驗收根本無從開始。
只帶走一件事
我以為隔離是「不要餵它東西」。實際上隔離是「知道有什麼東西正在被餵給它」,而預設值不會舉手。
作廢說明與十份原始輸出:generated/2026-09-09-day10-prd-to-cases/(作廢理由寫在 CONTAMINATED.md)


 iThome鐵人賽
 看影片追技術