
昨天那張 RTM 全綠。十條規格全有案例、零裸需求、抽驗 74 條零幻覺。
但綠燈只證明「這條規格有案例提到它」,沒有度量那條案例設計得夠不夠兇。
拿 PRD-05 當例子。它寫著大筆支出只有落在 A_r ≤ A_e ≤ A_d 才計入。而 run-a-3 給的兩條案例是 A_e = 70 和 A_e = 90(該份 A_d = 85)——RTM 標綠燈,兩條都指向 PRD-05,覆蓋成立。可是一條離邊界 15 年、一條超出 5 年。壽命當年那一筆到底算不算? 那才是缺陷 C 住的地方,而它沒被碰到。
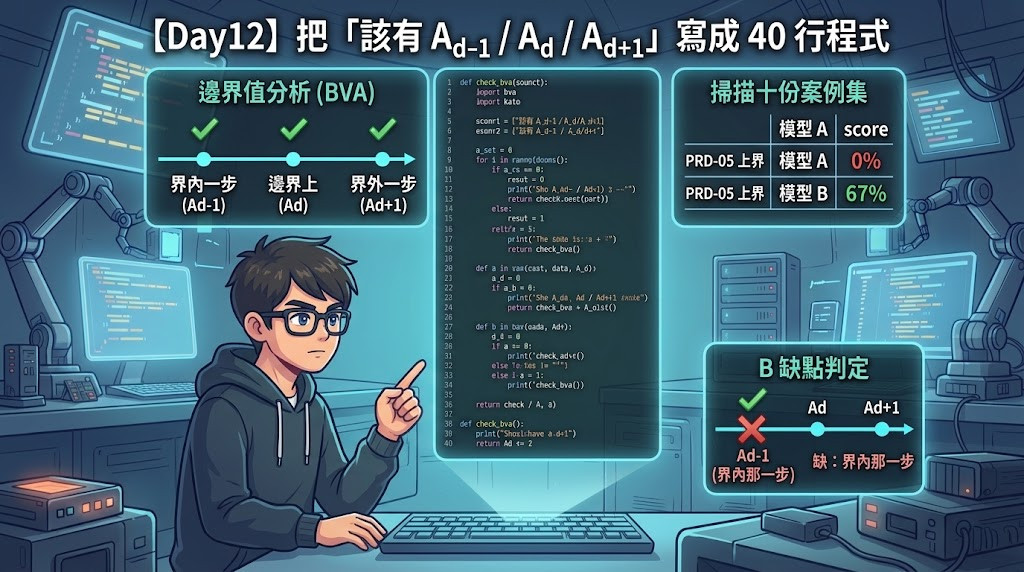
(BVA,boundary value analysis,邊界值分析:在等價類的交界處取值。標準是三個點——邊界上(on-point)、界外一步(off-above)、界內一步(off-below)。三個都取,才能確定實作把界線劃在我們以為的位置。)
這是 QA 的基本功,也是那種「看一眼案例就知道有沒有做」的直覺。今天要做的事是把這個直覺變成程式,因為 424 條案例,看不完。
有一個麻煩要先講:這支工具的邊界幾乎都不是常數。
無論是 PRD-05 的上下界、PRD-04 的大小關係,甚至勞保請領年齡,全都是使用者輸入。因此,這裡的「邊界」指的是兩個輸入的相對位置,而非寫死的數字。PRD 裡明寫的常數邊界只有兩處:PRD-01 的 r = 0 與 PRD-04 的「金額非負」。
檢核器得吃得下這種關係式,不然它就只能檢查這兩處。
雖然是個笨方法,但正是因為笨才驗得動:對每個案例,算出「左值 − 右值」,然後看這組差值裡有沒有出現 −1、0、+1。
Constraint = tuple[str, str, str | float]   # ("A_e", "<=", "A_d") 或 ("i", ">=", 0.0)
Case = dict[str, Any]                       # {"A_e": 85, "A_d": 85, ...}

def check_bva(constraint, cases, step=1.0, mode="3-point") -> dict:
    lhs_field, _op, rhs_spec = constraint
    required = {-1.0: "off-below", 0.0: "on-point", +1.0: "off-above"}
    # (原檔還有一個 5-point 模式的分支,此處省略)

    deltas = []
    for case in cases:
        if lhs_field not in case:
            continue
        if isinstance(rhs_spec, str):          # 關係式邊界:右手邊是參數名
            if rhs_spec not in case:
                continue
            rhs_val = float(case[rhs_spec])
        else:                                   # 常數邊界:右手邊是數字
            rhs_val = float(rhs_spec)
        deltas.append(float(case[lhs_field]) - rhs_val)

    missing = [label for offset, label in required.items()
               if not any(math.isclose(d, offset * step, abs_tol=1e-9) for d in deltas)]
    return {"score": (len(required) - len(missing)) / len(required),
            "missing": missing, "deltas": sorted(set(deltas)), "pass": not missing}
關鍵在 isinstance(rhs_spec, str) 那個分支。右手邊是字串,就當參數名去案例裡取值;是數字就直接比。一個分支,關係式和常數邊界就都吃得下。
用差值而不是絕對值還有一個好處:同一組三點,換不同的 A_d 仍然算得出來。一個案例是 A_e=70, A_d=70、另一個是 A_e=85, A_d=85,兩者的差值都是 0,都算命中 on-point。這在掃真實案例集的時候是必要的,因為各份輸出的基準情境不一樣。
檢核器本身也是程式,它也可能錯。而且它錯的方式很難察覺:回報 100% 命中的錯誤實作,跟真的 100% 長得一模一樣。所以它需要一組人手寫、人持有的驗收案例。這種東西有個名字叫 KAT(known-answer test,已知答案測試):輸入小到眼睛讀得完,預期結果確鑿無疑,不需要另一支程式來判斷對不對。
我寫了 7 組。其中三組是骨幹:
up = ("A_e", "<=", "A_d")

# 1) 完美三點 → 滿分
r = check_bva(up, [{"A_e": 84, "A_d": 85}, {"A_e": 85, "A_d": 85}, {"A_e": 86, "A_d": 85}])
assert r["pass"] and r["score"] == 1.0

# 2) 只給界內遠點與界外遠點 → 三點全缺,且必須指名 on-point
r = check_bva(up, [{"A_e": 75, "A_d": 85}, {"A_e": 95, "A_d": 85}])
assert not r["pass"] and r["score"] == 0.0 and "on-point" in r["missing"]

# 3) 邊界上 + 界外一步,缺界內一步 → 2/3
r = check_bva(up, [{"A_e": 85, "A_d": 85}, {"A_e": 86, "A_d": 85}])
assert r["missing"] == ["off-below"]
第 2 組就是前言那個「70 歲買車、90 歲買長照」的情境——RTM 會標綠燈,BVA 給 0 分。
另外四組管的是容易寫錯的地方:常數邊界(右手邊是數字)、同組差值不同絕對值、案例缺欄位時要跳過而不是當成命中、step 不是 1 的情況(利率以 0.01 為一步)。
這一層我不交給 AI 產。遞迴懷疑要有個底,而這裡就是底。 檔案在 tools/bva_checker.py,連 KAT 一共 128 行,跑起來只印一行「KAT 全部通過(7 組)」。
要把案例餵進檢核器,得先把它們變成 {"A_e": 85, "A_d": 85} 這種參數字典。
這一步我卡了四次。
前三次是基準情境的寫法。十份輸出用了三種:每列一個參數(| A_c 現齡 | 40 |)、一列塞三個(| A_c / A_r / A_d | 40 / 65 / 85 |)、還有根本不設基準,每條案例自己寫滿。解析器每修一次就撞上下一種。第四次是我以為已經分析完之後才發現的。run-B-02 的案例列長這樣:
| TC-05-01 | PRD-05(下界 A_e = A_r 計入) | A_c=64, A_r=65, A_d=70;A_e=65;⋯
| TC-05-02 | PRD-05(上界 A_e = A_d 計入) | 同上,A_e=70
「同上」。第二列只寫差異,其餘沿用前一列。解析器讀不懂這兩個字,於是 TC-05-02 之後全部掉了 A_r 和 A_d——而它們是關係式邊界的右手邊,掉了就算不出差值。
補上「同上」沿用之後,整條流程跑通了。而驗證方式是拿它跟我先前手工確認基準值算出的分數對照:
自動流程(解析器 → 檢核器) vs 人工確認基準值
10/10 完全一致
所以下面這張表是機器算的,不是我讀出來的。工具在 tools/case_extractor.py,兩條指令可以重現:
python3 tools/bva_checker.py    # 先驗收驗收者:KAT 自檢
G=generated/2026-09-09-day10-prd-to-cases
python3 tools/case_extractor.py $G/run-a-*.md $G/run-B-0[1-5].txt
範圍要先講清楚:今天只掃 PRD-05 的上下界這兩條約束,不是十條規格全掃。理由是 PRD-05 的上界正是缺陷 C 住的地方,而且它是關係式邊界(兩個輸入的相對位置),最能考驗檢核器。其餘八條規格的邊界今天沒有量。
上界 A_e ≤ A_d |
缺的點 | 下界 A_e ≥ A_r |
缺的點 | |
|---|---|---|---|---|
| run-a-1 | 33% | off-below, on-point | 0% | 三點全缺 |
| run-a-2 | 0% | 三點全缺 | 0% | 三點全缺 |
| run-a-3 | 0% | 三點全缺 | 0% | 三點全缺 |
| run-a-4 | 0% | 三點全缺 | 0% | 三點全缺 |
| run-a-5 | 33% | off-below, on-point | 0% | 三點全缺 |
| run-B-01 | 67% | off-below | 100% | — |
| run-B-02 | 100% | — | 100% | — |
| run-B-03 | 67% | off-below | 67% | off-above |
| run-B-04 | 67% | off-below | 67% | off-above |
| run-B-05 | 67% | off-below | 67% | off-above |
上界:A 中位 0%、B 中位 67%。 下界:A 中位 0%、B 中位 67%。
模型 A 五份的 A_e 取值是 70/86、70/85、70/90、65/82、70/86,大多落在距離邊界十幾二十年的地方。它確實產出了 PRD-05 的案例,RTM 也標了綠燈,但它就是沒有在邊界附近取樣。
而 B 那邊則有個很整齊的形狀:四份全都不約而同地缺了 off-below。那是「界內一步」,A_e = A_d − 1,也就是死前一年的那筆大筆支出。下界也是同一件事的鏡像:三份缺了 off-above,也就是 A_e = A_r + 1,退休後的第一年。
兩個邊界缺的,剛好都是界內那一步。
我想原因是這樣:界外一步會產生看得見的差別(支出被排除、介面出現「已忽略」標註),很容易寫出斷言;而界內一步,跟區間裡的任何一個點看起來都一樣,斷言寫起來平淡無味——它沒辦法讓案例看起來更完整,模型自然沒有理由寫它。
有一件事要說清楚,免得我誇大:這個缺口不會漏掉缺陷 C。 缺陷 C 是上界完全缺席(超出壽命的支出仍被計入),要抓到它,需要 A_e > A_d 並斷言排除,那正是 off-above 的守備範圍。B 有測這個點,A 的 run-a-1 和 run-a-5 也有。兩邊都抓得到那個已知缺陷。
我們缺的是另一個方向的鑑別力;只是那個方向,今天剛好沒有已知缺陷住在裡面而已。
run-B-02 拿到上界 100%,是十份裡唯一的滿分。我去看它怎麼做到的。
它的 PRD-05 專屬案例是 A_e = 64 / 65 / 70 / 71(該份的 A_d = 70),on-point 和 off-above 都有,off-below 沒有。
那個 −1 來自別的地方:TC-X-04(A_d = 66、A_e = 65)和 TC-X-06(A_d = 67、A_e = 66)。前者是為了測「大筆支出不得觸發餘額截斷」,後者是為了測「三類支出同期彙總」。兩條都不是為了邊界寫的,只是剛好落在那個差值上。所以它的 100% 是意外拿到的。
反過來說,run-B-01 的 TC-05-02 標題寫著:
PRD-05(上界含等號
A_e = A_d)
讀這個標題,你會以為上界測完了。它確實測了上界,測了其中一個點。
這就是為什麼要量,不能讀。 案例標題是模型寫的自述,跟 RTM 的「宣稱覆蓋」是同一類東西;而差值是從輸入參數算出來的,它不受標題影響。昨天我說「覆蓋是它自己宣稱的」,今天這句話有了第二個例子——連「我測了邊界」也是宣稱。
今天這支檢核器只有 40 行。我原以為難的是它,結果真正難的是前置作業:把文字案例變成參數字典。檢核器與 KAT 一次過關,解析器卻修了四次。
這個比例有點刺眼:判斷邏輯 38 行,取個輸入卻改了四輪。
原因並非模型寫得差,十份輸出在語意上高度一致(都知道要設基準、標規格、單獨測邊界)。它們不一致的是編碼:基準情境有三種寫法,參數有的寫滿有的寫「同上」,案例編號與標記更是五花八門。人讀毫無障礙,機器卻得為每種特例單獨寫分支。
其中最讓我不安的是「同上」那次:前三種格式不同頂多是解析失敗噴錯,但第四種卻是解析成功,但值是錯的(而且是我手工分析完報出數字後才發現)。這讓我意識到:「AI 產出要能自動驗收」,真正的卡點或許不在驗收邏輯,而在產出格式沒有契約。
不過這還只是觀察,要驗證得用沒見過的資料。因此我在解析器檔頭下了一道凍結宣告:
本檔對 Day 10 輸出調至可用後即凍結。Day 13 輸出為未知測試集,屆時本檔必須原封不動跑一次,記錄解析成功率。
若在新資料上直接可用,「無契約」一說便被削弱;若又撞上第五種寫法,那就是實證。先把預測寫下來,再去看結果,這招今天已經用第三次了。
今天量完上界命中率後,明天我想試個新方向:把 PRD-05 的上界子句從規格裡刪除,看模型還會不會寫出那條邊界的案例。如果它照寫,那就有意思了。
只帶走一件事
「我測了邊界」跟「我覺得我測了邊界」,差別在那一組差值裡。而差值不看標題。
今天的 repo:https://github.com/eyelash500/2026_ironman_test_ai/tree/day12


 iThome鐵人賽
 看影片追技術