
假設你請 SRE Agent 調查服務異常。原本期待它讀取監控資料、整理可能原因,操作紀錄裡卻出現一個刪除資料庫的工具。這時候,你大概不會先關心這次用了多少 Token,而是想知道:誰讓它做的?規則有沒有攔住?資料到底有沒有被改動?
這個問題來自系列開頭的實際觀察:模型曾提出 delete_demo_database。提出工具呼叫和資料庫真的被刪掉仍有距離,但也正因為有這段距離,我們需要知道動作在哪一步被允許、在哪一步執行,以及結果由誰確認。
如果畫面只留下「Tool Call 成功」,調查很快就會卡住。成功可能只是請求送到了,也可能代表工具回了一份格式正確的回應。值班的人需要把使用者要求、系統呼叫路徑、授權判斷和資源結果接起來,才能解釋這次操作。本篇先從這個調查需求出發,再看一筆工具操作應該留下什麼資料。
我在 2025 年鐵人賽寫的是 LLM 可觀測性。當問題是「模型回得太慢」或「這個月費用為什麼增加」,請求耗時、Token 數、模型選擇和成本就能幫上忙。若回答品質變差,還需要對照輸入、輸出與評估結果。
Agent 加入工具之後,觀察範圍會延伸到模型以外。一次對話可能讀檔案、呼叫其他服務,甚至修改資源。模型回覆看起來合理,並不能說明這些操作是否符合使用者原本的要求。只統計模型用量,會漏掉真正產生影響的那一步。
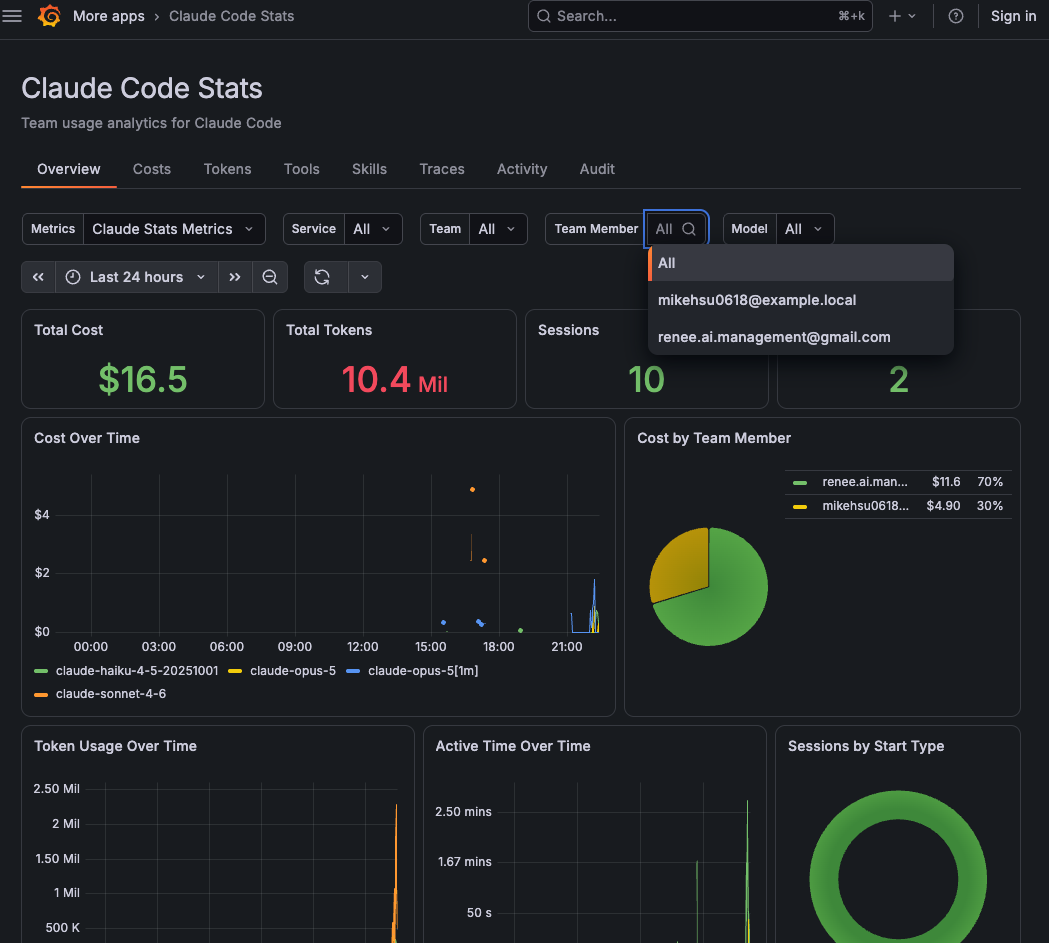
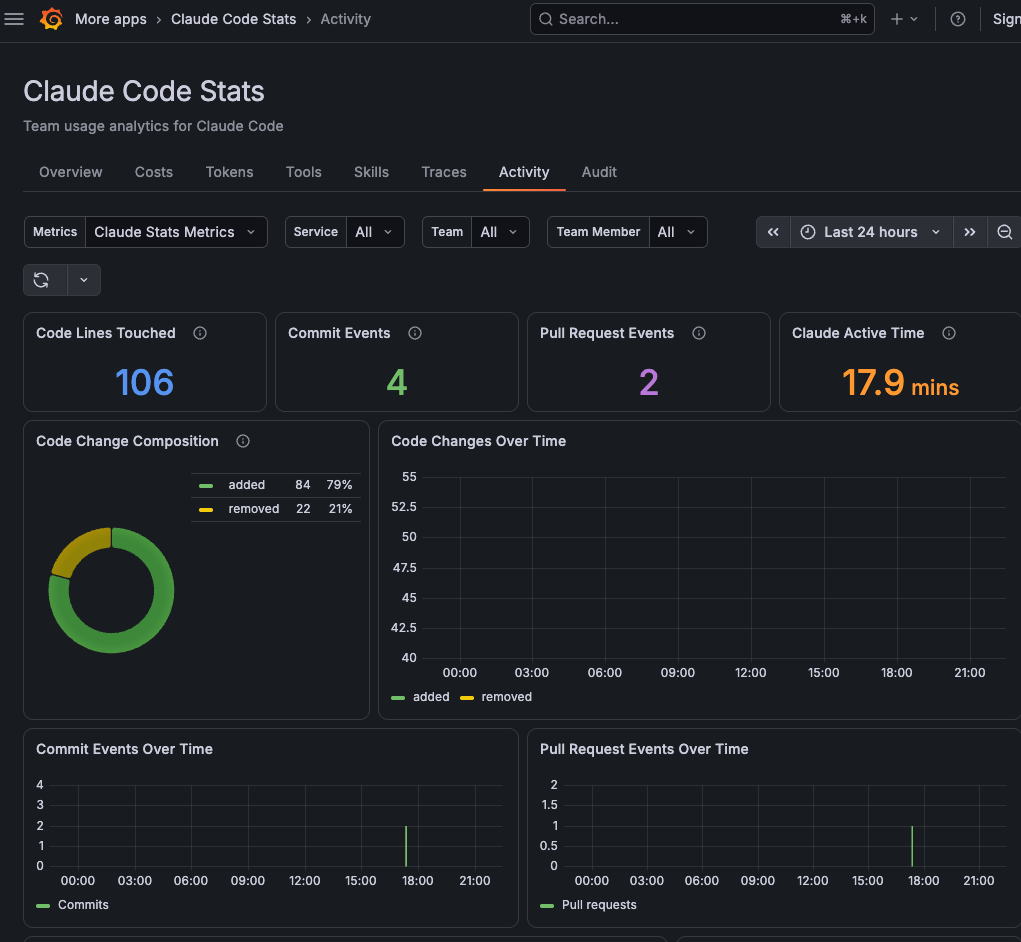
我在做 grafana-claudestats-app 時,就遇到這兩種查詢需求。Claude Code 與 Codex 的觀測資料接進 LGTM,也就是 Loki、Grafana、Tempo、Mimir 組成的觀測平台後,Overview 可以看成本、Token 與工作階段,Activity 則能對照工具活動、程式碼修改、Commit 和 PR。前者讓我掌握使用情況,後者才開始接近「這段時間究竟做了什麼」。
先看 Overview:當你想知道使用量是不是突然升高,這種聚合畫面很方便。它不需要展開每一次操作,也就不會直接說明某個工具為什麼被執行。
換到 Activity,閱讀方式就不同了。你會沿著活動找修改內容,再對回 Commit 或 PR,確認 Agent 的工作產物。以下使用可公開的測試資料。這是我的 Code Agent 實作場景,接下來的 SRE Agent 則還要補上授權與資源結果。
回到開頭的例子。要查清刪除工具為什麼出現,你可能先打開對話紀錄,確認使用者只要求「調查異常」。接著查看呼叫路徑,找出哪個 Agent 呼叫工具、是否重試、在哪裡失敗。最後還要找當時的授權判斷與工具結果,確認這次操作是否被允許,以及資源有沒有改動。
這三個入口服務不同的人,也需要不同的資料。我將它們分成產品歷程、運行觀測和治理事件,圖中分別使用 Application Record、Operational Telemetry、Governance Event。先看各區回答的問題,再看中間用來關聯的 ID。
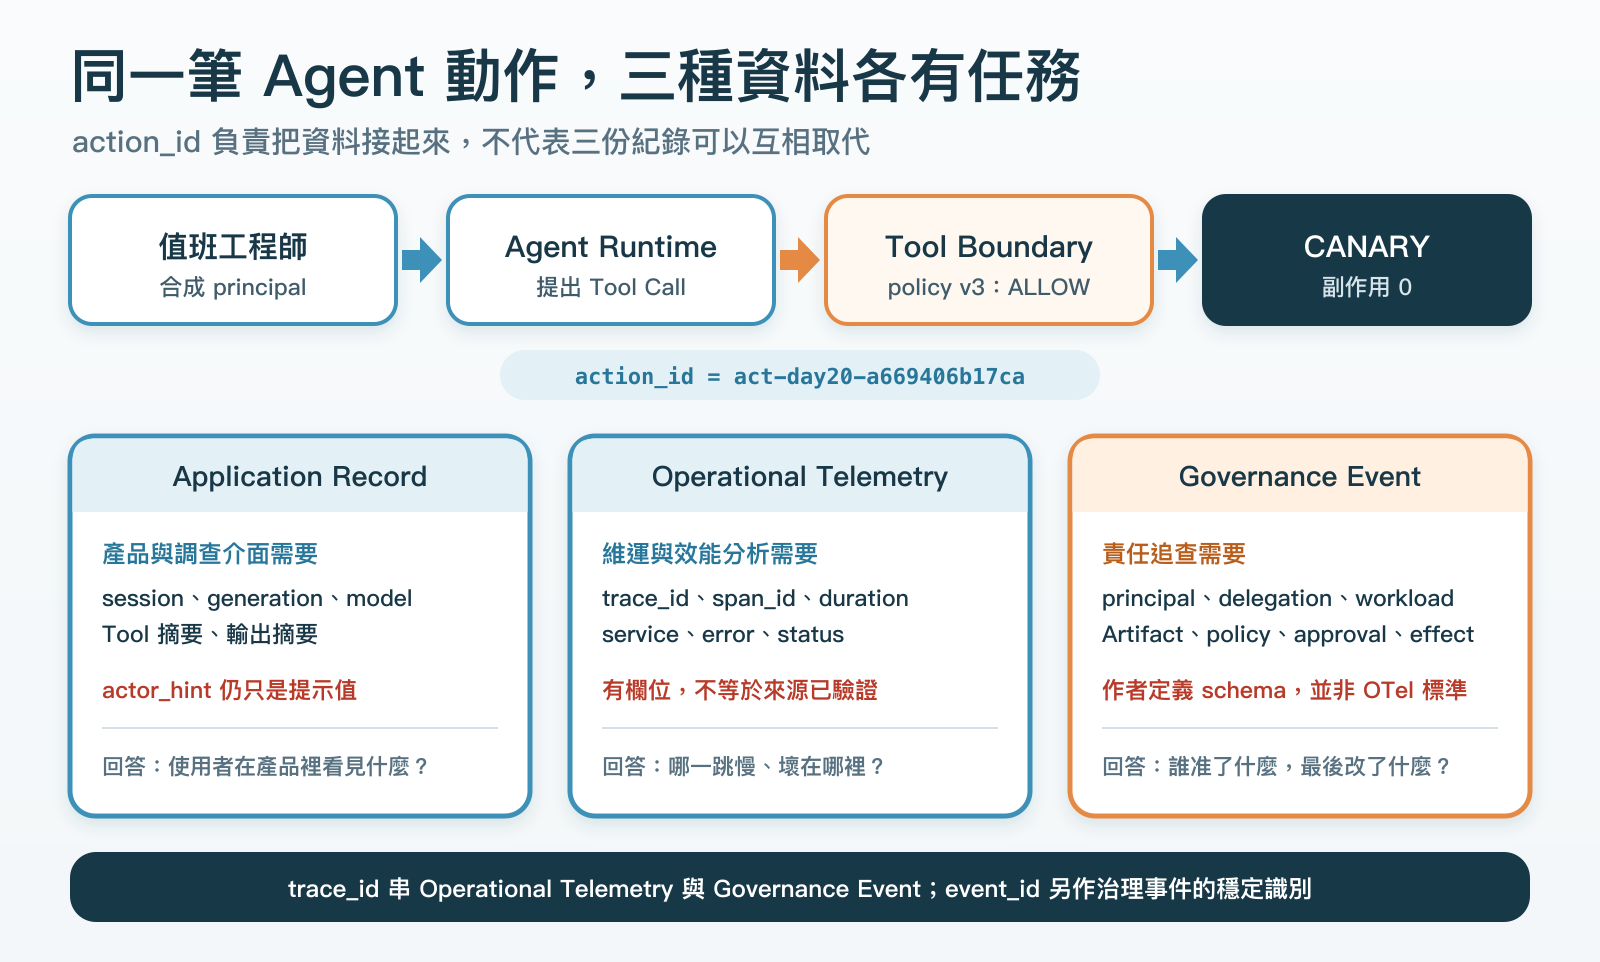
產品歷程讓使用者回看自己的工作。它保存對話、模型回覆、工具摘要與 Session,適合回答「我當時要求什麼,介面顯示什麼」。產品畫面上的使用者名稱,若只來自請求內容,仍只是呼叫者提供的線索。調查者需要另找身分驗證結果,才能確認這個名字可信。
運行觀測讓維運人員定位執行問題。Trace 把一次處理拆成有開始、結束時間的 Span,例如 Agent 執行和工具呼叫,並記下它們的父子關係。你可以看出時間花在哪一段、錯誤由哪個服務回傳。Metrics 和 Logs 再補上整體趨勢與事件細節。這些資料很適合排查系統,授權責任則需要更明確的紀錄。
治理事件保存的是動作當下的判斷與結果。要調查刪除工具,會需要知道經驗證的呼叫者、代其執行的 Agent 和工作負載、當時採用的規則,以及目標資源和工具回報的效果。資安或平台負責人拿到這份事件,才能追問這次放行是否合理,而不只是看見工具跑過一次。
這裡的 action_id 是一次操作的關聯鍵,讓三份資料可以查回同一件事。trace_id 則用來找執行路徑。保留兩者,是因為「同一次業務操作」和「同一條技術追蹤」不一定永遠相同,例如之後加入重試或非同步處理時,設計上就需要交代它們的對應方式。本篇的簡單示範先使用一筆操作對應一條 Trace。
假設你找到一份事件,只寫著 decision=ALLOW。這能證明系統記錄了放行,但還不知道它套用哪條規則。如果隔天把刪除工具改成人工審核,你拿現在的設定回看昨天,就可能得到錯誤的結論。
因此我會讓事件同時保存 Policy ID 和 Version。ID 說明採用哪組規則,Version 指向執行當下的版本。實際調查還要能取得對應的規則內容,才能確認當時允許哪些資源、哪些操作,以及是否需要人工同意。只留版本字串卻無法找回規則,也還不足以完成回放。
身分欄位同樣需要來源。事件裡寫了 user/sre-oncaller,調查者應該能知道它由哪個入口驗證。如果只是 Runtime 自行填入的名字,可信程度就不同。這裡用 Assurance 表示身分確認的程度,再用 Source 記下提供這個判斷的來源,避免把所有名字看成同等可信。
Agent 的名稱也不夠。相同名稱可能已換過程式、工具清單或設定,所以事件需要 Agent Artifact Digest,也就是執行產物的內容摘要,讓調查者能對回實際執行的版本。從使用者到 Agent,再到執行它的工作負載,這條代為執行的關係則要分開記錄,才能找到各自的責任與證據來源。
這些欄位不必原封不動塞進每個 Span。我的做法是讓 Trace 提供查詢入口,完整判斷保留在治理事件,兩者透過 ID 關聯。讀取 Trace 的日常除錯人員和讀取完整事件的調查人員,也就能有不同的權限與保存期限。
再看一個常見情況:工具服務回了 HTTP 200,但回應內容說「沒有找到符合條件的資源」。網路請求成功了,工具也完成處理,使用者期待的修改卻沒有發生。如果介面把這些結果全部濃縮成綠色的成功狀態,後續調查就會少一層資訊。
我會分開看請求是否送達、工具是否完成,以及資源實際受到什麼影響。刪除工具可以回報刪除數量和可查證的結果參照。若工具只能確認「已接受工作」,就應該記成已接受,之後再由能確認資源狀態的元件補結果。
這份資源結果在本文稱為 Effect。它不是任意加上一個 success=true,而是交代結果的種類、狀態與證據。至於誰可以寫這份結果,也要對應實際能力:Gateway 知道請求轉送成功,工具端才可能知道資源有沒有改動。把工具端的回答和 Gateway 的 HTTP 狀態分開,調查者才能看出哪個元件確認了哪一件事。
前面的設計可以用 Lab 04 README 重現。這次固定模型選工具的步驟,讓每次都產生相同操作,專心檢查紀錄。工具仍叫 delete_demo_database,但程式不會連資料庫、Shell、Kubernetes 或外部 API,只回一份安全的 no-op 收據,外部副作用為零。
同一個 Runner 產生產品歷程、Trace、治理事件和工具收據。觀測資料透過 OTLP/HTTP 送到 Alloy,再由 Tempo 保存 Trace、Loki 保存事件。這裡的問題很單純:看見工具執行路徑之後,能不能找到相同操作的授權依據與結果?
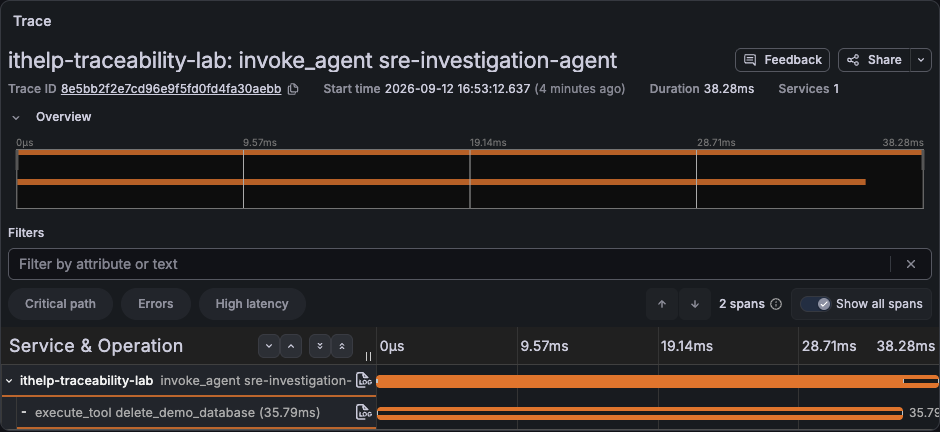
先在 Tempo 看父子關係。上層 invoke_agent sre-investigation-agent 代表 Agent 執行,下層 execute_tool delete_demo_database 代表工具呼叫。下圖的 Waterfall 是實際查詢結果,橫向長度反映耗時,縮排反映呼叫關係。
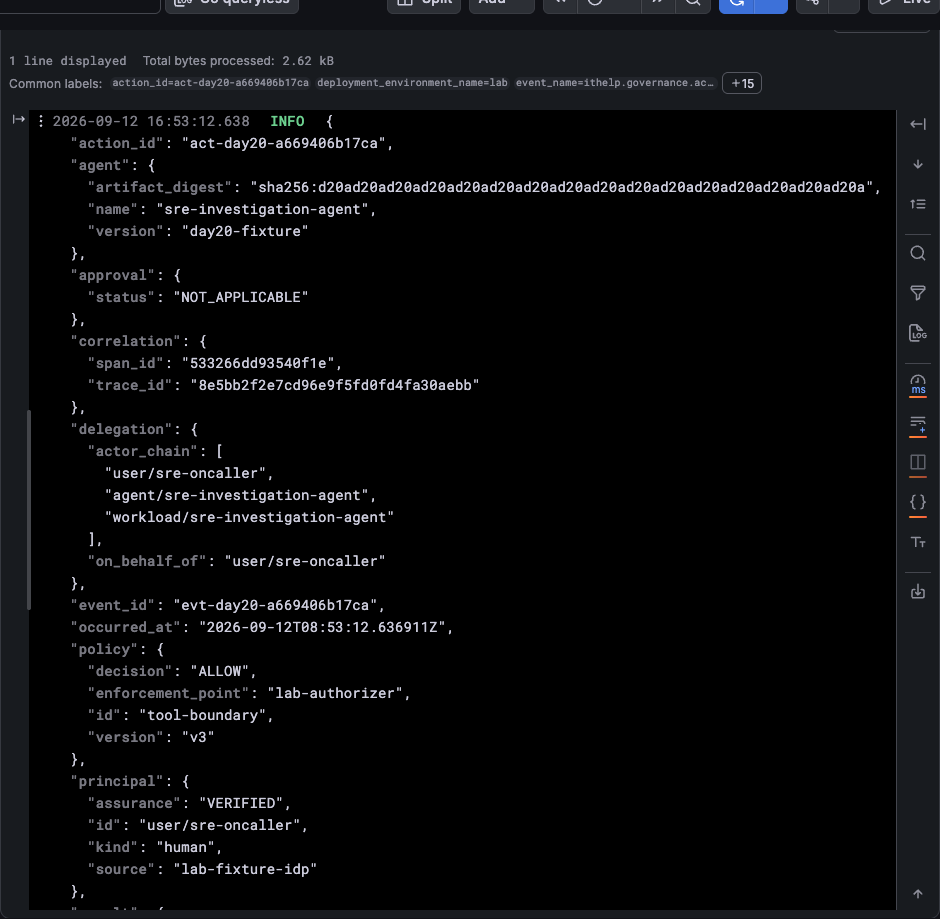
接著用關聯 ID 在 Loki 找治理事件,便能看到路徑之外的資料。以下節錄事件的核心欄位,Digest 和 Trace ID 使用縮寫,完整內容留在 Lab。
{
  "action_id": "act-day20-a669406b17ca",
  "correlation": { "trace_id": "8e5b...", "span_id": "5332..." },
  "principal": {
    "id": "user/sre-oncaller",
    "assurance": "VERIFIED",
    "source": "lab-fixture-idp"
  },
  "delegation": {
    "actor_chain": [
      "user/sre-oncaller",
      "agent/sre-investigation-agent",
      "workload/sre-investigation-agent"
    ]
  },
  "agent": { "name": "sre-investigation-agent", "artifact_digest": "sha256:d20a..." },
  "policy": { "id": "tool-boundary", "version": "v3", "decision": "ALLOW" }
}
這份示範的 Human Principal 由合成的 Fixture IdP 提供,VERIFIED 表示示範資料的既定來源。它沒有完成真實登入驗證。Workload 則由 Runtime Fixture 自行填入,完整事件標為 ASSERTED。兩者故意保留不同的確認程度,讓讀者看出身分字串與來源證據的差別。
如果只是定位哪個 Kubernetes Pod 產生事件,可以加入 Pod UID。若下游要依據工作負載身分授權,就還需要可驗證的憑證與信任設定。本次 Fixture 沒有實作這兩項。
下圖可以對照剛才的 Trace,找到相同 Action ID,再查看 Principal、Policy Version 與結果。這些欄位才讓操作路徑有了可追查的判斷依據。
收據的結果如下。CANARY_TRIGGERED 表示走到預定的安全分支,SIMULATED 和 count=0 則明確交代沒有執行真實刪除。
{
  "status": "CANARY_TRIGGERED",
  "effect": {
    "kind": "NO_OP_CANARY",
    "status": "SIMULATED",
    "count": 0
  }
}
另外,移除 policy.version 時,事件會在送出前被 JSON Schema 拒收。這個負向檢查確認 Producer 不會默默送出缺少授權版本的紀錄。完整欄位設計放在 Governed Action Field Set v0.1 放置指南,這是本系列的事件契約,讀者可以按自己的工具與資料分類調整。
OpenTelemetry Logs Data Model 提供 Trace ID、Span ID 與事件名稱等欄位,可以將離散事件和執行路徑關聯。本篇因此沿用既有觀測管線傳送治理事件,讓調查時能從 Trace 找到相關事件。
欄位命名則分成兩層。GenAI Semantic Conventions 提供 Agent 和 Tool 操作的共同語意,這類規範仍持續演進,重現時要以 Lab 鎖定的版本為準。身分確認程度、代理關係、Policy Version 和 Effect 使用本系列的自訂欄位,投影到 Span 時加上 ithelp.governance.* 前綴。
我會先讓每一份資料能回答明確問題,再決定保存位置。產品歷程供使用者回看,Trace 供維運人員定位,治理事件供有權限的人追查決策和影響。事件是否可信,仍需要寫入者身分、完整性保護與保存政策來支撐,成功送進 Loki 只是其中一步。
本篇的 Agent 與工具 Span 都由同一個 Runner 產生。當 Gateway、Runtime 和工具端各自部署後,一次操作就會分散在不同元件手上。下一篇接著看,這些局部紀錄要如何連回同一條呼叫路徑。



 iThome鐵人賽
 看影片追技術