
假設你請 Agent 查一個服務的異常,畫面一直停在「查詢中」。Gateway 的紀錄顯示請求已送出,Runtime 說自己正在等工具,工具服務卻說查詢早就完成。三邊都各有紀錄,值班的人仍不知道這幾筆是不是同一次操作,也不知道時間究竟花在哪裡。
Agent 的工作很容易跨過這些邊界。Runtime 負責安排步驟,Gateway 負責轉送與入口控制,MCP 服務負責提供工具。每個元件都看見自己的那一段,把它們的 Log 放進同一套平台,也還需要明確的關聯方式,才能從使用者的請求一路追到工具。
前一篇先討論一次操作要留下什麼。本篇接著處理資料分散之後的調查方式:先理解跨服務追蹤怎麼接線,再比較一條完整路徑和一條中途斷開的路徑。兩次工具都正常回應,觀測資料卻會給出不同的調查能力。
先把角色放回實際呼叫順序。Client 是提出請求的一端,Agent Runtime 收到請求後安排工作,例如決定呼叫工具、等待結果,再組織回覆。MCP 服務則提供工具介面,讓 Runtime 能取得工具執行結果。本篇以 MCP Adapter 扮演工具端,回傳可檢查的安全收據。
Gateway 位於轉送邊界。Client 呼叫 Runtime 時會通過它,Runtime 呼叫工具時也會通過它。這兩段可以使用同一個 agentgateway 的不同路由(Route),分別指向 Runtime 和 MCP Adapter,讓它依請求入口選擇轉送目標。
下圖有兩條不同用途的路徑。上半部是請求的去向,順著它看,能理解哪個元件在等待誰。下半部是觀測資料的去向,各元件將自己的紀錄送到 Alloy,再存入後端。Alloy 是資料收集器,並不參與上半部的工具決策。
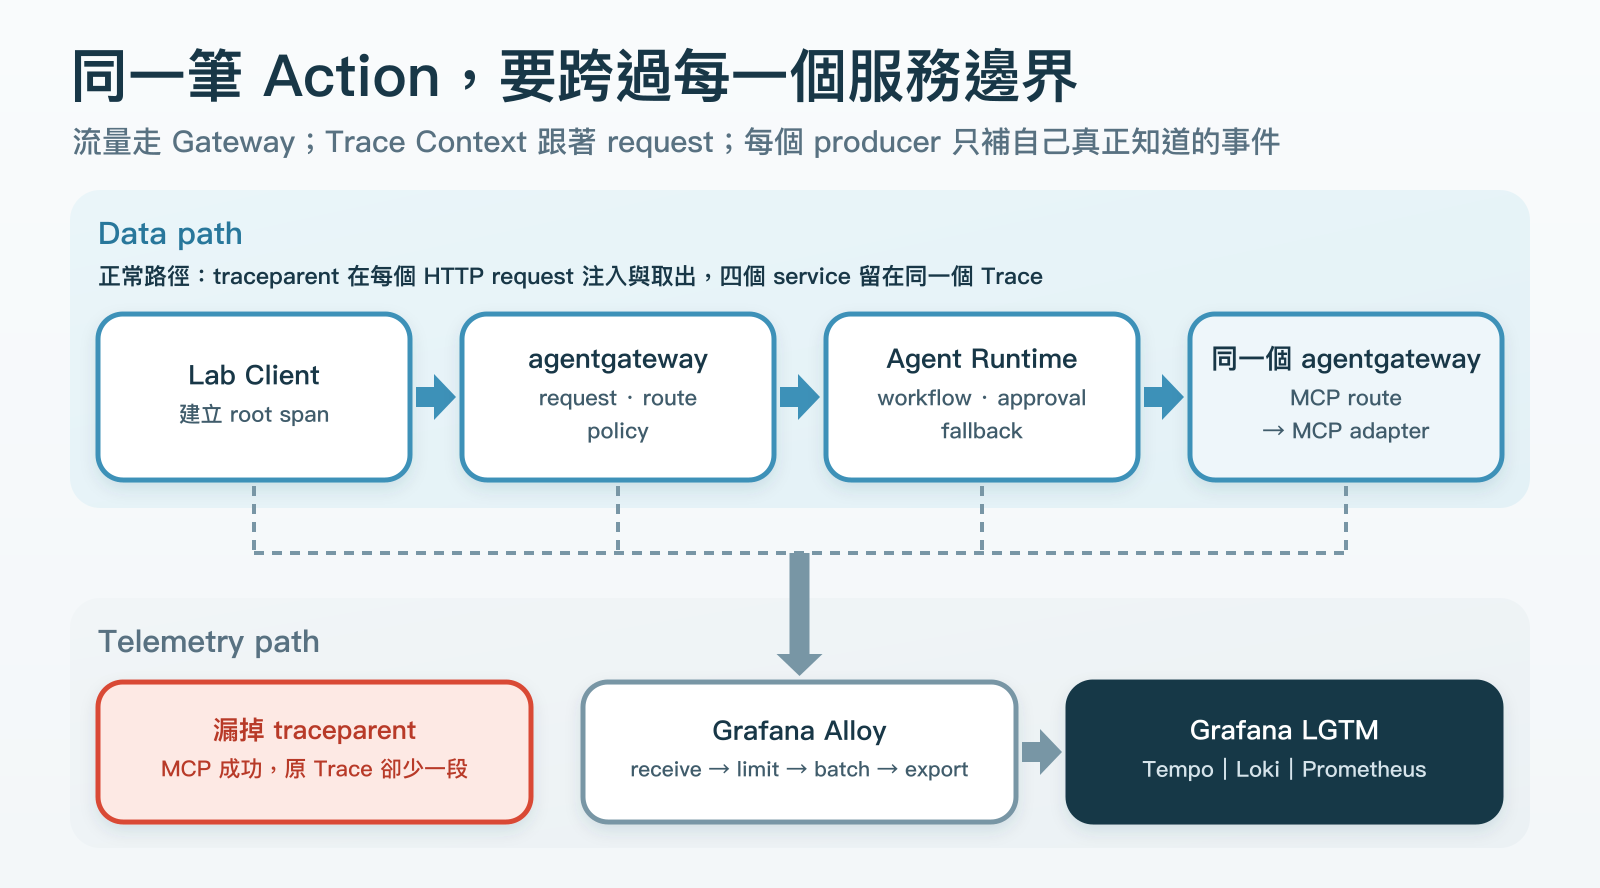
同一次操作到了不同位置,能留下的證據也不同。例如 Gateway 可以確認自己選了哪個 Route、上游回了什麼 HTTP 狀態。它通常看不到 Runtime 為什麼選這個工具,也無法只靠 HTTP 回應確認資料庫有沒有改動。
| 元件 | 本篇能直接觀察的內容 | 調查時需要向其他元件確認的內容 |
|---|---|---|
| Client | 請求開始、最後收到的回應 | 中間哪段服務處理較慢 |
| agentgateway | Route、轉送目標、入口判斷、HTTP 狀態 | Agent 選工具的理由、資源結果 |
| Runtime | 工作步驟、準備呼叫的工具、收到的結果 | 工具是否真的改到目標資源 |
| MCP Adapter | 工具請求、執行收據與回報的效果 | 使用者原始要求、上游授權依據 |
這也是我在維護觀測平台時比較花時間的地方。OTLP 接到 Alloy 之後,資料有共同的收集入口,但每個欄位仍要有人負責。Runtime 的工作狀態要由 Runtime 記錄,工具結果要由工具端回報。Collector 無法從一份 Gateway Access Log 推導出這兩件事。
Trace 可以想成一次處理的呼叫地圖。地圖上的每一段操作叫 Span,它記錄開始與結束時間、狀態和相關欄位。Runtime 呼叫工具時,可以先建立一個代表下游呼叫的 Span,工具端收到請求後再建立自己的處理 Span。兩段接成父子關係,就能看出「誰呼叫誰」以及等待時間。
在同一個程式裡,SDK 可以透過目前的執行 Context 找到上層 Span。換成另一個服務後,記憶體中的 Context 不會跟著 HTTP 自動搬過去,傳送端需要把關聯資訊放進請求,接收端再取出來,當作新 Span 的上層。
OpenTelemetry Context Propagation 用 Inject 和 Extract 描述這兩個步驟。HTTP 常見的載體是 traceparent Header,裡面包含 Trace ID、上游 Span ID 和追蹤旗標。接收端沿用 Trace ID,建立自己的 Span ID,並把收到的上游 Span 設為 Parent,後端才知道兩段屬於同一條路徑。
例如 Runtime 正在呼叫工具,送出 Header 的 Context 應該來自這一次下游呼叫。工具端取出後,便能接在正確的呼叫底下。若 Runtime 只是把最初收到的 Header 原封不動複製出去,可能保留同一個 Trace ID,卻跳過中間的父子關係。因此檢查時除了 ID 相同,也要看縮排和 Parent 是否合理。
追蹤資訊本身不代表授權。請求帶著 traceparent,只能提供呼叫關聯線索,不能證明呼叫者是哪個人。身分仍須由入口驗證,操作是否符合規則也需要另外記錄。
每個元件產生 Trace 和事件之後,還要把資料送到查詢系統。本篇使用 Alloy 接收 OTLP,這是 OpenTelemetry 的資料傳輸協定。OTLP 可以使用 HTTP 或 gRPC,元件採用不同傳输方式,也可以進入同一套收集管線。
這裡的 agentgateway 用 OTLP/gRPC 送 Trace 和 Access Log,Python 元件用 OTLP/HTTP。Alloy 接收後先經過記憶體限制與批次處理,再送到 OTEL-LGTM,這是一個整合收集器、Grafana 和觀測後端的本機示範環境。記憶體限制降低 Collector 過載風險,批次處理則減少零散傳送的成本。Gateway 原生的 Prometheus Metrics 另外以定期抓取端點資料的方式收集,這種方式稱為 Scrape。
如果要看 Gateway 本身的流量、錯誤和延遲,可以先使用 官方 Observability 文件 和 Grafana Dashboard。本篇另外查看跨服務 Trace,是因為 Gateway 面板無法單獨呈現 Runtime 內部步驟與工具端的全部紀錄。
這裡有兩個需要分開驗收的問題。第一個是每個元件的資料有沒有送達,第二個是收到的資料能不能連回同一次呼叫。收集管線健康,並不保證每個服務都傳對了 Trace Context。
Lab 04 README 提供完整設定與重現方式。實測將 Client、Runtime、MCP Adapter 拆成獨立服務,請求實際經過 agentgateway 的兩個 Route。Gateway 的轉送、HTTP 狀態、原生 Trace、Access Log 與 Metrics 都真實執行,Runtime 與工具端則用 Python Fixture 固定流程,讓兩次比較只改變追蹤資訊。
工具只回傳 NO_OP_CANARY 收據,不會修改外部資源。這次也沒有啟用 JWT,Runtime 填入的 Team 只是示範欄位,不能當成 Gateway 已驗證的身分。這個範圍讓我們可以先專心檢查服務邊界上的關聯。
正常情況下,Tempo 查到四個 Service、八個 Span。Gateway 在 /agent/run 與 /mcp/execute 兩段請求都留下處理和轉送紀錄,其他元件留下各自的操作。讀圖時可以從最上方的 Client 往下找 Runtime,再沿下游呼叫找到 MCP Adapter,確認工具端仍在同一條路徑裡。
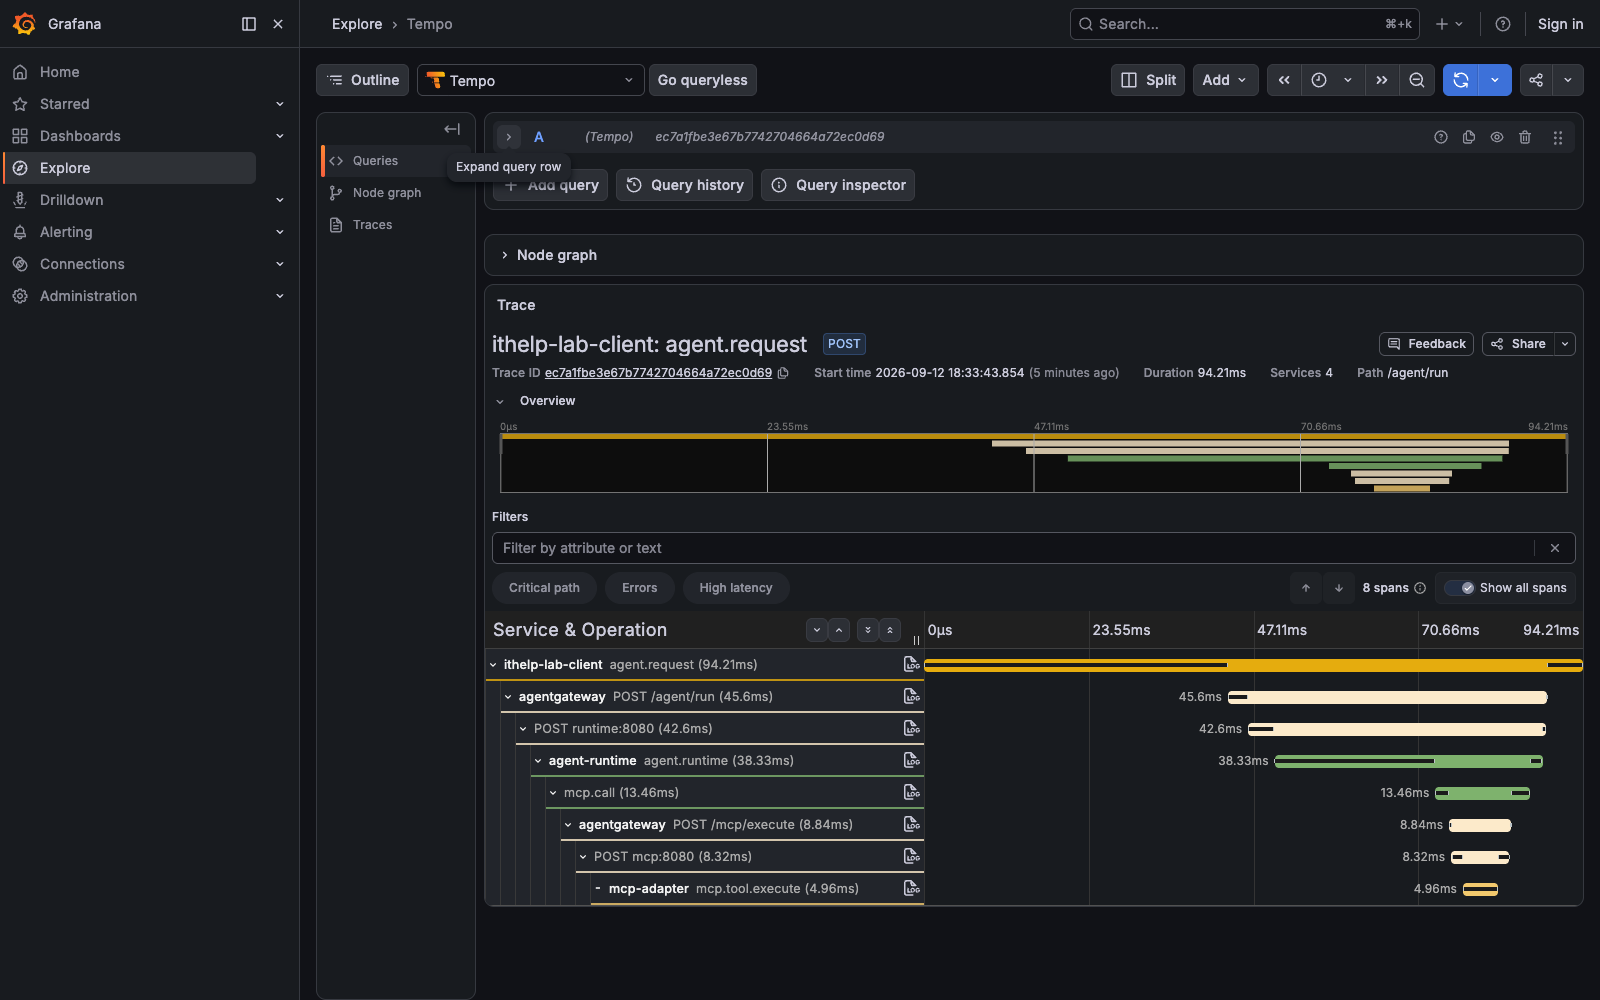
這條路徑成立,是因為傳送端注入目前 Context,接收端取出上游 Context,再建立自己的 Span。Runtime 呼叫 MCP Route 時也重新完成這個步驟,因此工具端和上游共享 Trace ID,並接到正確的 Parent。
接著只在 Runtime 到 MCP 的請求移除 Trace Context,其他流程保持相同。HTTP 仍回 200,工具收據仍是 CANARY_TRIGGERED,使用者看到的功能結果沒有改變。回頭查原本的 Trace,卻只剩三個 Service、五個 Span。
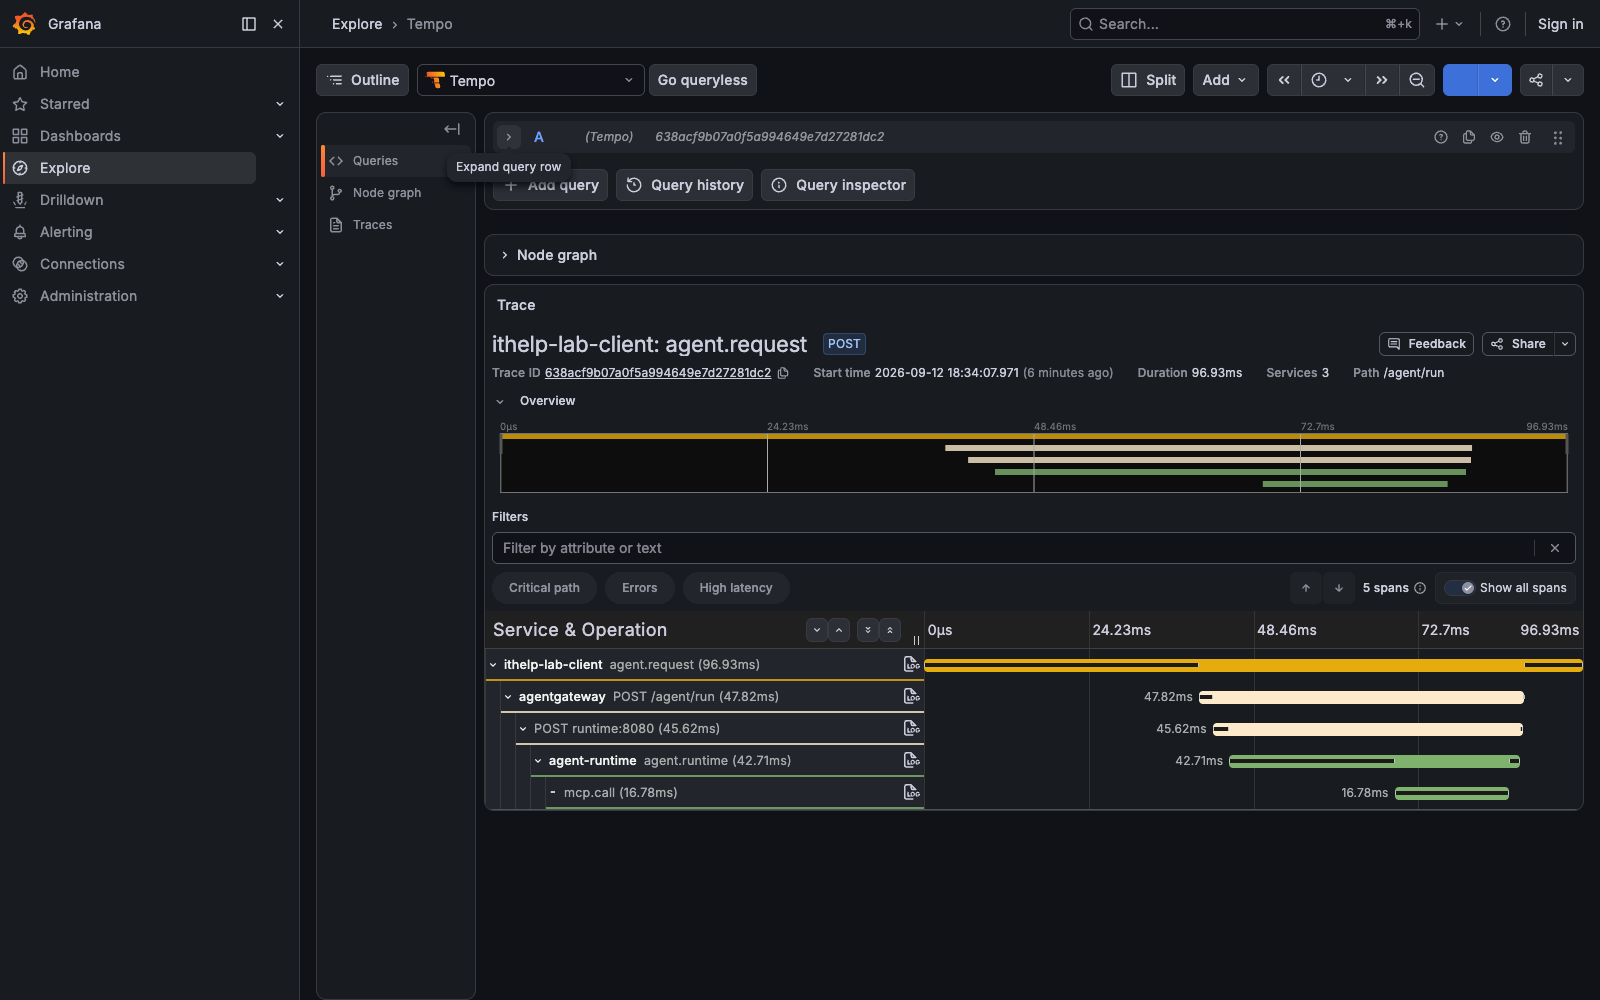
比較兩張圖時,要找的是工具端有沒有接在 Runtime 的呼叫底下。斷鏈後,Runtime 的 mcp.call 還在,工具端的 mcp.tool.execute 則進了另一條 Trace。它仍有紀錄,只是失去了和這次上游呼叫的明確關聯。
這種情況很容易被功能測試漏掉。單看工具端,一切正常。單看 Runtime,它也拿到了回應。等到有人問「這次等待發生在哪裡」,才得用時間戳或其他 ID 人工拼回兩邊的資料。因此我會把跨服務追蹤完整性放進驗收,確認關鍵下游確實出現在預期路徑,並測試拿掉 Context 時能不能發現缺口。
Trace 能展開呼叫順序,事件紀錄則補上各元件當時做了什麼。同一筆正常操作在 Loki 中有四筆結構化事件,分別記錄請求接受、Runtime 完成、工具收據和 Client 結果。它們共用 action_id,可以把工具結果和使用者最後收到的回應對起來。
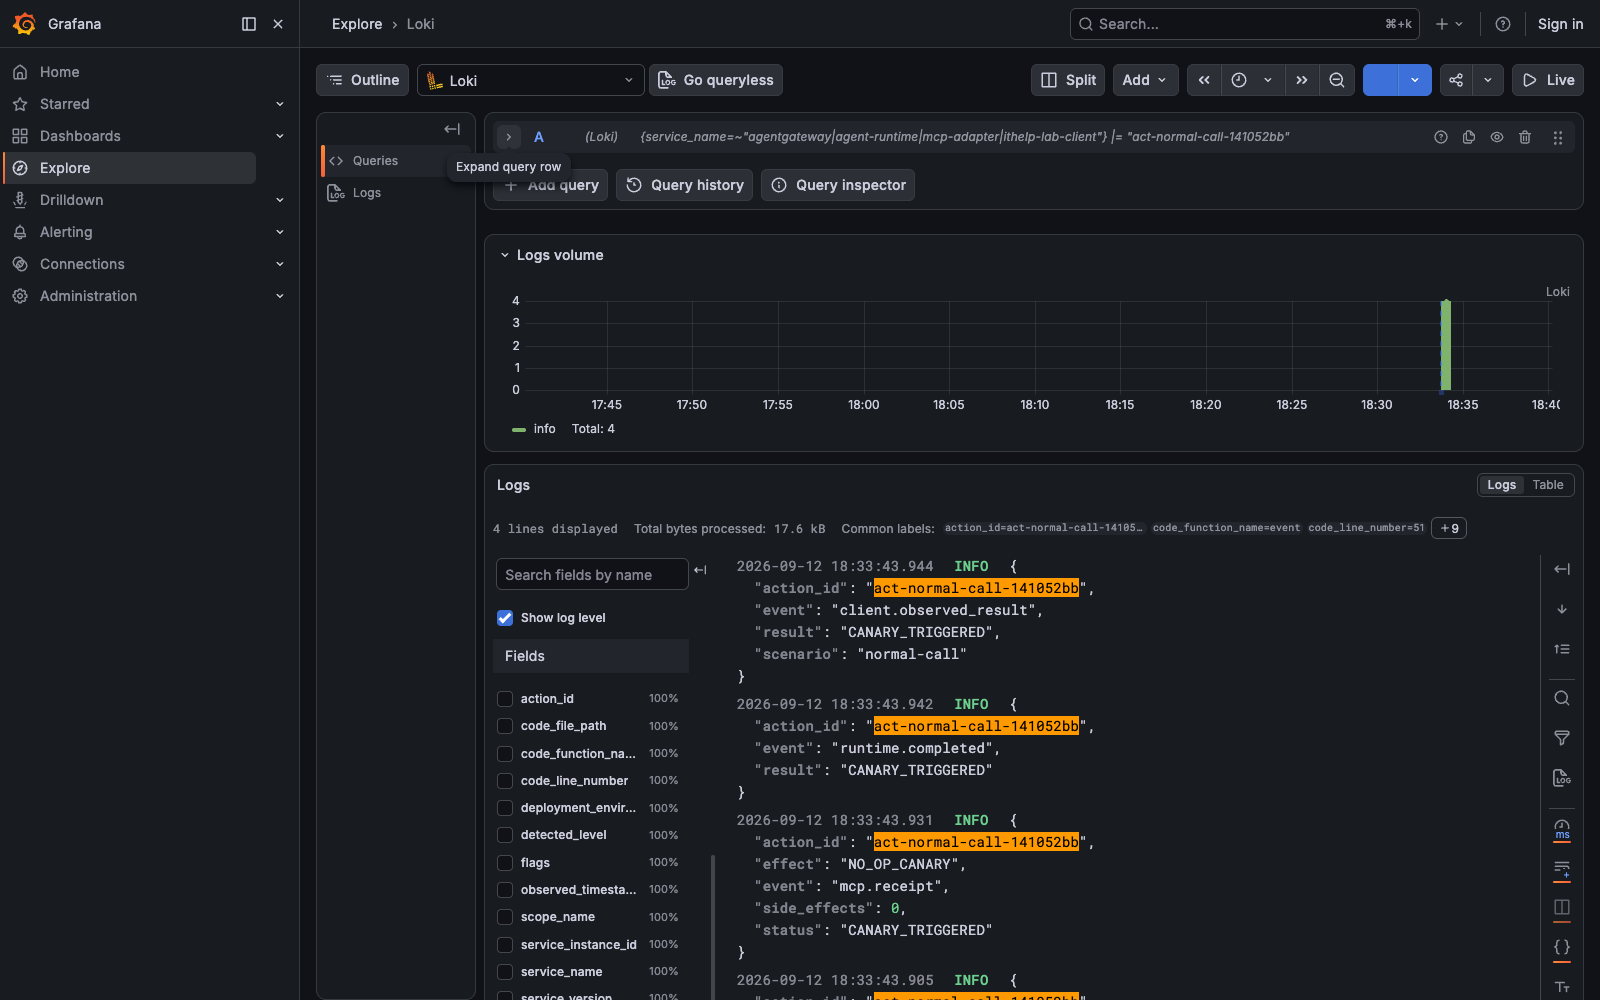
這個關聯鍵在本篇放於 Application Payload。Gateway 設定沒有解析 Body 裡的 action_id,所以它的 Access Log 能查 Route、轉送目標和狀態,卻不能直接用同一個欄位查回。若要讓 Gateway 也記錄這個 ID,就要另外定義 Header 或其他傳遞契約,並決定誰可以產生、覆寫與驗證它。
再換到 Prometheus,問題會從「這一筆發生什麼」變成「相同路徑是不是普遍出錯」。以下查詢依 Route、Status 和 Reason 聚合 Gateway Request,能觀察哪個入口出現拒絕或後端不可用。
sum by (route, status, reason) (agentgateway_requests_total)
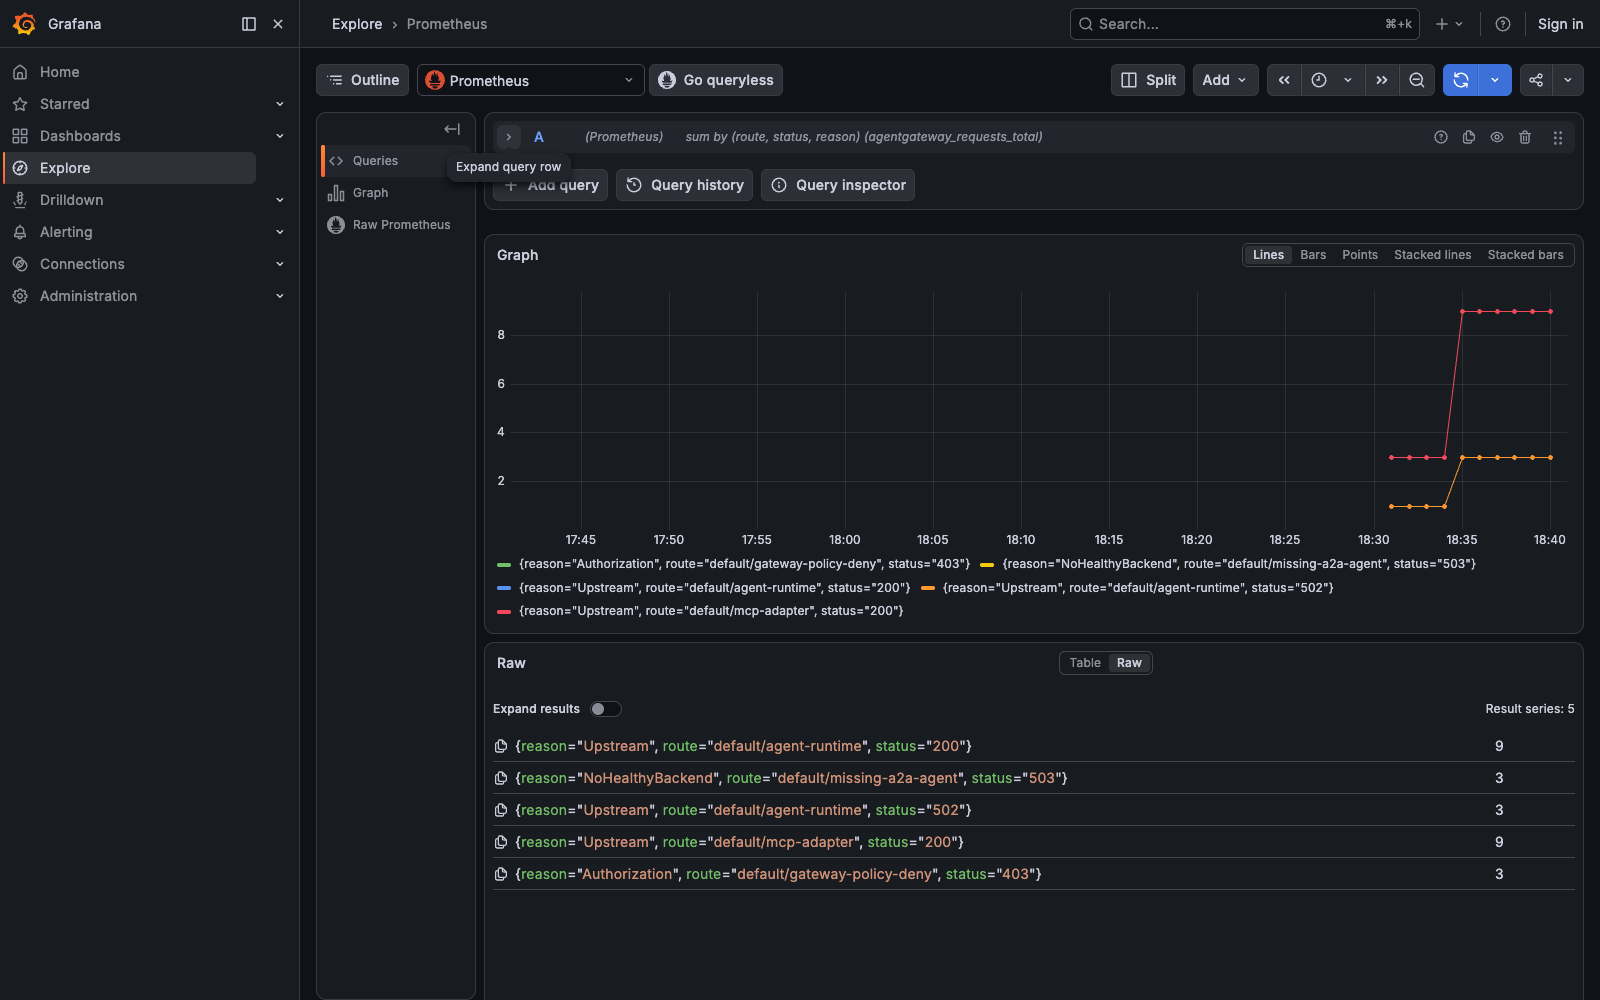
圖中的 Policy 拒絕情境是 Authorization/403,不存在的 A2A Backend 則是 NoHealthyBackend/503。這些數據協助判斷錯誤範圍與類型,再選一筆相關 Trace 展開細節。本篇不把每筆 action_id 加入 Metric Label,個別操作的查詢留給 Trace 和事件。
這份示範使用 Standalone agentgateway 和 grafana/otel-lgtm。Grafana 對 OTEL-LGTM Image 的定位 是開發、示範與測試。正式部署還需要按流量、可用性和資料保存需求安排後端與 Collector,不能把本機成功直接當成完整的運維設計。
回到 Kubernetes,我會先分開看設定是否成功套用、Gateway 是否正常處理請求,以及 Runtime 是否完成工作。設定控制器正常,不代表工具服務可用。Gateway 持續回應,也不代表 Agent 最後產生了預期結果。這些狀態需要各自的告警和處理人員,才不會在一個綠燈底下漏掉工作失敗。
Collector 同樣要有自己的健康檢查。後端暫時不可用時,資料是否重試、佇列能撐多久、什麼情況會丟棄,都會影響事後能查到的範圍。先知道這些限制,調查時才不會把「沒有紀錄」誤判成「沒有發生」。
到這裡,我們已經能由入口追到工具,也知道一段 Context 遺失會怎樣破壞調查。接下來做 Dashboard 時,通常會想按團隊或使用者篩選。這些身分資訊進入指標、Trace 和 Logs 之後,查詢方式、成本與暴露面各不相同,下一篇就從這個需求開始安排欄位落點。



 iThome鐵人賽
 看影片追技術