
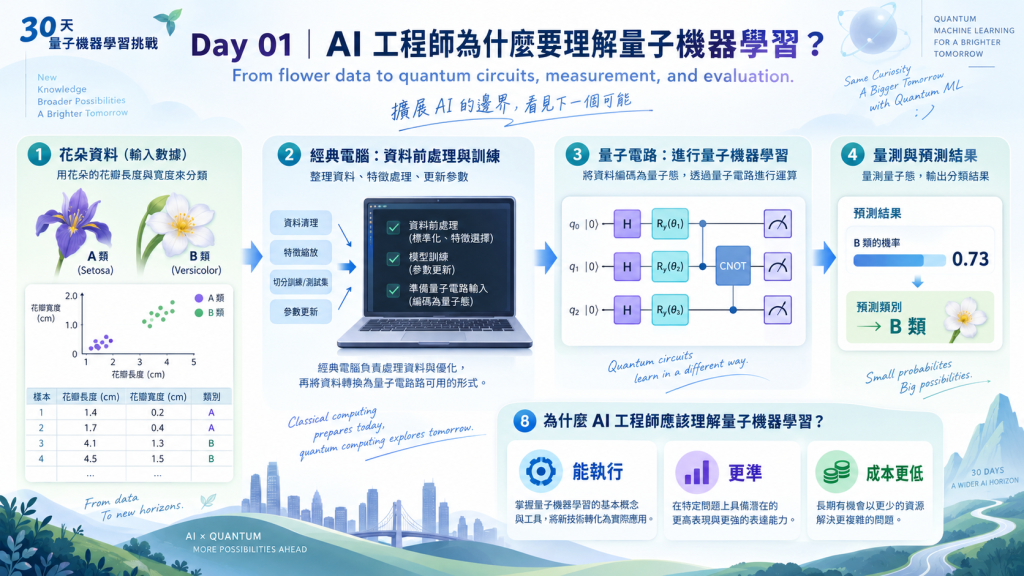
本次以 「從 AI 工程到量子機器學習:30 天 CUDA-Q 實作」 為主題,從 AI Engineer 的工程視角出發,使用 Python 與 NVIDIA CUDA-Q,逐步建立一套完整的 Quantum Machine Learning(QML)實驗流程。
30 天的內容會從 Qubit、Quantum Gate、Measurement 等必要的量子計算基礎開始,進一步實作,本系列不預設量子模型一定優於傳統機器學習,而是透過 Classical ML、Quantum ML 與 Hybrid ML 之間的實際比較,記錄 Accuracy、F1 Score、Training Time、Circuit Cost、Shots、Backend 與執行環境等資訊,嘗試回答一個核心問題:
Quantum Machine Learning 在目前的工程條件下,到底能解決什麼問題,又需要付出多少計算成本?
整個系列的程式碼、實驗紀錄、Benchmark 與文章內容皆整理於 GitHub:
GitHub Repository
https://github.com/kancheng/qml-engineering-30-days
這 30 天希望留下的不只是 30 篇互相獨立的文章,而是一個可以持續累積、執行、驗證、比較與延伸的 QML Engineering Project。
假設你手上有一批花的資料,每筆記錄包含花瓣長度、寬度,以及已知的種類。你想寫一個程式,讓它看過這些例子後,能判斷另一朵花屬於哪一類。這是一個機器學習問題。
現在,把程式中的一部分計算換成量子電路,會發生什麼事?資料要怎麼送進去?電路如何給出答案?如果預測變準了,增加的時間與運算成本是否值得?
量子機器學習(Quantum Machine Learning,QML)研究量子計算如何參與機器學習。本系列從上述這類一般數值資料出發,逐步建立可以執行、比較與回查的實驗。第一天先弄清楚整個流程,以及一個貫穿後續章節的判斷原則:程式能執行、模型預測得更準、完成任務的成本更低,需要分別提出證據。
Quantum machine learning (QML) explores how quantum computation can contribute to machine learning. Starting with a simple flower classification task, this chapter follows the path from numerical inputs to quantum circuits, measurements, and model updates. It also establishes how experiments will be assessed: a working implementation, better predictions, and lower total cost are separate claims that require separate evidence.
為了方便說明,先假設只需要分辨 A、B 兩種花,而且每朵花只提供花瓣的長度與寬度。以下是虛構的教學資料,並非本專案的實測結果。
| 花瓣長度 | 花瓣寬度 | 已知種類 |
|---|---|---|
| 1.4 公分 | 0.2 公分 | A |
| 1.7 公分 | 0.4 公分 | A |
| 4.5 公分 | 1.5 公分 | B |
| 4.9 公分 | 1.8 公分 | B |
長度與寬度是模型可以使用的資訊,稱為特徵;A、B 是希望它學會預測的答案,稱為標籤。這種提供範例與正確答案的學習方式,叫作監督式學習。
最簡單的做法,可以先猜一條規則:「花瓣超過某個長度,就判斷為 B。」這裡的長度門檻是可以調整的數值,也就是模型的參數。如果錯分了太多花,就移動門檻,再看結果是否改善。更複雜的模型可能同時使用長度與寬度,並調整許多參數,但基本工作仍然是從範例中找出可用的判斷規則。
「學會」不能只靠記住這四筆資料來確認。我們真正關心的是:遇到沒看過的花,模型還能不能判斷正確?這種把學到的規則用於新資料的能力,稱為泛化能力。
因此,在加入任何量子工具之前,問題就應該先寫清楚:輸入是什麼、要預測什麼,以及用什麼方式判斷預測是否有用。
一般機器學習模型會把輸入數值經過一連串計算,得到預測。QML 的一種做法,是讓量子電路負責其中一段計算。整理資料、計算預測誤差與更新參數,仍可由一般電腦完成。
先沿著一朵花的資料走一遍:
花瓣長度、寬度
      ↓
一般電腦:把數值轉成適合電路的輸入
      ↓
量子電路:依輸入與目前參數執行操作
      ↓
量測:取得結果,累積成可供預測的數值
      ↓
一般電腦:產生預測,與已知種類比較
      ↓
調整參數,再用新的設定執行電路
這裡的量子電路,可以先理解成一張有順序的操作清單:先準備量子位元,再依序對它們做指定操作,最後讀取結果。單一步驟稱為量子閘。它們實際如何改變狀態,會在 Day 02–04 用數值與小電路說明。
量子位元(qubit)是量子計算使用的基本資訊單位。在本系列最先使用的讀取方式下,一次量測會得到 0 或 1。不過,描述量測前的狀態,還需要能影響後續運算的資訊,不能只列出得到 0、1 的機率就結束。Day 02 會說明這項差別為什麼重要。
把花瓣尺寸轉成電路可以處理的形式,稱為資料編碼。例如,可以先把長度縮放成某個角度,再用這個角度設定量子操作。這裡需要區分兩種數值:輸入角度隨著每朵花改變;模型參數則由訓練流程調整,用來學習一套適用於多朵花的規則。
如果電路裡有可調整的參數,就稱為參數化量子電路。一般電腦與量子運算共同完成任務的方式,稱為量子與經典混合計算;「經典」在這裡就是一般電腦使用的計算方式。
QML 的範圍比這一條流程更廣,也包含其他學習方法與來自量子系統的資料。本系列先聚焦在一般數值資料,方便把輸入、預測與比較條件交代清楚。
我們可以約定:用電路量到 1 的比例,作為「判斷為 B」的分數。
假設對同一朵花、同一組參數,重新準備並執行電路 100 次,其中 73 次量到 1,便得到分數 73 ÷ 100 = 0.73。再約定分數至少 0.5 就判為 B,這朵花便會被分到 B 類。這些數字只是說明流程的假設例子;0.5 是我們選的判斷門檻,並非量子計算強制的規則。
這種重複執行以取得結果的方式叫作取樣,執行次數常以 shots 表示。每一次都包含重新準備狀態、執行操作與量測,並不是對同一份未改變的狀態反覆讀取。
如果再做一組 100 次,可能只得到 69 次 1。這種差異可能只是有限次取樣造成的波動,未必表示程式有錯。增加次數通常能讓比例更穩定,但也要付出更多執行成本。若裝置本身有系統性的讀取偏差,多量幾次仍不會自動把偏差消掉。
接著,一般電腦會把分數與正確答案比較。假設用 1 代表 B,便可以用平方差衡量這筆預測的誤差:
預測分數為 0.73:誤差 = (0.73 − 1)² = 0.0729
預測分數為 0.90:誤差 = (0.90 − 1)² = 0.0100
這種把預測與答案的差距變成數值的規則,稱為損失函數。訓練時通常會綜合多筆資料的損失,再調整參數,嘗試讓整體損失下降。負責選擇如何調整的演算法,稱為最佳化器。
注意,0.73 與 0.90 在上述門檻下都已判為 B,但平方誤差仍然不同。這說明「分類答對幾題」與「訓練時如何衡量誤差」是兩種不同的觀察。量到 1 的比例也不會自動成為可信的種類機率;它與實際答對機會的關係,仍要用資料檢驗。
當訓練完成、參數選定後,對新資料執行同樣的輸入與預測流程,就叫作推論。此時沒有這朵花的正確答案可供當場修正模型。
改變模型的運算方式,也會改變它能表示的輸入與輸出關係。對花的分類而言,可以把這件事想成:模型能在「長度與寬度」構成的平面上,畫出哪些分界,把 A、B 兩類分開?
量子模型的資料編碼與電路安排,會影響這些可表示的關係。這是可以研究的問題:某種安排是否適合某類資料?需要多少參數與量測?能否在有限的訓練時間內找到好設定?資料編碼如何影響模型能表示的函數,已有專門的理論研究。Schuld、Sweke 與 Meyer(2021)
但「能表示某種關係」與「訓練找得到它」仍有距離。就像有一套很靈活的繪圖工具,不代表有限時間內就能畫出合適的分類邊界。工具更複雜,也可能更難調整。
對工程工作而言,理解 QML 的價值,在於能把一項新計算方法接進完整流程,檢查它解決了什麼問題、增加了哪些成本。對研究而言,則需要進一步提出可被實驗推翻或支持的假設,例如:
在相同輸入資料、資料切分與模型選擇預算下,讓資料多次進入量子電路,是否能改善未見資料上的分類表現?改善是否值得增加的電路執行成本?
這個問題指定了要改變的因素、要固定的條件,以及要觀察的結果,後續才有辦法設計比較。
假設有人展示以下數字。這是一張虛構的判讀練習表,不是本專案成果。
| 方法 | 測試答對比例 | 完整訓練時間 |
|---|---|---|
| 一般模型 | 90% | 2 秒 |
| 量子模型(在一般電腦上模擬) | 92% | 120 秒 |
這張表最多先告訴我們:在這一次列出的結果中,量子模型的答對比例較高,訓練也較久。要解釋這個差距,還需要知道以下條件。
第一,兩個模型是否拿到相同的題目與資訊? 如果一個只用花瓣長度,另一個同時使用寬度,差距可能來自輸入資訊。若量子模型必須先壓縮資料,也應讓一般模型使用相同的壓縮輸入做對照;必要時再保留使用完整輸入的一般模型,觀察壓縮本身的影響。
第二,考試資料是否事先被拿來挑設定? 我們把資料分成三種用途:訓練資料用來調參數,驗證資料用來挑選模型設定,測試資料留到設定選定後評估。這就像練習題、模擬考與最後考試各有角色;如果反覆看最後考試的成績來改模型,它就不再是獨立的檢驗。縮放資料時使用的平均值等資訊,也應只從訓練資料取得,避免把測試資訊帶進訓練。
第三,差距是否穩定? 模型的初始參數、資料切分與有限次量測,都可能讓結果改變。如果測試集只有 50 筆,90% 與 92% 就只差一筆答對。需要記錄樣本數,並依實驗目的重複不同設定,報告平均表現與波動,才能判斷差距是否值得進一步研究。
控制程式隨機序列的起始設定稱為隨機種子(seed)。保存種子有助於重做實驗,但也要保存軟體版本與執行條件;單靠同一個種子,無法保證不同硬體上的所有結果完全一致。
第四,一般模型是否獲得合理的調整機會? 解決相同任務的參考方法稱為比較基準(baseline)。可以從簡單分類規則開始,再加入合適的一般機器學習模型。兩者不必強迫使用相同參數量,但必須交代各自的複雜度與選擇設定所花的預算。只仔細調整量子模型,卻讓一般模型使用不合適的設定,會讓比較失去說服力。
第五,時間到底算了哪些步驟? 完整成本可能包含資料轉換、反覆執行電路、量測、更新參數與模型選擇。如果使用遠端量子硬體,還可能包含傳輸與排隊。只量某一小段計算,無法直接回答整個任務要花多久。
量子優勢是更強的主張:需要說明在什麼任務、品質要求、問題規模與成本條件下,量子方法優於適當的經典方法。單次準確率較高,或電路成功執行,都不足以單獨支持這個結論。
本系列可以先在一般電腦上執行量子電路,因為模擬器會用數值計算,模仿量子狀態如何變化。這讓我們能先檢查小電路與訓練流程。
| 名稱 | 在流程中的角色 |
|---|---|
| CPU:中央處理器 | 執行一般程式、整理資料、控制訓練流程,也能執行量子模擬 |
| GPU:圖形處理器 | 擅長大量適合平行處理的數值運算,可用來加速部分量子模擬 |
| QPU:量子處理器 | 實際在量子硬體上執行操作與量測 |
CPU 與 GPU 都是經典硬體。GPU 上的模擬變快,表示一般電腦更快完成某個量子模擬工作;要知道真實 QPU 的速度與預測品質,仍需要另外量測。
模擬也有容量限制。以直接保存完整純態向量的常見方法為例,n 個量子位元需要 2ⁿ 個複數係數。這裡的重點是:每增加一個量子位元,這部分儲存需求就加倍。 小電路能順利執行,不能直接外推更大電路的成本。其他模擬方法可能利用電路結構節省資源,因此也要記錄採用哪種方法。
這些係數用來描述量子狀態,並不代表真實量子電腦可以一次把所有係數讀出來。從電路取得可用答案,仍然受到量測方式與次數的限制。
到了真實硬體,還需要考慮操作與讀取的偏差,也就是雜訊。此外,並非任意兩個量子位元都能直接一起操作,可能需要增加中間步驟。考慮能同時執行的操作後,仍需依序完成的層數稱為電路深度;更深的電路通常也意味著要更仔細檢查時間與雜訊的影響。
CUDA-Q 是本系列用來描述量子電路、指定執行目標與取得結果的開發工具。它支援一般運算與量子運算共同構成的程式流程。NVIDIA CUDA-Q 入門文件
執行後端(backend)就是程式實際交給哪個模擬器或硬體。沿用電路描述可以減少改寫工作,但切換後仍需核對可用操作、數值精度與量測條件。
本專案以 Surface Pro 7 進行寫作、資料整理與小型數值計算,以 Ubuntu 主機與 RTX 3060 顯示卡進行 CUDA-Q 環境與 GPU 模擬實驗。具體環境與驗證範圍見 Day 06。目前專案的多 GPU 部分是情境模型,QPU 部分是本地預演;兩者都沒有對應的真實硬體實測,也尚未證明量子優勢。
有了完整流程,再看方法名稱就比較容易知道它們各自負責什麼。
| 方法 | 用花的分類來理解 | 後續入口 |
|---|---|---|
| 變分量子分類器(VQC) | 調整電路裡的參數,讓預測更接近已知種類;「變分」在這裡指反覆調整參數來改善目標值 | Day 15 |
| 混合神經網路 | 先由一般神經網路把尺寸轉成中間數值,再交給量子電路,兩部分一起調整;神經網路是由多層可調計算組成的模型 | Day 19 |
| 量子核方法 | 用量子狀態之間的關係建立兩朵花的相似度,再交給一般學習方法分類 | Day 23 |
量子核方法中的「核」是一種符合特定數學條件的比較函數。它與 CUDA-Q 中描述量子運算程式區塊的 quantum kernel,是不同概念。
後續也會改變資料進入電路的方式,以及電路的操作排列,觀察預測與成本怎麼變化。方法名稱只是索引;閱讀時可以持續追問:輸入如何轉換、哪些參數會學習、輸出如何形成,以及比較結果支持了什麼。
| 階段 | 要回答的問題 | 累積的成果 |
|---|---|---|
| Day 01–05 | 量子狀態、操作與量測如何連起來? | 能用小型數值計算核對電路 |
| Day 06–10 | 如何讓電路參與反覆學習? | 環境紀錄與第一個參數更新流程 |
| Day 11–15 | 一般資料如何變成分類預測? | 資料編碼、分類器與保存的模型 |
| Day 16–20 | 量子、一般與混合模型差在哪裡? | 固定條件的比較與花卉資料實驗 |
| Day 21–25 | 資料太多或模型學不動時,原因是什麼? | 輸入壓縮、核方法與訓練限制的分析 |
| Day 26–30 | 雜訊、規模與硬體條件如何影響結論? | 效能紀錄、硬體執行準備與成果證據整理 |
完整章節見 30 天學習路線。
一個可供他人檢查的專案,需要把「為什麼這樣做」與「怎麼得到結果」連起來。每個重要實驗應保留問題、資料來源與切分、比較方法、執行環境、結果,以及尚未回答的限制。例如,若只測過少量輸入特徵,就應把結論限定在這些條件內,並說明下一步如何檢查規模增加後是否仍成立。
這些紀錄讓讀者能順著文章找到程式,再從程式找到保存結果。即使某次比較沒有改善,也能留下有用的分析:哪項假設沒有得到支持、可能原因是什麼,以及還需要哪個實驗才能區分原因。
Day 01 的產出是一份能指引後續實驗的問題定義。沿用花的分類,可以先寫成:
| 項目 | 本日練習設定 |
|---|---|
| 任務 | 根據花瓣長度與寬度,判斷 A、B 兩類 |
| 輸入與答案 | 兩個尺寸數值,以及每筆資料的已知種類 |
| 一般比較方法 | 先建立簡單分類規則,再選擇適當的一般模型 |
| 量子方法 | 把尺寸轉成電路操作的角度,調整電路參數,以量測比例形成預測 |
| 評估方式 | 在保留的測試資料上計算答對比例,記錄重複實驗的波動 |
| 成本紀錄 | 記錄完整訓練時間、預測時間與量測次數 |
| 結論邊界 | 小型模擬結果只能支持相應條件下的觀察,不能直接代表真實硬體或更大規模的表現 |
到這裡,可以試著回答三個問題:
回答時,將條件、觀察與推論分開:條件是兩個模型拿到什麼資料與資源;觀察是實際量到的數值;推論則是這些數值能支持到哪裡。這個習慣會一路用在後續的程式與實驗報告中。
基礎數學可以從 [F1] 的量子狀態、量子閘與量測開始;[R1]、[R2] 是整理多項研究的綜述,適合建立領域地圖;[R4] 將有標籤資料的學習問題接到量子計算;[P1] 則深入分析資料編碼如何限制模型能表示的關係。
閱讀一篇研究時,可以先記下它使用什麼資料、與誰比較、計算哪些成本,以及證據來自理論、模擬還是真實硬體。完整書目與用途見 文獻與資源索引。
延伸閱讀:[N1] Shreeya Sanjeev Gokhale et al., “A review of quantum machine learning algorithms, applications, and emerging advantages,” Discover Computing 29, 226 (2026)。原始來源;完整書目。可沿用上面的問題整理閱讀筆記,區分方法構想與支持結論的證據。
Day 02|從 Bit 到 Qubit:量子狀態與量測機率
今天把量子電路視為流程中的一段計算。下一篇會打開這一段,從 0 與 1 開始,說明量測前的量子狀態如何表示,以及為什麼兩個狀態即使有相同的 0、1 量測機率,經過後續操作仍可能出現不同結果。


 iThome鐵人賽
 看影片追技術