
Day1 用花卉分類說明:量子電路可以把輸入轉成量測結果,再由一般電腦整理成預測分數。如果執行 1,000 次,有大約一半量到 1,便能得到接近 0.5 的分數。
但這裡藏著一個問題:知道 0 與 1 各有多少機率,是否就知道電路裡的量子狀態?
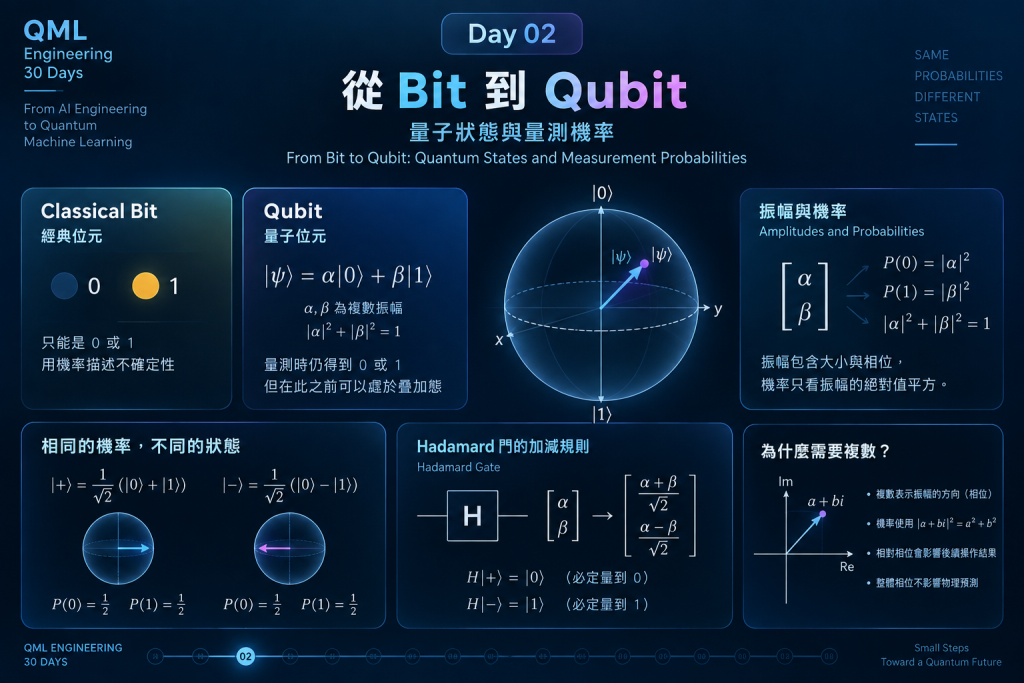
答案是還不夠。今天會看到兩個狀態,直接量測時都是一半 0、一半 1;對它們做同一個操作後,一個必定得到 0,另一個卻必定得到 1。要解釋這個差別,我們需要一組比機率更完整的數值,也就是「振幅」。
本章從兩個數如何排列開始,逐步算出機率、拆解正負號與複數的作用,最後用 Python 核對理論與抽樣結果。討論範圍先限定為單一量子位元的理想純態,也就是能用一個狀態向量完整描述的情況;雜訊或隨機混合不同狀態時,可能需要更一般的描述。
Day1 used measurement frequencies to form a prediction score. Day2 asks why these probabilities do not fully describe a quantum state. Starting with two-component vectors, we calculate measurement probabilities, show how relative phase changes the outcome of a later operation, and verify the calculations with Python. The examples distinguish ideal single-qubit pure states, theoretical probabilities, and finite-sample estimates.
一般電腦的位元(bit)可以取 0 或 1。例如,用 0 表示開關關閉、1 表示開啟。即使不知道開關目前在哪個位置,也可以用機率描述自己的不確定性。
量子位元(qubit)在本章使用的量測方式下,也只會得到 0 或 1。因此,光是看到一串隨機出現的 0、1,還不足以看出量子計算有何不同。差別要放到「量測前能做哪些操作,以及操作後會得到什麼」來觀察。
為了預測這些操作的結果,單一量子位元的純態使用兩個數描述,依序對應 0 與 1。我們先從一個只含一般實數的例子開始:
狀態向量 = [0.6, 0.8]ᵀ

對應 0 的振幅:0.6
對應 1 的振幅:0.8
向量就是按順序排列的一組數值。右上角的 ᵀ 表示把橫向排列改成直向排列,稱為轉置;這裡是為了在文字中方便排版。
這兩個數稱為機率振幅,簡稱振幅。它們用來計算機率,但本身並不是機率。以這個例子來說,量到 0 的機率不是 60%,量到 1 的機率也不是 80%。下一節會實際算出答案。
對本節的實數振幅,只要先平方,就能得到本章 0/1 量測的機率:
P(0) = 0.6² = 0.36 = 36%
P(1) = 0.8² = 0.64 = 64%

兩個機率相加:0.36 + 0.64 = 1
P(0) 讀作「得到 0 的機率」。如果每次都重新準備這個狀態,再量測一次,長期累積的結果會以約 36% 的比例出現 0、約 64% 出現 1。這不表示每做 100 次就一定剛好有 36 個 0。
機率總和必須是 1,因為本次量測的可能結果只有 0 與 1。對狀態向量而言,這項限制稱為正規化:所有振幅的絕對值平方相加等於 1。它也等同這個向量的長度為 1。
現在試試 [1, 1]ᵀ。兩項平方相加是 2,所以它還不能直接作為已正規化的狀態。要保留兩項相等的比例,可以將整個向量除以它的長度 √2:
原本的向量:[1, 1]ᵀ
向量長度:√(1² + 1²) = √2
正規化後:[1/√2, 1/√2]ᵀ

P(0) = (1/√2)² = 1/2
P(1) = (1/√2)² = 1/2
這也說明為什麼量子公式常出現 1/√2:它約等於 0.7071,平方後才是 0.5。如果把兩個振幅都寫成 0.5,機率總和只會是 0.25 + 0.25 = 0.5。
非零向量可以用「除以長度」的方法正規化;全為零的向量長度是 0,不能這樣處理,也無法代表量子純態。這裡是在整理數學描述,實際硬體仍需要透過操作準備對應的狀態。
論文不會每次都把兩個分量完整列出來,而是經常寫成:
|ψ⟩ = α|0⟩ + β|1⟩
可以把它讀成:「這個叫作 psi 的狀態,對應 0 的振幅是 alpha,對應 1 的振幅是 beta。」符號與前面的數值一一對應:
| 寫法 | 意思 | 向量表示 |
|---|---|---|
|0⟩ |
在本章量測方式下必定得到 0 的狀態 | [1, 0]ᵀ |
|1⟩ |
在本章量測方式下必定得到 1 的狀態 | [0, 1]ᵀ |
|ψ⟩ |
替目前討論的狀態取的名稱 | [α, β]ᵀ |
ψ、α、β 是希臘字母,用途和程式裡替變數命名相似。外面的 | ⟩ 稱為 ket,是表示向量的一種寫法,屬於狄拉克符號(Dirac notation)。|0⟩ 是整個向量的名稱,不是數字 0。
前面的例子因此可以寫成:
0.6|0⟩ + 0.8|1⟩ = [0.6, 0.8]ᵀ
|0⟩ 與 |1⟩ 是這套表示方式的兩個基本方向,合稱計算基底。類似在平面上指定水平與垂直方向後,才能說明座標各代表什麼。本文所說的「直接量測」,都是指在這個基底下量測。
當兩項振幅都不為零,就說這個狀態相對於計算基底具有疊加。這表示描述中同時包含兩個基底方向的分量;一次量測仍只會輸出其中一個結果。疊加是否出現也與選用的基底有關,不能脫離表示方式來判斷。
考慮下面兩個狀態。它們只差一個負號:
|+⟩ = [1/√2,  1/√2]ᵀ
|−⟩ = [1/√2, −1/√2]ᵀ
|+⟩ 與 |−⟩ 是替狀態取的名稱,不是新的量測輸出。直接算平方,兩者都得到 P(0) = P(1) = 1/2,因為正負號在平方時消失了。
現在,對兩個狀態做同一個操作,稱為 Hadamard 閘,簡記為 H。量子閘就是改變量子狀態的基本操作。今天先用它的加減規則計算,不需要先學矩陣乘法:
輸入振幅:[α, β]ᵀ

H 操作後:
對應 0 的新振幅 = (α + β) / √2
對應 1 的新振幅 = (α − β) / √2
將 |+⟩ 代進去:
對應 0:(1/√2 + 1/√2) / √2 = 1
對應 1:(1/√2 − 1/√2) / √2 = 0

得到 [1, 0]ᵀ,也就是 |0⟩,之後必定量到 0。
再將 |−⟩ 代進去:
對應 0:(1/√2 + (−1/√2)) / √2 = 0
對應 1:(1/√2 − (−1/√2)) / √2 = 1

得到 [0, 1]ᵀ,也就是 |1⟩,之後必定量到 1。
| 準備的狀態 | 直接量測 | 先做 H,再量測 |
|---|---|---|
|+⟩ |
0、1 各 50% | 必定得到 0 |
|−⟩ |
0、1 各 50% | 必定得到 1 |
這裡每一種流程都要從重新準備的狀態開始。例如,「先做 H,再量測」不包含前一欄的直接量測。
原本看不出的正負號,經過操作後,變成可觀察的機率差異。振幅在組合時可能相加,也可能抵消,這稱為干涉。水波相遇時也有增強與抵消,可以借這個現象理解加減的效果;這裡實際相加的是量子振幅。
因此,如果程式只保存 [0.5, 0.5] 這份機率表,就無法判斷做完 H 後應該得到哪一個答案。振幅必須先經過運算,再轉成機率;提早丟掉正負號等資訊,可能算出錯誤的後續結果。
正負號讓我們看到振幅包含方向資訊。若把正實數畫成向右的箭頭,負實數就是向左的箭頭,兩者相差半圈。更一般的量子狀態需要描述不只左右兩個方向,因此會使用複數。
複數寫成 a + bi。可以先把它看成平面上的箭頭:橫向分量是 a,縱向分量是 b。例如,3 + 4i 對應從原點指向 (3, 4) 的箭頭,長度是 5。i 是虛數單位,運算規則為 i² = −1。
箭頭的長度稱為複數的絕對值,指向的角度稱為相位。計算量測機率時,我們取的是長度的平方:
|a + bi|² = a² + b²
因此,完整的機率規則是:
P(0) = |α|²
P(1) = |β|²
這稱為波恩規則(Born rule)。兩側的直線在這裡表示複數絕對值,與包住狀態名稱的 |ψ⟩ 是不同用途。機率規則是量子理論用來連接狀態與實驗結果的基本規則,並非只靠「機率總和為 1」就能推導出來。
例如,讓第二個振幅轉向複數平面的上方:
α = 1/√2
β = i/√2

P(0) = |1/√2|² = 1/2
P(1) = |i/√2|² = 0² + (1/√2)² = 1/2
如果直接把 β 平方,會得到 −1/2,不可能是機率。程式因此需要算 abs(振幅) ** 2,不能一般地用 振幅 ** 2 代替。
同一狀態內,兩個非零振幅的方向差稱為相對相位。|+⟩ 的兩項方向相同,|−⟩ 的兩項則相差半圈。上一節已經算出,這種差別能在後續操作中被看見。
若將所有振幅一起乘上同一個長度為 1 的複數,則只是把所有箭頭轉過相同角度,稱為改變整體相位。例如:
[ 0.6,  0.8]ᵀ
[−0.6, −0.8]ᵀ
這兩個向量描述同一個物理純態,因為整體反號沒有改變兩項之間的關係。對整個狀態共同施加這個相位,不會改變後續操作與量測的物理預測。相比之下,只改一項符號,就可能改變相對相位與實驗結果。
為了算長度平方,可以把複數乘上自己的複共軛:把虛部反號,例如 a + bi 的共軛是 a − bi,相乘便得到 a² + b²。
把 |ψ⟩ 轉成橫向排列,再對每一項取複共軛,就得到 bra,記作 ⟨ψ|。兩者相乘寫成:
⟨ψ|ψ⟩ = α*α + β*β = |α|² + |β|² = 1
星號代表複共軛。這種對應分量相乘再相加的計算稱為內積;在複數向量中,要先對第一個向量取共軛。⟨ψ|ψ⟩ = 1 就是在用精簡符號說:「這個狀態的長度平方是 1,符合正規化條件。」
狀態向量、複數振幅與正規化的標準寫法,也可對照 IBM Quantum 的量子資訊教材。
回到 [0.6, 0.8]ᵀ。在理想的計算基底量測下:
量測前:0.6|0⟩ + 0.8|1⟩

36% 的機率 → 得到 0,量測後狀態為 |0⟩
64% 的機率 → 得到 1,量測後狀態為 |1⟩
如果第一次得到 0,立刻用相同方式再量一次,中間沒有其他操作或干擾,就仍然得到 0。這次再量的已經是 |0⟩,不是最初的疊加態。
所以,要估計原本 36% 與 64% 的分布,必須反覆做「準備原本狀態 → 量測 → 記錄」。這種獨立重複的次數稱為 shots。不能只準備一次,再把後續連續讀取的結果當成原本分布的樣本。
同樣地,如果在上一節的 H 操作之前先量測,就會改變要交給 H 的狀態,無法再沿用未量測時的推導。電路裡的操作順序,包括量測放在哪裡,都屬於實驗條件。
本章附的程式使用 [1/√2, i/√2]ᵀ,理論上量到 0、1 的機率都是 0.5。在本次執行環境中,固定隨機種子 42、抽樣 1,000 次後,得到 503 個 0 與 497 個 1。
| 數值 | 對應 0 | 對應 1 |
|---|---|---|
| 理論機率 | 0.5 | 0.5 |
| 抽樣次數 | 503 | 497 |
| 次數除以 1,000 的估計比例 | 0.503 | 0.497 |
有限次抽樣的比例會波動,這不是理論機率改變了。更精確地說,在每次獨立、成功機率固定為 p 的條件下,用 N 次樣本估計機率,估計值的標準差是:
標準差 = √(p(1 − p) / N)
標準差描述重做許多批實驗時,估計值通常波動的尺度,並非每一批誤差都不能超過的上限。當 p = 0.5、N = 1,000 時,這個尺度約為 0.0158,也就是 1.58 個百分點。0.503 與 0.5 相差 0.3 個百分點,落在這個尺度內。
由公式也能看出,要讓這種波動尺度減半,樣本數要增加到四倍。更多 shots 能改善抽樣精度,但若硬體持續把某些 1 誤讀成 0,多做幾次不會自動消除這種偏差。
Day1 用量到 1 的比例當作分數。另一種常見做法,是把量到 0 記為 +1,量到 1 記為 −1,再求平均:
理論平均 = (+1) × P(0) + (−1) × P(1)
         = P(0) − P(1)

本次樣本平均 = (503 − 497) / 1,000 = 0.006
依機率計算的平均稱為期望值,上述特定記分方式對應 Z 量測的期望值,常寫成 ⟨Z⟩。本例理論值是 0,抽樣估計則是 0.006。若要轉回量到 1 的機率,可以用 P(1) = (1 − ⟨Z⟩) / 2;將樣本平均代入,就還原成 0.497。
因此,讀模型輸出時要先確認它代表什麼:是量到 1 的比例、以正負一記分的平均,還是後續轉換過的分數。它們的數值範圍與解讀方式不同。
現在已經看到,單一量子位元的純態需要同時描述振幅大小與相對相位。布洛赫球(Bloch sphere)把這些資訊整理成球面上的位置:
| 球面位置 | 代表的狀態或性質 |
|---|---|
| 北極 | |0⟩,直接量測必定得到 0 |
| 南極 | |1⟩,直接量測必定得到 1 |
| 越靠近北極 | 直接量到 0 的機率越高 |
| 赤道 | 直接量到 0、1 的機率各半 |
| 赤道上不同的方向 | 機率相同,但相對相位不同;|+⟩ 與 |−⟩ 在相反兩側 |
這張地圖的用途,是把「機率表看不見的差異」也畫出來。只看 0/1 機率,像是只知道球面位置的南北高度,還不知道繞著球的哪個方向。
對應的公式是:
|ψ⟩ = cos(θ/2)|0⟩ + e^(iφ) sin(θ/2)|1⟩
θ(theta)是從北極方向量起的角度,從 0 到半圈;φ(phi)是繞南北軸轉過的角度。sin、cos 是三角函數,而 e^(iφ) = cosφ + i sinφ 表示一個長度為 1、方向為 φ 的複數。
公式的兩個角色可以分開讀:cos(θ/2) 與 sin(θ/2) 決定振幅大小,所以機率為 cos²(θ/2) 與 sin²(θ/2);e^(iφ) 不改變第二項的長度,只設定相對相位。三角恆等式 cos² + sin² = 1 則確保機率總和為 1。
例如,θ = π/2 表示從北極走到赤道,其中 π 弧度等於半圈。此時兩個振幅大小都是 1/√2;再選 φ = 0,得到 |+⟩,選 φ = π,就得到 |−⟩。在兩極有一項振幅為零,φ 不再區分不同的物理純態。
球面上的點表示量子狀態,不是粒子真的位於球面某處。單一量子位元的理想量子閘可對應球面旋轉;受到雜訊或隨機混合的狀態也可能對應球內部的點,需要後續介紹的混合態描述。多個量子位元之間的完整關係,則不能只靠一顆球,或把每顆球分開畫就全部表達。
本章使用 Python 的數值運算套件 NumPy,在一般電腦上計算向量與抽樣。已備妥專案 NumPy 環境後,從專案根目錄執行:
python articles/day02/state_vector.py
完整程式見 state_vector.py。先把最核心的計算拆出來看:
import numpy as np

state = np.array([1 / np.sqrt(2), 1j / np.sqrt(2)], dtype=complex)

norm_squared = np.vdot(state, state).real
probabilities = np.abs(state) ** 2

print(f"norm_squared = {norm_squared:.1f}")
print(f"P(0) = {probabilities[0]:.1f}")
print(f"P(1) = {probabilities[1]:.1f}")
1j 是 Python 表示虛數單位的方式。np.vdot 對第一個向量取複共軛後計算內積,.real 取實部,np.abs 計算絕對值。輸出為:
norm_squared = 1.0
P(0) = 0.5
P(1) = 0.5
這裡算出的機率是由狀態向量直接得到的理論值,只受到電腦有限數值精度的影響,沒有有限 shots 的抽樣波動。完整程式會再進行抽樣,本次執行輸出為:
state = [0.70710678+0.j         0.        +0.70710678j]
norm = 1.000000
P(0) = 0.500000
P(1) = 0.500000
shots = 1000, seed = 42
counts = {'0': 503, '1': 497}
完整程式的 norm 輸出實際上也是長度的平方。它先檢查狀態是否已正規化,再用理論機率生成 1,000 個樣本;這是在一般電腦上模擬獨立重複量測的統計,沒有使用真實量子硬體,也沒有逐次模擬量測後的狀態。
隨機種子(seed)控制程式產生隨機序列的起始設定,方便在相同環境重現。503 與 497 是這次程式抽樣的結果;更換種子或執行環境時,應重新記錄輸出,不能把這兩個數當成量子規則要求的答案。
以下是可以獨立執行的第二段範例,直接照第 4 節的加減規則寫出 H 操作:
import numpy as np


def apply_h(state):
    alpha, beta = state
    return np.array([alpha + beta, alpha - beta]) / np.sqrt(2)


plus = np.array([1, 1], dtype=complex) / np.sqrt(2)
minus = np.array([1, -1], dtype=complex) / np.sqrt(2)

for name, state in [("plus", plus), ("minus", minus)]:
    before = np.abs(state) ** 2
    after = np.abs(apply_h(state)) ** 2
    print(f"{name}: before={before.round(6)}, after={after.round(6)}")
預期輸出:
plus: before=[0.5 0.5], after=[1. 0.]
minus: before=[0.5 0.5], after=[0. 1.]
這段程式在核對一個明確的數學主張:直接量測機率相同的兩個狀態,經過相同操作後,可以得到不同機率。它不涉及模型訓練,也不是量子硬體的效能實驗。
Day1 把花瓣長度與寬度組成輸入。假設某筆教學資料是 [3, 4],這是一份尺寸紀錄,長度不必等於 1。若想把兩個數作為單一量子位元的振幅,就必須先正規化:
資料:[3, 4]
長度:√(3² + 4²) = 5
正規化後:[0.6, 0.8]
對應量測機率:[0.36, 0.64]
但另一筆資料 [6, 8] 也會變成 [0.6, 0.8]。如果只保留這個狀態,兩筆資料原本的整體大小差異就消失了。把資料變成合法的量子狀態,與保留任務需要的資訊,是兩個都要檢查的問題。 後續的振幅編碼章節會繼續討論這種轉換與實際準備成本。
此外,Python 程式能直接印出完整向量,是因為一般電腦本來就保存了這些數值。真實量子裝置不能靠一次 0/1 量測,把兩個複數振幅全部讀出;要估計未知狀態,通常需要準備多份相同狀態,使用不同量測設定並累積統計。
對 n 個量子位元,完整純態向量有 2ⁿ 個複數振幅。1、2、3 個量子位元分別需要 2、4、8 個分量,直接保存完整向量的模擬方法因此會隨規模增加而迅速耗用記憶體。但狀態空間大,不表示資料可以免費送入,也不表示一次就能讀出所有答案;運算與讀取成本仍要分別分析。
問題一:[0.5, 0.5]ᵀ 可以直接作為已正規化的純態嗎?
不行。長度平方是 0.5,還沒有達到 1。將它除以自己的長度 √0.5,才得到 [1/√2, 1/√2]ᵀ。檢查的是振幅的絕對值平方總和,不是振幅相加的結果。
問題二:兩個狀態直接量測都是各一半,就能說它們相同嗎?
不能。|+⟩ 與 |−⟩ 提供反例:先做 H 後,量測結果完全不同。只看單一基底的機率表,會遺漏相對相位資訊。
問題三:抽樣比例從 0.500 變成 0.497,能說模型變差嗎?
還不能。先確認比較的是理論機率還是抽樣估計,再檢查 shots、波動大小、狀態與操作是否相同。如果還要談分類品質,則需要把分數轉成預測,再與保留資料的正確答案比較。
整理本日實驗時,可以保留狀態向量、量測前的操作、理論機率、shots、種子與抽樣計數。這些資訊讓他人能分辨:差異來自狀態、操作,還是有限次抽樣,也能把手算、程式與結論逐一對上。
完整書目與使用目的見 文獻與資源索引。
[N2] Theodore McKeever and Ahsan Nazir. “An Introduction to the Foundations and Interpretations of Quantum Mechanics.” arXiv:2603.09818v2 (2026);預印本講義。原始來源;完整書目。
這份預印本講義可作為狀態與量測議題的延伸入口。閱讀時,先區分用來計算實驗結果的規則,以及對這些規則的物理解釋;上傳至 arXiv 本身不代表已通過同行審查。
今天用加減法看見 H 操作如何讓相對相位變成機率差異。下一篇會把這些操作寫成矩陣,依序計算不同量子閘的作用,並檢查為什麼理想量子閘能保持機率總和為 1。


 iThome鐵人賽
 看影片追技術