
Day 19 讓「指數 > 200 日線」和「四家族投票」過了四道門,Day 20 把它們做成曝險。這篇要把那個結論打回原形:它們的優勢全部來自 2008 年一次事件,拿掉那一年就沒有了;而 3,000 個隨機亂擲的開關裡,有 90 個也能過四道門。
擇時的資料看起來很多——二十一年、五千多個交易日——但擇時要抓的是空頭,空頭在這二十一年裡只發生六次。你在六個點上挑參數,挑到的多半是雜訊。
0050 從高點回檔超過 15% 的事件,2005 年以來有十次:
高點          谷底          回到高點      深度
2006-05      2006-06       2006-11      −16%
2007-10      2008-11       2011-01      −56%
2011-01      2011-12       2013-05      −23%
2015-04      2015-08       2016-08      −21%
2018-08      2019-01       2019-09      −18%
2020-01      2020-03       2020-07      −28%
2022-01      2022-10       2024-02      −34%
2024-07      2024-08       2025-01      −21%
2025-01      2025-04       2025-07      −27%
2026-06      2026-07       (進行中)    −15%
十次裡只有 2008 一次超過 40%,2022 一次超過 30%,其餘八次在 15% 到 28% 之間,跟 0050 一年的標準差(20%)同一個量級。擇時能賺的是「躲掉大的」,大的只有一到兩次。
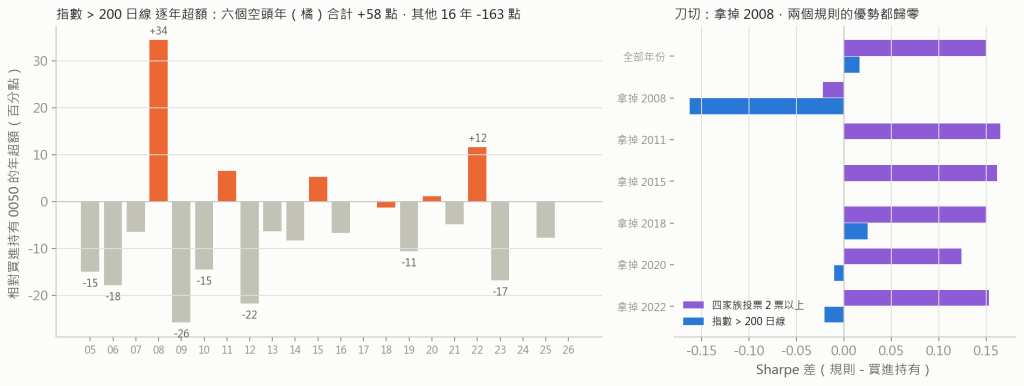
把「指數 > 200 日線」相對買進持有的年超額攤開:六個空頭年合計 +58 個百分點,其中 2008 年一年 +34;其他 16 年合計 −163 個百分點——2009 年 −26、2012 年 −22、2006 年 −18、2023 年 −17。二十一年加起來它是輸的(年化 11.6% 對 15.0%),Sharpe 贏是因為波動小。
刀切法把年份一個一個拿掉,看 Sharpe 差(規則減買進持有):
                 指數 > 200 日線    四家族投票 ≥ 2
全部年份            +0.02             +0.15
拿掉 2008           −0.16             −0.02
拿掉 2011           −0.00             +0.16
拿掉 2015           +0.00             +0.16
拿掉 2018           +0.03             +0.15
拿掉 2020           −0.01             +0.12
拿掉 2022           −0.02             +0.15
拿掉 2008,均線規則從小贏變成明顯輸,投票規則從 +0.15 變成 0。拿掉其他任何一年都沒差。這兩個規則過四道門,靠的是同一個樣本點。
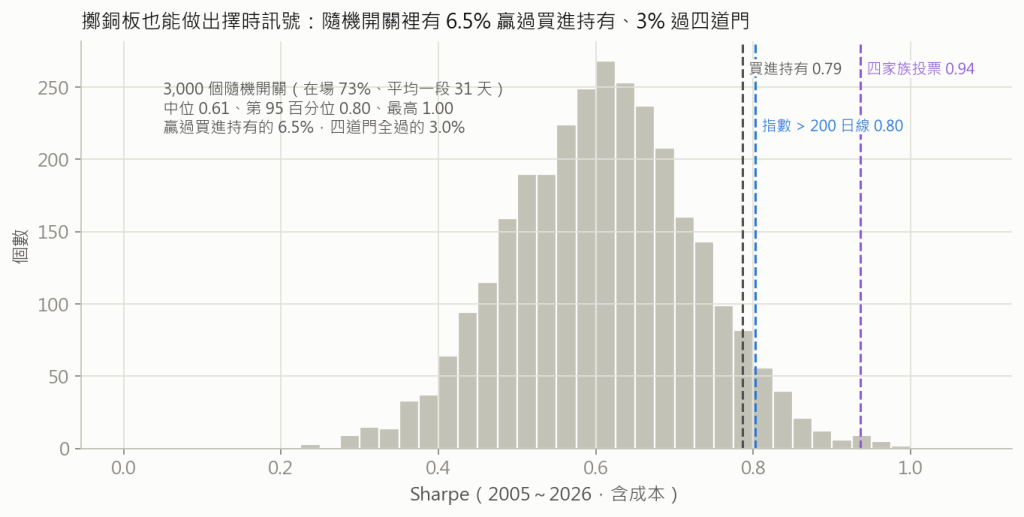
做 3,000 個隨機開關:在場比例跟 200 日線規則一樣(73%),一段持有或空手的平均長度也一樣(31 天),進出時點純亂數。套在 0050 上、含成本:
隨機開關的 Sharpe        中位 0.61    第 95 百分位 0.80    最高 1.00
贏過買進持有 0.79 的      6.5%
贏過 200 日線 0.80 的     4.8%
贏過投票 0.94 的          0.5%
四道門全過的              3.0%(90 個)
在 2005 到 2026 這段資料上,隨便亂擲,二十個裡有一個贏過買進持有,三十個裡有一個能過 Day 19 的四道門。均線規則的 0.80 落在隨機分布的第 95 百分位——比大多數亂數好,但沒有好到能說「這不是運氣」。投票規則的 0.94 是第 99.5 百分位,好一些,而它的優勢也是 2008 那一年給的。
四道門擋得住爛規則,擋不住運氣。這是 Day 19 沒講的那半句。
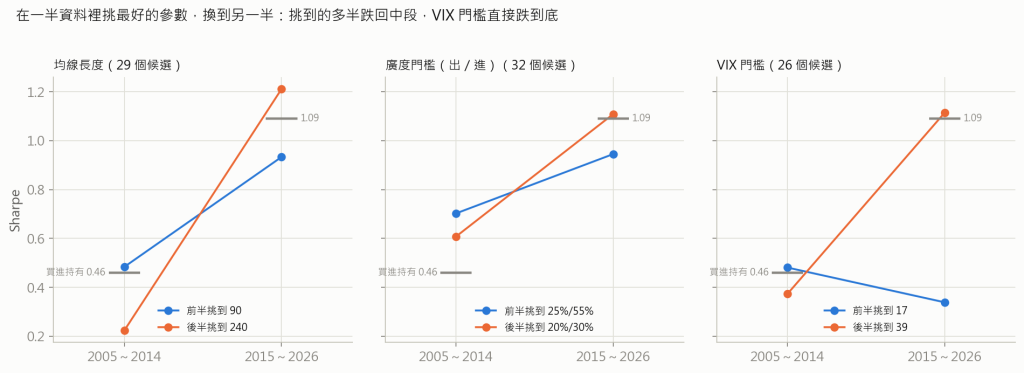
三組參數網格:均線長度 20 到 300(29 個)、廣度出場/進場門檻對(32 個)、VIX 門檻 15 到 40(26 個)。在前半段(2005~2014)挑 Sharpe 最高的,拿到後半段(2015~2026)看;再反過來做一次。
                      前半挑到    前半    後半     後半排名       後半挑到    後半    前半     前半排名
均線長度               90 日      0.48    0.93     26/29         240 日     1.21    0.22     25/29
廣度門檻              25%/55%     0.70    0.94     14/32        20%/30%     1.11    0.61      8/32
VIX 門檻               17        0.48    0.34     25/26          39        1.11    0.37      9/26
(買進持有)                      0.46    1.09                                1.09    0.46
前半段最好的均線是 90 日,到後半段排 29 個裡的第 26;後半段最好的是 240 日,到前半段排第 25。兩段挑出來的參數差了快三倍,而且都在另一段墊底。VIX 更慘:前半挑到 17,後半 Sharpe 0.34,連買進持有的三分之一都不到。
全樣本挑出來的「最佳」——均線 190、廣度 20%/30%、VIX 38——是把兩段各自的運氣加起來,這三個數字沒有任何一個是事前可以猜到的。
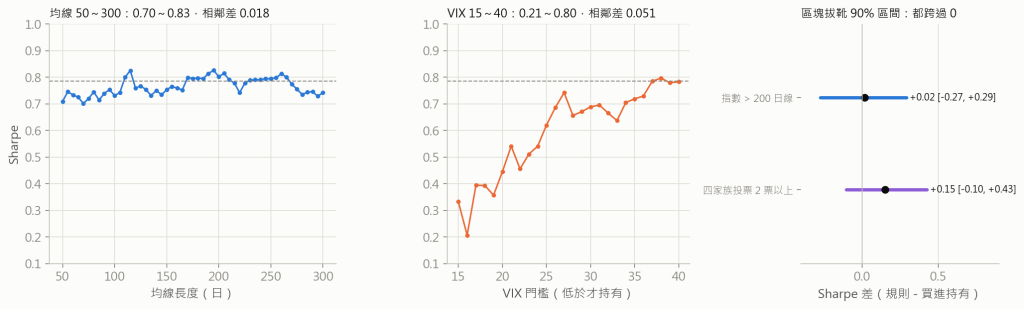
Day 19 說參數要平,這裡給量法:把參數細切,看相鄰兩個的 Sharpe 差多少。
均線 50~300 日,步 5     Sharpe 0.70~0.83    相鄰差平均 0.018    MA55 0.75、MA65 0.73
VIX 門檻 15~40           Sharpe 0.21~0.80    相鄰差平均 0.051
廣度門檻 32 組            Sharpe 0.64~0.89
均線是一條平緩的曲線,55 和 65 差 0.02,往哪邊挪都差不多——它的成績不靠某個特定數字。VIX 是鋸齒,相鄰差平均是均線的三倍,門檻從 16 換到 17 就差 0.19,這種形狀的規則是在對六個空頭的時點對號入座。
最後用區塊拔靴問一次:規則贏買進持有的那點 Sharpe,是真的還是抽樣誤差?把二十一年的日報酬切成 60 日一塊、重抽 2,000 次:
指數 > 200 日線     Sharpe 差 +0.02    90% 區間 [−0.27, +0.29]    差 ≤ 0 的比例 49%
四家族投票 ≥ 2      Sharpe 差 +0.15    90% 區間 [−0.10, +0.43]    差 ≤ 0 的比例 17%
兩個區間都跨過 0。均線規則有一半的重抽是輸的;投票規則好一點,但六分之一的重抽也是輸的。二十一年的資料量,不足以說任何一個擇時規則「顯著」贏過什麼都不做。
要,但理由不是報酬。
這幾篇累積下來的事實:擇時不加報酬(Day 19),分級不加報酬(Day 20),優勢集中在一次事件、統計上分不出運氣(這篇)。它唯一穩定做到的是把 −56% 變成 −25% 上下,而這件事不只 2008 那年成立——逐年超額在六個空頭年裡五個為正。擇時層的用途是砍尾巴,不是加 Sharpe,評估它的時候看最大回檔和空頭年,不看全期 Sharpe。
既然挑不出「最佳參數」,就不要挑。這個系列的做法:
1. 參數用整數、用慣例:200 日線、±5%、5 日確認。不用網格搜出來的數字
2. 只用參數曲線平的訊號:均線可以,VIX 門檻、廣度門檻不行——四家族投票裡有兩票就是這種訊號,它的 +0.15 要再打折;之後的曝險只用 Day 20 的均線階梯
3. 每個規則附相鄰參數的成績;相鄰差超過 0.05 的不用
4. 報告時把空頭年和其他年分開列,並附拿掉 2008 的版本
5. 擇時層的部位是曝險 0~1,不做反向、不加槓桿;它能做的只有少虧
同樣的邏輯回頭套在選股層:飆股名單七年留出期每週一份,三百多個樣本,命中率的雜訊是幾個百分點;擇時層六個樣本,雜訊是整個結論。哪一層的數字可以信、可以信到什麼程度,看的是樣本點,不是年數。
**空頭只有六次,大的只有一次。**0050 回檔超過 15% 的事件二十一年十次,超過 40% 的只有 2008。
**兩個過門的規則,優勢全在 2008。**拿掉那一年,均線規則 Sharpe 差 −0.16、投票規則 0;其他年份拿掉哪一年都沒差。
**隨機開關 3,000 個,6.5% 贏過買進持有、3% 過四道門。**四道門擋得住爛規則,擋不住運氣。
**一半資料挑的參數,到另一半墊底。**均線前半挑 90 日、後半挑 240 日,各自在另一段排倒數;VIX 前半挑 17,後半 Sharpe 0.34。
**拔靴區間都跨過 0。**均線規則一半的重抽是輸的。擇時層留著是為了砍尾巴,評估看回檔和空頭年;參數用整數,不搜。


 iThome鐵人賽
 看影片追技術