
LLM 在這條產線上能站三個位置,風險完全不同。
**特徵萃取器。**把文字變成數字:這則新聞是正面還是負面、這份法說會逐字稿的語氣、這段財報附註有沒有提到訴訟。輸出是一欄特徵,餵給 Day 15 的模型,用同一把尺量。風險兩個:前視偏誤(這篇),和可重現性(Day 24)——同一則新聞明年再問一次,數字要一樣。
**研究助理。**寫程式、抓資料、審回測。這個系列從 Day 1 到現在的程式,大半是這樣寫出來的。風險是它很會把錯的東西寫得很順:一個把未來報酬當特徵的洩漏,它可以寫得毫無破綻,還附上漂亮的 Sharpe。Day 28 會拿合成資料去抓這種事。
**決策者。**直接問它「這檔該不該買」。這個位置這個系列不碰。理由不是它答得不好,是答案沒有辦法驗證:它每次的理由都不一樣、成本無法回測、而且前視偏誤在這裡最嚴重——它「建議」2019 年買聯發科的時候,是因為它知道聯發科 2020 年漲了九成。
第五幕只用第一種角色。文字進去、數字出來、數字過尺。
語言模型的訓練資料是網路文本,截止在某個時間點。2021 年以後訓練的任何模型,都讀過 2020 年全年的財經新聞:疫情、油價負值、居家辦公、5G、聯發科的營收月月創高、台塑四寶的虧損。
拿 2019 年 6 月底市值最大的 40 檔上市公司,看它們接下來 12 個月相對加權指數的表現:
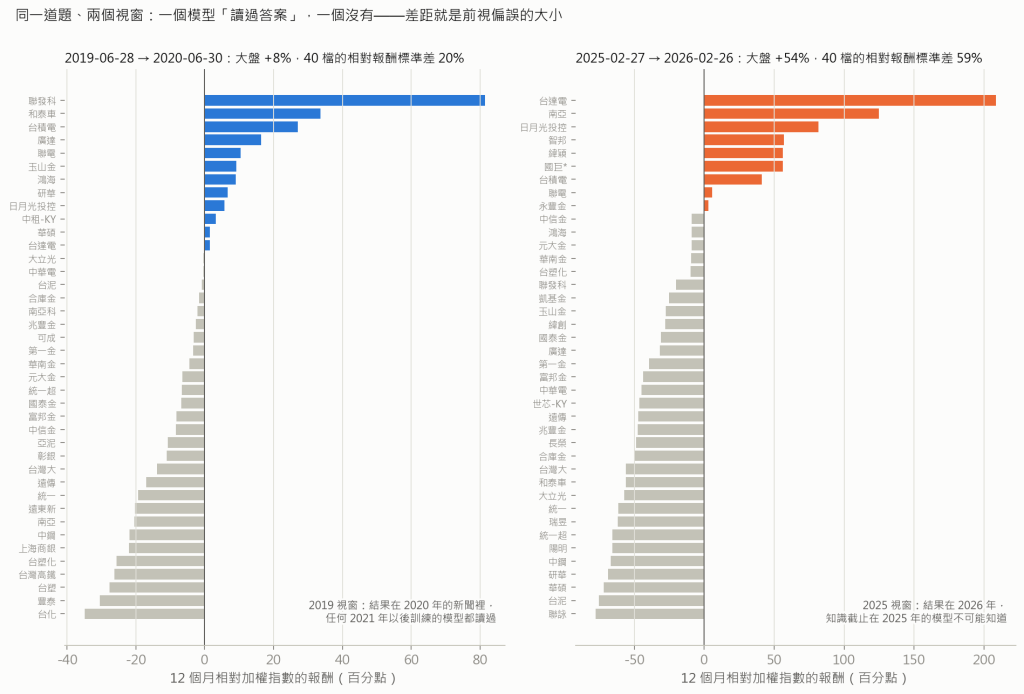
2019-06-28 → 2020-06-30    大盤 +8%    40 檔相對報酬標準差 20%    贏大盤的 12 檔
  最好   聯發科 +81%、和泰車 +34%、台積電 +27%、廣達 +16%、聯電 +10%
  最差   台化 −35%、豐泰 −30%、台塑 −28%、台灣高鐵 −26%、台塑化 −26%
這張表的每一列,都在 2020 年的新聞裡出現過幾百次。你可以在提示詞裡寫「假設今天是 2019 年 6 月 28 日,只用那天以前的資訊」,模型會很配合地用 2019 年的語氣回答。指令改變的是它的措辭,不是它的記憶。
這不只是「問未來股價」的問題。你問它「2019 年 12 月這則武漢肺炎的新聞對航空股是利多還是利空」,它回答「利空」不是分析出來的,是記得後來長榮航跌了多少。所有用歷史文本做的 LLM 特徵,回測期落在模型知識截止之前的部分,全部有這個問題,程度不一而已。
方法是給它一道它讀過答案的題,和一道它不可能讀過答案的題,看差距。
題目一    假設今天是 <日期>,只用那天以前的資訊,判斷這家公司未來 12 個月相對加權指數的表現,1~5 分
題目二    直接問:這家公司從 <起> 到 <迄> 漲跌幾成
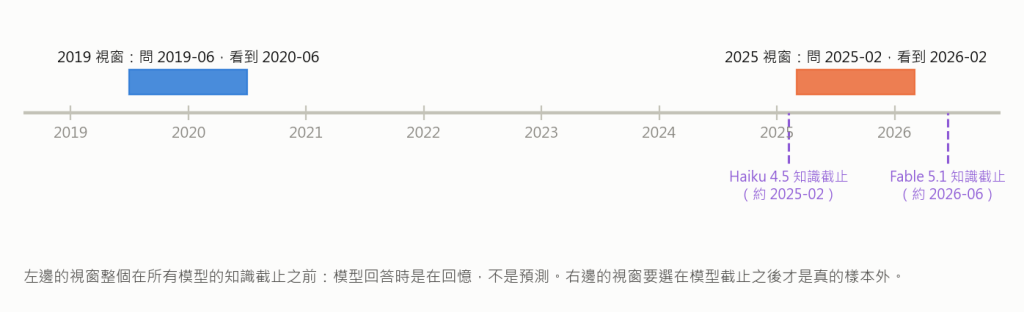
視窗一    2019-06-28 起 12 個月,結果在 2020 年——所有模型都讀過
視窗二    2025-02-27 起 12 個月,結果在 2026 年 2 月——知識截止在 2025 年的模型不可能讀過
母體      各視窗起點市值前 40 的上市公司
評分      模型的答案 對 實際結果 的 Spearman;題目一另看 4~5 分那組對 3 分那組的平均報酬差
視窗二的實際結果:
2025-02-27 → 2026-02-26    大盤 +54%    40 檔相對報酬標準差 59%    贏大盤的 9 檔
  最好   台達電 +208%、南亞 +125%、日月光投控 +82%、智邦 +57%、緯穎 +56%
  最差   聯詠 −78%、台泥 −75%、華碩 −72%、研華 −69%、中鋼 −67%
判讀規則事先定好:視窗一的相關明顯高於視窗二,差的那一截就是它記得的部分;兩邊都接近零,代表它沒記住個股層級的結果;兩邊都高,先查它的知識截止。
模型用 Gemini 2.5 Flash(知識截止 2025 年初,視窗二對它是真的樣本外),溫度 0,160 題,每題快取。
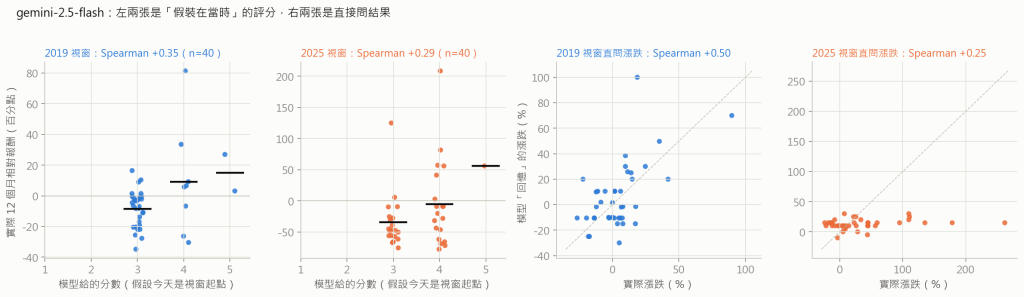
                              視窗一(2019,讀過答案)        視窗二(2025,沒讀過)
題目一 評分 vs 實際           Spearman +0.35 [+0.04, +0.61]    +0.29 [+0.01, +0.55]
  給的分數                    3 分 30 檔、4 分 8 檔、5 分 2 檔  3 分 20、4 分 19、5 分 1
  各分數的平均相對報酬        3 分 −8%、4 分 +9%、5 分 +15%    3 分 −34%、4 分 −5%、5 分 +56%
題目二 直問漲跌 vs 實際       Spearman +0.50 [+0.23, +0.70]    +0.25 [+0.02, +0.45]
  絕對誤差中位                13 個百分點                      28 個百分點
  答案的標準差                26(實際 20)                    8(實際 59)
  答負數的檔數                21(實際 15 檔跌)               2(實際 12 檔跌)
方括號是 40 檔重抽 2,000 次的 90% 區間。
**直問那題把記憶抓了個正著。**2019 視窗它答得像看過:聯發科實際 +90%、它答 +70%;台積電 +35%、答 +50%;台化 −27%、答 −10%;台塑 −19%、答 −10%;台灣高鐵 −18%、答 −25%。40 檔裡 21 檔答負數,實際 15 檔跌,方向和幅度都有。2025 視窗它答得像沒看過:40 檔裡一半答的是 15、20、25 這三個數字,台達電實際 +262% 它答 +15%,南亞 +179% 答 +15%,聯詠 −24% 也答 +15%。答案的標準差 8,實際是 59。一個知道、一個不知道,差距很清楚。
**評分那題的差距卻只有 0.06。**視窗一 +0.35、視窗二 +0.29,兩個區間大幅重疊,低於事先定的 0.2 門檻。記憶明明在,為什麼漏不出來?看它給的分數:兩個視窗合計 80 題,沒有一題給 1 分或 2 分。它記得台化跌了三成,評分還是給 3;記得台灣高鐵跌兩成,給 4。「假設今天是 2019 年」的指令讓它把所有答案壓進 3 和 4,只在它特別有印象的贏家(台積電 5 分、聯發科 4 分)露出一點。記憶漏出來的形式是「不敢給低分」,而不是「給對分數」。
**視窗二的 +0.29 是另一回事。**它給 4 到 5 分的 20 檔裡有台達電、日月光投控、智邦、緯穎這些之後真的大漲的 AI 硬體,也有四家金控、統一超、廣達,還有之後跌了一到兩成的聯詠、華碩、研華。給 3 分的 20 檔多是傳產和另外幾家金控,那一年整批跑輸台積電行情。這不是記憶,是 2025 年初「電子給 4、傳產給 3」的偏好剛好押中一半,40 檔的區間寬到 +0.01 到 +0.55,不能當成它有預測力。
三件事從這裡出來。第一,記憶存在,直問就抓得到,之後每個模型進場前都要問這一題。第二,評分格式會把記憶壓扁,這是好事也是壞事——好在它漏得少,壞在你看評分的相關差以為沒事,其實是格式擋住了,換成「這則新聞利多利空」的格式會不會擋住,不知道。第三,40 檔的樣本只能看方向,正式的門要用 200 檔以上。
知道問題之後,能用的評估期只剩三種。
**知識截止之後的期間。**模型截止 2025 年初,就只能用 2025 年之後的資料驗證它的特徵,到今天一年半。樣本少,但乾淨。Day 26 的增量測試會用這段。
**去識別化的輸入。**把公司名、代號、日期全部抹掉,只給模型文本本身:「本公司本月營收較去年同期成長 35%,主因新產品出貨」。它認不出這是誰、哪一年,就沒有辦法回憶。代價是模型也用不上它對這家公司的背景知識——而那些背景知識本來就是回憶的一部分,拿掉是對的。
**跨期一致性。**同一個特徵,在截止之前的期間和之後的期間,IC 要在同一個量級。截止前 0.10、截止後 0.02,就是前視在撐前面那段。
第五幕的規矩:
1. LLM 特徵只在模型知識截止之後的期間評分;截止之前的期間只看方向,不算成績
2. 輸入去識別化:新聞和財報文字去掉公司名、代號、日期,再給模型
3. 每一次呼叫快取,鍵是提示詞的雜湊;回測要能離線重跑(Day 24)
4. 每個模型進場前跑探針,兩題都跑:直問那題視窗一的 Spearman 高於視窗二 0.2 以上,就當它記得——
   它對截止前文本的標註只能用去識別化的輸入;評分那題的差距小不代表沒記憶
5. 過了探針的特徵,用 Day 15 的尺量增量:沒有增量就寫沒有增量(Day 26)
**LLM 有三種角色,這個系列只用一種。**文字變數字的特徵萃取器;研究助理是工具;決策者不碰。
**它讀過答案。**Gemini 2.5 Flash 直問 2019 到 2020 的漲跌,Spearman +0.50、誤差中位 13 個百分點,聯發科答 +70%、台化答 −10%;問 2025 到 2026,一半的答案是 15、20、25 這三個數字,Spearman +0.25、誤差 28 個百分點。
評分格式把記憶壓扁。「假設今天是 2019 年」的評分,兩個視窗的相關只差 0.06,因為它 80 題沒給過 1 分或 2 分。差距小不是沒記憶,是格式擋住了。
**真正的樣本外只有三種。**截止之後的期間、去識別化的輸入、跨期一致的 IC。探針兩題都要跑,直問那題才是抓記憶的。


 iThome鐵人賽
 看影片追技術