
昨天自己接管了一次 backend,整條 torch.compile 流水線算是摸過一遍。不過有一個前提我們從來沒有挑戰過,所有事情都發生在 Python process 裡。Dynamo 掛在直譯器上攔 frame,guard 每次呼叫都驗一輪。但部署現場常常不長這樣,線上服務可能是一台 C++ server,手機和車機上根本沒有直譯器。就算有,你也未必想把整套 JIT 機器搬進生產環境。今天來看 PyTorch 為這種場景鋪的另一條路,torch.export 加上 AOTInductor,把模型先編好、打包成一個 .pt2 檔,到了現場不需要 Python 也能跑。
今天的比喻是廚師與便當。torch.compile 像帶著廚師隨行,到現場看食材臨場開火,菜色隨時能調整,但整套廚房都得跟著走。export 加 AOTInductor 則是出發前把菜封進便當盒,現場打開就能吃,代價是菜單得先定案。
正文開始!
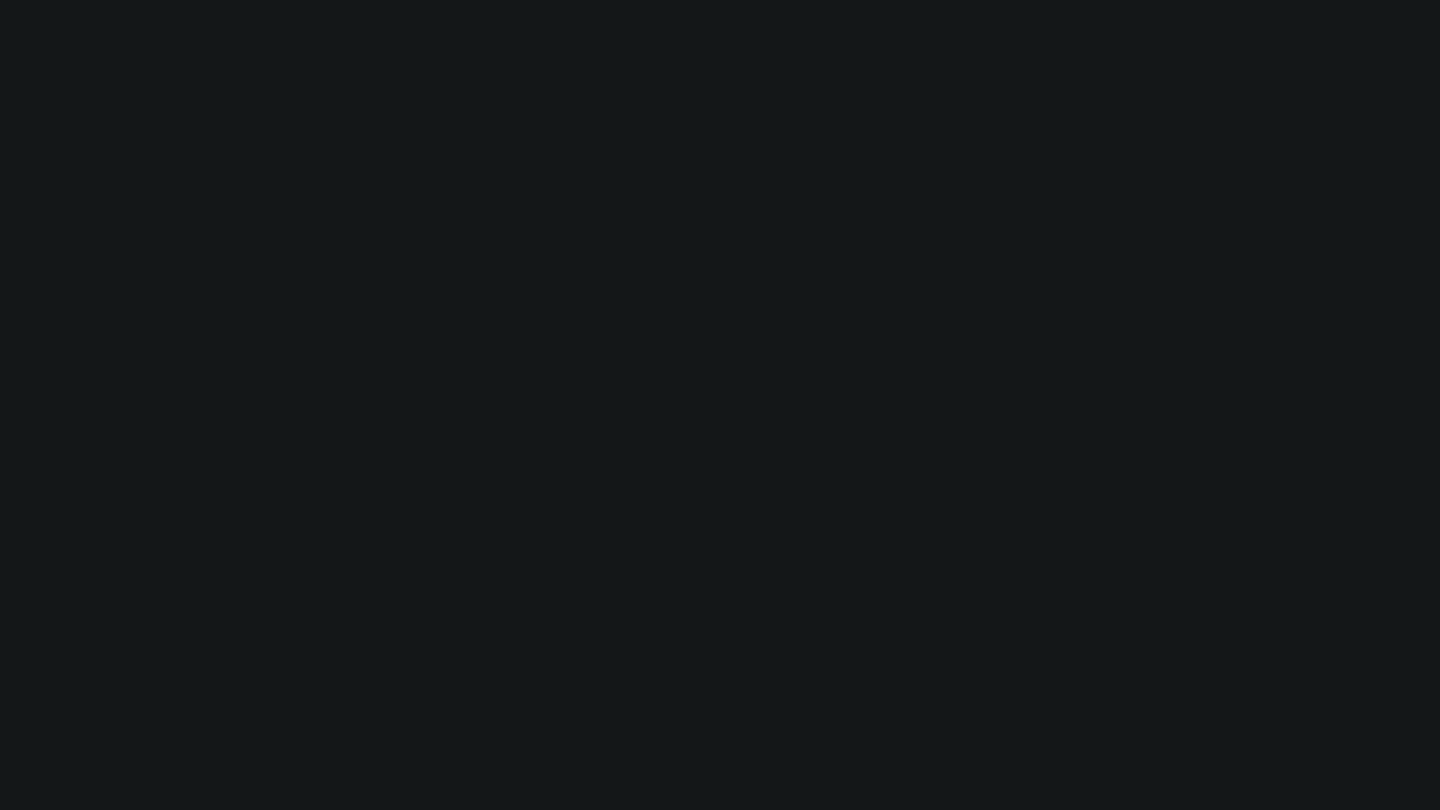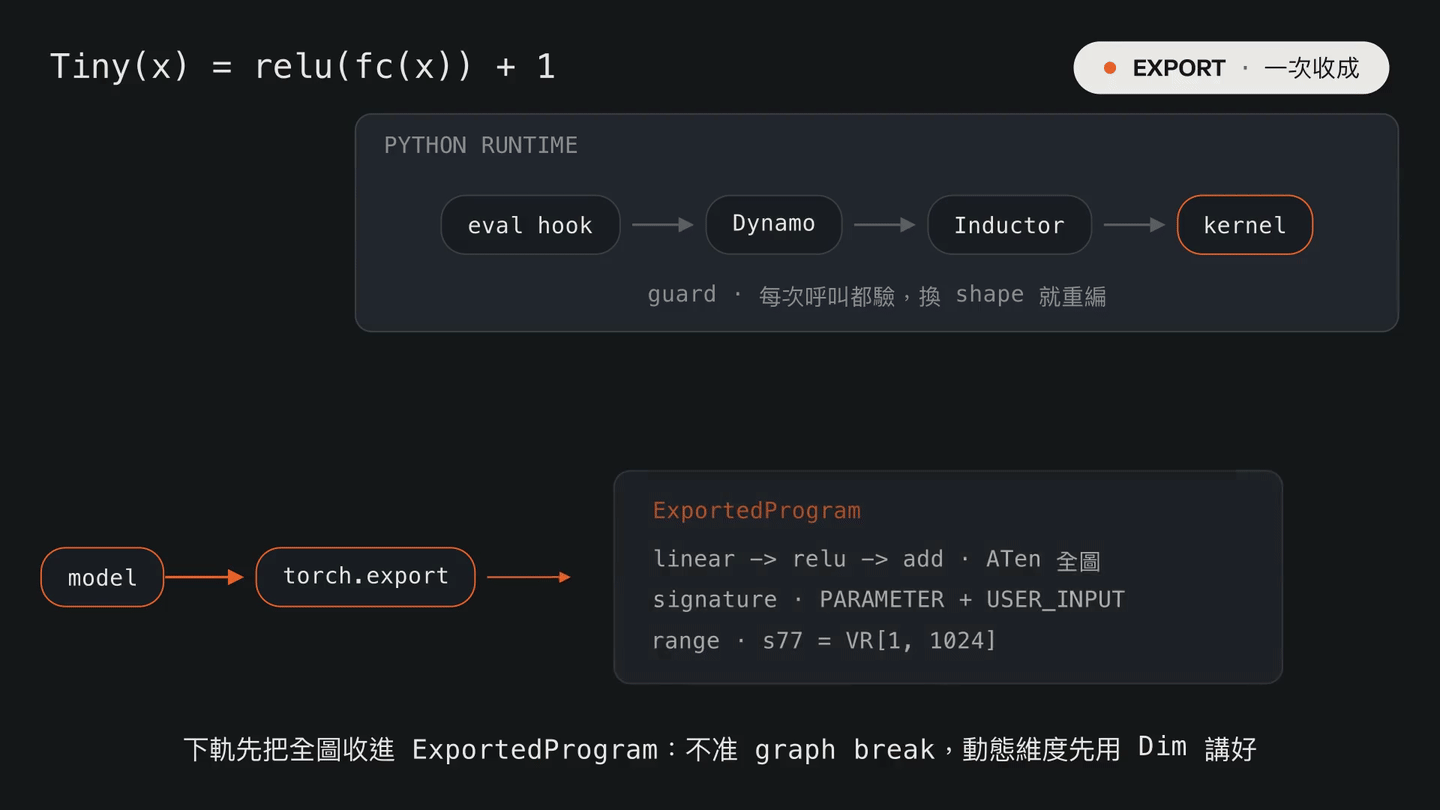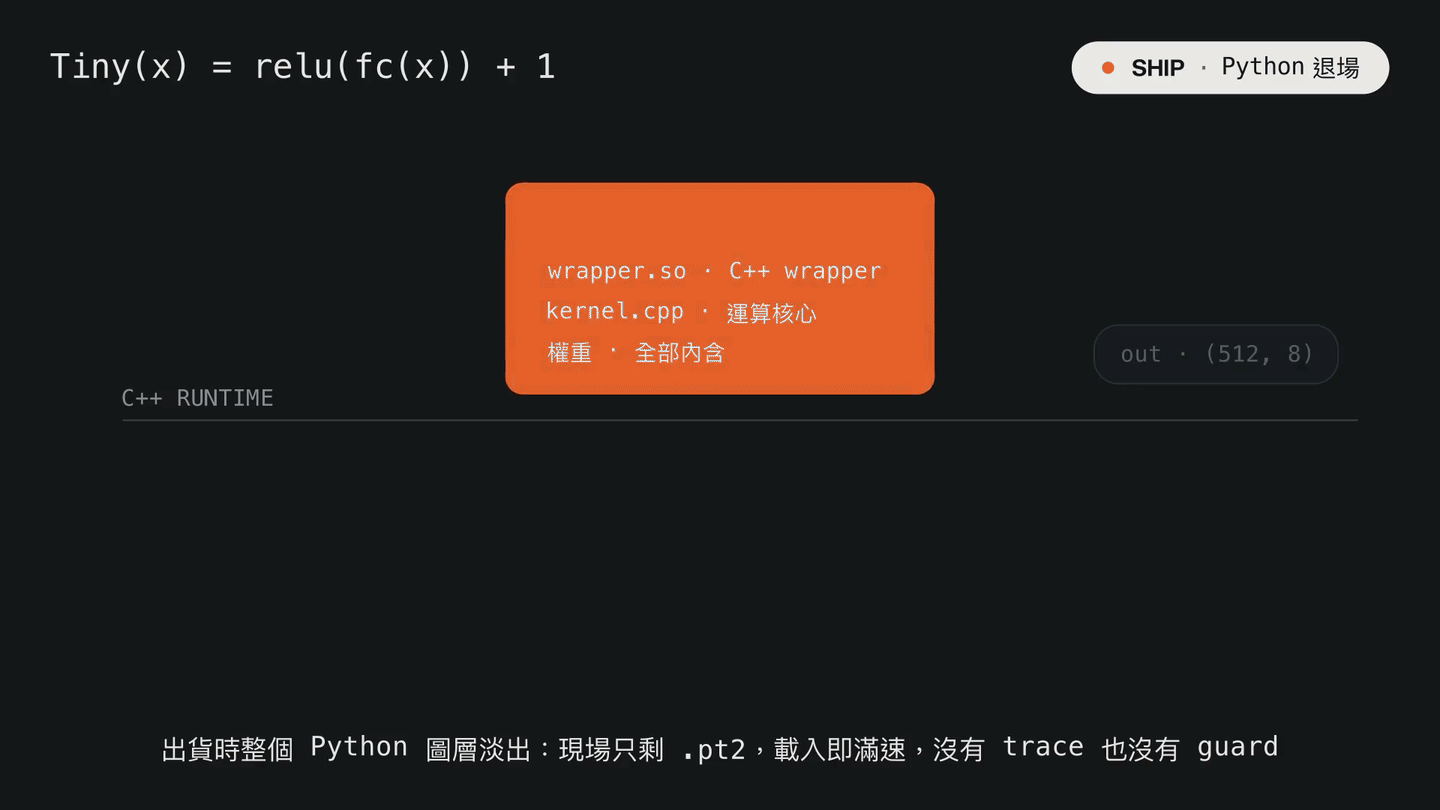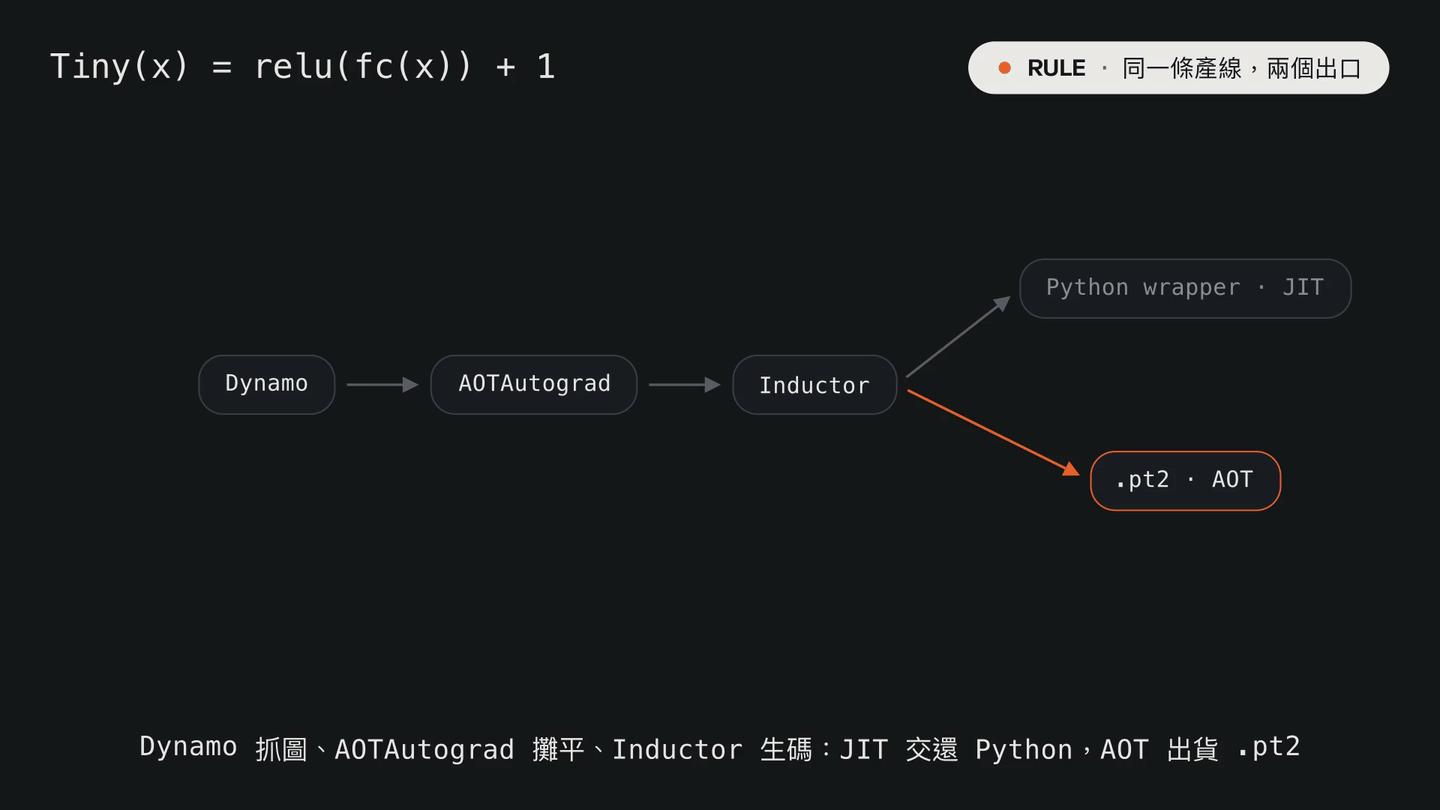
兩條路走的是同一條流水線,分開它們的只有一個問題,編譯發生在什麼時候。
這不是另一套編譯器。export 底下抓圖的是同一個 Dynamo,AOTInductor 就是 Inductor,講過的 lowering、fusion、codegen 一路照走。
真正變的是付錢的時間點。JIT 把編譯成本攤在執行期,第一次呼叫慢,之後每次呼叫還要付一小筆 guard 的手續費,換到的是遇到什麼都能應變。AOT 把成本搬到出貨之前,現場每一次呼叫都直達 kernel,代價是所有的萬一都必須在匯出時想清楚。
兩條路最本質的差別在對 graph break 的態度。torch.compile 把 graph break 當日常,把函式切成幾段照樣跑。但 export 的產物要在沒有直譯器的地方執行,斷掉的部分沒有人接手,所以它承諾交出的是一張完整的圖,做不到就直接報錯。拿一個資料相依的分支實測,以下實驗都在本機 CPU 上跑(torch 2.8.0),完整程式在 code/day29/。
class Branchy(torch.nn.Module):
    def forward(self, x):
        if x.sum() > 0:
            return x + 1
        return x - 1
torch.compile 的反應是切開來繼續跑。
[torch.compile on data-dependent branch]
  graph_count=2 graph_break_count=1
  break reason: generic_jump TensorVariable()
同一個 module 丟給 export,得到的是一個錯誤。
[torch.export on the same module]
  GuardOnDataDependentSymNode: Could not guard on data-dependent expression Eq(u0, 1)
分支條件取決於張量的值,圖沒辦法在編譯期決定走哪一邊。compile 選擇切成兩段,export 把問題丟回給你,要嘛改寫成 torch.where 這類留在圖裡的寫法,要嘛用控制流 op 把兩個分支都收進圖裡。
動態 shape 也一樣。export 沒有 recompile 的機會,所以哪個維度會變、範圍多大,都得在匯出時用 Dim 宣告清楚。這份宣告是一紙雙向的合約。編譯器拿到範圍,就把這個維度當符號處理,生成一份通吃整段範圍的程式碼。使用者這邊則是自我約束,執行期餵進超出範圍的輸入會被直接拒絕,而不是默默算錯。同一套 symbolic shape 機制,在 compile 那邊是事後升格,在這裡是事前簽字。
export 的產物叫 ExportedProgram,是一份可以脫離原始 Python 程式碼獨立存在的模型描述。拿一個小模型匯出,把 batch 維度宣告成動態。
batch = Dim("batch", min=1, max=1024)
ep = export(m, (x,), dynamic_shapes={"x": {0: batch}})
印出來的內容節錄如下。
ExportedProgram:
    class GraphModule(torch.nn.Module):
        def forward(self, p_fc_weight: "f32[8, 16]", p_fc_bias: "f32[8]", x: "f32[s77, 16]"):
            linear: "f32[s77, 8]" = torch.ops.aten.linear.default(x, p_fc_weight, p_fc_bias);  x = p_fc_weight = p_fc_bias = None
            relu: "f32[s77, 8]" = torch.ops.aten.relu.default(linear);  linear = None
            add: "f32[s77, 8]" = torch.ops.aten.add.Tensor(relu, 1);  relu = None
            return (add,)

Graph signature:
    # inputs
    p_fc_weight: PARAMETER target='fc.weight'
    p_fc_bias: PARAMETER target='fc.bias'
    x: USER_INPUT

    # outputs
    add: USER_OUTPUT

Range constraints: {s77: VR[1, 1024]}
一份 ExportedProgram 由三個部分組成,少任何一個,別人都沒辦法把這個模型跑起來。
fc.weight 和 fc.bias 被抬升成圖的輸入,整張圖成為一個沒有隱藏狀態的純函數。上面那段 range constraints 則是動態合約的具體長相,宣告的 batch 在圖裡以符號現身,範圍 1 到 1024 直接寫死在裡面。
這張圖還是 functionalize 過的,沒有 in-place 帶來的 side effect 要收拾,後面接手的編譯器和驗證工具都好做事。ExportedProgram 也可以序列化,也就是整份存成檔案,在另一台機器讀回來再編。匯出和編譯因此能拆成出貨流程裡的兩站,不必擠在同一個環境完成。
圖一:同一個模型的兩條出路。上軌 torch.compile 常駐 Python runtime,每次呼叫都經過 guard,遇到新狀況當場 recompile。下軌 export 把全圖收成 ExportedProgram,AOTInductor 鑄成一顆 .pt2,Python 圖層淡出,便當獨自在 C++ runtime 上開飯。
有了 ExportedProgram,AOTInductor 接手把它變成成品。
torch._inductor.aoti_compile_and_package(ep, package_path="tiny.pt2")
.pt2 其實是一個 zip,打開看看。
[pt2 package contents]
  tiny/data/aotinductor/model/cq5wuv454krsolah7rcae76pgdsnriveltbeyf4wsndgpgt76clw.wrapper.cpp  (27 KB)
  tiny/data/aotinductor/model/cocidwwsfww37pg7yy5b7f3fo4oy2lgne33ab6he52mejkbfc74o.kernel.cpp  (8 KB)
  tiny/data/aotinductor/model/cq5wuv454krsolah7rcae76pgdsnriveltbeyf4wsndgpgt76clw.wrapper.so  (229 KB)
  tiny/archive_format  (0 KB)
主角是那顆編好的 .so,旁邊躺著它的原始碼。kernel.cpp 是 Inductor 生出來的運算 kernel,跟講 C++ codegen 時看過的同一批貨。真正的新東西是 wrapper.cpp。負責配 buffer、按順序呼叫 kernel 的那一層,在 torch.compile 裡是一段 Python 程式碼,AOTInductor 把它也翻成了 C++,順便把權重打包進檔案,動態 shape 的推導和範圍檢查也一起編進機器碼。原本 runtime 裡屬於 Python 的最後一份工作,就這樣被編譯期整個吃掉了。
載回來驗收。
[load and run]
  allclose(aoti, eager) = True
  batch=512 output shape = (512, 8)
  dynamo frames traced while running .pt2 = 0
  dynamo frames traced after one torch.compile call = 2
輸出跟 eager 完全一致。匯出時用的是 batch 4,餵 512 也照樣跑,動態維度的合約有效。最後兩行是今天最重要的證據,執行 .pt2 的整個過程 Dynamo 一個 frame 都沒有 trace,對照組 torch.compile 呼叫一次就 trace 了 2 個。在 Python 裡載入只是方便驗證,同一顆 .so 用 libtorch 的 C++ 介面一樣能載。一個 .pt2 就是一份完整的交付物,wrapper、kernel、權重全在裡面。
選哪條路,看的是執行現場長什麼樣子。
折衷的場景也存在。有 Python 的推論服務可以先把模型用 AOTInductor 編好,Python 端只負責載入呼叫,換一批機器也不必再付 recompile 的帳。
今天把部署這條路走完。torch.export 用全圖承諾換掉 graph break 的彈性,動態維度用 Dim 寫進合約,產物 ExportedProgram 是一張參數外露、簽名齊全的 ATen 純函數圖。AOTInductor 把它連 wrapper 一起編成 C++,打包成一顆自足的 .pt2,執行時 Dynamo 零參與。Dynamo 抓圖、AOTAutograd 攤平、Inductor 生碼,兩條路每一站都共用,變的只是圖從哪裡進來、成品往哪裡去。
明天是最後一天,把三十天的路重新走一遍,從 bytecode 攔截到 kernel 出爐,把整個 torch.compile 的地圖攤開來總整理。那我們明天見!


 iThome鐵人賽
 看影片追技術