
昨天把快取講完,編譯的帳結清了,同一張圖第二次遇到直接撿現成的,Part 3 走完。今天起進入 Part 4,視角從「怎麼把 kernel 編快」換成「這套東西在真實場景怎麼用、會出什麼事」,第一站是執行期的另一種 overhead。kernel 編好也快取好了,每一步還是得由 CPU 一顆一顆丟上 GPU,這個發射動作本身有固定成本,模型裡小 kernel 一多,GPU 反而大部分時間在等 CPU。今天的主角 CUDA Graph 就是來收這筆帳的,torch.compile 把它包裝成 mode="reduce-overhead"。
正文開始!
GPU 不會自己動。每一顆 kernel 都要 CPU 透過 CUDA API 發射,填參數、排上 stream、通知 driver,這一串在 CPU 端要花幾個 us,跟 kernel 多大無關,是每次發射固定要付的門票。kernel 夠大時這筆錢無所謂,一顆大 matmul 跑幾百 us,前面幾 us 早被蓋過去。麻煩的是另一種體質的模型,一長串小 kernel 每顆只跑幾 us,發射時間跟執行時間同一個量級甚至更長。這時 GPU 軌道上 kernel 之間全是空隙,算完一顆就停下來等 CPU,硬體大半時間在發呆。
平常感覺不到,是因為 CUDA 執行本來就是非同步的。CPU 把 kernel 丟進 stream 佇列就繼續往前跑,只要 kernel 夠肥,CPU 發射的速度永遠追得上 GPU 消化的速度,佇列裡隨時有存貨。小 kernel 把這個緩衝打破了。GPU 幾 us 就清空一顆,CPU 卻要走完一整套流程才發得出下一顆,存貨見底,換 GPU 排隊等 CPU。
這筆 overhead 不歸編譯管。講 fusion 時說過,matmul 這種 op 融不動,32 層的 MLP 編完還是幾十顆 kernel,每一步照樣幾十次發射。編譯讓每顆 kernel 變快,發射次數並沒有變。
實驗跑在 L40S 上(torch 2.8.0),模型故意挑 launch-bound 的體質,32 層 Linear(256, 256) 接 ReLU,batch 只有 8,每顆 kernel 都超小。eager、預設 compile、reduce-overhead 各 bench 一輪,計時用 CUDA event 取平均,完整程式在 code/day25/。
eager            1.124 ms (+/- 0.008)
compile default  0.960 ms (+/- 0.019)
reduce-overhead  0.119 ms (+/- 0.003)
default vs eager          1.17x
reduce-overhead vs eager  9.45x
預設模式只快 1.17 倍,因為融不掉的部分還在,一步還是六十幾次發射。換成 reduce-overhead,同一個模型直接 9.45 倍,而它生成的 kernel 跟預設模式是同一批,差距全部來自發射方式。再把 batch 放大到 8192 當對照組。
eager            2.228 ms (+/- 0.002)
compile default  1.585 ms (+/- 0.003)
reduce-overhead  1.567 ms (+/- 0.004)
reduce-overhead vs default 1.01x
kernel 一大,執行時間把 overhead 整個淹掉,reduce-overhead 跟預設模式只差 1.01 倍。同一招在兩種 batch 下賺頭差了快十倍,是今天最重要的一組對照。
reduce-overhead 底下是 CUDA 原生的 CUDA Graph,他的邏輯其實就有點像錄影。capture 是開錄,先正常發射一遍,把期間每次發射的參數、順序、依賴側錄成一張 graph。replay 是重播,之後跑同樣的序列時 CPU 只按一次,driver 把整張圖原樣放一遍,幾十次發射收成一次。PyTorch 把它包成 torch.cuda.CUDAGraph,手動玩一次長這樣。開錄前要先跑幾輪 warmup,讓初始化和記憶體配置這些只做一次的動作先完成,免得被錄進圖裡。
g = torch.cuda.CUDAGraph()
with torch.cuda.graph(g):
    static_y = model(static_x)

static_x.copy_(new_x)
g.replay()
replay 後拿 static_y 跟 eager 對答案,順便量 32 層共 64 次發射跟一次 replay 的差距。
replay result matches eager: True
eager 64 launches  1.116 ms
graph replay       0.113 ms
replay vs eager    9.90x
答案一致,速度跟 reduce-overhead 量到的幾乎一樣,證明那 9.45 倍就是錄影機的功勞。代價也寫在這段程式裡。
copy_ 進 static_x 才能 replay。.item() 這種要同步回 CPU 的操作會讓 capture 直接失敗,因為 replay 只重播 GPU 端指令,CPU 端邏輯不會跟著重來。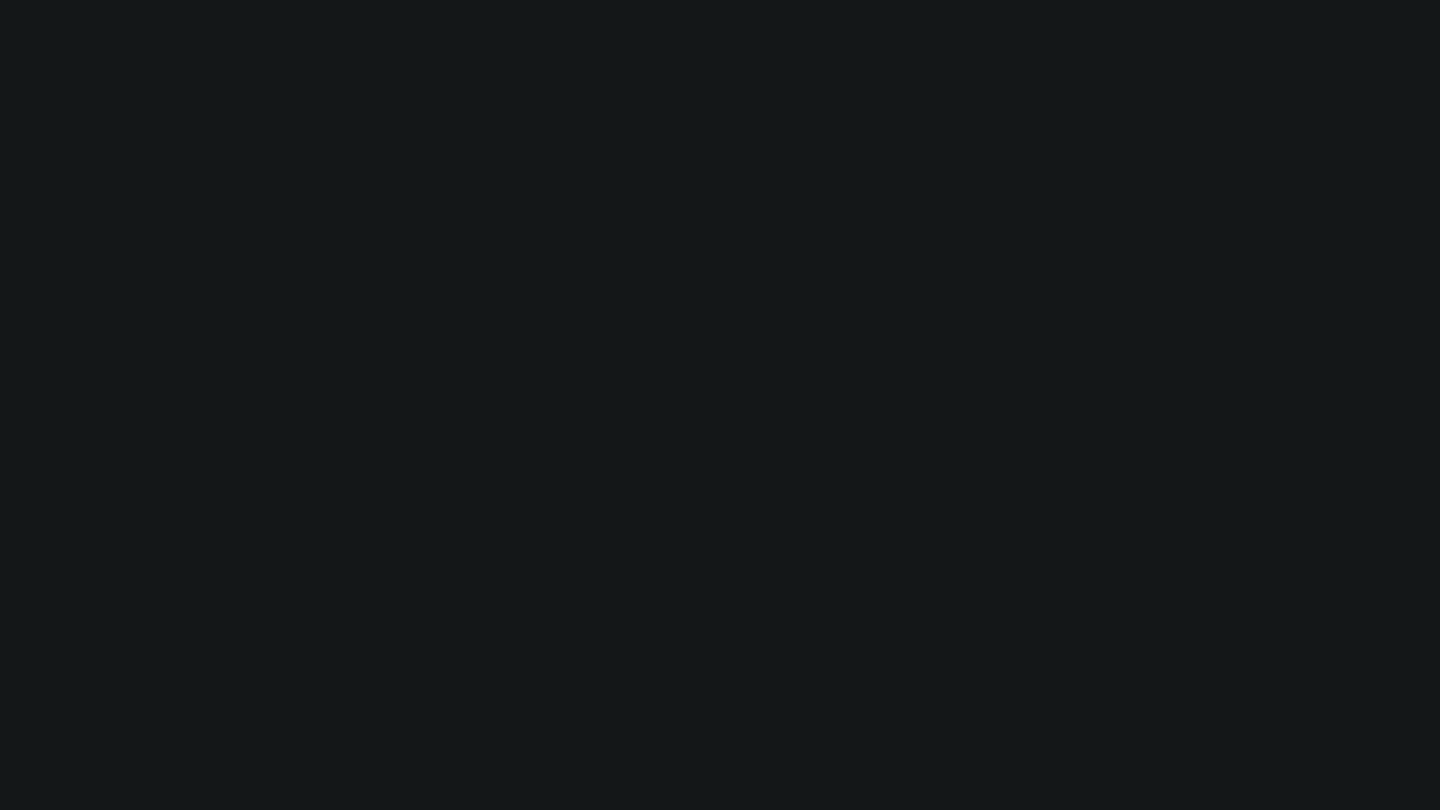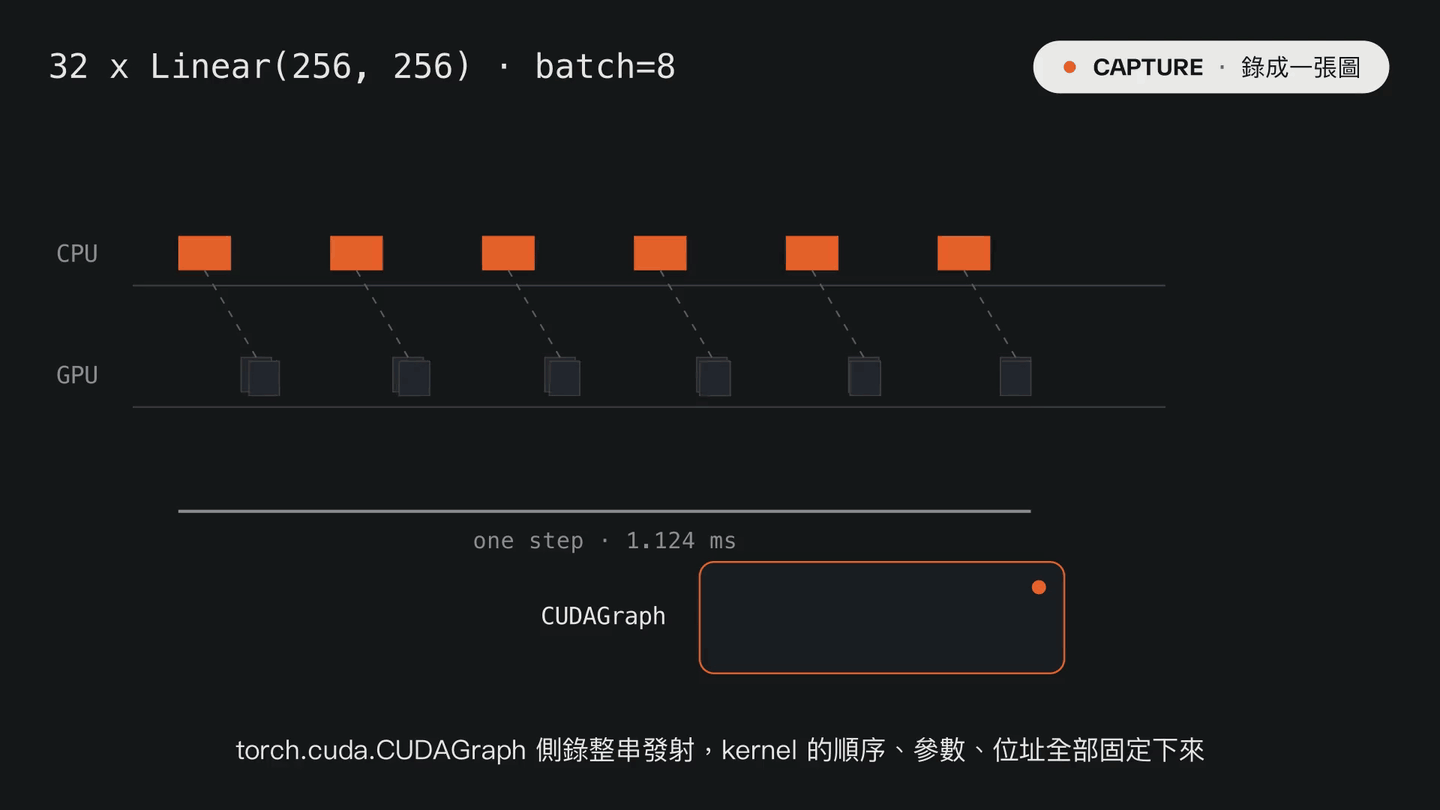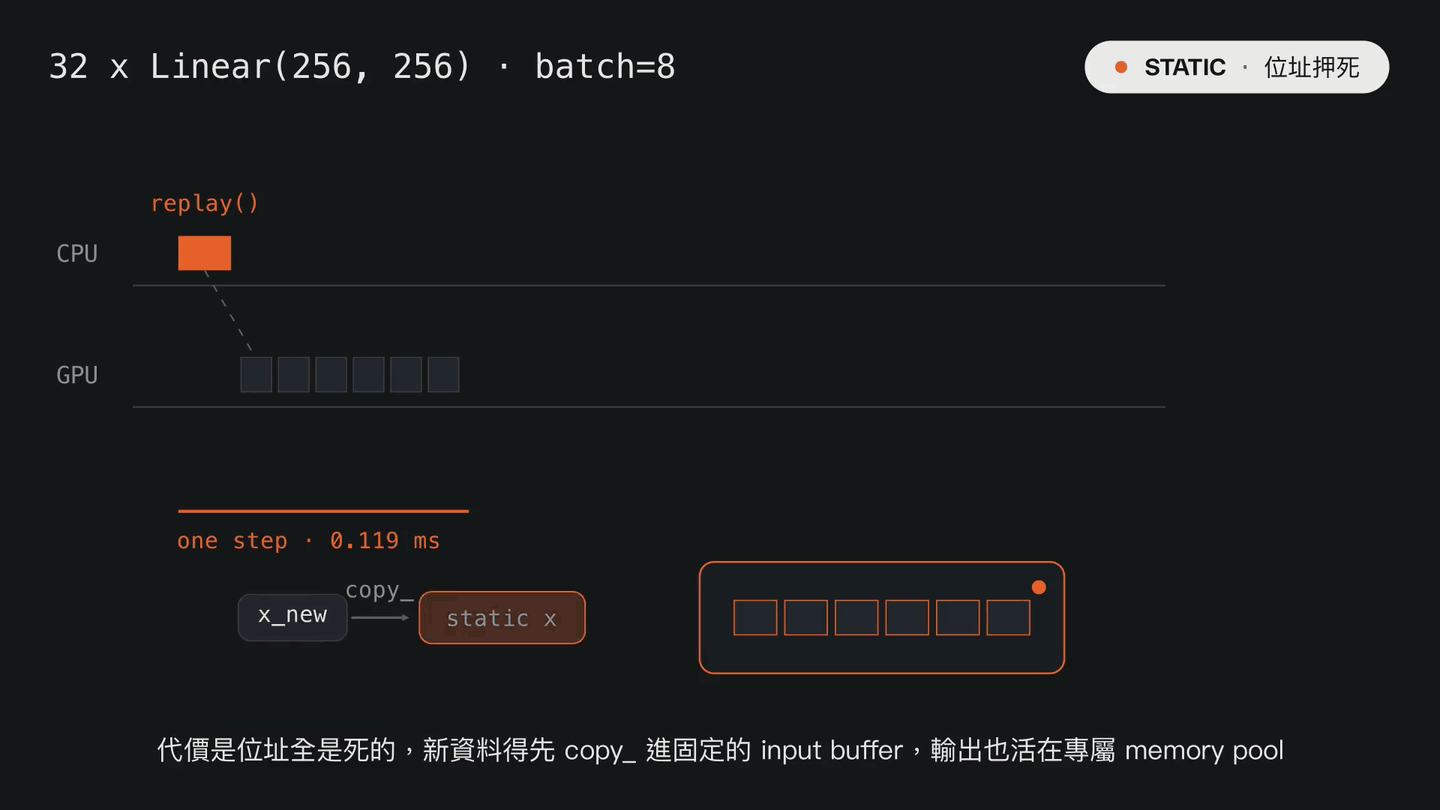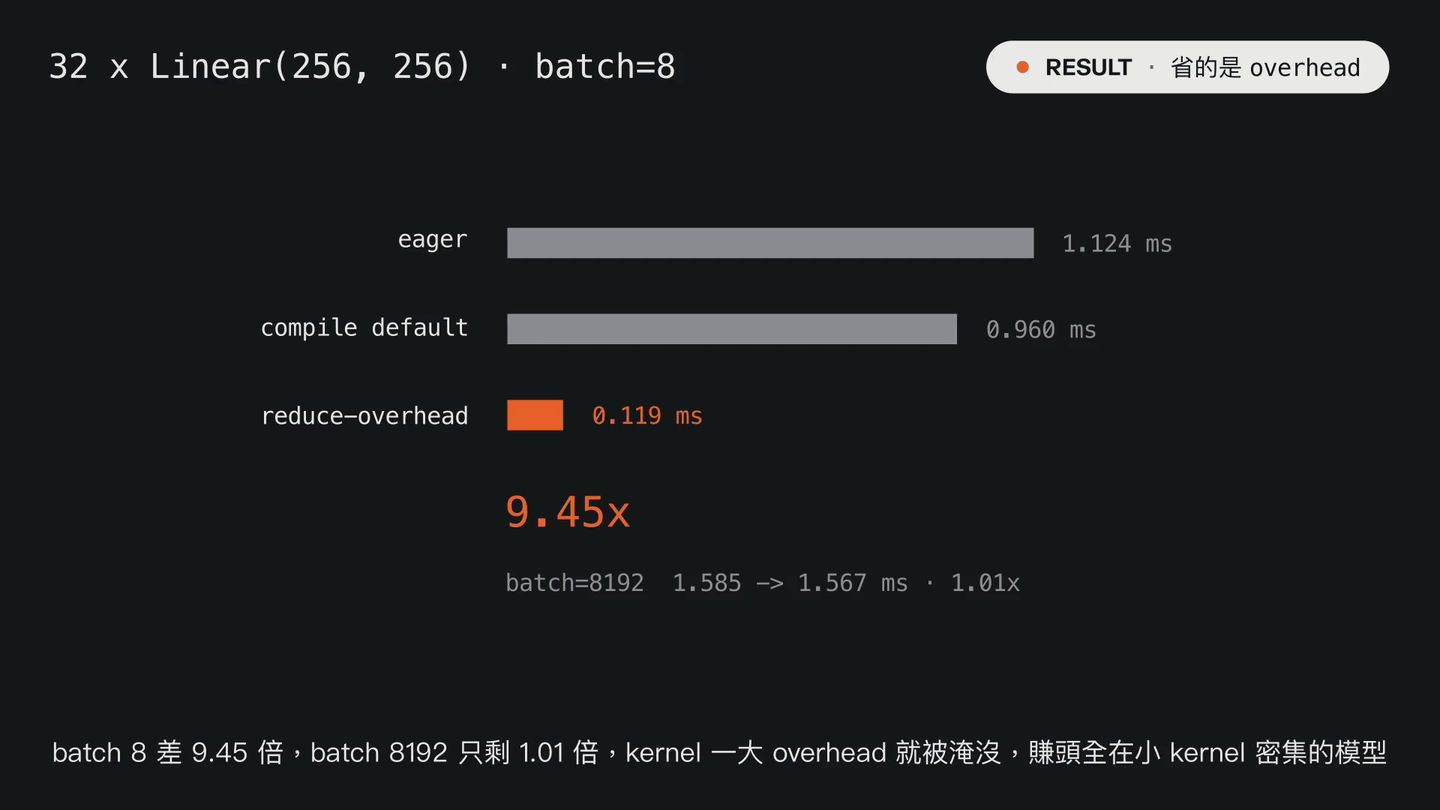
圖一:launch overhead 的收帳過程。eager 下 CPU 每發射一顆 kernel 都付一段橘色成本,GPU 軌道上小 kernel 之間全是 idle。CUDAGraph 把整串發射側錄成一張圖,之後 CPU 只按一次 replay,kernel 緊緊相連,單步時間從 1.124 ms 掉到 0.119 ms。
手動這樣玩只顧得了一張圖,真實模型沒這麼單純。graph break 會把模型切成好幾段,forward 和 backward 又是分開的兩張,每張各開一個 memory pool 的話,中間結果得在 pool 之間搬來搬去,記憶體也各算各的。reduce-overhead 的做法是讓所有 graph 共用同一個 pool,並把可能的執行路徑組織成一棵樹,走到哪條就重播哪條,記憶體按樹上最長的一條算,而不是每張圖加總。
它也把雜事一起做掉了。每個函式先用真發射跑 warmup,等位址和記憶體穩定才開錄。開錄前會確認不會蓋掉前一張 graph 還活著的輸出,踩到就換個位置重錄,重錄次數超過上限就乾脆放棄錄影,退回逐顆發射。這也解釋了 reduce-overhead 前幾次呼叫特別慢,不只是在編譯,還有錄影機在架設。
剛剛那三條要求,Inductor 替你扛了大半。輸入會自動複製進 static buffer,參數本來就長住固定位址。但有一條逃不掉,輸出活在 graph 的 memory pool 裡,下一次 replay 會原地覆寫上一次的結果。抓著上一輪的輸出不放再呼叫一次,兩個 tensor 位址一模一樣。
hold output alive, call again: ptr 22480592830464 -> 22480592830464, same: True
想留住結果就得自己 clone,這是 reduce-overhead 最容易踩到的雷。另一種情況是函式根本上不了車,例如會 mutate 輸入的圖,replay 每次都原樣重做那個 mutation,語意就對不上了,Inductor 會直接跳過並留話。
[__perf_hints] skipping cudagraphs due to mutated inputs (1 instances). Found from :
   File "/root/cudagraph.py", line 90, in mutate
    x.add_(1)
同一個檢查也擋掉 CPU tensor 混在圖裡的情況。剩下的限制可以一次列完。
所以開發階段先用預設模式把模型跑對,最後再換 reduce-overhead 收 overhead,比較省事。
賺不賺只看一件事,GPU 到底有沒有在等 CPU。
判斷也簡單,profiler 裡 GPU 時間軸上的空隙就是可以收的帳,空隙不多就別開。
執行期的這筆帳今天收完了。launch overhead 是 CPU 每次發射 kernel 的固定成本,編譯管不到,CUDA Graph 用 capture 和 replay 把幾十次發射收成一次,reduce-overhead 把錄影、共用 memory pool、跨 graph break 這些髒活自動化,代價是位址押死、輸出會被覆寫、shape 要穩定、記憶體多吃一些。batch 8 的 9.45 倍和 batch 8192 的 1.01 倍放在一起就是完整說明書,收的是 overhead 的帳,模型本身算得越重,這筆帳越不值得收。
不過「shape 要穩定」這句埋了雷。怕 shape 變來變去的不只 CUDA Graph,整個 torch.compile 都怕。明天就來看 recompilation 爆炸這個最常見的事故,怎麼發生、怎麼診斷、怎麼修。那我們明天見!


 iThome鐵人賽
 看影片追技術