
一次 Agent 工作順利完成,背後可能已經向模型服務送了兩次請求。第一次遇到錯誤,第二次改用備援模型,使用者最後只看見一份回答。等你打開成本面板,請求數、Token 數和金額卻未必涵蓋同一批處理。
這會影響很實際的判斷:團隊最近變貴,是使用量增加,還是重試變多?Backup 模型是否真的比較省?面板沒有顯示失敗請求的成本,能不能當成它免費?如果不先知道數字從哪裡來,很容易在一個看起來精確的總額上做出錯誤決策。
我在 agentgateway 1.5.0 的實測中,看到官方 Analytics 顯示兩次 Calls、十個 Tokens 和 USD 0.000066。數字來自真實 Gateway 處理,但 Provider 是本機固定回應的示範服務。本篇先解釋一次工作、多次請求與成本證據的關係,再回到這張畫面,看它能支持哪些判斷。
使用者請 Agent 完成一項工作,在本文稱為 Action。Runtime 或 Client 為了完成它,向 Provider 送出一次網路請求,則稱為 Attempt。兩者是一對多的關係:第一次成功時只有一個 Attempt,遇到重試或備援時就會增加。
例如使用者要求整理一段資料,Primary Provider 回 503,Client 重送後由 Backup 完成。從工作結果看,Action 成功了。從 Provider 請求看,則是一次失敗、一次成功。若用「成功請求比例」代替「工作完成比例」,就會得到不同的服務品質解讀。
成本也需要保留這兩個粒度。只記最後一次成功回應,會失去前面送過哪些請求的資料。較好的方式是每次 Attempt 保存 Provider、時間、狀態與 Usage 證據,再用 action_id 對回原本的工作。這樣異常時才有辦法分辨是工作量增加,還是同一批工作需要更多次嘗試。
Attempt 也需要自己的識別或關聯資訊。網路 Trace 可以協助查回一次請求,但不要假設所有 Retry 設計都一律使用不同 Trace ID。具體如何識別每次嘗試,應由 Runtime 和 Gateway 的紀錄契約決定。本次示範會保存兩次 HTTP 請求各自的 Trace 與 Provider 資料。
Provider Response 的 Usage 是一份用量收據,例如回報 Input 和 Output Token 數。Gateway 拿到 Usage 後,再乘上模型價格表,就能算出即時估算。這對看趨勢、設預算和找異常很有用,但供應商月底的結算還可能包含合約價、折抵和其他計費規則。
agentgateway Model Costs 文件 說明了價格目錄與用量估算的關係。資料來源可以分成三層,調查時應先確認自己拿到哪一層:
| 資料 | 直接回答的問題 | 還需要另外確認的內容 |
|---|---|---|
| Response Usage | 這次回應回報多少 Token? | 失敗請求是否有完整用量 |
| Gateway 價格目錄 | 這份用量依所選費率估算多少? | 價格版本、未定價模型、合約差異 |
| Provider 帳務資料 | 供應商最後結算多少? | 如何對回團隊、帳戶與工作 |
如果失敗回應沒有 Usage,Gateway 就缺少估算的輸入。Access Log 或 Metric 可能因此出現零值,但調查者應記成用量未知。只有取得零用量的證據時,才能寫成零,不能把「沒有取得用量」直接換成零。正式對帳還要看 Provider 的 Billing Export 或 Invoice。
我在自己的 Grafana Claude Code Stats App 也做過這個取捨。畫面使用 Estimated API-equivalent Cost,表示依模型 API 費率換算的估值,價格表放進 Source Control。沒有對應費率的模型另列 Unpriced Model Tokens,不拿相近型號的價格代替。命名和缺失資料的呈現,會直接影響讀者是否把面板誤讀成帳單。
Runtime 可以使用一個 Virtual Model 名稱,讓 Gateway 決定要送到哪個 Provider。這對應用很方便:應用只選一個服務意圖,路由和備援留在入口管理。但看成本時,還要知道實際由誰服務。
本篇 Client 一律要求 day24-resilient-agent。Primary 成功時回報的模型是 day24-primary,Backup 成功則是 day24-backup。Requested Model 保留原本的選擇,Served Model 才說明最後採用的模型。兩者和 Provider 一起保存,才能查出同一個入口是否逐漸轉向較昂貴的備援。
日常指標可以按團隊、Route、Provider、Served Model 和結果聚合。個別 Action ID、Trace ID 或 Provider Request ID 則留在事件與 Trace,調查時再展開。這延續前篇的資料分工,成本分析也需要控制分組數量。
agentgateway LLM Analytics 將 LLM Requests 存入資料庫,利用回應用量與模型目錄顯示請求、Tokens 和估算成本。官方已經提供畫面,因此可以先用它確認 Provider 和 Model 的使用情況,再補自己需要的跨服務關聯。
它的資料仍來自 Gateway 看見的流量。若某份失敗回應沒有用量,畫面不會因為能顯示總額就取得供應商的結算證據。做 Dashboard 時,我會把已知用量、估算金額和缺失資料一起呈現,讓使用者知道目前的數字涵蓋哪些請求。
另外還有 官方 Grafana Dashboard,適合看 Gateway 的流量、延遲和原生 LLM 觀測資料。該版本上游資產主要使用 Kubernetes 的 Namespace、Gateway、Pod 等 Labels。本篇是 Standalone Compose,因此保留同版官方資產作維運參考,另外補 Action 關聯畫面。
Lab 04 README 啟動 Primary 和 Backup 兩個本機 Provider Fixtures,分別使用 OpenAI 相容和 Anthropic 回應格式。它們固定回傳狀態、模型名稱與 Usage,不需要外部 API Key,也沒有實際供應商帳單。
這次 Gateway 真的執行 LLM 路由、原生 Analytics、Metrics、Access Logs 和 Trace。固定 Provider 回應,則讓我們能在相同條件下檢查失敗與成功資料如何被記錄。
圖中的兩組路徑是不同情境,閱讀時看同一個 Action 如何分成兩次 HTTP 請求。每次的實際呼叫都是 Client → agentgateway → Provider,沒有雙層 Proxy。
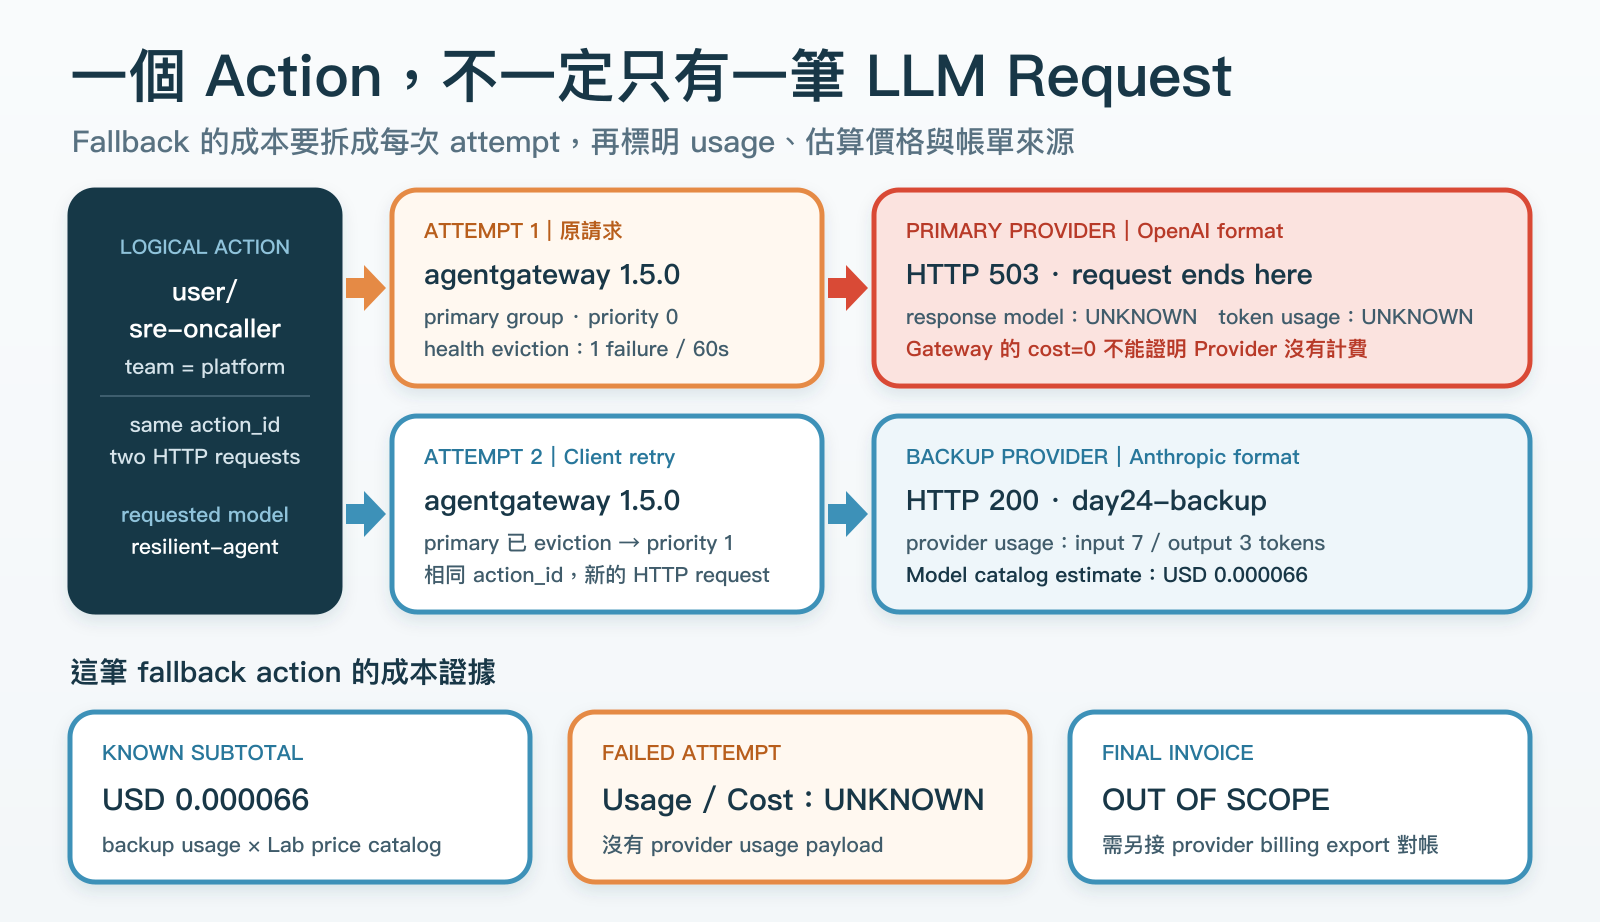
我原本把 Virtual Model 的 Failover 理解成 Primary 失敗後,Gateway 會在同一個 Request 裡直接換 Backup。這份設定實跑後,Primary 503 會讓 Gateway 暫時避開故障 Target,但當下請求仍然失敗,下一筆請求才改走可用的 Backup。這個行為稱為 Health Eviction,改變的是後續選路。
本次因此由 Client 明確重送,並讓兩次請求共用一個 action_id。agentgateway 另有 Route-level Retry Policy,但不能把它與這份 Simplified LLM Policy 混用。在 1.5.0 直接加入 llm.policies.retry,Validator 會回報:
Error: llm.policies: unknown field retry
這個結果只限定本次配置方式。正式採用時,要另外確認重試發生在哪層、最多幾次,以及總等待時間。若 Client 和 Gateway 都各自重試,同一次工作就可能產生比預期更多的 Provider Attempts。
實測先確認 Primary 正常時一筆請求能成功,回報 Input 11、Output 5。再把 Primary 固定成 503:不重送時,工作停在失敗。Client 重送後,Backup 回 200,提供 Input 7、Output 3,工作才完成。
官方 Analytics 下圖只看最後這個備援情境。閱讀時先看 Calls 是兩次,再看 Token 和 Cost:後兩項只來自 Backup 的成功回應。
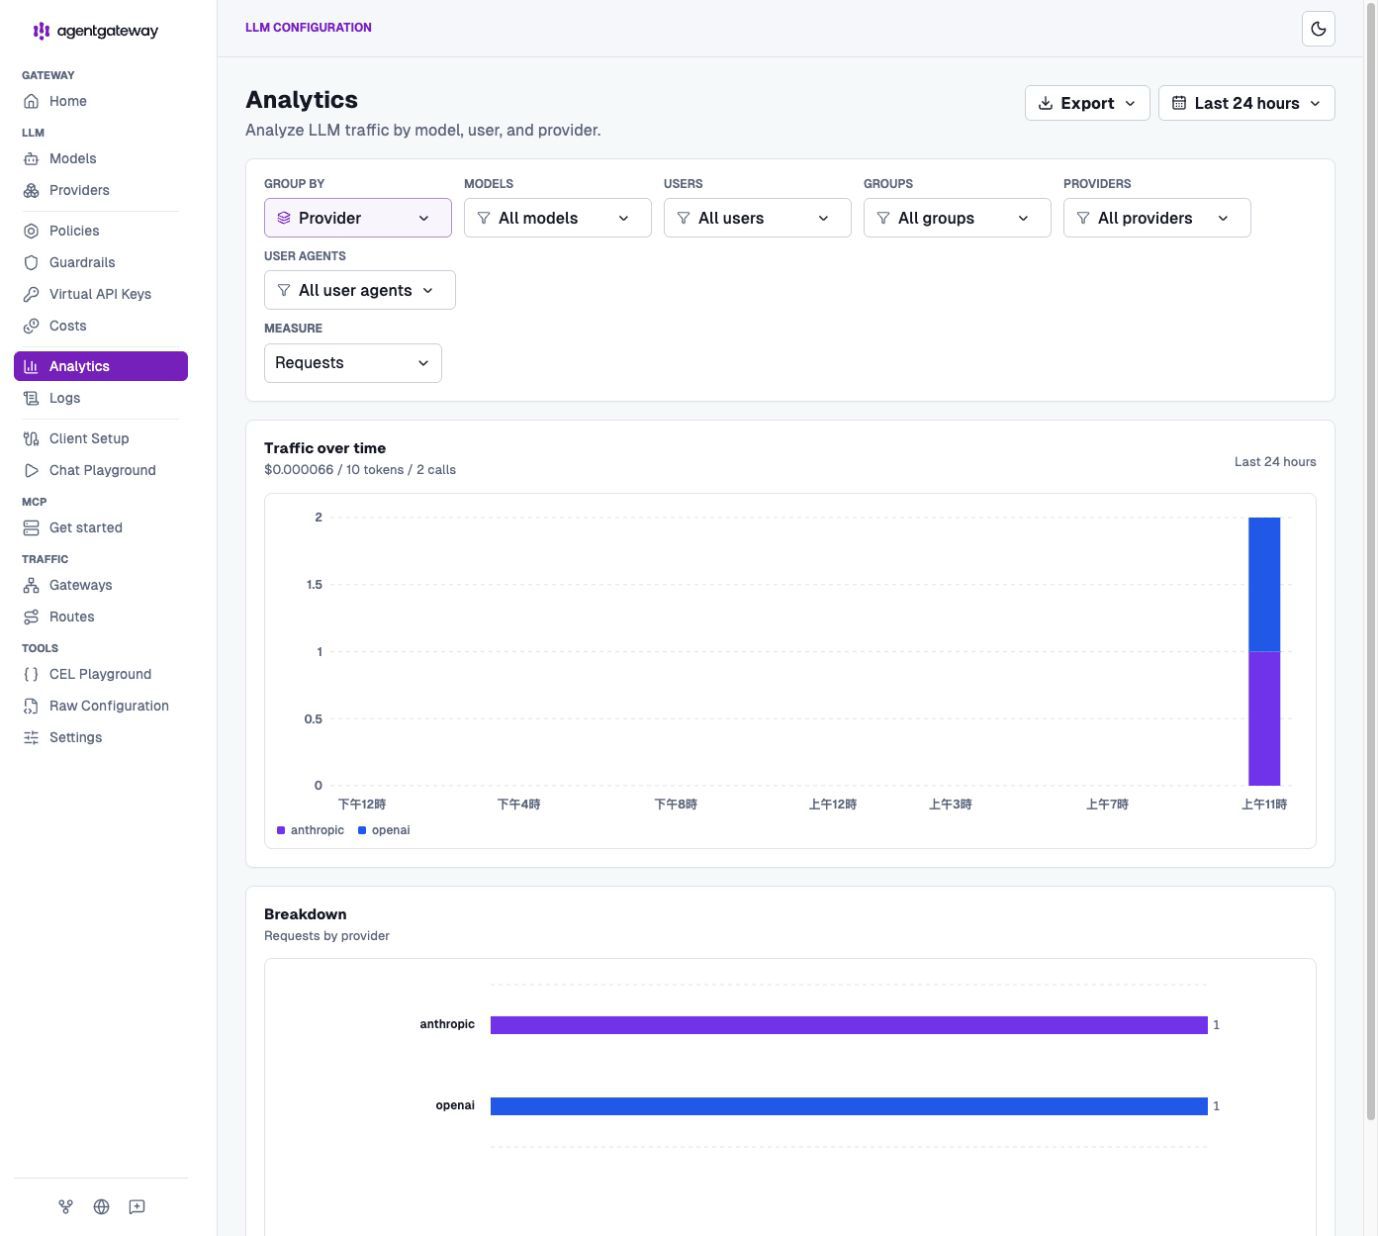
Calls 包含 Primary 503 與 Backup 200。十個 Tokens 與 USD 0.000066 卻只有一份 Usage 支持,所以目前能說的是「已知的 Backup 估算小計」。完整 Action Cost 仍是 UNKNOWN,因為 Primary 的用量沒有資料。
這不代表本機示範真的產生了未知帳單,而是要保留一個正式服務也會遇到的資料狀態:失敗請求沒有回報 Usage 時,觀測端無法只靠零值確認是否免費。把這個缺口在畫面上保留下來,日後才有地方接供應商的帳務資料。
自訂 Grafana 畫面將原生 Token/Cost Metrics 和相關 Logs 放在一起。上半部用來比較兩種 Provider 格式的用量與估算,下半部則以 correlation_action_id 找 Primary 失敗和 Backup 成功的兩次請求。
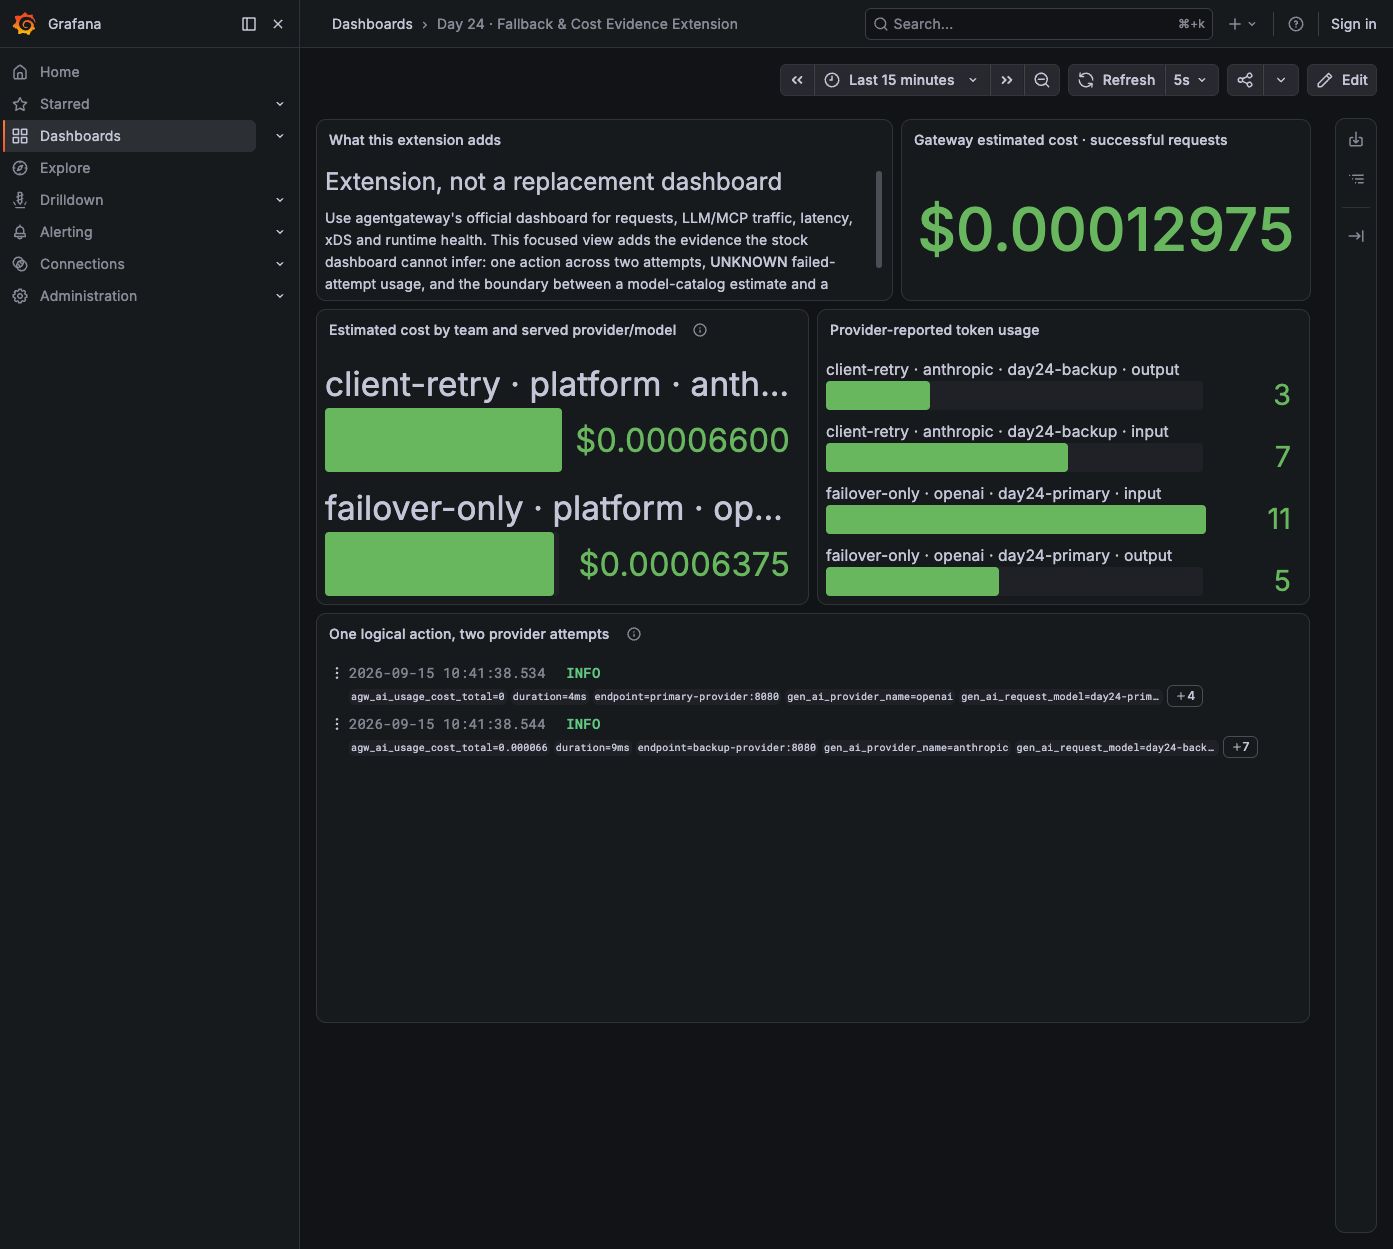
這張圖的 USD 0.00012975 還包含先前獨立的 Primary Calibration,也就是為確認 Primary 正常計價而送的一次成功請求,再加上 Backup 成功請求。它能說明兩種 Provider 格式都被處理,不能拿來當某一筆備援工作的價格。
總額的範圍由查詢條件決定。只看同一個時間區間,就可能混入其他工作。個別調查需要沿 Action ID 查明哪些 Attempts 屬於這次工作,再看每次有沒有 Usage。這也是保留逐筆資料的價值:日常看聚合,對不上時還能回到來源。
即時告警可以用 Gateway Estimate,例如觀察某個團隊的費用趨勢,或備援用量是否突然增加。若要向團隊正式分帳,就還需要版本化價格、可信的團隊對應,以及 Provider 帳務核對。官方 Attribution 文件 也說明,帳單層級歸屬取決於 Provider 是否支援並保存對應資訊。
價格表要有生效時間,未知用量和未定價模型要可見。重試規則則要由明確的元件負責,包含次數、等待上限和失敗處理。當工作還會呼叫有副作用的工具,重試也要檢查冪等性,避免同一個修改被執行兩次。
這份成本鏈最後能回答:原本要求哪個模型、實際送了幾次請求、哪個 Provider 完成、哪次回報用量,以及金額依哪份價格估算。缺的資料留待帳務補齊,才有辦法解釋總額,而不只是顯示總額。
接下來把觀測資料交回 Agent 使用。當 SRE Agent 可以自己查 Loki,它不只需要控制查詢範圍,也要能區分工具回應、空結果和真正可用的事故線索。



 iThome鐵人賽
 看影片追技術