
做 Agent Dashboard 時,很容易遇到這個需求:目前只能按團隊看流量,能不能再加一個成員選單?每筆請求本來就帶著登入資訊,從 JWT 取出使用者 ID,再加進指標,看起來只需要多一個欄位。
畫面上的改動很小,儲存方式卻會跟著改變。原本一個團隊共用一條請求計數,加入使用者後就按人拆開。如果再按 Conversation 分組,每次新對話也可能建立新的時間序列。即使請求量完全相同,觀測後端需要維護的資料組合仍然增加。
我在維運 Prometheus/Mimir 和 Loki 時,會把這個問題與個資分開看。使用者 ID 就算已經換成看不出 Email 的代碼,只要每個人仍有不同值,分組數量就不會因此減少。本篇先看這種成本如何產生,再用 agentgateway 的實測比較團隊、使用者與對話三種分組。
Prometheus 的時間序列,可以理解成某個指標在一組固定條件下,隨時間累積的數值。指標名稱加上完整的 Label 值組合,就識別一條序列。例如相同的 Request Counter,team=platform 與 team=application 會各自保存數值,查詢時再將兩者加總。
若你在其中加入 user_id,同一個團隊的請求就會按使用者分開計數。再加入 conversation_id,同一個人的不同對話也會各自成為一組。這些欄位不是只在查詢時顯示,它們會參與寫入時的資料識別。Prometheus Label 實務 因此提醒,每組不同的 Label 值會建立新序列,使用者 ID 等不受控集合需要特別留意。
Cardinality 指的就是不同組合的數量。它會影響後端需要維護多少序列,以及查詢必須掃過多少資料。請求數和 Cardinality 是不同的量:一萬筆請求可以累積在少數幾條序列,也可以因為每筆都有唯一操作 ID 而拆成一萬條。
查詢時使用 sum by (team),可以將細分資料重新聚合,卻不會取消寫入時已經建立的使用者序列。錄製規則或 Dashboard 隱藏欄位,也不會讓原始資料的成本消失。要限制分組,必須在 Producer 或收集出口決定哪些值能進 Label。
成員篩選本身很有用,問題是它要服務哪種工作。值班的人想知道「哪個團隊的工具錯誤率上升」,通常只需要團隊、Route 和結果。調查某位使用者的一次操作,則需要找到事件與呼叫路徑,逐筆查看上下文。兩種需求可以在同一個 Grafana 裡完成,底下仍然可以使用不同資料來源。
我會讓日常健康指標保留有限的集合,例如由平台管理的團隊與路由。個別操作的識別放在 Trace 或 Log Metadata,事故調查時再拿來篩選。若需要長期做每人使用分析,就另外規劃分析資料的 Schema、查詢權限和容量,讓它有自己的維護責任。
這種分工還有一個前提:團隊值必須真的受控。欄位叫 team 並不保證值很少。若任意應用可以把 Project ID 或臨時名稱塞進去,它仍然會隨使用量成長。因此 Label 審查要同時看欄位名稱、值的來源、誰維護集合,以及什麼時候會增加或淘汰。
想按登入者分組,首先要確認登入資訊可信。JWT 的 sub 代表主體,team 則是本篇採用的合成 Claim。Gateway 應先驗證簽章、簽發者、接收對象和有效時間,才使用其中的值。直接把使用者傳入的 Header 改名成 user_id,並不能得到相同的身分證據。
agentgateway 可以將這些值加入原生觀測欄位。Metric Field Projection 文件 說明了自訂 Metric 欄位的設定。這裡的 Projection 就是從請求脈絡挑出欄位,放進輸出的指標,不需要應用再另外寫一份近似的 Gateway Counter。
例如下面的設定只加入團隊值,讓請求指標能按團隊聚合。這是後段實測使用的片段,完整 JWT 與路由設定留在 Lab。
config:
  metrics:
    fields:
      add:
        team: jwt.team
入口驗證與欄位選取是兩個判斷。驗證過的 sub 可以可信地識別主體,是否適合進入 Metric Label,則還要回到資料用途與容量。可信來源不會自動讓高基數變低。
Lab 04 README 用三組平行的 agentgateway 驗證前面的差異。三組都驗相同 JWT、使用相同 Route 和 Backend,也都處理相同流量。唯一改變的是原生 agentgateway_requests_total 加入的 Label:第一組只加團隊,第二組再加使用者,第三組再加對話 ID。
這裡的 Gateway 是實際的 agentgateway 1.5.0。Python 只建立臨時 RSA Key、替合成主體簽 Token、產生流量、提供固定回 HTTP 200 的安全後端,並查詢觀測資料。沒有 Token 和 Audience 錯誤的請求,都先得到 401,確認身分欄位確實經過驗證入口。
下圖的 A、B、C 各自接收相同請求,不是三層 Proxy 串接。先看三組輸入一致,再看下方不同的 Metric 分組,才能把結果差異歸因到 Label 設計。
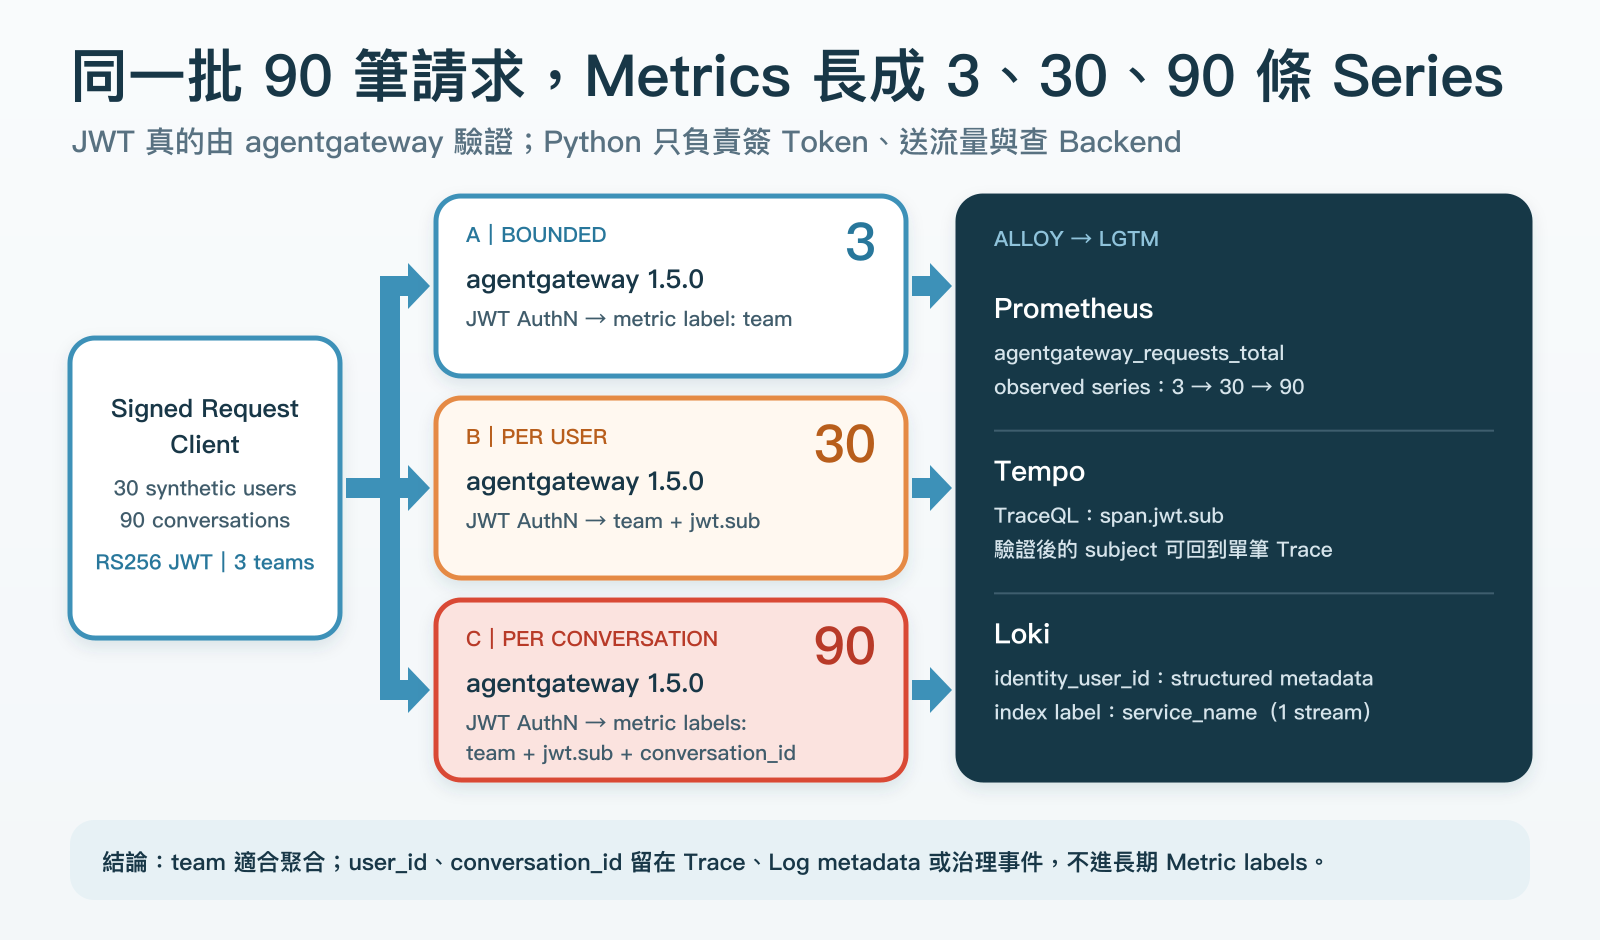
流量固定為三個團隊、三十位合成使用者,每人三段對話。每位使用者只屬於一個團隊,每段對話也只屬於一位使用者,所以每組都是九十筆請求。三組合計二百七十筆成功請求,另外有兩筆前面的身分驗證拒絕測試。
team 和 user_id 來自已驗證的 JWT。conversation_id 則來自 x-conversation-id Header,它是應用的關聯值,並沒有因為 Gateway 接收它就變成已驗證的身分。這個差別不影響分組成本,但會影響調查時能相信什麼。
流量結束後,直接查 Prometheus 已保存的 Label Sets。三個 Scrape Job 使用相同條件,各自選取對應 Job,再計算這條 Route、HTTP 200 的序列數。核心查詢如下:
count(
  agentgateway_requests_total{
    route="default/cardinality-run",
    status="200"
  }
)
結果依序是三、三十、九十條。只按團隊分組時,同一團隊的請求累積在一起。加入使用者後,拆成三十個實際出現的使用者組合。再加入對話後,拆成九十個實際出現的對話組合。
下圖上半部的 Bar Gauge 直接查 Gateway 原生指標,下半部則是三組 Gateway 送出的 Access Logs。可以對照「序列數不同,但每組收到相同流量」,而不是把三個數字理解成流量依序增加。
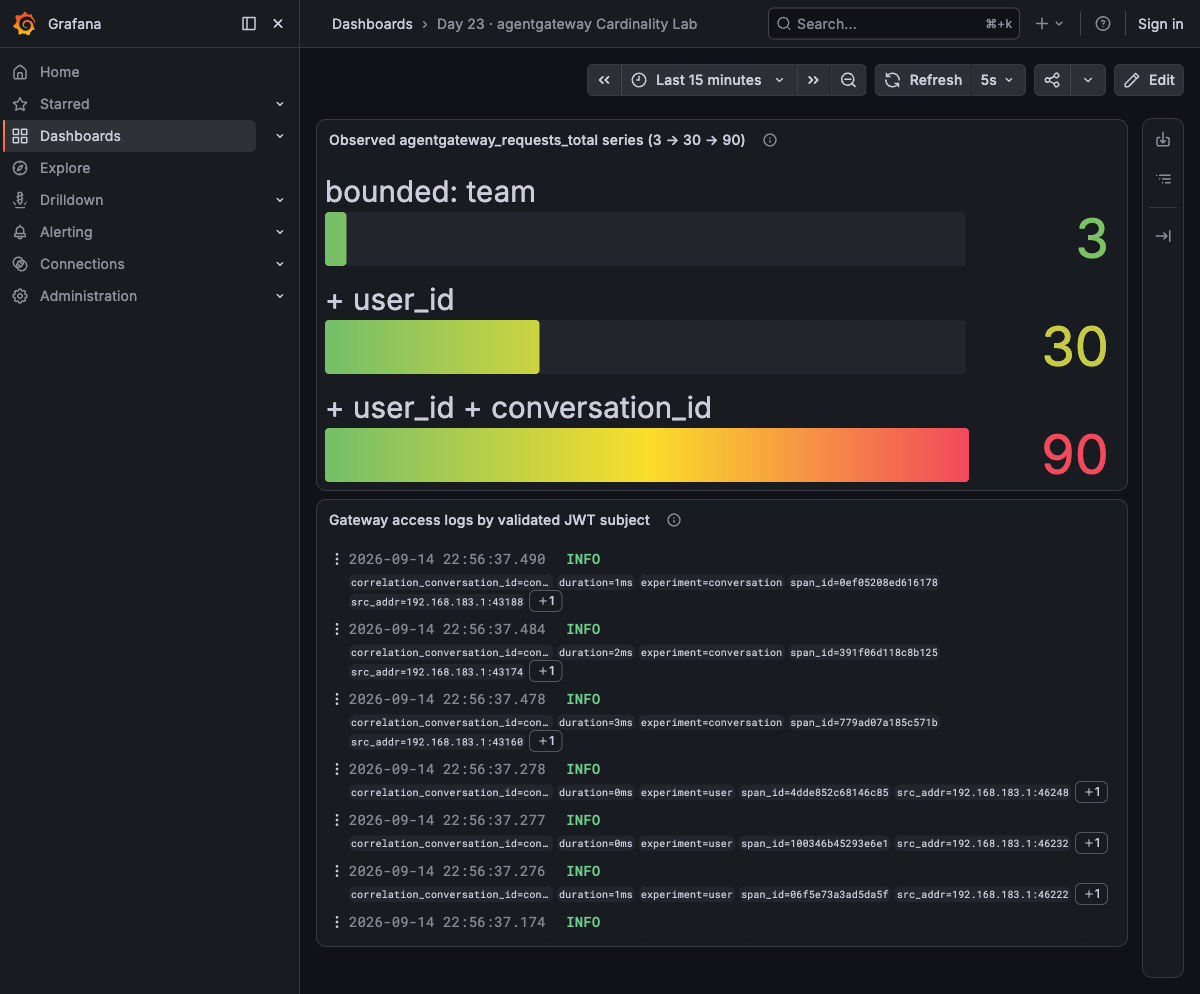
後兩組相對第一組增加十倍和三十倍,這只描述本次流量形成的組合。它不是把三個團隊、三十位使用者、九十段對話全部相乘,因為這些值有從屬關係,不會出現所有可能排列。
正式流量還有 Method、Status、Backend、Model 或 Region 等維度。本次固定其他條件,才容易看見身分分組帶來的額外成本。實際容量需要按自己的流量與保存期限量測,不能直接拿這個倍率預估帳單或記憶體。
三組 Gateway 的 Trace 和 Access Log 都保留單筆調查所需的合成主體欄位。流量產生器也為每筆請求加入 W3C traceparent,把第一筆合法請求的 Trace ID 存到報告。用它查 Tempo,可以在 Gateway Span 找到 jwt.sub=user/sre-oncaller-000,對回這次請求。
本次直接使用合成 Subject,是為了檢查原生 Claim Projection。實際資料若不需要保存原始主體值,可以按前篇的方法換成受控參照,並安排單人查詢權限。這會改變識別資料的暴露方式,卻仍保留每人不同的值,所以高基數判斷不變。
Trace 的保存仍受 Sampling 和管線可用性影響。若某筆沒有被保存,就要使用相關事件或調整追蹤策略,不能從聚合指標猜出一條不存在的執行路徑。
Loki 使用另一種方式。先以有限的 service_name 選 Stream,再用 Structured Metadata 過濾使用者:
{service_name="agentgateway"}
  | identity_user_id = "user/sre-oncaller-000"
本次二百七十筆 Gateway Access Log 只形成一條 service_name=agentgateway Stream。後端的 Label Name 與 Series API 也確認,使用者和對話 ID 沒有進 Index Label。這讓單人資料仍可搜尋,卻不按每人、每段對話切出新的 Stream。
Loki Structured Metadata 適合這類需要查詢、卻不適合進索引的高基數值。它仍然保存資料,也有查詢與儲存成本。個別主體查詢需要的權限、Tenant 隔離與刪除流程,應該和團隊健康面板分開安排。
我會把 Cardinality Budget 當成一份可以持續檢查的約定。除了允許哪些 Label,還要說明預期值域、負責人,以及新增值的條件。例如團隊由身分或平台團隊維護,Route 隨服務上架增加,Outcome 則由固定狀態集合產生。只限制 Key 數量,仍然可能讓其中一個值域無限成長。
Review 時先問使用者要做哪個查詢,再查看既有 Labels 和尖峰 Active Series,也就是目前仍在產生資料的序列數。若新欄位只為偶爾查一筆事件,就優先提供 Trace 或 Log 的搜尋入口。若確實有長期分組價值,再替它安排容量、值的生命週期與維護者。
本次比較讓我們看到,agentgateway 的 Claim Projection 能工作,欄位的資料責任也因此回到平台手上。團隊聚合和個別調查都能保留,只需要各自使用適合的儲存方式。
下一個常見分組是 Model 和 Provider。它們通常比對話 ID 更容易控制,但一次 Agent 工作可能先呼叫 Primary,再由 Backup 完成。下一篇接著看,畫面上的模型、Token 和成本究竟對應哪一次請求。



 iThome鐵人賽
 看影片追技術