
文字      月營收表的備註欄,2013-01 到 2026-08,164 個月,63,140 則
抽樣      每個月固定種子抽 50 則,去識別化
請求      一個月一個請求:50 則一起給,要它對每則回 tone(−2 到 +2),只輸出 JSON 陣列
模型      Gemini 2.5 Flash,溫度 0,不用思考預算,每個請求快取
成本      164 個請求,免費額度,58 分鐘
產出      7,760 則有效標註(94.7%);月指數 = 語氣平均、負面比例(tone < 0 的占比)
可用日    次月 11 日,跟營收數字同一天
tone 的分布:−2 占 4%、−1 占 20%、0 占 32%、+1 占 38%、+2 占 6%。跟 Day 24 一則一則問的時候七成給 0 不一樣,五十則放在一起比較,它願意分出正負。
重測:抽 12 個月,把 50 則的順序打亂再問一次,500 則裡 88% 完全一致、99% 差在 1 以內,月平均的差中位數 0.08。月指數是穩的。
LLM 語氣月均 vs 營收 yoy 為正的公司比例     Spearman +0.57
LLM 負面比例 vs 該比例                              −0.61
LLM 語氣月均 vs embedding 語氣月均(Day 24)       +0.31
LLM 語氣月均 vs 站上 60 日線比例                    −0.11
LLM 語氣月均 vs 指數距 200 日線                     +0.25
它跟營收數字走在一起、跟廣度無關,是基本面側的指標,有資格當第五家族而不是另一種廣度。跟 Day 24 的 embedding 版只有 +0.31,兩條路讀出來的東西不太一樣,差在哪裡下一節講。
前視的檢查照 Day 23 的第三條規矩:跨期一致。LLM 指數跟 yoy 為正比例的相關,模型知識截止前(到 2025-02)+0.54、截止後 +0.80。截止後高很多,但 embedding 版同樣是 +0.48 對 +0.94,這是 2025 年後那 18 個月本身的特性,不是 LLM 偷看。
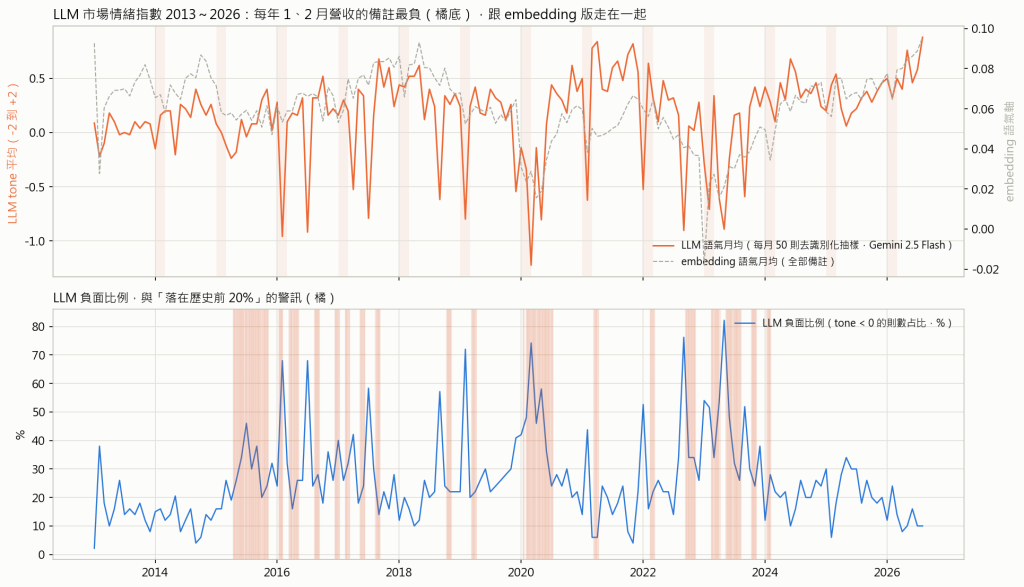
Day 24 的 embedding 語氣軸有一個很強的季節:每年 1、2 月的備註最負,因為春節工作天數少,公司統一寫「工作天數減少致營收下降」。embedding 量的是措辭離「需求疲弱」多近,這句就是負的。
LLM 讀同一句,大多給 0:它知道這是在陳述一個日曆事實,不是對生意的判斷。1、2 月營收的 LLM 語氣平均 0.11,其他月份 0.25,差距在,但比 embedding 版小得多,警訊落點也不再集中在 2、3 月。這件事在擇時上很重要,因為 embedding 版的第一條規則被季節咬了:
                                       年化    Sharpe   最大回檔   前半    後半
買進持有 0050                          21.4%   1.08     −34%      0.92    1.24
embedding 語氣 3 月變化低 → 曝險 0.5    21.6%   1.17     −38%      1.04    1.31
對照:每年 2/11~4/10 曝險 0.5          21.7%   1.19     −32%      0.98    1.37
embedding 版的警訊十二次有九次在 2、3 月,成績一條月曆就做得到。要救它得先減掉同月份的歷史平均再算,校正之後 Sharpe 1.19、回檔 −26%,才是文字自己的訊號。LLM 版不用走這一步。
規則跟 Day 19 一樣:t 日收盤算訊號、t+2 生效、每次改曝險付 0.15%,套在 0050,2015 到 2026,前半到 2020、後半從 2021。警訊 = 指標落在自己「當時以前」歷史的極端 20%,警訊時曝險 0.5。
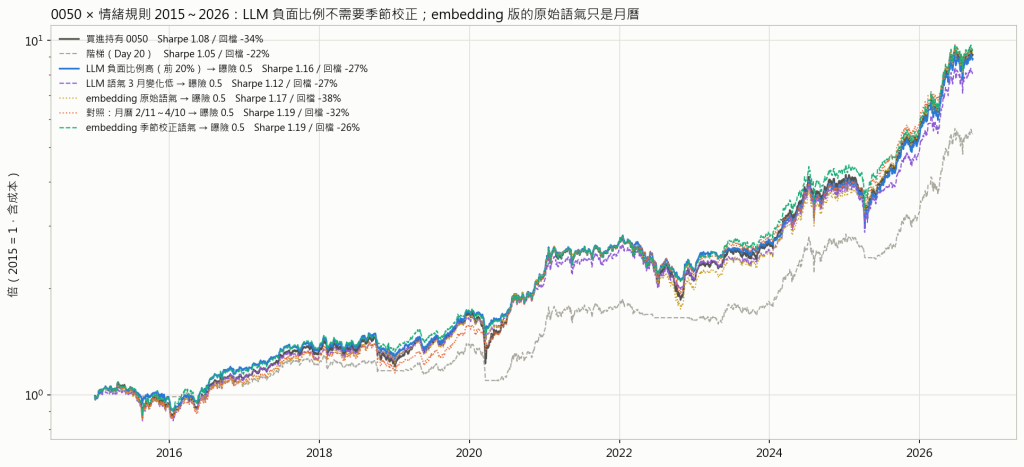
                                        年化    Sharpe   最大回檔   前半    後半    在場    警訊次數   過關
買進持有 0050                           21.4%   1.08     −34%      0.92    1.24    100%
LLM 負面比例高(前 20%)→ 曝險 0.5      21.1%   1.16     −28%      1.11    1.25     88%     18       4
LLM 語氣 3 月變化低 → 曝險 0.5          20.2%   1.12     −28%      1.03    1.24     86%     25       4
LLM 語氣低(後 20%)→ 曝險 0.5          20.6%   1.11     −31%      1.02    1.21     91%     14       3
embedding 季節校正語氣 → 曝險 0.5       21.8%   1.19     −26%      1.08    1.32     90%     16       4
對照:季節校正 yoy 為正比例 → 曝險 0.5  20.6%   1.12     −29%      1.09    1.17     89%     20       3
階梯(Day 20)                          16.1%   1.05     −22%      0.71    1.32     71%              2
主角是負面比例:這個月標成負面的備註占比落在歷史前 20%,就把 0050 減半。四關全過,Sharpe 1.16 對 1.08,回檔 −28% 對 −34%,前後半都贏。十八次警訊散在一年裡的九個月份,抓到 2018-10、2020-01、2022-02、2022-09 這幾段。
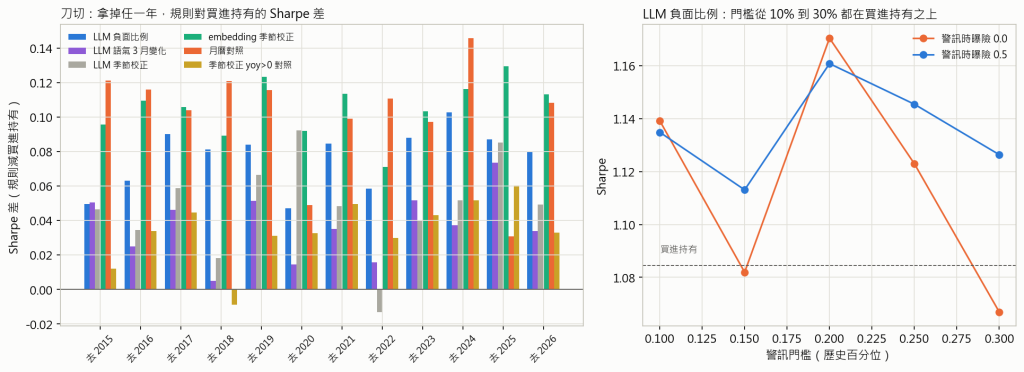
拿掉任何一年,Sharpe 差在 +0.05 到 +0.10;警訊時曝險 0.5 的版本,門檻從 10% 到 30% 都是 1.11 到 1.16,全部在買進持有之上(改成空手的版本在 15% 只跟買進持有打平、30% 掉到以下,減半比空手穩)。這條規則不靠某一年、也不靠某個門檻。
但要老實講兩件事。第一,它比 embedding 季節校正版弱:1.16 對 1.19,刀切 +0.05 到 +0.10 對 +0.07 到 +0.13。LLM 讀得比較懂,但讀懂之後的擇時價值沒有比一條零成本的向量軸高。第二,數字版本的對照(季節校正過的 yoy 為正比例)Sharpe 1.12、過三關,文字比數字多出來的只有 0.04 的 Sharpe 和一關。文字裡有營收數字沒有的東西,不多。
五分位對未來 60 日的報酬:負面比例最高的一組之後 60 日 5.8%,最低的一組 4.9%,中間三組 4.7 到 5.6,方向甚至跟規則相反。它不是線性的預測,平均而言負面月份之後反而略好;規則賺到的是幾次大回檔前負面比例剛好衝到前 20%,躲掉一半,其他時候減半是白減的。Day 22 講的樣本數問題,十八次警訊一樣適用。
2026 年 8 月:LLM 語氣月均 0.88,歷史第 99 百分位;負面比例 10%,第 7 百分位。全市場的公司解釋營收的語氣是十三年來最正面的,沒有警訊,規則給的曝險是 1。跟廣度放在一起看:七成的股票在 60 日線下,公司自己說生意很好。這兩件事同時成立,就是現在。
**去識別化是 LLM 讀歷史文字的前提。**拿掉公司、代號、年份,模型就只能做文字分類,記憶進不來;跨期一致性檢查過了,截止前後的相關差距 embedding 版也有。
**五十則一起問,一小時,免費額度做完十三年。**7,760 則標註、重測 88% 一致、月均差 0.08。指數穩得可以當每月更新的東西。
LLM 讀得懂春節。「工作天數減少」它給 0,embedding 給負;所以 LLM 版不用季節校正,embedding 版不校正就是一條月曆規則。
**負面比例規則四關全過,但贏得不多。**Sharpe 1.16 對買進持有 1.08、回檔 −28% 對 −34%、刀切與門檻都穩;比零成本的 embedding 季節校正版低 0.03,比純數字的對照高 0.04。文字的市場情緒有資格當第五家族,它的價值是「不用價量就能看見同一件事」,不是更準。


 iThome鐵人賽
 看影片追技術