
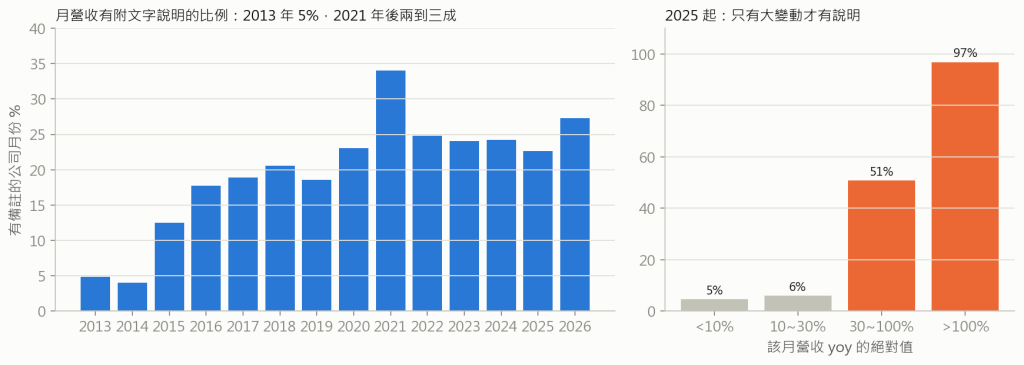
2013 年起 63,140 則備註,2,168 檔公司,中位數 25 個字、九成在 53 個字以內。內容像這樣:
主要客戶的新產品開始出貨,以及新客戶的產品開始量產。
本月營收較去年同期增加,係因前期未有銷貨收入所致。
受惠於全球 AI 及 HPC 客戶需求持續強勁,高階測試座及 MEMS 探針卡持續拉貨。
因本期子公司工程收入及嬰童用品收入較去年同期減少。
四件事要先知道。
**只有大變動才有備註。**2025 年起,營收 yoy 絕對值超過 100% 的月份 97% 有備註,30% 到 100% 的一半有,30% 以內只有 5%。「有沒有備註」本身跟 yoy 的大小幾乎是同一件事,文字特徵的樣本天生偏向大起大落的公司月份。
**三成是套話。**63,140 則裡,出現十次以上的句子占 29%:「客戶需求增加」一句出現 306 次,「係本公司自結合併營收」184 次。抽出來的 600 則裡有 130 則跟另一則一字不差。這些句子沒有資訊,兩條路都只能給它一個一樣的分數。
**覆蓋率是逐年長出來的。**2013 年 5%、2016 年 18%、2021 年後兩到三成。回測往前拉到 2013 年,前幾年幾乎沒有樣本。
**發布日對齊很乾淨。**備註跟營收同一份申報,次月 10 日前公布,可用日跟 Day 9 一樣是次月 11 日,不用另外猜這段文字什麼時候能看到。這是它勝過新聞的地方:新聞的「發布時間」常常是網站的時間戳,不是市場看到的時間。
模型用 BAAI/bge-small-zh-v1.5,一個一百多 MB 的中文句向量模型,在這台機器的 CPU 上載入 15 秒、把 63,140 則備註全部嵌成 512 維向量花 168 秒。
向量本身不是一個數字,要把它壓成一個。做法是定一條「語氣軸」:六句正向錨句(客戶需求提升、新產品開始量產出貨、新客戶開始貢獻營收……)的平均向量,減六句負向錨句(客戶需求疲弱、客戶去化庫存、出貨遞延……)的平均向量,每則備註在這條軸上的投影就是它的分數。沒有標籤、沒有訓練、沒有隨機性。
分數十分位          −0.10(最負)    0.08(中位)    0.17(最正)
跟同月營收 yoy 的 Spearman                +0.44
最負的備註          受新冠肺炎影響及美金匯率貶值導致營收減少。/去年因疫情影響基期低。
最正的備註          新產品開始貢獻營收,5 月營收創 3 年來新高/新增產品線及成功開發新客戶
可重現性            同一批文字重算一次,向量逐維最大差 1.5 × 10⁻⁷
+0.44 是它讀得懂中文的證據:公司寫「需求減少」的月份 yoy 確實是負的。1.5 × 10⁻⁷ 是浮點運算的雜訊,模型檔案固定、程式固定,明年跑出來就是同一個數字。這條路的成本是零,唯一的維護工作是把模型檔案跟程式一起存起來。
把備註去識別化——公司名、代號不給,民國年和西元年改成「某年」——丟給 Gemini 2.5 Flash,溫度 0,要求輸出四個欄位:
tone       −2 明顯負面 … +2 明顯正面(對未來營運的語氣)
driver     需求/價格/新產品或新客戶/產能或出貨時程/併購或合併範圍/基期或一次性/匯率/其他
one_off    是否一次性
guidance   有沒有對之後幾個月的展望:正面/負面/沒有
抽 600 則,全部落在 2025 年 3 月以後——Gemini 2.5 Flash 的知識截止之後,避開 Day 23 那個坑。免費額度跑 600 則加 120 則重測,一個半小時。
tone 分布       −2:1    −1:24    0:434    +1:106    +2:35
driver          需求 216、產能或出貨時程 136、其他 86、新產品或新客戶 58、基期或一次性 46、併購 37、匯率 11、價格 10
guidance        沒有 558、正面 39、負面 3
one_off         61 則
七成二的備註被標成中性。這不是模型偷懶,是備註本來就多半只陳述事實:「配合客戶需求出貨」「因勞務收入減少」。真正帶語氣的是那 166 則,正的居多——公司解釋營收大增的時候比解釋大減的時候話多。展望幾乎沒有,558 則沒有提到之後。
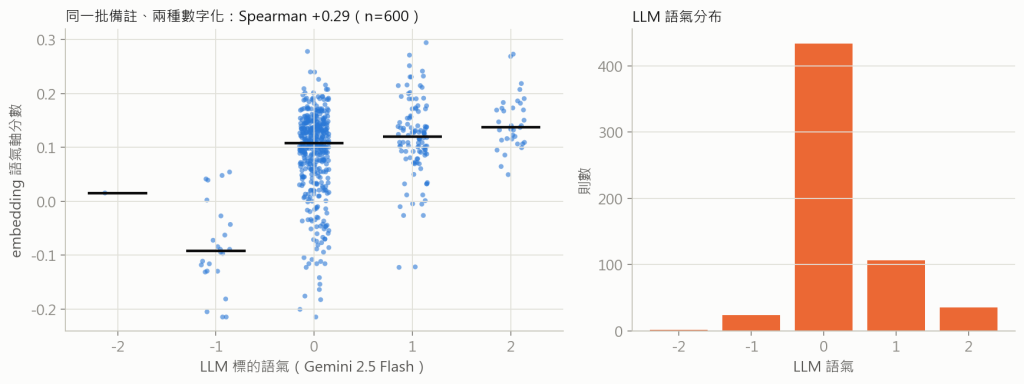
同一批 600 則,兩條路的分數 Spearman +0.29。相關但不高,因為兩者量的不是同一個東西:embedding 軸量的是措辭離「需求提升」還是「需求疲弱」多近,LLM 量的是它讀完之後對未來的判斷。「本月營收較去年同期減少,主係因為客戶需求減少所致」embedding 給最負,LLM 給 −1;「合併子公司屹海風電獲利,挹注營收」embedding 覺得中性,LLM 給 +1,還標了 driver 是併購——這種差別在 Day 26 量增量的時候會變成兩個不同的特徵。
這是這篇真正要回答的問題。embedding 那條路答完了:會。LLM 這條路要測。
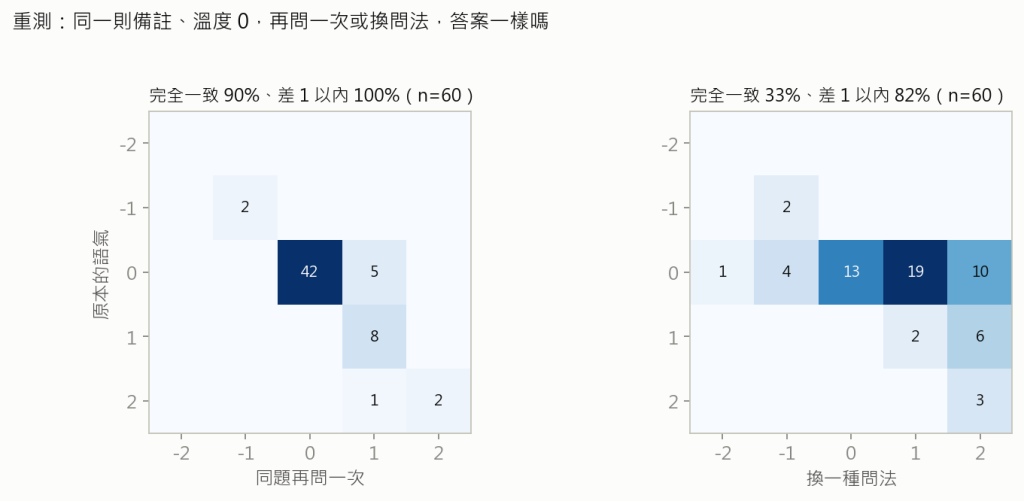
拿 60 則出來重問兩次:同一段提示詞在尾巴加一句「請再確認一次」,讓快取失效、模型真的再答一次;以及換一種問法,意思一樣、字不一樣。
                     tone 完全一致    差 ≤ 1     driver 一致    one_off 一致
同題再問一次            90%           100%
換一種問法              33%            82%          80%           98%
同題再問,溫度 0,九成一樣,剩下一成在相鄰的分數之間跳。換一種問法,只有三分之一一樣:第二種問法把 19 則從 0 分推到 +1、10 則推到 +2,平均高了 0.65 分。**同一段文字、同一個模型、同一天,換幾個字的問法,數字就差半格以上。**driver 和 one_off 是事實性的欄位,穩得多。
這件事的意思是:LLM 標註出來的數字,一半是文字的,一半是提示詞的。要它明年跑出同一個,條件是提示詞一個字不改、模型版本不變、溫度 0——三個條件裡最難的是模型版本,供應商會退役舊模型,到時候同一個提示詞就會給出另一個分布。
所以規矩是這樣:
1. 提示詞當程式碼:進版本控制,改一個字就是新版本,新版本的標註全部重跑,不混用
2. 快取鍵 = 模型名 + 提示詞 + 文字 的雜湊;原始回答整段存檔,不只存解析後的數字
3. 回測只用快取,不即時呼叫;模型退役時,快取裡的數字還在,特徵可以重建
4. 每個 LLM 特徵附重測數字:同題一致率、換問法一致率;換問法差 ≤1 低於八成的欄位不用
5. 有 embedding 做得到的,先用 embedding;LLM 只做 embedding 做不到的事——分類原因、判斷一次性、抓展望
成本也放在這裡,因為它決定哪條路走得下去:
                    63,140 則(2013 起全部)        10,101 則(2025-03 起)
本機 embedding      3 分鐘、0 元                    30 秒、0 元
Gemini 免費額度     每分鐘十幾題,約 4 天           約 14 小時
Claude Haiku 4.5    約 25 M tokens、30~40 美元      約 6 美元
Day 26 才用 Day 15 的尺正式量,這裡先看 600 則的方向,全在模型截止之後,沒有前視。
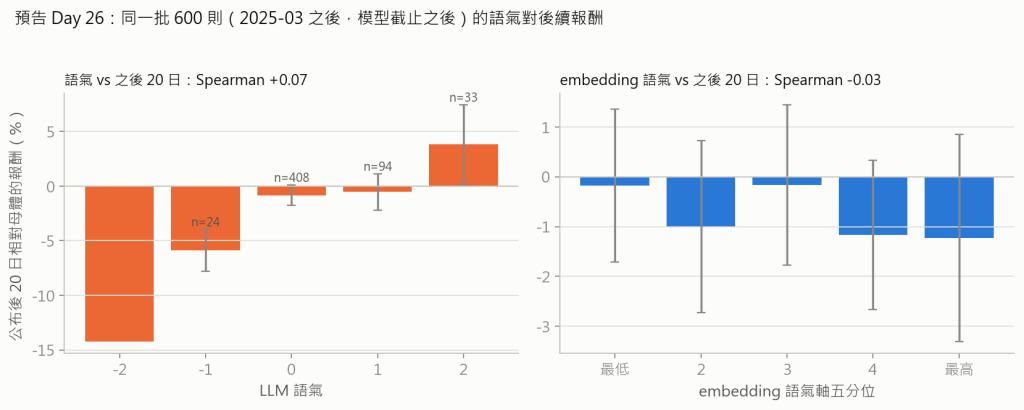
LLM tone       −1(24 則)   0(408 則)   +1(94 則)   +2(33 則)
公布後 20 日
相對母體         −5.9%        −0.8%         −0.5%        +3.8%
Spearman                          +0.07
embedding 語氣軸五分位:最低 0.0%、−1.0%、−0.4%、−1.1%、最高 −1.2%     Spearman −0.03
LLM 的兩端有方向:−1 那組公布後 20 日輸母體 5.9 個百分點,+2 那組贏 3.8,但兩端合起來 57 則,中間 500 則是平的,整體 Spearman 0.07。embedding 的語氣軸完全沒有:五個分位都是負的,最正的那組最差。措辭的正負和之後的報酬無關,模型「讀完之後的判斷」有一點,而且集中在極端值。這是 Day 26 要接著問的:這一點是不是營收 yoy 本身就有的,扣掉 Day 12 的營收特徵之後還剩不剩。
**文字來源要先有乾淨的日期。**月營收備註跟營收同一天公布,可用日次月 11 日;63,140 則,但只有大變動才寫,2013 年前幾年幾乎沒有。
**embedding 三分鐘、零成本、位元級可重現。**語氣軸跟同月 yoy 的相關 +0.44,重算差 10⁻⁷。有 embedding 做得到的先用 embedding。
**LLM 標註一半是文字的、一半是提示詞的。**同題再問 90% 一致,換問法只有 33%,平均差 0.65 分。提示詞當程式碼、快取存原始回答、附重測數字。
**兩條路量的不是同一個東西。**Spearman +0.29;LLM 會抓原因和一次性,embedding 只抓措辭。600 則先看方向:LLM 語氣兩端有方向、中間是平的,embedding 語氣軸沒有。Day 26 用同一把尺量增量。


 iThome鐵人賽
 看影片追技術