
主張:
RunConfig不是一堆可有可無的旗標,它是你的語音 agent 能不能撐過十分鐘、能不能撐過一千個並發使用者的分水嶺。
讀完能做到:看懂RunConfig每個關鍵參數在解決什麼問題,並寫出一個能「監看」外部世界變化的 streaming tool。
Day 21 用了預設的 RunConfig,agent 能講話能看鏡頭,一切順利——直到你把它接上真實使用者,某天早上發現生產環境的錯誤日誌裡塞滿了斷線紀錄,客服對話講到一半就斷了,而且完全沒有觸發你設好的成本警報。
這不是巧合。今天要拆的 RunConfig,官方文件用一整份 Part 4 來講,因為它同時控制了回應格式、連線可靠度、session 能撐多久、以及成本上限——而這幾件事之間的關聯,遠比看起來複雜。
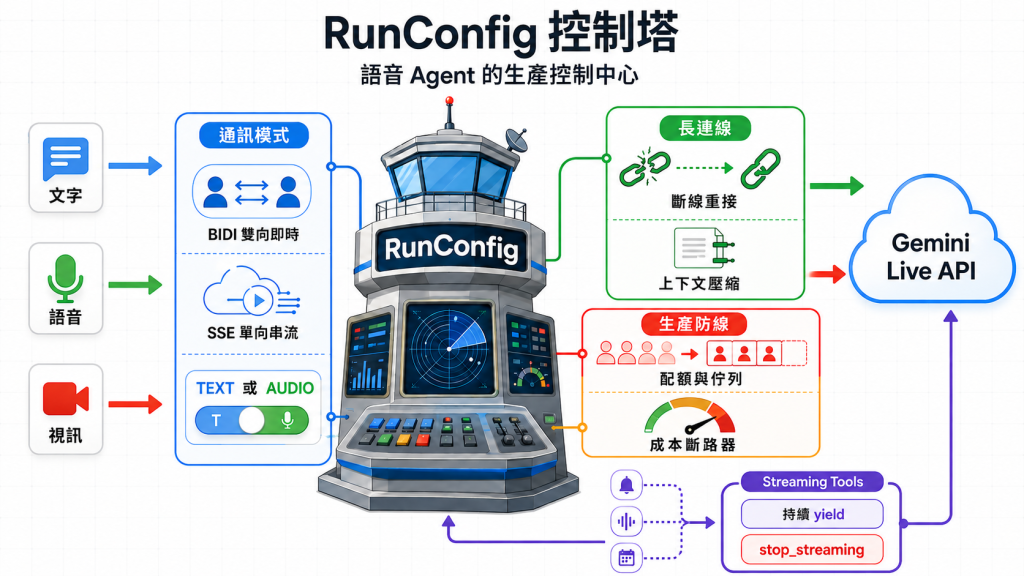
先講最容易踩到的規則:Gemini Live API 跟 Agent Platform 版本(透過 Google Cloud 存取,用 Google Cloud 憑證而非 API key,適合正式部署與企業應用;跟直接用 API key 打的 AI Studio 版是同一顆 Live API 的兩種進入方式,靠環境變數 GOOGLE_GENAI_USE_ENTERPRISE 切換,不用改程式碼)都限制一個 session 只能有一種回應模式——TEXT 或 AUDIO,不能同時要。
接下來這幾段 RunConfig 程式碼都是接著 Day 21 建好的 agent 專案改參數,不是各自獨立、貼上就能跑的完整腳本——RunConfig 與 StreamingMode 只需要 import 這一次,後面的片段沿用同一份:
from google.adk.agents.run_config import RunConfig, StreamingMode

# ✅ 正確:純文字回應
run_config = RunConfig(
    response_modalities=["TEXT"],
    streaming_mode=StreamingMode.BIDI
)

# ❌ 錯誤:兩種模式一起要(建構當下不會報錯,實際連上 Live API 時才會收到下面這個錯誤)
run_config = RunConfig(
    response_modalities=["TEXT", "AUDIO"],
    streaming_mode=StreamingMode.BIDI
)
# Live API 回傳:「Only one response modality is supported per session」
如果你完全沒指定 response_modalities,ADK 會自動幫你設成 ["AUDIO"],因為 native audio 模型需要明確的回應模式。這代表 Day 21 那個範例其實一直是用語音模式在跑,即使你沒寫這一行。選定之後不能中途切換模式——但輸入端沒有這個限制,不管你選哪種輸出模式,使用者都可以隨時傳文字、語音或視訊進來(只要模型支援那個輸入模態)。
RunConfig 還有一個常被忽略的開關,決定 ADK 跟 Gemini 之間走哪條協定:
StreamingMode.BIDI——WebSocket 連到真正的 Live API(live.connect()),雙向、支援打斷、支援語音視訊StreamingMode.SSE——HTTP streaming 連到標準 Gemini API(generate_content_async()),單向、傳統請求-回應模式這兩個名詞容易誤導人——它們指的是 ADK 跟 Gemini 之間的通訊協定,不是你的應用程式面向客戶端的架構。你完全可以用 SSE 模式接 Gemini,同時自己架一個 WebSocket 伺服器給前端用。
什麼時候該選哪個?Gemini 1.5 系列(gemini-pro-latest、gemini-flash-latest)完全不支援 Live API,只能走 SSE——換來的是最大 2M tokens 的巨大 context window,適合純文字、不需要即時打斷的應用。Gemini 2.0/2.5 Live 系列兩種都支援,但通常會用 BIDI 才能拿到即時語音視訊功能。
還有一個實驗性功能值得記一筆:Progressive SSE Streaming(環境變數 ADK_ENABLE_PROGRESSIVE_SSE_STREAMING=1 開啟),它改善 SSE 模式混合內容類型(文字、function call、inline data)的順序保留與合併邏輯,並且延後執行 function call 到最終聚合事件,避免重複執行——但這只影響 SSE,對 BIDI 完全沒作用。
Day 21 講了 ADK Session 跟 Live API session 的差異。這裡還有一層更細的區分,是 Live API 內部的:
| Connection | Session | |
|---|---|---|
| 是什麼 | WebSocket 網路連線 | 邏輯上的對話上下文 |
| 範圍 | 傳輸層 | 應用層 |
| 能延續嗎 | 單一網路連線 | 可透過 resumption 橫跨多個連線 |
| 失敗影響 | 網路錯誤或逾時 | 對話歷史遺失 |
兩個平台的連線與 session 時長限制不一樣,而且這張表是你規劃長對話應用時必須先查的:
| 限制類型 | Gemini Live API(AI Studio) | Gemini Live API (Agent Platform) |
|---|---|---|
| 連線時長 | ~10 分鐘 | 未單獨記載 |
| Session 時長(純音訊) | 15 分鐘 | 10 分鐘 |
| Session 時長(音訊+視訊) | 2 分鐘 | 10 分鐘 |
| 併發 session | 50(Tier 1)/1,000(Tier 2+) | 最多 1,000 |
看到「音訊+視訊只有 2 分鐘」這行,你大概能理解為什麼 Day 21 的視訊 demo 用起來讓人有點緊張——不開額外設定的話,你真的沒多少時間。
WebSocket 連線大約 10 分鐘就會自動關閉,這是 Live API 平台層的行為,不是 bug。要撐過這個限制,靠的是 Session Resumption——Live API 會產生「resumption handle」,讓你能接回同一個 session 上下文,對話歷史與狀態不丟失。
開啟它只要一行:
from google.genai import types
# RunConfig/StreamingMode 沿用上面已經 import 的那份

run_config = RunConfig(
    session_resumption=types.SessionResumptionConfig()
)
背後 ADK 做的事情比這一行看起來多得多:整個過程中 Live API 會持續送 session_resumption_update 訊息,帶著最新的 handle,ADK 自動把它快取在 InvocationContext.live_session_resumption_handle;當 WebSocket 因為 10 分鐘限制而優雅關閉時(不會拋出例外),ADK 內部迴圈偵測到關閉,自動用剛剛快取的 handle 重新連線,對話從原本的位置無縫接續。你的應用程式碼完全不用寫任何重連邏輯——唯一你要負責的,是你的客戶端到你伺服器那段連線的重連,ADK 只負責它跟 Live API 之間那段。
官方的建議很直接:正式環境預設開啟 session resumption,除非你有明確理由不開——短於 10 分鐘的一次性互動、無狀態的請求-回應場景、開發除錯階段可以不開,其餘情況都該開。
Session resumption 解決連線斷線的問題,但它沒解決另一個限制——session 時長上限(音訊 15 分鐘、音訊+視訊 2 分鐘,或 Agent Platform 統一 10 分鐘)跟token 上限(native audio 模型大約 128k tokens)。真的很長的客服對話、家教陪聊,遲早會撞到其中一個牆。
Context Window Compression 同時解決兩個問題:用 sliding window 方式,當 token 數超過 trigger_tokens 門檻,自動壓縮或摘要較早的對話歷史,只保留最近 target_tokens 的完整細節。關鍵效果是開啟它之後,session 時長限制直接變成無限——不只是延長,是移除那個 15 分鐘/2 分鐘/10 分鐘的上限。
# RunConfig 與 types 沿用前面已經 import 的那份(from google.genai import types)

run_config = RunConfig(
    context_window_compression=types.ContextWindowCompressionConfig(
        trigger_tokens=100000,  # 128k context 的 ~78%
        sliding_window=types.SlidingWindow(
            target_tokens=80000  # 壓縮到 ~62%,保留近期對話
        )
    )
)
官方給的參數選擇邏輯:trigger_tokens 設在 model context window 的 70–80%,留緩衝讓當前這輪對話講完再壓縮;target_tokens 設在 60–70%,壓縮後留出足夠空間撐好幾輪對話才需要再次壓縮。長篇技術討論的場景可以調鬆一點(70% trigger / 50% target),短問答場景可以調緊一點(85% trigger / 70% target)。
代價很直白:壓縮意味著早期對話的細節會逐漸模糊,模型看到的是摘要而非逐字歷史。如果你的應用需要精確回溯早期對話內容(比如法律諮詢要引用使用者三十分鐘前講的原話),壓縮可能不是你要的東西——這時該考慮的是縮短單次 session 長度,而不是硬開壓縮。
正式環境要接的不是一個使用者,是很多個。兩個平台的配額邏輯完全不同:
Gemini Live API(依 tier 分級):Free tier 配額很低且未公開明確數字;Tier 1 是 50 個併發 session、400 萬 TPM;Tier 2/3 是 1,000 個併發、1,000 萬 TPM。
Gemini Live API (Agent Platform)(依專案分級):每分鐘最多建立 10 個併發連線,但總併發 session 上限可達 1,000 個(可申請提高)。
面對配額限制,官方給了兩種架構選擇:
選錯架構的後果很現實:用 Direct Mapping 撐一個公開的正式服務,尖峰時間新使用者會直接連線失敗,而不是「稍等一下」的體驗。
max_llm_calls——這個參數官方文件用粗體特別強調一個地雷:它對 run_live() 搭配 StreamingMode.BIDI 完全不生效。這個上限只保護 SSE 模式跟 run_async() 流程。如果你以為設了 max_llm_calls=500 就能防止語音 session 失控燒錢,你是錯的——BIDI 串流需要你自己實作 session 時長限制、輪次計數、或應用層的斷路器。
save_live_blob——把音訊(目前只有音訊)持久化到 SessionService 與 ArtifactService,用於除錯、法規遵循(醫療、金融業的稽核軌跡)、品質監控。16kHz PCM 音訊輸入大約每分鐘 1.92 MB,長期開啟會累積可觀的儲存成本,建議只在真的需要時開,並搭配保留政策自動清理舊音檔。這個參數以前叫 save_live_audio,ADK 會自動遷移但會發出棄用警告,建議直接改用新名字。
custom_metadata——把任意 key-value 附加到這次 invocation 產生的每個 Event 上,存進 session,可用來做使用者分群、A/B 測試標記、合規追蹤。多 agent 情境下,A2A 請求的 metadata 也會自動映射進這個欄位。
support_cfcsupport_cfc=True 開啟 Compositional Function Calling——讓模型可以並行呼叫多個獨立工具、把一個工具的輸出串成另一個工具的輸入、或依中間結果條件式地執行工具。有個容易讓人意外的行為:只要開了 support_cfc,不管你 streaming_mode 設成什麼,ADK 內部都會強制走 Live API,因為只有 Live API 後端支援 CFC。它只支援 gemini-2.x 模型(ADK 會在 session 初始化時驗證模型名稱是否以 gemini-2 開頭),且會自動注入 BuiltInCodeExecutor。標記為 Experimental,行為可能改變。
前面都在講「怎麼撐住連線」,現在換個方向——怎麼讓工具主動把中間結果推給 agent,而不是等 agent 問完才回答一次。這只在 ADK Gemini Live API 裡才有意義,目前仍是 Experimental 功能。
定義一個 streaming tool 要滿足兩個條件:必須是 async 函式,而且回傳型別要標成 AsyncGenerator。支援兩種:簡單型(吃非影像/音訊的輸入流)跟影像串流型(用保留參數 input_stream: LiveRequestQueue 接收視訊流)。
以下是官方範例改編的最小可執行版本,先聚焦在股價監控這個簡單型工具,加上讓模型能停止串流工具的 stop_streaming:
import asyncio
from typing import AsyncGenerator

from google.adk.agents.llm_agent import Agent
from google.adk.tools.function_tool import FunctionTool


async def monitor_stock_price(stock_symbol: str) -> AsyncGenerator[str, None]:
  """This function will monitor the price for the given stock_symbol in a continuous, streaming and asynchronously way."""
  print(f"Start monitor stock price for {stock_symbol}!")

  # Let's mock stock price change.
  await asyncio.sleep(4)
  price_alert1 = f"the price for {stock_symbol} is 300"
  yield price_alert1
  print(price_alert1)

  await asyncio.sleep(4)
  price_alert1 = f"the price for {stock_symbol} is 400"
  yield price_alert1
  print(price_alert1)


# Use this exact function to help ADK stop your streaming tools when requested.
def stop_streaming(function_name: str):
  """Stop the streaming

  Args:
    function_name: The name of the streaming function to stop.
  """
  pass


root_agent = Agent(
    model="gemini-flash-latest",
    name="stock_streaming_agent",
    instruction="""
      You are a monitoring agent. You can do stock price monitoring
      using the provided tools/functions.
      Don't ask too many questions. Don't be too talkative.
    """,
    tools=[
        monitor_stock_price,
        FunctionTool(stop_streaming),
    ]
)
這個版本拿掉了官方原範例裡的 monitor_video_stream(影像人數監控)——它還牽涉到讀取 LiveRequestQueue、丟棄過期影格、呼叫模型分析畫面等額外邏輯,篇幅上不適合塞進這個最小範例,完整寫法可以直接看官方文件:Streaming Tools。
幾個容易漏掉的規則:你必須提供一個叫 stop_streaming(function_name: str) 的函式當工具,讓模型能明確要求停止某個正在跑的 streaming tool——這不是隨便取名字就好,官方指定了這個確切的簽章。而 streaming tool 的生命週期是:模型呼叫它 → ADK 啟動你的 async generator → 你持續 yield 結果 → 直到模型呼叫 stop_streaming、session 結束、或發生錯誤,ADK 才會取消這個 generator task。
官方範例裡的影像串流版本(monitor_video_stream)展示了一個實用模式:用 while input_stream._queue.qsize() != 0 把佇列裡累積的舊畫面清空,只處理最新一張,避免處理落後的影格造成回應延遲——這是處理視訊串流時很常見的「丟棄過期資料」策略。
今天把 RunConfig 拆成了五塊:回應模式與協定選擇、connection/session 的時長限制、resumption 怎麼自動重連、context window compression 怎麼換來無限時長、以及配額規劃的兩種架構。加上 streaming tools 讓工具主動推送變化。明天要往音訊本身的細節走——PCM 格式、Native Audio 跟 Half-Cascade 兩種模型架構的取捨、VAD 怎麼運作,以及一個多 agent 情境下你關不掉的自動行為。
Google ADK 官方網站
GitHub - Agent Development Kit (ADK) 2.0
GitHub 開源實作:https://github.com/SeanLinH/adk_tutor


 iThome鐵人賽
 看影片追技術