
摘要
這篇文章介紹 ChatGPT Work 中 GPT-5.6 Sol、Terra、Luna 的定位差異,以及「輕度」到「極高」推理強度各自代表什麼。文章的核心觀點是:模型選擇與推理強度是兩個不同維度,模型決定處理方式,推理強度則決定這項任務要投入多少思考。與其把 Sol、Terra、Luna 理解成單純的強、中、弱,更實用的做法是依照任務的資料量、複雜度與推理需求來選擇。實測同一份公開聲明後也發現,在任務不算複雜時,Sol 與 Luna 的輸出差距未必像想像中明顯。因此使用 ChatGPT Work 時,重點不是每次都選最強模型、最高推理,而是讓模型與推理設定和工作本身相稱。
大部分人打開 ChatGPT Work,應該都是輸入問題、按下送出,然後等答案。
但你可能沒有注意過,同樣是 ChatGPT Work,背後其實還能決定兩件事:要讓哪一種模型來處理,以及這個問題值得讓它想多久。這兩個設定平常很容易被忽略,卻會直接影響一項工作的處理方式。有些任務只需要快速整理,有些需要同時處理很多條件,也有些值得讓模型多花一點時間反覆推敲。
所以這篇我想往 ChatGPT Work 裡面再挖一層:看看 Sol、Terra、Luna 到底差在哪裡,以及「輕度」到「極高」這些推理設定,實際上是在調整什麼。
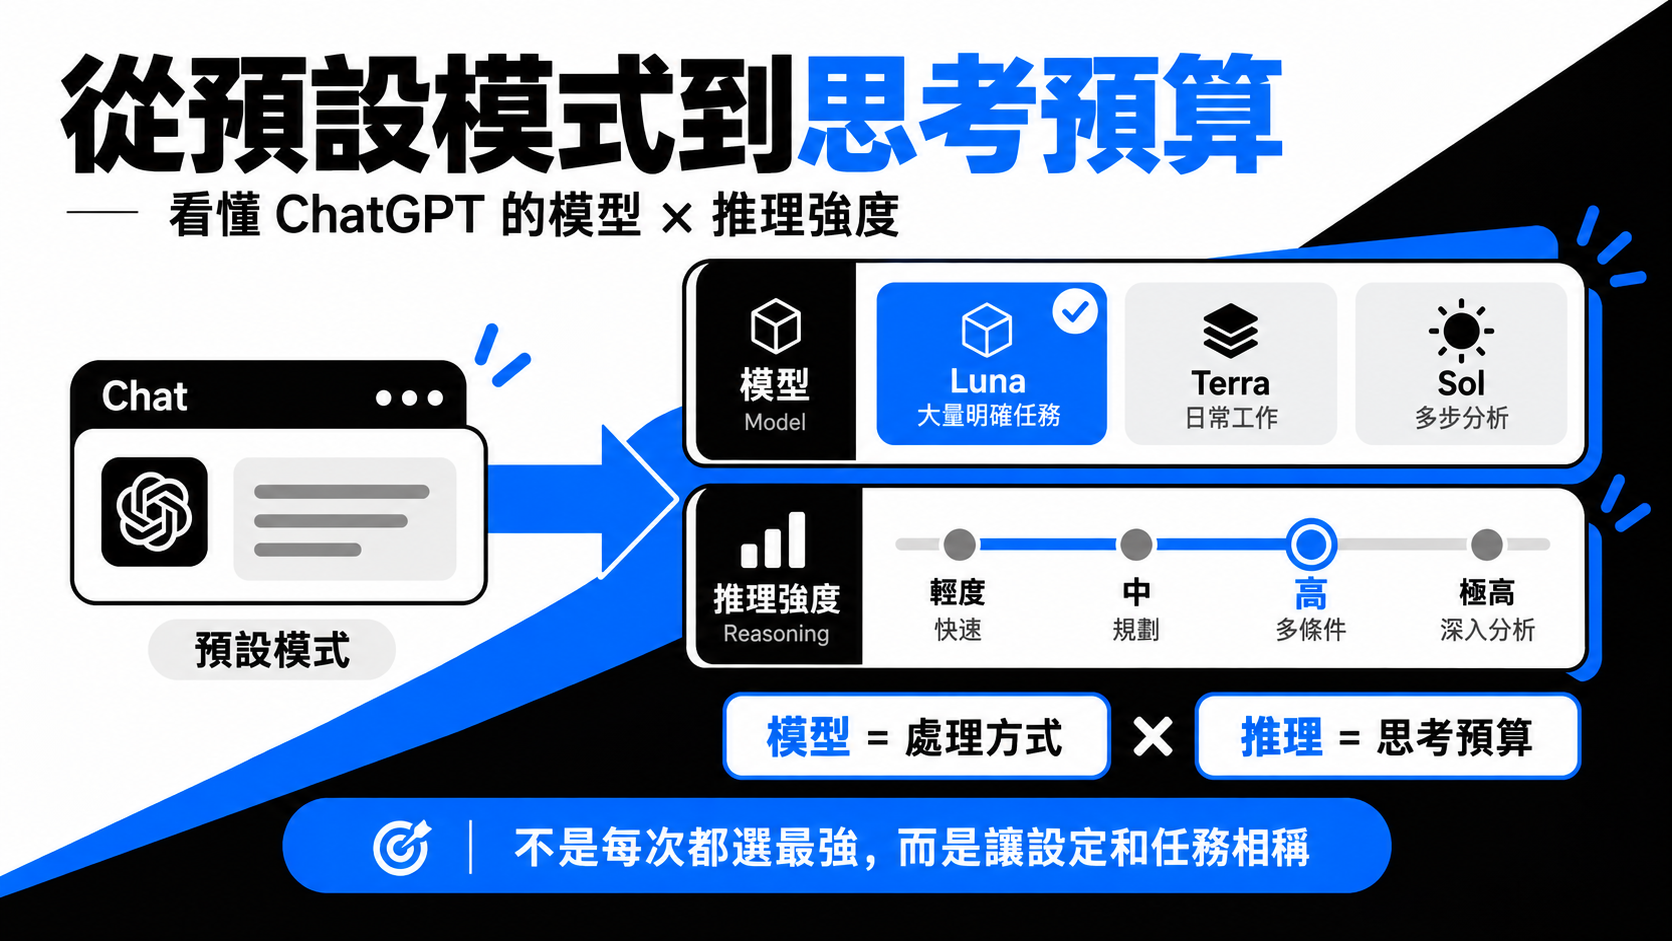
Sol、Terra、Luna 都是為工作情境設計的 GPT-5.6 模型;差別不只是誰比較強,端看你更在意 推理能力、整體平衡,還是大量處理的效率與成本。
第一次看到 Sol、Terra、Luna,很容易直接理解成「強、中、弱」。但拿來工作時,我覺得更實用的方式是看任務本身。假設今天有 500 筆客服留言,要分類、抓關鍵字,再整理成固定格式。規則已經很清楚,重點是快速、穩定地大量處理,這類工作比較接近 Luna 的定位。平常整理文件、改寫文章、分析資料這類日常知識工作,可以先從 Terra 思考;如果任務同時牽涉多份資料、彼此衝突的條件,還需要進一步分析與整合,再考慮 Sol。
所以我現在會先把三個模型記成這樣:
| 模型 | 我會怎麼記 | 適合的工作 |
|---|---|---|
| Luna | 快速處理大量明確任務 | 分類、擷取、監控、固定格式工作 |
| Terra | 日常工作的主力 | 寫作、整理、分析、一般問題解決 |
| Sol | 留給需要多想幾步的工作 | 研究、策略、多來源分析、重要決策 |
模型選好之後,還有另一個設定:要讓它在這個問題上投入多少推理。
可以先把推理強度理解成一筆「思考預算」。需求明確的任務不一定需要花很多時間推敲;當問題開始出現多個限制、需要比較不同方案,或前面的判斷會影響後續結果時,提高推理強度才比較有意義。所以比起記住每個名稱,更重要的是知道:什麼樣的工作,值得往上加一格?
先不要把推理強度理解成「越高越好」,比較實用的判斷方式,是看任務需要處理多少條件與推理步驟:
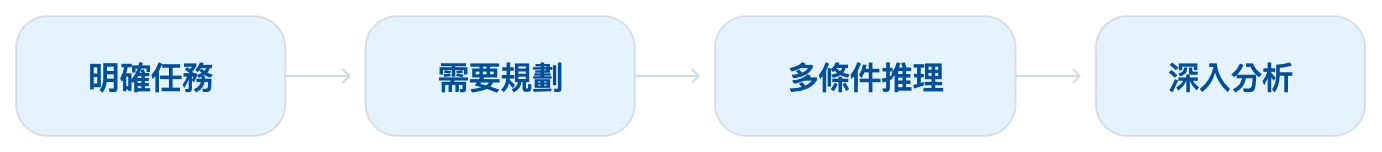
| 推理設定 | 可以先這樣理解 | 適合的工作 |
|---|---|---|
| 輕度 | 快速處理 | 改寫、摘要、擷取資訊 |
| 中 | 加入規劃 | 比較、分析、寫作、一般規劃 |
| 高 | 處理多個條件 | 行程規劃、文件比較、複雜問題 |
| 極高 | 深入分析 | 研究、多來源分析、需要仔細驗證的任務 |
重點不是每次都把設定往上拉,而是讓投入的推理程度和任務本身相稱。
前面講了模型定位和推理強度,但只看說明還是很難知道,實際用起來到底差多少。
所以我拿了一份公開聲明來測試,請 ChatGPT 假設自己是一位新聞傳播系老師,從「誰在說、證據能支持到哪裡、哪些地方容易產生過度推論」這幾個角度,整理出學生可以學到的媒體識讀原則。
這次我先把推理強度固定在 輕度,只更換模型:一次使用 GPT-5.6 Sol,一次使用 GPT-5.6 Luna。Prompt 和原始資料都相同,看看換模型之後,閱讀方式會不會跟著改變。
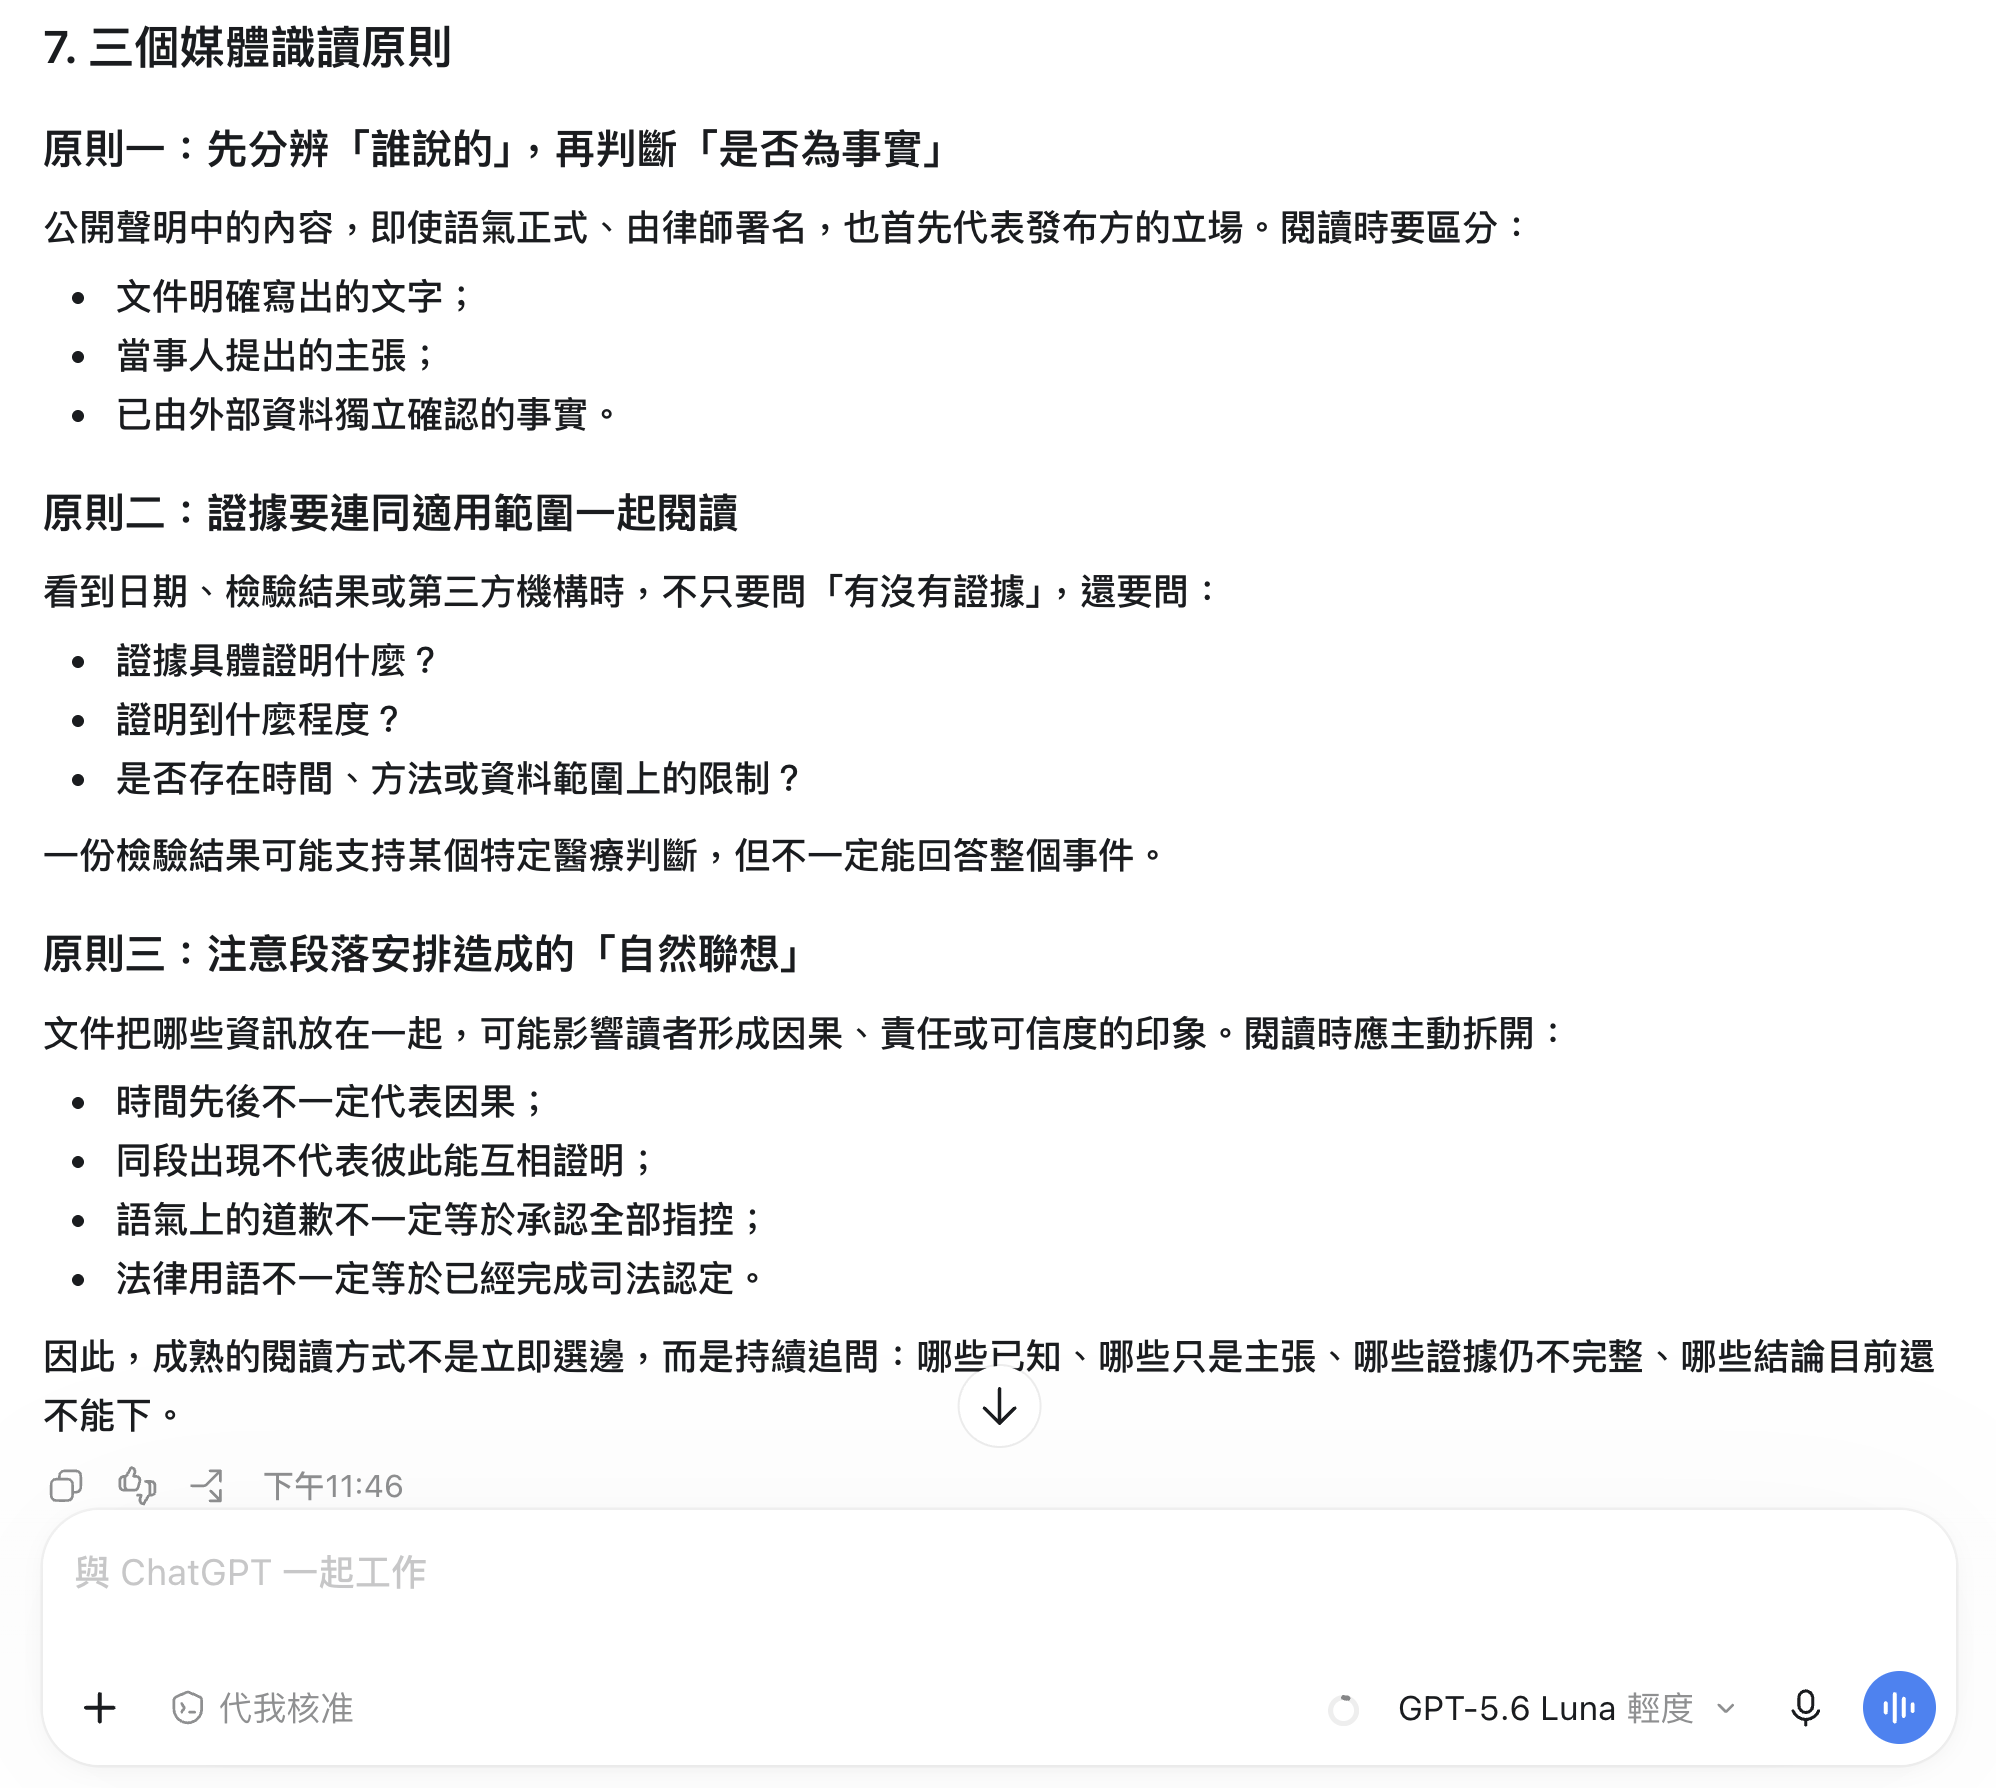
〔截圖 1:Luna 模型分析結果〕
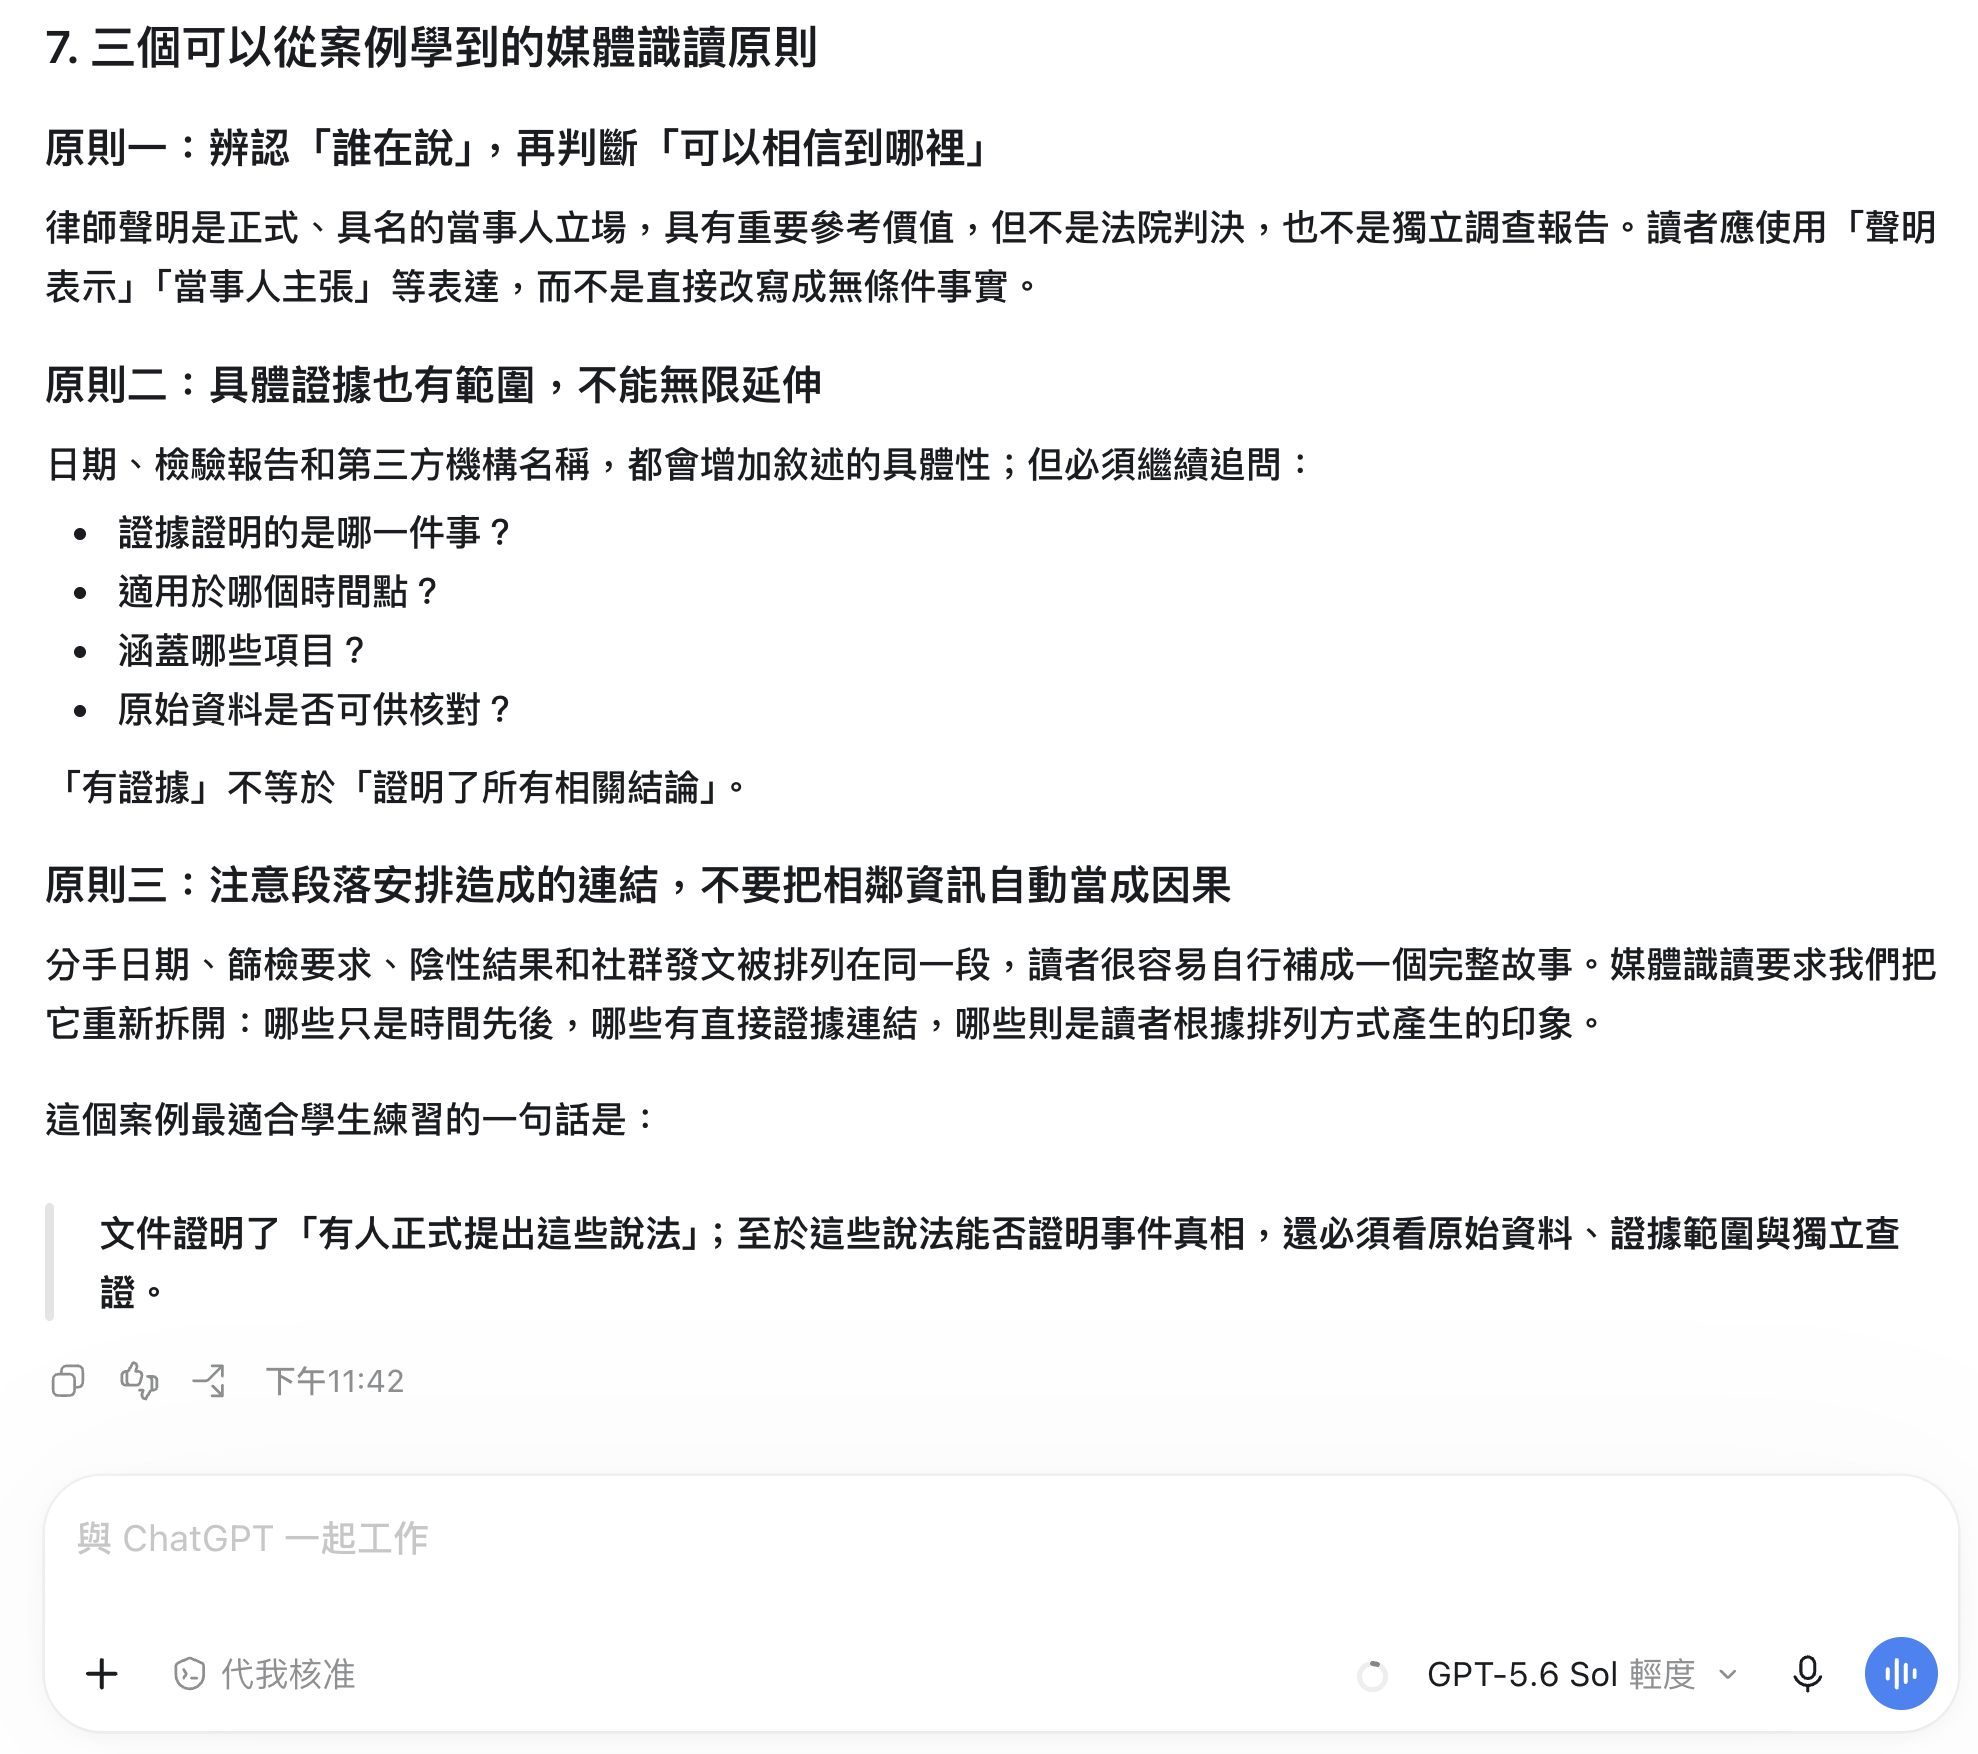
〔截圖 2:sol 模型分析結果〕
實際跑完後,我反而覺得兩者的差距沒有想像中大。
Sol 的回答比較像編輯帶著讀者拆文件。它從「誰在說、可以相信到哪裡」開始,再往下談證據範圍,以及段落排列可能造成的因果聯想,整體閱讀感比較偏向判讀與分析。
Luna 則比較像整理好的課堂講義。它把「文件內容、當事人主張、外部確認」切得很清楚,也主動提醒像是「道歉不等於承認所有指控」、「法律用語不代表已經完成司法認定」這類閱讀界線。
就這次案例來看,Sol 的體感偏向整體判讀,Luna 偏向規則化整理,但兩者都抓到了事實與主張、證據邊界、段落暗示這三個核心。這也讓我比較意外:當任務本身還不算太複雜時,換模型帶來的差距,可能沒有想像中那麼明顯。
💡 補充:完整分析提示詞
我會把這次使用的版本放在 GitHub Repo,方便想實際測試的人直接取用,再依自己的工作方式修改。
看完這篇,可以先把模型和推理強度理解成兩個不同的工作設定:模型決定處理方式,推理強度決定投入多少思考資源。這次實測也可以看到,在相對單純的任務裡,不同模型的差距未必會非常明顯。真正有用的是開始根據工作的複雜程度,選擇適合的模型與推理強度。
模型和推理強度是兩個不同的選擇,而且不是每一次都需要把兩者拉到最高。
本篇內文示範用提示詞都在比賽用專案中,記得隨時關注比賽用專案


 iThome鐵人賽
 看影片追技術