

昨天聊了 taxonomy(分類體系)的設計,也提到分類定義好之後,它會成為 UI、SEO 與 AI 資料增補共用的一份契約。但分類樹再完整,品牌清單、商品資料庫與搜尋結果都不會自己出現。
所以今天要接著回答兩個問題:這些資料要怎麼系統性地取得?在流程裡,哪些工作適合交給 Agent,哪些邊界應該由程式掌握?
今天先談設計原則與取捨。明天再把這些原則對應到專案實際採用的七步驟流程。
查閱常見的架構做法時,Anthropic 的〈Building effective agents〉提供了一個很有用的區分:workflow 由程式預先定義路徑;Agent 則由模型動態決定步驟與工具使用。 需要模型,不代表整段流程都必須成為 Agent;固定步驟裡的 LLM 呼叫,也可以組成一條 workflow。
OpenAI 的〈A practical guide to building agents〉則建議從簡單設計逐步擴充,避免過早引入多 Agent 的複雜度,並為執行設定明確的退出條件,例如完成輸出、發生錯誤或達到回合上限。
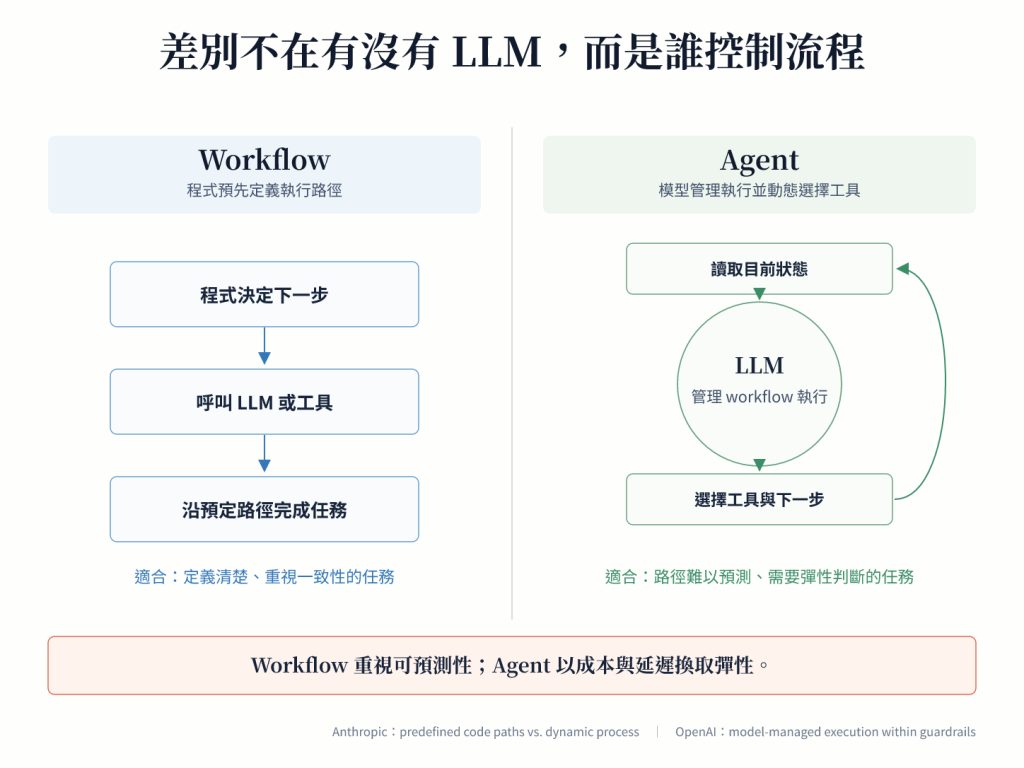
這些指南沒有規定資料獲取該拆成幾個模組,但提供了一個設計起點:
已知路徑用 workflow;需要動態決策時才放入 Agent,再為它定義清楚的邊界。
這也是我重新設計資料流程時採用的出發點。不是先問「哪裡可以加 AI」,而是先確認哪些步驟已經知道怎麼做,以及哪些地方真的需要模型根據現場資訊決定下一步。
昨天我們已經用 taxonomy 定義了「一個產品是什麼」。接下來的問題是:第一筆資料要從哪裡來?
以一筆品牌資料為例,我們可能需要名稱、官網、分類、品牌描述與通路等資訊。這些內容卻散落在品牌官網、社群與通路頁面裡:有些藏在 HTML 或 JSON-LD,有些必須等 JavaScript 渲染後才能讀取,還有些根本沒有直接寫出我們需要的欄位。
如果從「一個外部來源,最後如何變成資料庫裡可用的一筆紀錄」往回拆,大致會經過六個階段:來源探索、內容取得、資料結構化、資料增補、品質驗證,以及合併寫入。
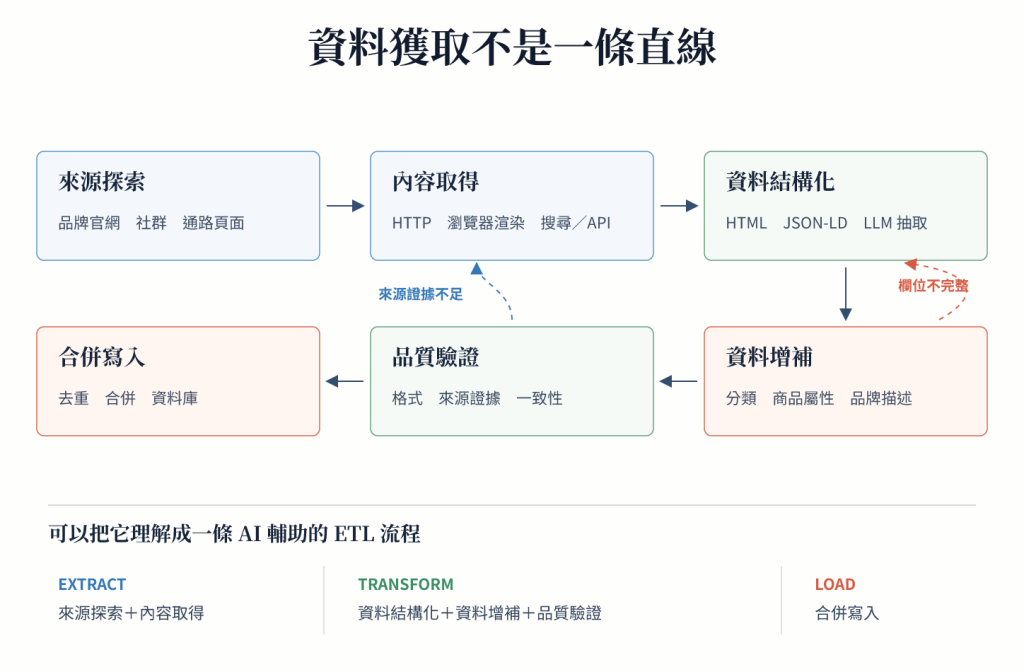
從資料工程的角度,可以把這整套系統理解成一條大型的 AI 輔助 ETL pipeline:
它和傳統 ETL 的方向相同:把分散的資料彙整、轉換,再寫入資料庫。不同的是,中間路徑不必針對每種網站事先寫死;Agent 可以在既定的工具與限制內,根據當下訊號選擇瀏覽器、API 或 LLM,驗證失敗時也可以回到前一步補充資料。
把六個階段攤開之後,會發現它們不只使用不同工具,連失敗的方式也不同:
如果這些工作都包在同一個大步驟裡,最後只會得到「整次執行失敗」,卻很難知道問題究竟出在哪裡。這也是為什麼我把模組化(modularization)納入架構設計:每個模組都是可以單獨觀察、測試與重跑的工作單位,有自己的輸入、輸出與完成條件,再由外層流程管理順序與依賴關係。
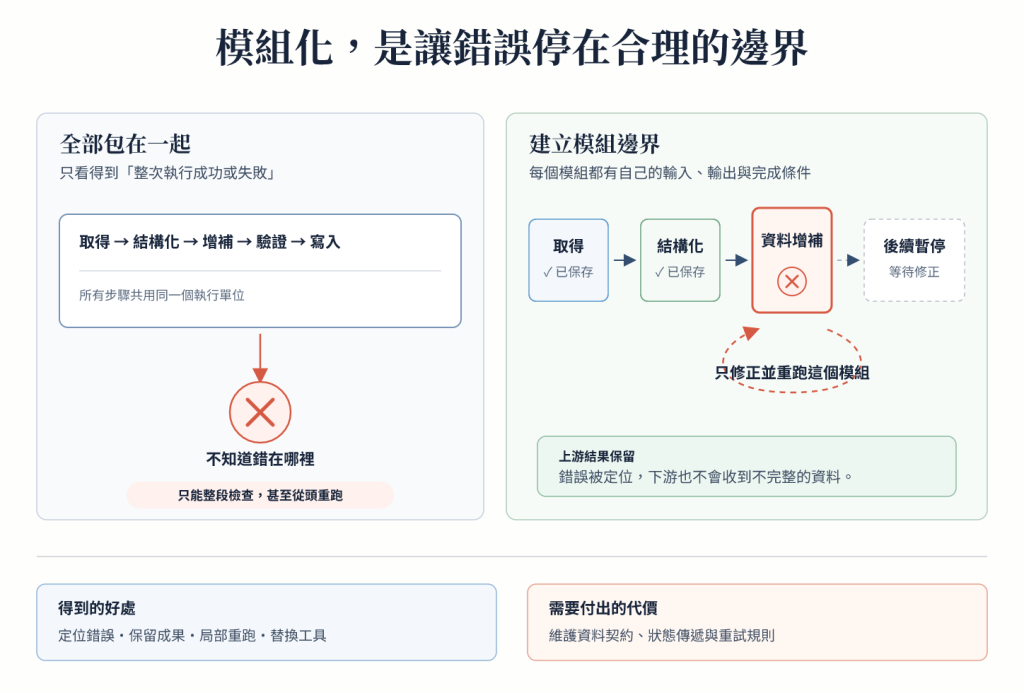
這樣做主要帶來三個好處:
但這份可控性不是免費的。每多切出一個模組,就多一組輸入與輸出契約需要維護,也多一個可能因 schema 不一致、狀態沒有正確傳遞,或重試條件互相衝突而失敗的接點。切得太細,流程會充滿資料傳遞與協調成本;切得太粗,錯誤又會重新混在一起,失去局部重跑的意義。真正困難的不是把流程拆開,而是找到一個能隔離失敗、又不讓協調成本超過收益的邊界。
模組化的目的不是增加步驟,而是讓錯誤停在合理的邊界,並保留已經成功取得的結果。
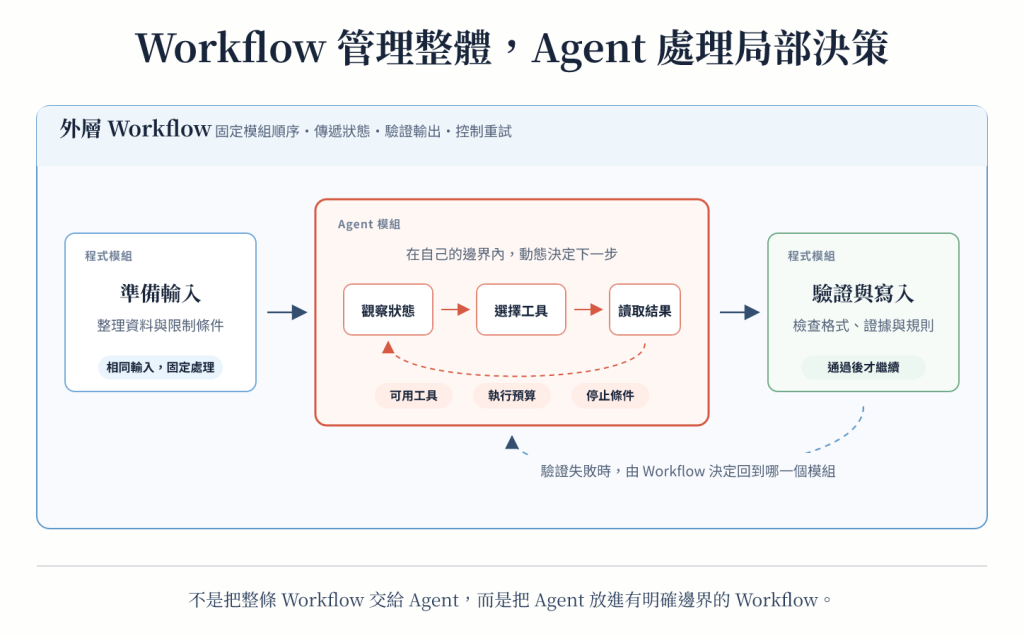
走到這裡,最後採用的不是「讓一個 Agent 包辦所有事情」,也不是「完全不用 Agent」,而是一條由程式控制的 workflow,在需要動態判斷的地方放入有明確邊界的 Agent 模組。
外層 workflow 負責決定資料要經過哪些模組、狀態如何傳遞、何時驗證,以及在什麼條件下繼續或停止。Agent 不接管整條流程,而是在既定的工具、預算與停止條件內,根據現場訊號決定下一步該怎麼做。
以品牌網站為例,程式很難事先寫死該讀哪個頁面、要使用靜態抓取還是瀏覽器渲染。這部分可以交給 Agent 判斷;抓取計畫確定之後,實際執行、格式驗證、去重與寫入則交回程式。驗證失敗時,也由外層 workflow 決定該停止、補救,還是回到特定模組重跑。
換句話說,Workflow 提供穩定的骨架,Agent 則補上局部情境需要的彈性。
Day 2 把產品問題拆成了資料、搜尋與探索,Day 3 則先定義資料應該長成什麼樣子。下一步,就是把這些需求真正落成一條資料獲取流程:從品牌網站取得內容、整理成可用欄位、補上分類與描述,再經過驗證後寫入資料庫。
明天我會沿著這個具體案例,展開專案目前採用的模組,說明每個模組負責什麼、哪些地方使用程式、LLM 或 Agent,以及資料如何從外部來源一路變成資料庫裡可以使用的紀錄。
我們明天見!


 iThome鐵人賽
 看影片追技術