

上一篇我們把一段自然語言進入搜尋系統後要處理的資訊分成兩種:
回到上一篇的例子:
想找一個適合露營用的隨行杯,最好是不鏽鋼、風格簡單。
「隨行杯」、「不鏽鋼」有機會轉成分類或材質篩選條件;「適合露營」、「風格簡單」則比較難直接對應到資料庫欄位,但仍然會影響哪些商品和需求比較接近。上一篇先提到 embedding 這條路徑,這一篇就繼續把它往下拆:
最簡單的理解方式,是把 embedding 想成一個把文字轉成數字表示的方法。輸入一段文字之後,embedding 模型不會回傳分類或答案,而是回傳一串數字,也就是一個向量(vector)。
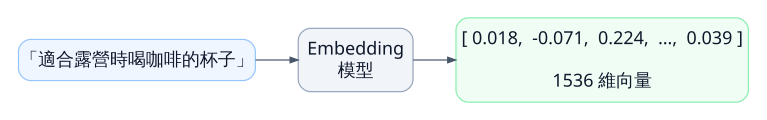
單看向量裡的某一個數字沒有任何意義,真正重要的是整個向量在空間中的相對位置:
如果 query 向量和商品向量越接近,兩者的語意通常也越接近。
回到前面的搜尋句「適合露營用的隨行杯」:假設某件商品描述的是「輕量、雙層真空、方便攜帶」,即使沒有直接寫出「露營」兩個字,兩段文字仍可能在 embedding 空間裡彼此接近;「手工陶瓷餐盤」或「皮革短夾」則會落在更遠的位置。
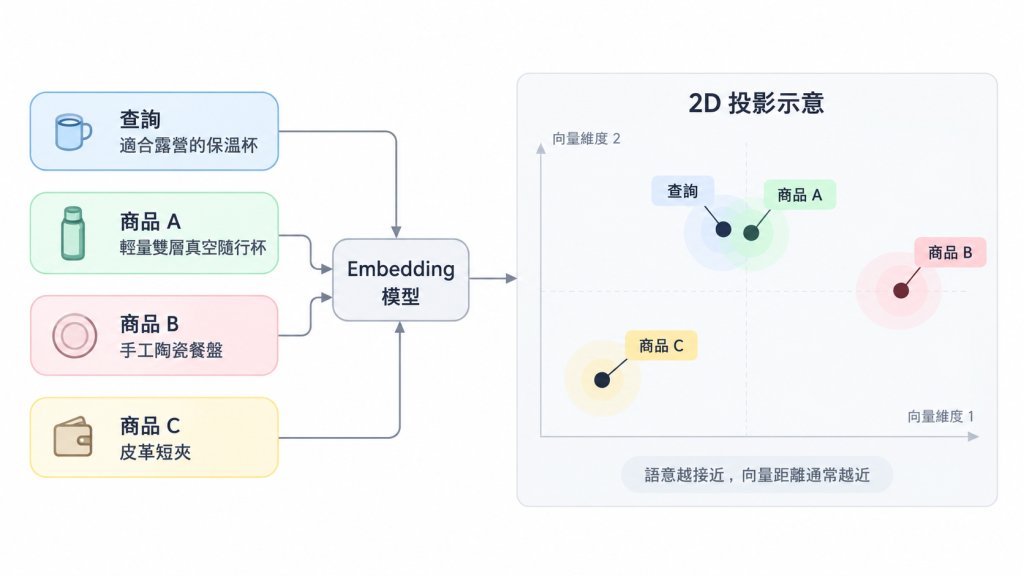
註:這張圖只是幫助理解高維空間的二維投影,實際的 embedding 通常有數百到數千個維度,而把高維資料壓成二維或三維後,視覺上的距離可能會失真,因此圖的用途是建立直覺,而不是精確還原模型內部的表示空間。
有了向量之後,還需要一套方法計算它們有多接近,常見的做法包括 cosine similarity、dot product 與 Euclidean distance 等。若用 similarity 的角度理解,就是 cosine similarity 越高,通常代表兩個向量越接近:
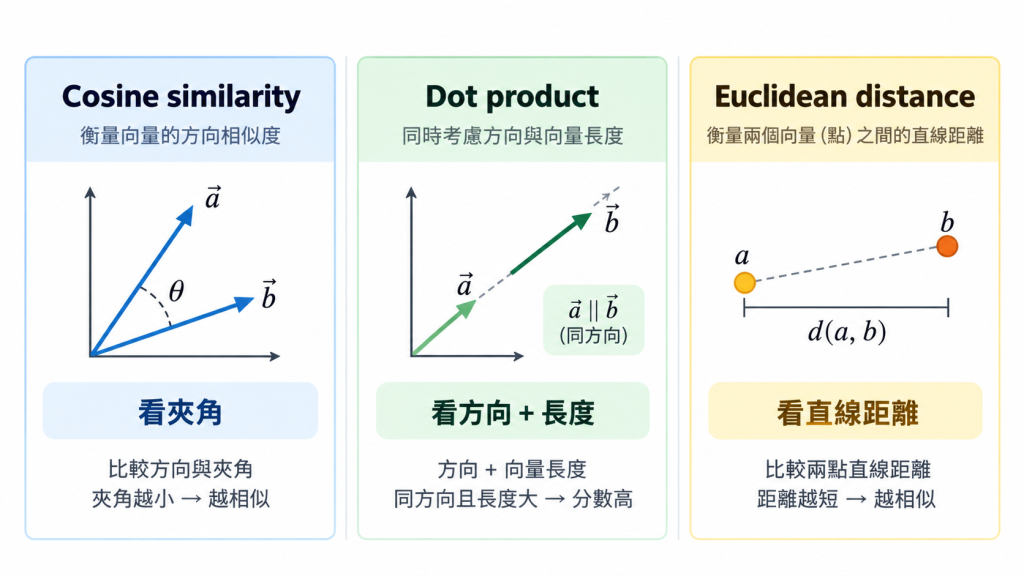
這也代表我們不需要替每個維度人工命名成「露營」、「簡約」或其他具體概念。embedding 模型會從訓練資料中學出一套高維表示,而搜尋系統真正使用的是不同向量之間的相對關係。有了可以比較的向量之後,我們就能利用向量距離做 vector retrieval(向量檢索),找出語意接近的商品。
商品端的 embedding 會事先計算並儲存;使用者每次輸入新的 query 時,系統再把這段文字轉成 query embedding,接著和商品向量比較,在向量空間裡找出距離最近的一批商品。這類搜尋通常稱為最近鄰搜尋(nearest-neighbor search)。
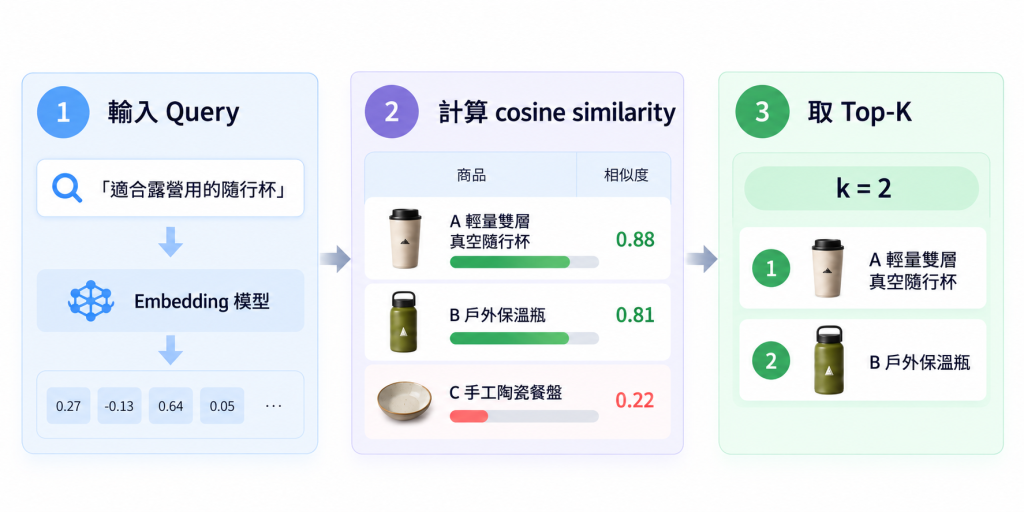
資料量小時,可以直接把 query 和所有商品逐一比較;資料量變大後,通常會用向量索引加速搜尋,不一定真的掃過每一筆資料,例如 pgvector 的 HNSW 向量索引 即屬於 approximate nearest neighbor(近似最近鄰)方法,在搜尋速度與 recall 之間做取捨,而不是每次都精確掃過全部向量。
// 示意,省略正式實作細節
for (const product of products) {
  product.embedding = embed(product.searchDocument);
}

const queryEmbedding = embed(query);

const candidates = nearestNeighbors(
  queryEmbedding,
  productEmbeddings,
);
Retrieval 這個階段的目的並不是直接整理出最終的搜尋結果,而是先從大量商品中把「可能相關」的候選盡量找回來。這一層更重視 Recall:寧可讓候選集合多帶一些雜訊,也不要太早漏掉真正相關的商品。最近鄰搜尋會依相似度產生排名,lexical retrieval 也會依詞彙分數產生排名;這些可以視為第一階段排序(first-stage ranking)。它們的首要任務仍然是候選生成(candidate generation),所以這個初始順序不一定就是最後最適合呈現給使用者的結果。
一件商品如果在 retrieval 階段就被漏掉,後面的排序再強也沒有機會把它救回來。因此這兩層的責任可以先這樣理解:retrieval 先把相關商品找進候選,並產生初始排序;下一篇再討論如何在同一批候選上重新排序,讓前排結果更符合使用者需求。
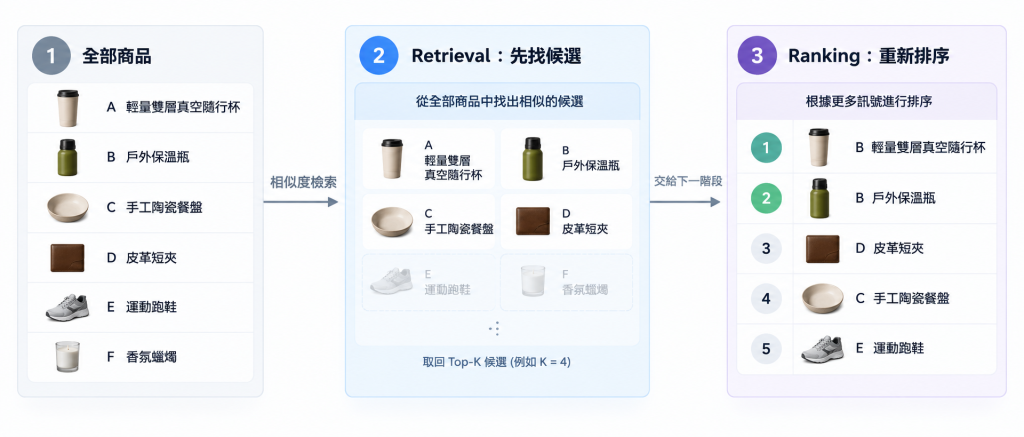
前面用 nearest-neighbor search 說明的就是向量檢索(vector retrieval);但商品搜尋還有另一條很重要的路徑:直接利用 query 裡實際出現的字詞來找候選,也就是詞彙檢索(lexical retrieval)。
如果只知道「哪些字有出現」還不夠,lexical retrieval 還需要替 query 與每份文件計算一個相關性分數。一個經典的起點是 TF-IDF(Term Frequency–Inverse Document Frequency)。它把字詞的重要性拆成兩個直覺:
例如 query 是「露營水壺」時,如果「水壺」在很多商品裡都會出現,而「露營」相對少見,那麼命中「露營」通常會提供更強的字面匹配訊號。
TF-IDF 很直觀,但直接使用 term frequency 也會帶來問題:同一個詞從出現 1 次增加到 2 次可能很有意義,但從 20 次增加到 21 次,通常不應該得到同樣幅度的加分;另外,較長的文件也更容易因為字比較多而命中 query。BM25 保留 IDF 的核心想法,並進一步加入 term-frequency saturation 與 document-length normalization:少見的詞比較重要、同一個詞重複出現有幫助但不會無限加分、文件長度需要被校正。
無論是 TF-IDF 或 BM25,本質上仍然在回答同一種問題:
使用者真的寫了什麼字?商品資料裡有沒有直接出現這些線索?
這也說明為什麼 lexical retrieval 和 vector retrieval 不是替代關係:
前面提到的兩種 retrieval 方式會各自產生一份候選清單:向量檢索依向量相似度得到自己的順序,詞彙檢索也會依 lexical score 得到另一個順序。接下來的問題是:怎麼把兩條 retrieval 路徑找回來的 candidates 合成同一個候選集合?
最直覺的做法可能是直接相加兩邊的分數,但兩個分數來自不同計算方式,數值尺度與分布沒有共同意義:0.8 的 cosine similarity(餘弦相似度),不能直接拿來和詞彙檢索分數的 0.8 當成同一件事。
我們可以使用 RRF(Reciprocal Rank Fusion) 做 retrieval 階段的融合(fusion):它不直接比較兩邊的原始分數,而是利用商品在兩份候選清單中的排名位置來計算融合分數。
假設商品 A 在 lexical 排第 1、vector 排第 3,它會同時得到兩條 retrieval 路徑的貢獻;商品 B 即使只在 vector 排第 1,也仍然會從 vector 這條路得到分數並留在候選集合裡。RRF 不只是把不同檢索方法找回來的結果合併成一份混合候選集合(hybrid candidate set),也會根據融合分數產生一個初始順序。只是這個順序仍然屬於 retrieval 階段的 first-stage ranking,還不是最後呈現給使用者的排序。
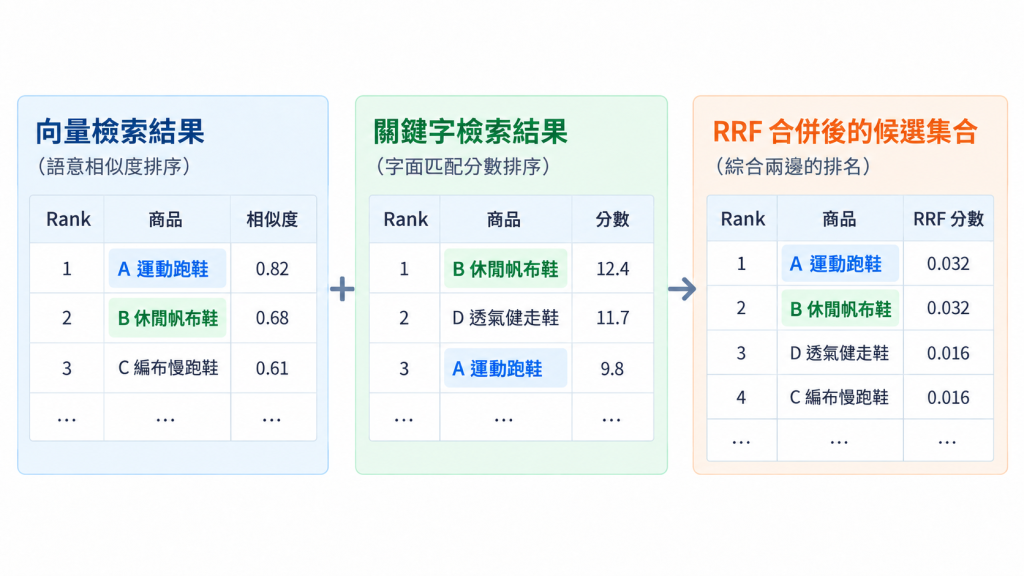
因此這裡的 Rank Fusion 雖然會產生順序,仍然是在 retrieval 階段利用各路徑的初始排名做融合。下一篇談的 Reranking(重新排序)則是在候選集合確定之後,再加入更多訊號,把同一批結果重新排一次。
搜尋系統的品質其實包含兩個不同問題:
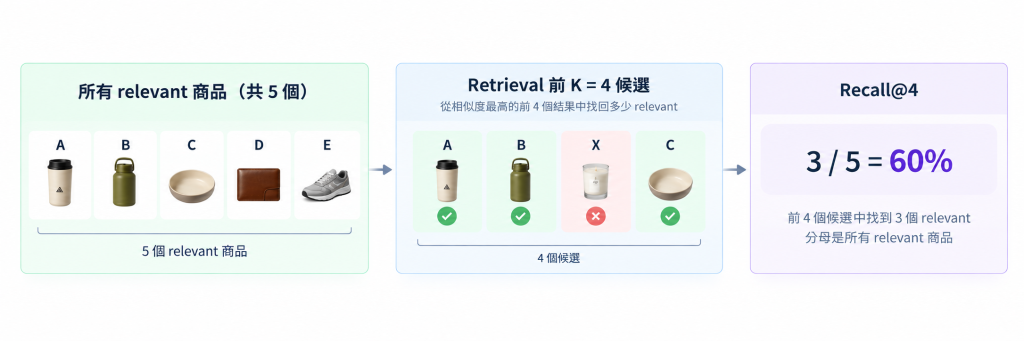
前者是 retrieval 這一層最重要的責任,後者則會是下一篇 ranking 的重點。在 retrieval 階段我們最常關注的指標是 Recall@K:只要真正相關的商品在這一步被漏掉,後面的 ranking 再強也沒有機會把它救回來。
這裡的 K 指的是 retrieval 階段保留多少個候選。以下圖為例,已知總共有 5 個 relevant 商品,而前 4 個候選中找回了 3 個,因此 Recall@4 = 3 / 5 = 60%。注意那個無關商品 X 本身不會直接降低 Recall;真正讓 Recall 降低的是 relevant 商品 D、E 沒有進入前 K 個候選。
所以這篇如果只聚焦 retrieval,本質上的取捨是:先提高 Recall@K,容許候選集合帶著一些雜訊;等相關商品都進入候選後,再交給 ranking 處理「誰應該排前面」的問題。
這一篇從 embedding 一路走到候選生成:vector retrieval 找語意接近的商品,lexical retrieval 保留精確字面訊號,再透過 RRF 把兩條路徑找回來的結果合成一份候選集合與初始順序。這一層最重要的問題,仍然是不要太早把相關的商品漏掉。
但有了初始排序,不代表這個順序已經夠好。某件很相關的商品可能已經進入候選集合,卻仍排在很後面;從 Recall 的角度它沒有被漏掉,對只看前幾筆結果的使用者來說卻仍然等於找不到。
所以接下來的問題不再只是「哪些商品要進候選」,而是:同一批候選已經有一個初始順序後,我們能不能用更多訊號把它再排得更好?
下一篇就從這個問題開始,介紹 Reranking(重新排序),以及 Learning to Rank 如何作為其中一種方法建立更好的第二階段排序。


 iThome鐵人賽
 看影片追技術