
產品上線後,商品介紹會持續修改,資料量也會增加。打造搜尋功能時,除了讓使用者找到商品,還得處理兩個問題:新版資訊多久能進入搜尋,以及資料變多後,查詢還能不能維持效率。
這篇先談資料新鮮度,沿著一次商品介紹的修改,看新版資訊如何進入搜尋;再談索引,說明資料準備好之後,如何減少候選查找的工作,以及加速需要付出的成本。
假設你下個月準備去露營,在一篇介紹台灣製不鏽鋼隨行杯的文章裡看到一件感興趣的商品。你想再比較其他適合戶外使用的款式,於是在搜尋框輸入「露營用的不鏽鋼杯」,卻沒看到文章裡那件杯子。你反覆地查看商品頁本身,明明網站上有提到「可帶去露營,適合戶外使用」,但為什麼搜尋頁面打上「露營用的不鏽鋼杯」卻找不到對應的商品呢?
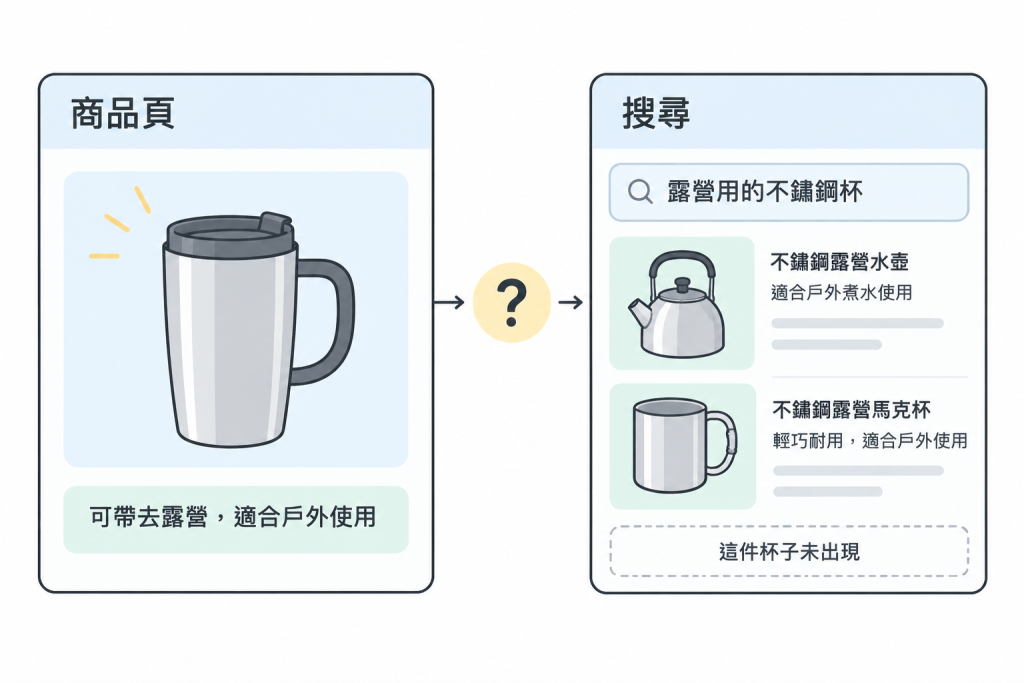
這個例子採用向量檢索:模型把查詢與商品介紹轉成一串數字,稱為向量,用來比較文字的語意是否相近。查詢向量在搜尋當下生成,商品向量則預先生成並保存。因此,商品頁已經改了,搜尋使用的商品向量卻可能仍來自舊版介紹;這是需要先查證的一個原因。
假設商品向量每小時更新一次,這次修改與搜尋的時間軸如下:
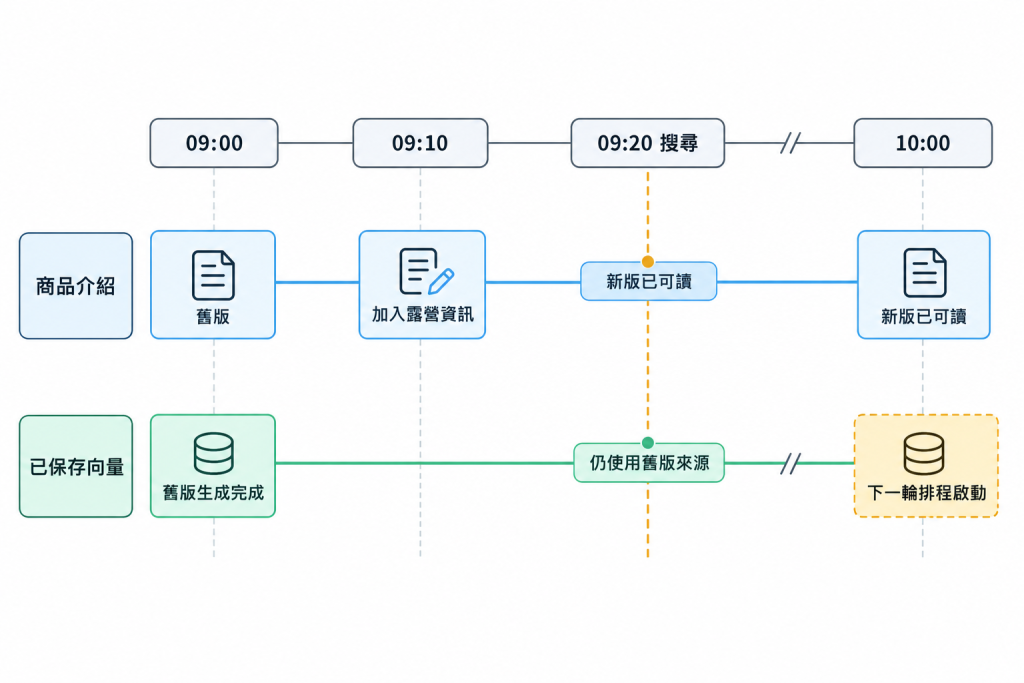
在這個例子裡,使用者於 09:20 搜尋時,商品介紹已經修改,但保存的向量仍來自 09:00 的舊版介紹。這段「來源已改,搜尋使用的資料尚未跟上」的落差,就是資料新鮮度(data freshness)要處理的問題。要知道新版資訊何時能進入搜尋,得先看它依賴哪些資料,以及更新需要經過哪些步驟。
一份商品向量可能同時使用商品介紹、品牌簡介與分類名稱。這些提供輸入的資料稱為上游(upstream);根據它們組裝的文件與生成的向量,就是下游(downstream)。任一輸入改變,都要確認依賴它的下游是否需要更新。例如品牌簡介改了就得同時檢查使用這份簡介的商品向量,而不只是品牌頁本身。
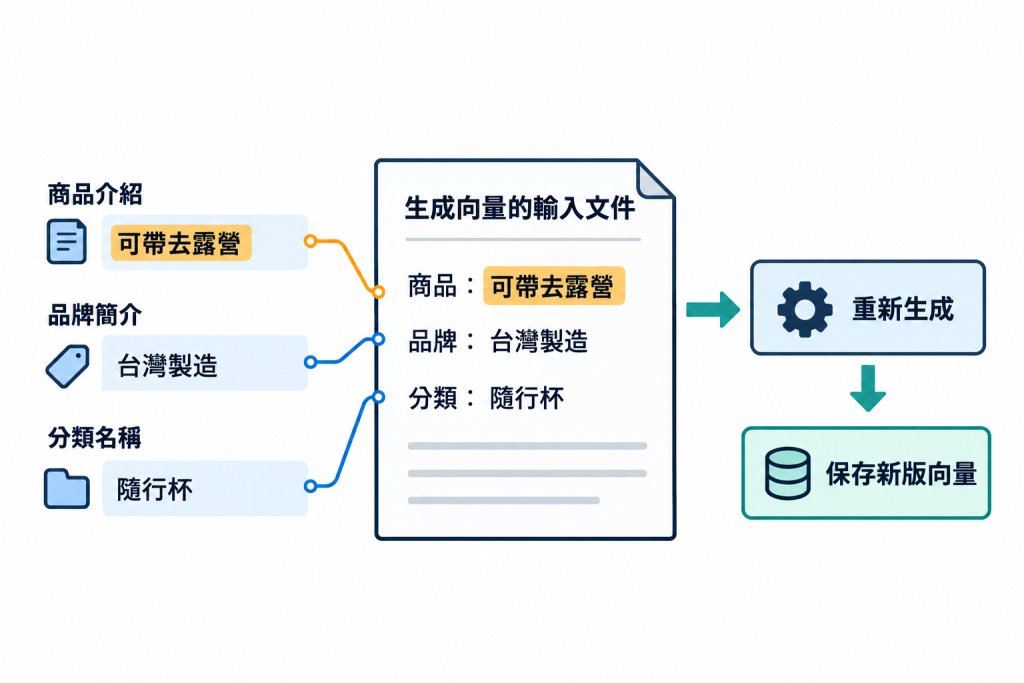
回到這件杯子,露營資訊必須先進入組裝後的文件,再用這一版文件重新生成並保存向量,搜尋才能使用新版資訊。只修改商品介紹,不會讓已保存的向量自動改變。等待排程、排隊、生成向量與寫入都需要時間,所以 10:00 啟動更新,不代表新版向量在 10:00 就能被搜尋使用。新版向量成功寫入搜尋使用的資料後,這次更新才算跟上來源;至於杯子是否出現在結果裡,還取決於查找範圍、篩選條件與排序。
要避免每一輪都重做所有商品,可以比較來源內容雜湊(source hash)。雜湊可視為內容的指紋:把目前輸入文件的雜湊,與上次生成向量時保存的值比較,就能找出內容有變動的商品,只針對這些商品重新生成向量。以下假設使用同一個嵌入模型;更換模型時,即使內容相同,也要重新生成對應的向量。
import { createHash } from "node:crypto";

function sourceHash(document: string): string {
  return createHash("sha256").update(document, "utf8").digest("hex");
}

// 上次生成向量時使用的文件
const previousDocument = [
  "不鏽鋼隨行杯",
  "適合外出攜帶。",
].join("\n");
// 來源更新後組裝的文件
const currentDocument = [
  "不鏽鋼隨行杯",
  "可帶去露營,適合戶外使用。",
].join("\n");

const savedHash = sourceHash(previousDocument);
const currentHash = sourceHash(currentDocument);

console.log(savedHash !== currentHash); // true:需要重新生成向量
新鮮度檢查(freshness check)是把更新的容許時間寫成規則,超時就回報。以定期匯入商品資料為例,資料工具 dbt 的來源新鮮度檢查會根據來源表最新的載入時間,判斷距離上次收到資料過了多久。
version: 2
sources:
  - name: catalog_import
    schema: raw
    config:
      loaded_at_field: _loaded_at # 匯入流程寫入的載入時間
      freshness:
        warn_after: {count: 90, period: minute} # 超過 90 分鐘,回報警告
        error_after: {count: 120, period: minute} # 超過 120 分鐘,回報錯誤
    tables:
      - name: products
# dbt 2.x:檢查商品來源表是否按時收到資料
dbt freshness --select "source:catalog_import.products"
但來源表有收到新資料,不代表這件杯子的向量已更新。回到前面的例子,還要比對目前輸入文件與生成向量時保存的雜湊,並記錄來源修改到新版向量可被搜尋使用的耗時,才能檢查下游是否也在容許時間內完成。
假設前面的新版向量已經可以被搜尋使用,接下來要處理的是查找效率。檢索(retrieval)就是根據使用者的查詢,從商品資料裡找出候選。商品越多,若每次都逐筆比對文字或計算向量距離,需要做的工作也越多。索引(index)是預先建立的查找結構,讓搜尋減少逐筆掃描的工作。
以「露營用的不鏽鋼杯」為例:
要加速這兩條路徑,可以分別建立文字索引與向量索引,減少詞彙比對與向量距離查找的工作。
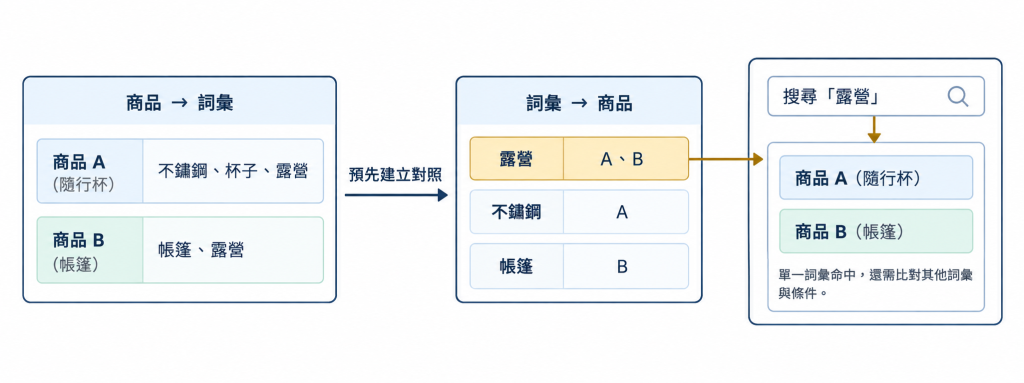
如果每次搜尋「露營」都要逐筆讀取商品名稱與介紹,商品越多要檢查的文字也越多。文字索引會先把這些內容整理成詞彙,再建立詞彙與商品的對照。以下圖為例,如果索引只收錄名稱,透過這份索引就查不到介紹裡新增的「露營」;把介紹也納入,才能利用索引查到這個詞。
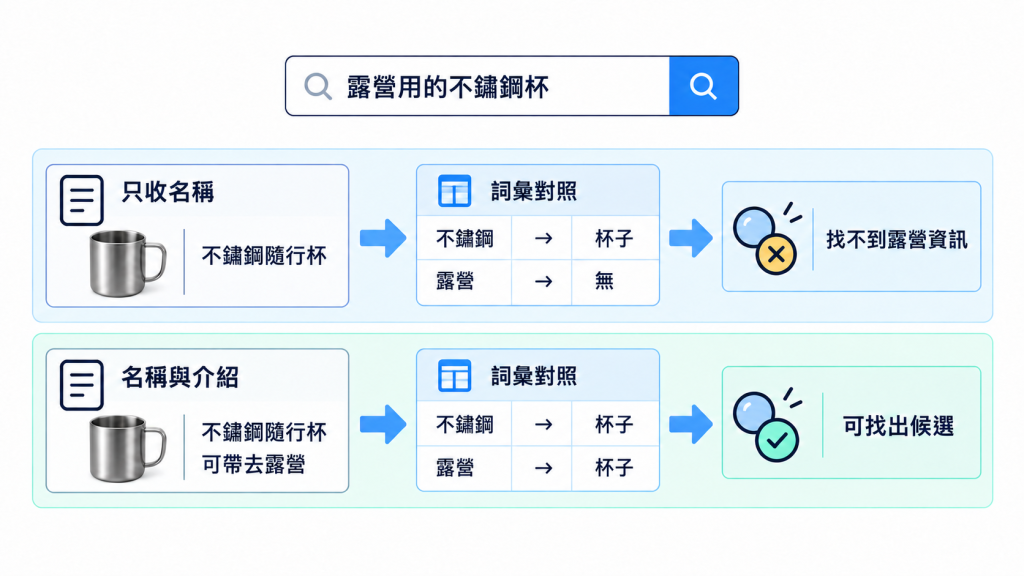
倒排索引(inverted index)就是建立文字索引的一種方式:原本的資料是「每件商品包含哪些詞彙」,倒排索引把方向反過來,保存「每個詞彙出現在哪些商品」。系統會從納入的欄位整理詞彙並建立對照,不需要為「露營」手動建立一個專用索引。搜尋「露營」時,就能先查出對應的商品,再比對其他詞彙與條件。這條路徑比對的是文字詞彙,與下面的向量距離查找不同。
在向量檢索的方向我們同樣也可以做索引:HNSW(Hierarchical Navigable Small World)會預先把商品向量連成多層圖,每個節點代表一個商品向量,連結讓查找可以移動到其他節點。上層只保留部分節點,方便快速移動;最底層包含所有節點,供查找進一步比較。
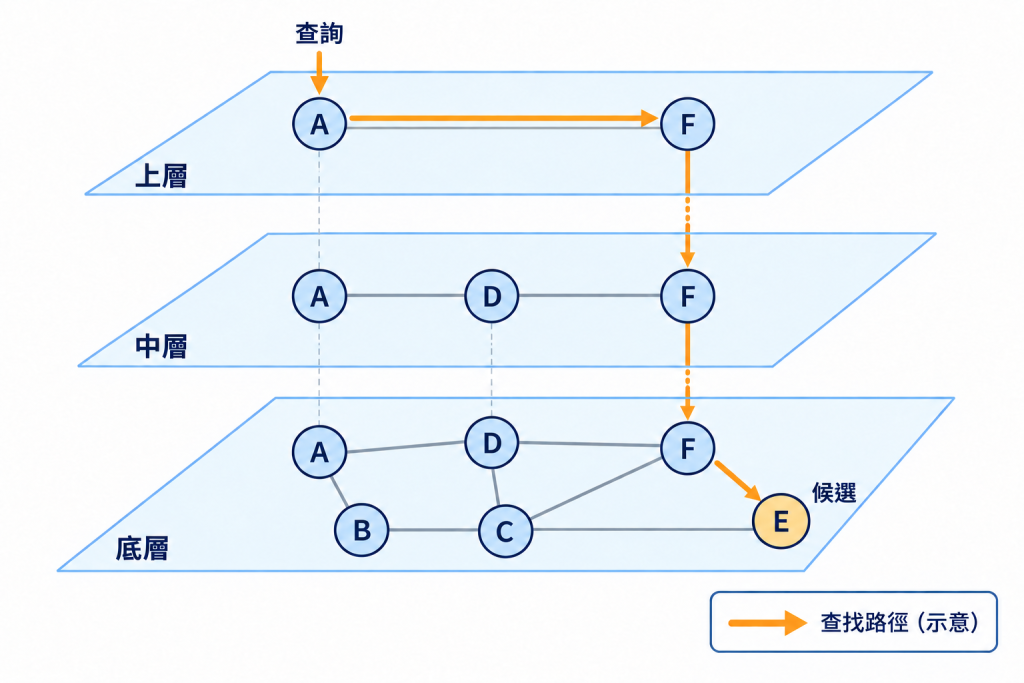
搜尋時,HNSW 從上層的入口出發,沿著連結比較哪些節點更接近查詢向量,再往下層探索候選。它透過這些連結縮小需要計算距離的範圍,省下逐筆比較所有商品的工作。下面用概念程式碼表示建立與使用索引的差別:
# 概念示意,非特定套件的 API
index = HNSWIndex(distance="cosine")  # 比較餘弦距離

# 建立索引:把既有商品向量加入圖中,建立節點間的連結
for product in products:
    index.add(product.id, product.embedding)

# 查詢與商品使用同一嵌入模型、相同維度
query_vector = embed("露營用的不鏽鋼杯")

# 查找時沿圖探索;20 是示意的回傳數量
candidates = index.search(query_vector, k=20)
HNSW 的加速來自只探索部分節點,因此屬於近似最近鄰搜尋(approximate nearest neighbor search),可能漏掉逐筆精確比較會找到的商品。擴大探索範圍可以降低遺漏的機會,也會增加距離計算與耗時。
索引能減少查找工作,但也需要額外儲存空間與建立時間,新增或修改資料時還要維護索引。前面的商品介紹更新後,文字索引需要更新詞彙對照;新版商品向量產生後,向量索引也要納入它,因此索引的維護其實隱含著不小的成本。在實作上我們通常會先挑出經常執行、等待時間長的查詢,再根據查找方式選擇索引;資料量少、逐筆掃描已經夠快時,新增索引可能只增加維護成本。
要判斷索引是否值得保留,需要比較建立前後的實際查詢,在 PostgreSQL 中我們可以用 EXPLAIN ANALYZE 來查詢採用的路徑與執行時間。下面先用一個單純的價格篩選示範:
-- PostgreSQL 示意:products 是商品表,價格上限僅為例子
-- 1. 建立索引前先量測;ANALYZE 會實際執行這個 SELECT
EXPLAIN (ANALYZE, BUFFERS)
SELECT id
FROM products
WHERE visible AND price <= 1000;

-- 2. 為價格範圍查找建立 B-tree 索引
-- B-tree 索引按欄位值建立有序結構,可加速價格這類範圍查找
CREATE INDEX product_price_idx ON products USING btree (price);

-- 3. 建立後,在相同資料與條件下重跑上面的 EXPLAIN
-- Seq Scan:逐筆掃描;Index Scan / Bitmap Index Scan:透過索引
-- Execution Time:資料庫查詢執行時間;BUFFERS:資料頁存取情況
商品資料持續更新,向量生成與索引維護也需要持續執行。下一篇會接著討論:這些更新工作如何交給背景執行,以及該怎麼選擇部署環境?


 iThome鐵人賽
 看影片追技術