

上一篇我們聊了 Retrieval(檢索)的細節,討論了 lexical retrieval(詞彙檢索)、vector retrieval(向量檢索)與 hybrid retrieval(混合檢索)等方式,目標是先把真正相關的商品盡量找回來。這些 retrieval 方法在找回候選的同時,其實也會產生一個 initial ranking(初始排序);接下來真正要問的是:這個初始順序夠不夠好,我們能不能再把它排得更符合使用者需求?
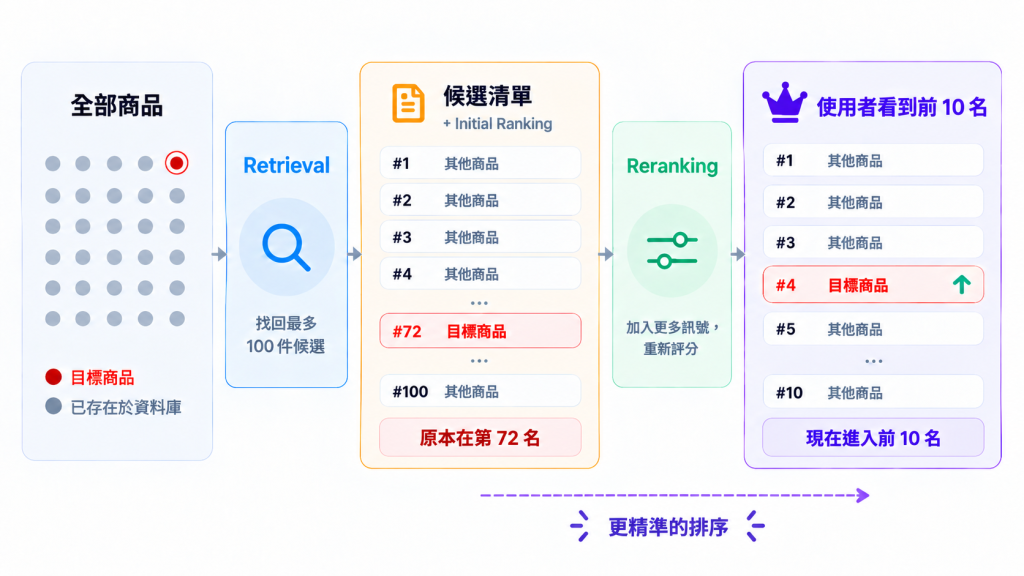
假設使用者搜尋「適合露營用的隨行杯」,一件符合需求的商品已經進入含有 100 件商品的候選清單,卻在 initial ranking 裡只排第 72 名。這件商品雖然沒有被漏掉,但使用者只瀏覽前幾筆結果時,仍然看不到它。因此我們這裡想要探討的問題是:
在固定的候選集合中,如何設計排序方法,讓更符合使用者需求的商品優先出現在搜尋結果前列?
Retrieval 已經產生一份帶有初始順序的候選清單。如果想進一步調整這個順序,最簡單的做法就是挑出我們重視的訊號、設定權重,再依加總後的分數由高到低排列。
假設我認為 semantic similarity(語意相似度)最重要,其次是商品名稱有沒有直接命中,再來才是 lexical score(詞彙檢索分數),就可以先給它們 0.5、0.3、0.2 的權重,再用最後的加權分數決定順序。這裡先假設不同來源的分數已做 normalization(正規化),落在可以比較的尺度上;否則就和上一篇提到的一樣,不能直接把 cosine similarity 與 lexical score 原始值相加。
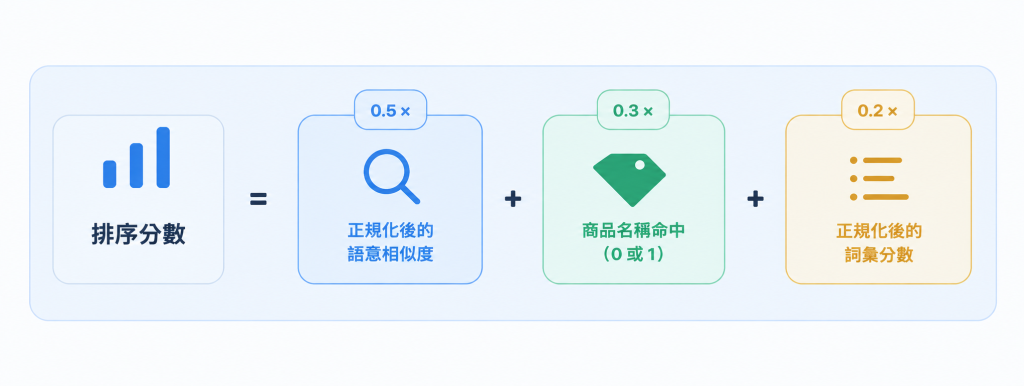
這種做法的好處是**規則透明、容易除錯,也不需要先訓練模型。**如果只有兩三個訊號,而且產品需求很明確,從規則式排序開始通常就已經足夠,不需要一開始就導入更複雜的模型。
然而,實務上我們在意且想要拿來影響排序的因素通常不只兩三個。以目前這個搜尋系統來說,我們可以想到至少三類資訊:
有了這些例子,就比較容易理解為什麼不一定要直接沿用 RRF 的順序。RRF 使用各檢索路徑的名次做融合,但到了第二階段,我們還可以加入名稱命中、文字重疊等其他資訊,補足第一階段沒有考慮到的訊號。然而這邊要留意的是特徵不是越多越好,有些特徵如「描述長度」或「圖片面積」或許對於資料呈現上有所影響,但對於該商品是否「更為相關」則不見得有直接的關係。
這些額外特徵要怎麼放進排序流程?這就帶到下一個概念:Reranking。
Retrieval 已經替我們完成第一輪候選篩選與排序。如果可搜尋商品有上萬件,就沒有必要再對整個商品庫計算所有排序特徵;這個專案先把範圍縮到最多 100 件候選,再只針對這批商品加入更多訊號並重新評分。
對 retrieval 已找回的候選重新評分、再決定呈現順序,這個步驟就是 Reranking。
前面有提到 Retrieval 其實也會有初始排序:
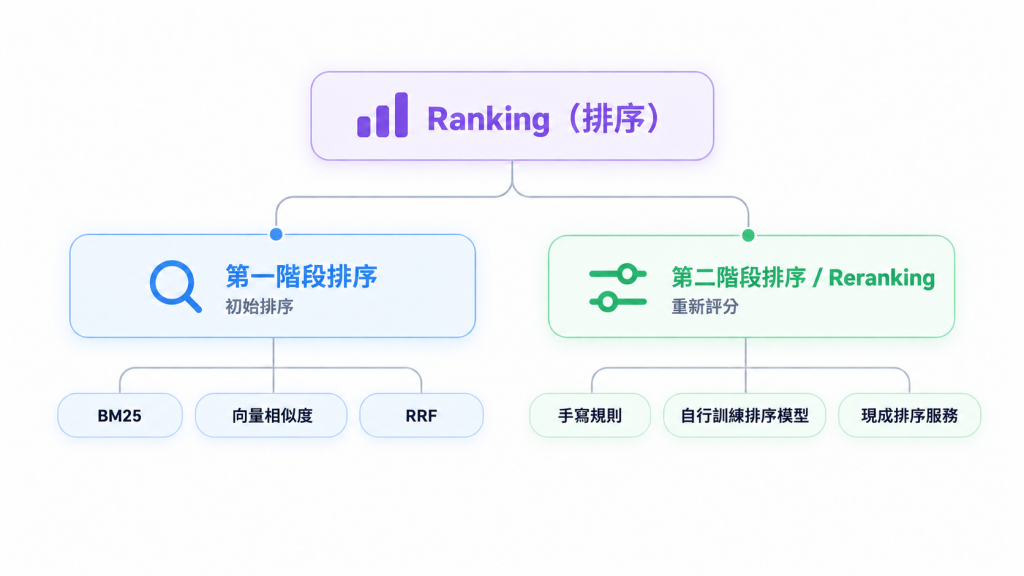
因此這裡的 re- 指的是:Retrieval 已經排過一次,我們再對同一批候選做第二次排序,讓更符合使用者需求的商品有機會被推到更前面。這個步驟可以使用前面提到的手寫規則,也可以交給其他模型或現成服務:
前面手寫排序公式時,我們自行決定哪些訊號要加分、各占多少權重。Learning to Rank 則把這部分交給模型:提供查詢、候選商品的特徵,以及相關性標註,讓模型學習如何組合這些資訊,產生更符合需求的順序。
在排序問題裡,我們更在意相對順序,而不是把模型輸出的 score 當成具有絕對意義的數值。假設商品 A、B 分別得到 2.7、1.3,重點是模型把 A 排在 B 前面;不代表商品的相關性存在一個叫做「2.7」的標準答案。
常見的訓練模型之一為 LightGBM,我們可以利用其 lambdarank 目標函數來訓練這個模型,以下把實作簡化成主要流程:
# 簡化自目前實作;X、y、qid 為已備妥且列序一致的 NumPy 陣列。
import numpy as np
import lightgbm as lgb
from sklearn.model_selection import GroupKFold

# X:每個「查詢-商品」配對的特徵矩陣。
# y:整數相關性標註(0、1、2、3);qid:所屬查詢的識別碼。
# 以下資料不包含保留測試集。
n_queries = len(np.unique(qid))
if n_queries < 2:
    raise ValueError("依查詢分組驗證至少需要兩個查詢")

def make_dataset(indices, reference=None):
    # group 是各查詢的筆數,不是逐列的 qid。
    # 先讓同一查詢的資料連續排列,再計算每組筆數。
    rows = indices[np.argsort(qid[indices], kind="stable")]
    _, sizes = np.unique(qid[rows], return_counts=True)
    return lgb.Dataset(
        X[rows], label=y[rows], group=sizes, reference=reference,
    )

params = {
    "objective": "lambdarank",
    "metric": "ndcg",                    # 驗證前排排序品質
    "eval_at": [5, 10],
    "label_gain": [0, 1, 3, 7],           # 四個相關性等級的增益
    "lambdarank_truncation_level": 13,    # 訓練時關注前排名次
    "verbosity": -1,
}

# GroupKFold(分組交叉驗證)讓同一查詢不會跨越訓練與驗證集。
fold_scores, best_iterations = [], []
cv = GroupKFold(n_splits=min(5, n_queries))
for train_idx, valid_idx in cv.split(X, y, groups=qid):
    train_ds = make_dataset(train_idx)
    valid_ds = make_dataset(valid_idx, reference=train_ds)
    model = lgb.train(
        params, train_ds, num_boost_round=500,
        valid_sets=[valid_ds],
        callbacks=[lgb.early_stopping(50, verbose=False)],
    )
    fold_scores.append(model.best_score["valid_0"]["ndcg@10"])
    best_iterations.append(model.best_iteration)

# 用各折結果比較設定;不是把最後一折模型直接拿去上線。
mean_ndcg = float(np.mean(fold_scores))
model = lgb.train(
    params, make_dataset(np.arange(len(y))),
    num_boost_round=int(np.median(best_iterations)),
)
模型在離線資料上訓練完成,只代表我們得到一個可以評分的模型;真正上線時,還要另外建立線上推論流程:收到查詢、取得候選、計算特徵、載入模型、產生分數,再把新的順序回傳。線上只做推論,不會每次查詢都重新訓練,也不需要使用者提供相關性標註。
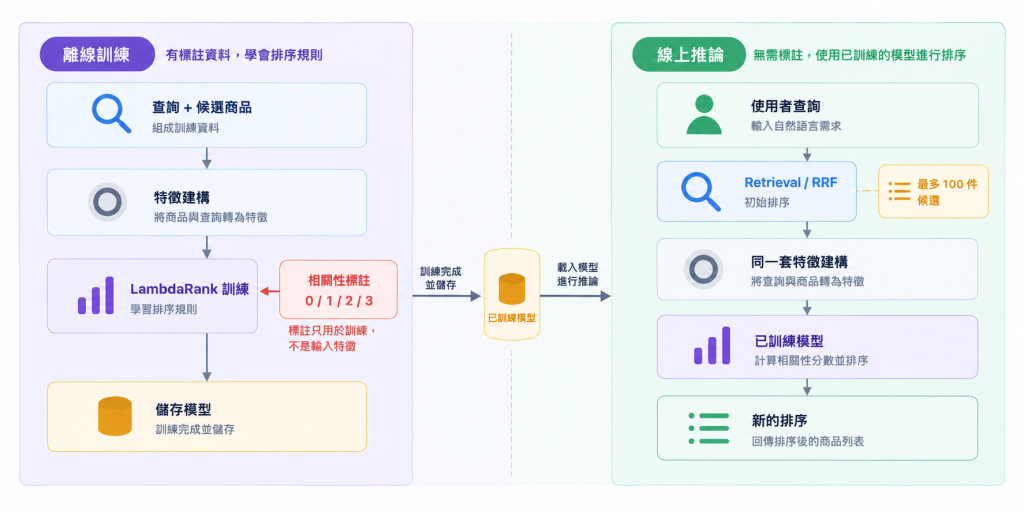
部署排序模型時,真正要處理的是離線訓練環境與線上服務之間的落差。特徵怎麼算、模型怎麼被載入、流量怎麼切換,都可能讓「離線評估表現很好」和「上線後真的照預期工作」變成兩件事。以下我們來看三種不同的風險:
第一個風險是 training-serving skew(訓練與線上推論偏差):模型訓練時看到一套特徵定義,上線後卻因為欄位順序、單位或計算方式不同,實際收到另一套資料。例如模型訓練時第二個欄位是檢索名次,線上卻放入相似度分數,即使資料都是數字、程式沒有報錯,模型解讀的內容也已經不同。
常見做法是把特徵定義集中管理並明確版本化,讓訓練與線上推論都依賴同一份規格。以目前實作為例,特徵名稱、來源與排列順序會寫進 FEATURE_SPEC,計算 hash(雜湊值),並存入模型的中繼資料;載入模型時先核對這份定義是否和線上程式相容:
import { createHash } from "node:crypto";

// 簡化示意:FEATURE_SPEC 來自共用模組,modelMeta 來自模型中繼資料。
const featureSpecHash = createHash("sha256")
  .update(JSON.stringify(FEATURE_SPEC))
  .digest("hex");

if (modelMeta.feature_spec_hash !== featureSpecHash) {
  throw new Error("Feature spec mismatch");
}
這能攔下特徵清單或順序不相容的情況,但不會自動理解計算方式的變更。假設 lexical_score 的名稱沒變,公式卻改了,這個 hash 仍可能相同。修改特徵計算時,仍需要固定輸入的測試與重新評估,不能只靠名稱相同就繼續套用舊模型。
另一個常見風險發生在模型轉檔與執行環境:模型可能在 Python 裡訓練,但正式產品未必直接使用同一套 Python 執行環境;模型常會被匯出成 ONNX 等格式,再交給 Node.js、Java 或其他執行環境使用。
這會是一個問題的原因是因為模型轉檔後,在不同執行環境中的運算結果不一定完全相同:運算子(operator)對應、浮點精度或轉換方式的差異,都可能讓同一組特徵得到略有不同的分數,而排序最終依分數決定順序,所以即使偏差很小,只要兩個商品原本分數很接近,就可能直接交換排名。因此需要一致性測試(parity test),確認訓練環境與線上評分器的輸出差異小到不會改變模型行為。
要怎麼做這個測試呢?我們可以先在訓練環境保存幾組固定的特徵輸入與預期分數,再讓線上評分器重跑一次,確認誤差落在可接受範圍。以上述情境為例,模型在 Python 訓練後匯出成 ONNX,再由 Node.js 執行推論,就可以用固定測試資料驗證兩邊的分數是否一致。
// expectedScore 由訓練環境事先產生
for (const fixture of parityFixtures) {
  const [actualScore] = await scoreCandidates([
    Float32Array.from(fixture.features),
  ]);

  expect(
    Math.abs(actualScore - fixture.expectedScore)
  ).toBeLessThan(1e-5);
}
即使線上推論可以正常運作,也不代表應該直接把 100% 流量直接轉移到新的模型。除了離線資料無法完整覆蓋真實的查詢分布外,新的排序模型也可能增加延遲、提高錯誤率,或在特定使用情境下產生沒有預期到的排序。
一個比較穩健的上線策略通常會分幾步:
上一篇談 Retrieval 時,我們用 Recall@K(召回率) 回答一個很直接的問題:在保留 K 個候選的情況下,應該找回來的相關商品有多少真的進了候選集合。
到了 Ranking,問題換成了:同一批候選都已經找回來之後,前排結果的品質與順序好不好? 因此除了看前 K 筆有多少相關結果,也會使用真正對排名位置敏感的指標。
以下三個是常見的 Ranking 指標:
另外,Recall@100 在純 reranking 實驗裡反而可以當 sanity check(合理性檢查):如果兩個 ranker 使用完全相同的 100 件候選,只是重新排列順序,Recall@100 理論上就不應該改變。
以下是我們實際測試後看到的結果:
| 指標 | RRF 基準 | LTR v1 | 差異(LTR − RRF) |
|---|---|---|---|
| Recall@100 | 0.851 | 0.851 | 0 |
| Precision@5 | 0.600 | 0.644 | +0.044 |
| NDCG@10 | 0.732 | 0.787 | +0.055 |
| MRR | 0.875 | 0.906 | +0.031 |
這類排序比較有一個前提:兩種方法要使用相同的查詢、相關性標註與候選商品,才比較能把差異歸因於排序本身。評估題目也應與訓練資料分開;反覆拿測試題調參,最後測到的就不再是未見需求上的表現。
這次結果有兩個我最在意的訊號:
前面幾篇我們從系統的角度,拆解了一次商品搜尋背後實際發生的事情:自然語言怎麼變成搜尋條件、retrieval(檢索)怎麼找出候選,以及 ranking(排序)怎麼決定最後的結果順序。
到這裡,搜尋背後的流程大致接起來了。下一篇會把視角翻回使用者端:當這些能力真的出現在畫面上,使用者要怎麼理解搜尋結果、調整系統的判斷,並繼續往下一步探索?


 iThome鐵人賽
 看影片追技術