
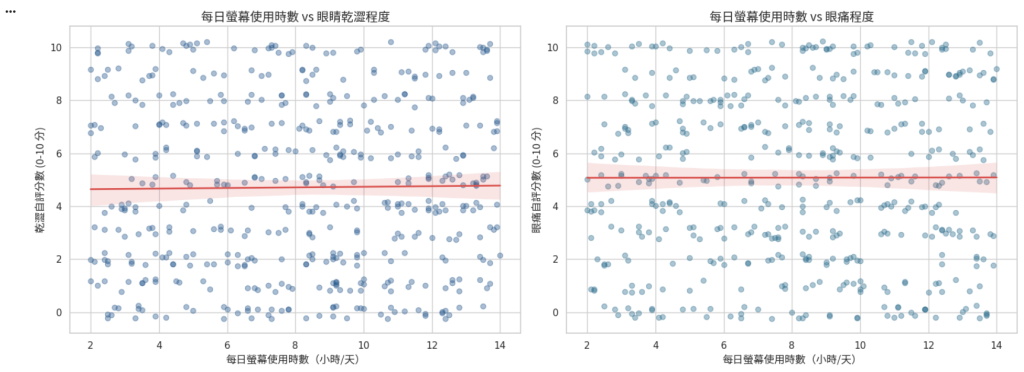
透過Seaborn的regplot繪製散佈圖並疊加線性迴歸擬合線,同時利用抖動與透明度解決離散量表點位重疊問題。
一、實作前情境:離散量表繪製散佈圖的「重疊盲點」
在探討兩個連續型變數(或一個連續型、一個離散評分)的關聯時,散佈圖是最直觀的工具。
然而,本專案的Eye_Dryness_Level與Eye_Pain_Level皆為0到10的整數評分(Discrete Integer Scale)。如果直接使用常規的 sns.scatterplot(),許多具有相同螢幕時長與評分的樣本點會完全重疊在一起,導致視覺上無法判斷某個點位究竟代表 1 位受試者還是 20 位受試者(即所謂的 Overplotting 問題)。
為了解決這個視覺盲點,本日實作採用兩種處理手法:
二、撰寫雙變數關聯視覺化腳本
在Notebook中新增程式碼儲存格,使用plt.subplots建立1列2行的對比畫布:
# ==========================================
# Day 8:雙變數關聯分析(散佈圖 + 迴歸趨勢線)
# ==========================================

import matplotlib.pyplot as plt
import seaborn as sns
import matplotlib.font_manager as fm

# 引用中文字型
font_path = 'NotoSansTC-Regular.otf'
my_font = fm.FontProperties(fname=font_path)

# 1.建立 1x2 畫布佈局
fig, axes = plt.subplots(1, 2, figsize=(16, 6))
sns.set_theme(style="whitegrid")

# --- 圖1:螢幕使用時數 vs 眼睛乾澀程度 ---
sns.regplot(
    data=df,
    x='Daily_Screen_Hours',
    y='Eye_Dryness_Level',
    ax=axes[0],
    color='#2b5c8f',
    scatter_kws={'alpha': 0.4, 's': 35},
    line_kws={'color': '#d9534f', 'linewidth': 2},
    y_jitter=0.25 # 對離散評分施加輕微垂直抖動以避免重疊
)
axes[0].set_title('每日螢幕使用時數 vs 眼睛乾澀程度', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[0].set_xlabel('每日螢幕使用時數(小時/天)', fontproperties=my_font, fontsize=12)
axes[0].set_ylabel('乾澀自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[0].set_ylim(-0.8, 10.8)

# --- 圖2:螢幕使用時數 vs 眼痛程度 ---
sns.regplot(
    data=df,
    x='Daily_Screen_Hours',
    y='Eye_Pain_Level',
    ax=axes[1],
    color='#31708f',
    scatter_kws={'alpha': 0.4, 's': 35},
    line_kws={'color': '#d9534f', 'linewidth': 2},
    y_jitter=0.25
)
axes[1].set_title('每日螢幕使用時數 vs 眼痛程度', fontproperties=my_font, fontsize=14, fontweight='bold')
axes[1].set_xlabel('每日螢幕使用時數(小時/天)', fontproperties=my_font, fontsize=12)
axes[1].set_ylabel('眼痛自評分數 (0-10 分)', fontproperties=my_font, fontsize=12)
axes[1].set_ylim(-0.8, 10.8)

plt.tight_layout()
plt.show()
三、圖表解讀與數據洞察(打破直覺的意外發現)
觀察由regplot繪製出的兩張散佈圖與趨勢擬合結果:
1.趨勢線走勢:斜率近乎為零(無明顯單純線性關聯)
2.點位分佈格局:全面散佈與高度異質性
3.實作工程反思
這項觀察為接下來的分析提供了絕佳的故事轉折點:單看兩個變數看不出線性趨勢,因此更需要計算全欄位相關係數矩陣來找出背後真正具有影響力的隱藏因子!


 iThome鐵人賽
 看影片追技術