
邁入鐵人賽後半程(推論統計階段),利用 SciPy 進行嚴謹的雙樣本統計假設檢定,針對 Day 10 觀察到的「抗藍光濾鏡使用組 vs. 未使用組」在自覺症狀(乾澀、眼痛)與 Day 15 打造的「CESI 綜合疲勞指數」上的差異,以 p值判定是否具備統計顯著性。
一、實作前情境:為什麼 EDA 之後必須做假設檢定?
在 Day 10 的分組箱形圖與平均數比對中,我們發現:
在工程實務與資料科學競賽中,我們不能僅憑「0.35 分」的肉眼差距就斷定抗藍光有效或無效。這個差距到底是母體真實存在的保護效應,還是單純抽樣 500 人時產生的隨機波動?
今天我們建立標準的推論統計檢驗流程:
虛無假設(H0):使用抗藍光濾鏡組與未開啟組,在眼部指標上無顯著差異(mu_1/mu_2)。
對立假設(H1):兩組在眼部指標上存在顯著差異(mu_1/mu_2)。
顯著水準(alpha):設定為標準的 0.05。若 p < 0.05則拒絕虛無假設。
二、 撰寫自動化統計檢定 Pipeline 腳本
在進行兩組均值檢驗前,必須先透過 Shapiro-Wilk 檢驗判斷資料是否符合常態分佈,並用 Levene's Test 檢驗變異數同質性,以決定使用傳統 Student's t檢定、Welch's t檢定或無母數檢定(Mann-Whitney U Test)。
在 Colab 中新增儲存格,撰寫完整統計檢定腳本:
# ==========================================
# Day 16:抗藍光濾鏡效果之雙樣本假設檢定
# ==========================================

import warnings
warnings.filterwarnings('ignore')

import pandas as pd
import numpy as np
from scipy import stats

# 確保 CESI_Score 已於 Day 15 計算完成
if 'CESI_Score' not in df.columns:
    df['Blurred_Vision_Score'] = df['Blurred_Vision'].map({'Yes': 10.0, 'No': 0.0})
    break_discount = 1.0 - (df['Break_Frequency_Per_Hour'] * 0.05)
    df['Exposure_Burden'] = (df['Daily_Screen_Hours'] / df['Sleep_Hours']) * break_discount
    min_b, max_b = df['Exposure_Burden'].min(), df['Exposure_Burden'].max()
    df['Exposure_Score'] = ((df['Exposure_Burden'] - min_b) / (max_b - min_b)) * 10.0
    df['CESI_Score'] = (
        df['Eye_Dryness_Level'] * 2.0 +
        df['Eye_Pain_Level'] * 2.5 +
        df['Blurred_Vision_Score'] * 1.5 +
        (df['Headache_Frequency_Per_Week'] / 7.0 * 10.0) * 0.5 +
        df['Exposure_Score'] * 3.5
    )

# 1. 拆分兩組資料
group_no = df[df['Blue_Light_Filter_Used'] == 'No']
group_yes = df[df['Blue_Light_Filter_Used'] == 'Yes']

targets = ['Eye_Dryness_Level', 'Eye_Pain_Level', 'CESI_Score']
target_names = ['眼睛乾澀程度', '眼痛程度', 'CESI綜合指數']

results = []

for col, name in zip(targets, target_names):
    data_no = group_no[col]
    data_yes = group_yes[col]

    # (1) 常態性檢定 (Shapiro-Wilk Test)
    _, p_norm_no = stats.shapiro(data_no)
    _, p_norm_yes = stats.shapiro(data_yes)
    is_normal = (p_norm_no > 0.05) and (p_norm_yes > 0.05)

    # (2) 變異數同質性檢定 (Levene's Test)
    _, p_levene = stats.levene(data_no, data_yes)
    equal_var = p_levene > 0.05

    # (3) 執行獨立樣本 t 檢定 (母數)
    t_stat, p_ttest = stats.ttest_ind(data_no, data_yes, equal_var=equal_var)

    # (4) 執行 Mann-Whitney U 檢定 (無母數)
    u_stat, p_utest = stats.mannwhitneyu(data_no, data_yes, alternative='two-sided')

    results.append({
        '指標項目': name,
        '未開啟組(均值)': round(data_no.mean(), 2),
        '使用組(均值)': round(data_yes.mean(), 2),
        '差值(Yes-No)': round(data_yes.mean() - data_no.mean(), 2),
        '常態性(p>0.05)': '符合' if is_normal else '偏離常態',
        't檢定 p值': round(p_ttest, 4),
        'Mann-Whitney p值': round(p_utest, 4),
        '統計顯著性(α=0.05)': '顯著差異' if p_utest < 0.05 else '無顯著差異'
    })

# 2. 輸出格式化統計報告
results_df = pd.DataFrame(results)
print("=== 抗藍光濾鏡分組假設檢定分析報告 ===")
display(results_df)
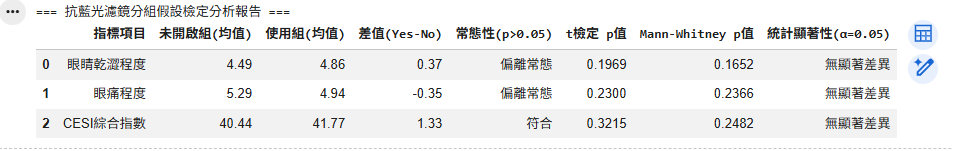
三、 圖表解讀與統計檢定結論
由自動化統計檢定 Pipeline 產出的報告表格,可從統計分佈與假設檢定兩個維度得出嚴謹結論:
b.眼痛程度(Eye_Pain_Level):
c.CESI 綜合疲勞指數(CESI_Score):


 iThome鐵人賽
 看影片追技術